Skill 越推荐越多,收藏夹越来越长,真可正做课题时,很多朋友还是不知道该装哪个。
临时搜工具、复制提示词,容易每次重来;整套全装又增加依赖、权限和选择成本。进入专业分析,通用回答仍可能缺少边界与复现记录。
更省事的办法,是把 Skill 当作科研流程中的“岗位说明书”:当前步骤需要什么,就只装什么。Scientific Agent Skills 提供了一套可拆分工具箱。下面不按专业报目录,而按从检索到投稿的顺序来选。
| 项目介绍
项目名称:scientific-agent-skills
项目链接
https://github.com/K-Dense-AI/scientific-agent-skills
Scientific Agent Skills 是一个开源科研 Skill 集合。它不是一个替你包办科研的“超级按钮”,而是一组写给 AI Agent 的专业工作说明:什么时候该调用某个工具、要检查哪些前提、如何保留参数与来源、哪些结论不能越界。
项目覆盖文献与数据库检索、生物信息、药物研发、临床研究、机器学习、统计分析、科研绘图、论文写作、实验室平台和合规准备等方向。
项目累计列出 100+ 数据库、70+ Python 包 Skill,以及多种科研平台集成。换句话说,它补的不是模型会不会聊天,而是模型做具体科研任务时有没有一套可追踪的做法。
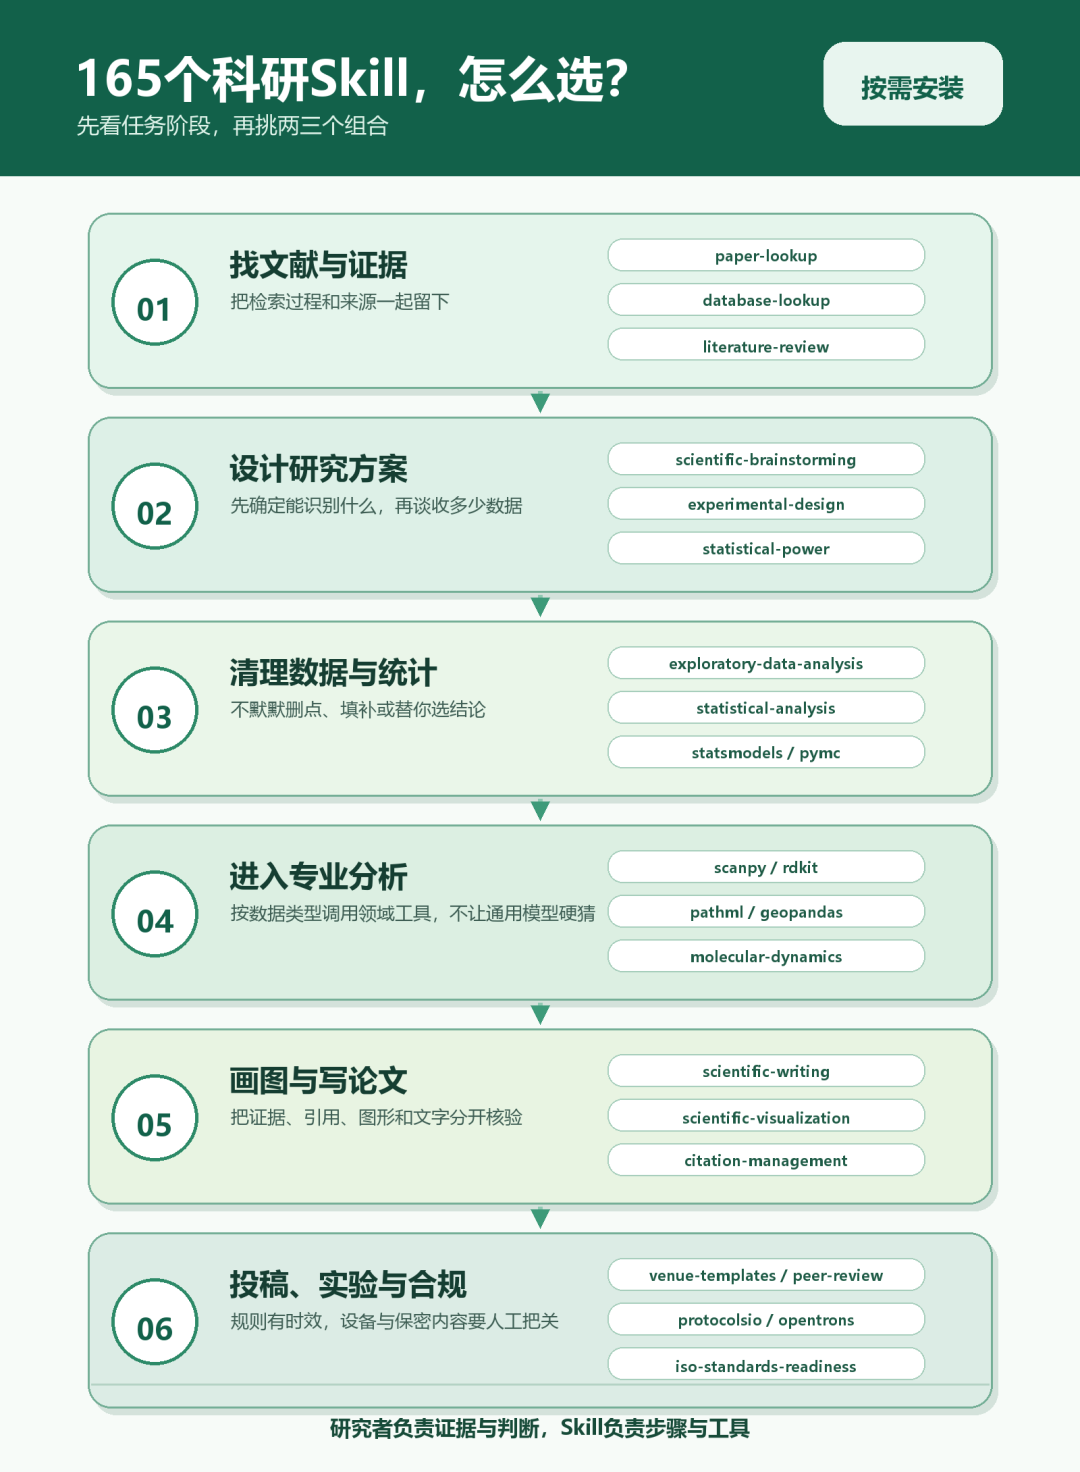
日常工作学习时候完全没必要全装。你可以先看自己卡在哪一段:找证据、定方案、清数据、做专业分析、写作表达,还是投稿与实验合规。选中阶段,再挑两三个 Skill 组合,通常已经够用。
| 安装与部署
对支持 Agent Skills 标准的工具,项目给出的常用安装命令是:
npx skills add K-Dense-AI/scientific-agent-skills
如果安装了新版 GitHub CLI,也可以只装一个指定 Skill。例如给 Codex 安装 Scanpy:
gh skill install K-Dense-AI/scientific-agent-skills scanpy --agent codex
需要固定版本时,可用 --pin 指向 release tag 或 commit SHA。不同宿主的路径和参数会更新,正式安装前仍要看各自最新文档。
Tips:
最好不要让AI直接执行指令安装仓库内全部内容,可以先让AI确认一下Skill仓库的列表,再选择需要的安装。
| 场景1 文献检索
一句“帮我找文献”很容易换来十条看似整齐的标题,却看不出查了哪个库、筛选条件是什么,也不知道缺失结果是“没有研究”还是“接口没返回”。
推荐组合:paper-lookup + database-lookup + literature-review;需要把结论定位到可访问原文时,再加 paperclip。
子项目说明:
paper-lookup 可面向 PubMed、PMC、arXiv、OpenAlex、Crossref、Semantic Scholar 等 11 个学术接口做可复现检索;
database-lookup 负责按明确端点、过滤条件和分页规则查询 78 个公共数据库;
literature-review 用来组织检索、筛选与证据综合。
paperclip 用来全文和监管材料检索,并把判断定位到原文位置。
简单说,先让前几个Skill回答“去哪里找、怎么整理”,最后由Paperclip 回答“这句话在原文哪儿”。
提示词:
请使用 paper-lookup 和 database-lookup,为“【研究主题】”设计一次可复现的证据检索。先确认研究对象、时间范围、文献类型、语言和是否只要开放获取全文;再选择合适的数据库,不要无目的遍历全部接口。
输出检索式、端点或数据库、关键参数、访问日期、纳入与排除规则,并按 DOI/PMID/arXiv ID 去重。
若结果为空或不完整,请区分“未检出”和“接口/权限限制”。最后用 literature-review 将证据按主题归类,标出共识、冲突、研究空缺及仍待人工核验的引用;如需引用原文,请调用 paperclip 给出原文位置,无法取得全文时明确说明,不得根据摘要补写正文内容。
在让Agent读取项目仓库后,我们可以直接输入以上指令,Agent会自动安装并使用以上提到的子项目完成我们所需要的任务。
输出范例如下:
| 场景2 研究设计
不少人拿到一个想法就开始收数据,等分析时才发现处理组与批次重合、重复测量被当成独立样本,或者样本量只凭“前人差不多”。此时统计技巧再花哨,也救不了结构性问题。
推荐组合:scientific-brainstorming + hypothesis-generation + scientific-critical-thinking + experimental-design + statistical-power。
子项目说明:
scientific-brainstorming 负责铺开研究方向;
hypothesis-generation 把其中的想法整理成尚待验证的候选假设;scientific-critical-thinking 专门追问因果跳跃、混杂因素和替代解释。
之后再由 experimental-design 处理随机化、重复、区组和实验结构;
最后用 statistical-power 计算样本量或最小可检测效应。
提示词:
围绕“【研究问题】”
调用 scientific-brainstorming 提出 3 个彼此可区分的机制,再用 hypothesis-generation 将其改写为候选假设,逐条列出前提、可观察预测和反证条件。
调用 scientific-critical-thinking 检查因果跳跃、混杂因素与竞争性解释。随后使用 experimental-design,把研究单位、处理因素、对照、随机化层级、区组因素、独立重复与重复测量写清,专门检查伪重复。
最后调用 statistical-power:基于【先验研究/最小有意义效应】给出效应量假设、α、目标功效、失访或聚类修正、计算方法与敏感性区间。若关键参数缺失,先列出需要我确认的信息,不要自行填数。
| 场景3 边界检查
上传一张表就让 AI “分析一下”,最常见的后果不是报错,而是它默默删异常值、自动填缺失、挑一个检验,再给出一段很有把握的结论。步骤顺利,证据链却断了。
推荐组合:exploratory-data-analysis + statistical-analysis + uncertainty-and-units,必要时追加 statsmodels 或 pymc。
子项目说明:
exploratory-data-analysis 的定位是对获授权的本地数据做有边界的检查,不自动删点、填补、标准化或覆盖原始文件;
statistical-analysis 把检验选择、假设检查、效应量和报告放在同一流程里;
uncertainty-and-units 负责单位一致性、不确定度预算和误差传播。
需要具体模型 API 时,再按研究设计调用 statsmodels 或 pymc,而不是先看哪个包顺手。
提示词:
请只在【数据文件路径】的副本上工作。
先用 exploratory-data-analysis 输出变量类型、样本量、缺失模式、重复记录、取值范围、分布、组间结构和潜在异常;不得自动删除、填补、变换或覆盖数据。
然后根据“【假设】—【研究设计】—【因变量类型】—【独立单位】”调用 statistical-analysis,说明候选检验及选择理由,检查相应假设,报告效应方向、效应量和置信区间。
若变量含物理量、测量误差或单位换算,再调用 uncertainty-and-units 核对量纲、不确定度和误差传播。把数据事实、统计推断和领域解释分开;若设计是横截面或观察性研究,不使用“导致”“影响”等因果措辞。
| 场景4 数据分析
单细胞矩阵、分子结构、病理切片和空间数据看上去都叫“数据”,可预处理、质量控制、版本依赖和有效性判断完全不同。通用脚本能跑,不等于专业流程成立。
推荐方式:按数据类型选专用 Skill。
子项目说明:
单细胞分析可看 scanpy,分子与药物信息可看 rdkit,数字病理可看 pathml,空间数据可看 geopandas;实验流程还可连接 protocolsio-integration,液体处理则有 opentrons-integration。
提示词:
我的任务是【专业研究任务】,输入为【文件格式、物种/平台/空间坐标系/仪器等关键信息】,目标输出为【结果与用途】。
请先判断仓库中最匹配的专用 Skill,并读取其 `SKILL.md` 后再执行。开始前列出软件与数据版本、必要元数据、质量控制、不可逆操作和人工确认点;所有处理保留原始文件、随机种子、参数和环境信息。
若涉及实验设备,只生成协议草案并先做本地模拟,不把语法通过或模拟成功当作获准上机。
| 场景5 初稿到投稿
让 AI 一次完成“写论文、补引用、画图、按期刊格式投稿”,看起来省提示词,实际把证据核验、语言润色、图形真实性和投稿规则混在一起。任何一环出错,都很难追溯。
推荐组合:scientific-writing + citation-management + scientific-visualization + scientific-schematics + venue-templates + peer-review。需要精细控制统计图时,再调用 matplotlib 或 seaborn。
子项目说明:
scientific-writing 强调证据来源、保密和不得捏造;
citation-management 用 DOI、PMID 等核对元数据;
scientific-visualization 负责图形真实性和投稿输出,scientific-schematics 适合机制图与实验示意图,Matplotlib 和 Seaborn 则提供更细的坐标、分组、误差线和导出控制。到了投稿阶段,再用 venue-templates 核对当年官方规则,并在授权和保密条件明确时调用 peer-review 做结构化自审。
提示词:
请分阶段处理【论文材料】:
先使用 scientific-writing,仅依据我提供的结果、方法和已核验来源整理初稿,缺证据处标“待补”;
再用 citation-management 按 DOI/PMID 核对作者、题名、期刊、年份和链接。
调用 scientific-visualization 审核图形是否诚实呈现样本、缺失、误差和变换;
统计图需要精细控制时使用 matplotlib 或 seaborn,机制与实验流程图使用 scientific-schematics。
随后用 venue-templates 打开【期刊/会议、年份、文章类型、投稿阶段】的官方说明,核对页数、匿名、图表和补充材料要求;
最后用 peer-review 从方法、统计、复现、伦理和结论边界做自审。各阶段单独输出修改记录,不得用语言润色掩盖证据缺口。
| 尾声
这类仓库型的Skill,乍一看包含的内容很繁琐,但对大部分人来说,只需选自己需要的功能即可:它们恰好对应你眼前的任务,还能把来源、参数和人工确认点留下来。装得少一点,反而更容易知道结果是怎么来的。
AI 可以替我们翻文档、调接口、整理格式,也能提醒容易漏掉的步骤。但研究问题为何重要、证据是否可信、实验能否开展、结论该说到哪里,仍然需要人负责。Skill 的位置是减少重复劳动,不是接管科研判断。