科研图表最容易卡住的地方,常常不是不会写 `plt.plot()`。变量表、回归结果、算法指标都在手里,真正让人停下来的是:这组数据到底要让读者看见什么?是组间差异、变量关系,还是随规模变化的趋势?如果这个问题没先说清楚,图画得越快,返工越早。
常规做法是先照着熟悉的模板画一张柱状图或折线图,再调颜色、字号和图例。它能很快产出一张“看起来像图”的图片,却不一定能支撑论文中的那句话。尤其当样本很小、维度很多,或者停止时间与问题规模一起变化时,默认图形很容易把真正的限制藏起来。
AI Agent 可以把这一步往前挪:先读数据、识别分布和异常值,再询问这张图想论证的命题,最后才决定图型、期刊尺寸、字体和导出格式。本期介绍两个方向不同的工具:一个负责“分析数据后给出画法并完成绘图”,另一个负责“先找参考范式,再把人选中的样式交给代码 Agent”。
01 项目介绍
1 scipilot-figure-skill
项目地址:
https://github.com/Haojae/scipilot-figure-skill
项目介绍
`scipilot-figure-skill` 把自己定位为科研数据可视化顾问,而不只是一个绘图脚本集合。它的顺序很明确:先做数据剖析和图表决策,再绘制、按期刊规范调整、视觉自检并导出。项目提供了 `profile_data.py`、图表选择决策框架、期刊规格、9 类绘图配方,以及程序检查和 AI 读图组成的闭环。
它会检查列类型、样本量、分布、异常值和相关性,并追问“你希望图支持哪一个论点”。例如每组只有 5 个样本时,它会拦截只画均值柱状图的请求,建议使用箱线图叠加 stripplot,让每个点可见;维度超过 12 时,它建议拆图,而不是把所有变量塞进一张图。
项目还明确规定了最终尺寸出图、矢量格式优先、色盲友好配色、最终尺寸下的字号和误差说明。v2.1 增加了出图后的视觉自检:程序检查缺字、裁切和刻度重叠,多模态检查图例是否压住数据、子图是否对齐、灰度下颜色是否仍可区分。中文模式会自动寻找 CJK 字体,并处理负号方框问题。
安装指南
在 Claude Code、Codex 或其他兼容 Skill 的环境中,可按仓库说明安装:
请帮我安装这个 Skill:https://github.com/Haojae/scipilot-figure-skill.git
提示词范例
使用 $scipilot-figure-skill 处理当前文件夹中的 results.csv。
先不要画图。请完成数据剖析:列类型、样本量、缺失值、分布、异常值、组间结构和相关性。然后询问我这张图要支持的具体论点,并给出主推荐图型、备选图型和各自理由。若样本量太小、维度过多、双 Y 轴会制造误读,或指定图型不适合数据,请主动拦截并说明原因。
我确认图型后,再按 Nature 双栏最终尺寸生成 PDF、SVG 和 PNG。使用可读的 CJK 字体、色盲友好配色和统一的子图标签;图注写清 n、误差类型和检验方法。导出后运行程序自检,并用图像复核缺字、裁切、重叠、图例遮挡和灰度可读性。发现问题就回改并重渲染,不要只报告“文件已保存”。
02 AgentFigureGallery
项目地址:
https://github.com/Dsadd4/AgentFigureGallery
项目介绍
`AgentFigureGallery` 解决的是另一类问题:科研图并不总是从“空白画布”开始。很多时候,作者知道想要类似某篇论文、某个期刊或某种细胞图谱风格,却很难把这种视觉偏好翻译成代码参数。这个项目提供一个面向 Claude Code、Codex、Cursor 等 coding agent 的科学绘图参考图库。
它的流程是:Agent 先按任务或 plot type 查询真实图例,研究者在浏览器图库中标记喜欢、拒绝或选中的参考图,工具再把选择导出为 reference bundle,最后交给绘图代码使用。
项目内置了一个可即时运行的小型参考包,也支持安装包含 16,341 个公开候选图的 `full-public` 资源池,覆盖 10 类常见科学图形。
安装指南
Codex 快速安装:
curl -fsSL https://raw.githubusercontent.com/Dsadd4/AgentFigureGallery/main/scripts/install.sh | bash
脚本会克隆或更新仓库,创建Python虚拟环境,安装包,并安装Codex技能包装器。
手动安装:
git clone https://github.com/Dsadd4/AgentFigureGallery.gitcd AgentFigureGallerypython -m venv .venvsource .venv/bin/activatepip install -e .agentfiguregallery doctoragentfiguregallery install-skill --target codex
在生成绘图代码之前,通过Agent 查询视觉参考,然后用户在浏览器中选择首选示例,AgentFigureGallery 导出选定的参考以完成最终绘图任务。
02 作者评价
1 scipilot-figure-skill
scipilot-figure-skill 和普通画图工具的对比
如果你已经有一份 CSV,最想知道“该用什么图、哪些地方容易误读”,`scipilot-figure-skill` 更直接。它覆盖从数据剖析到导出的完整链路,能主动拦截小样本柱状图、双 Y 轴和维度堆叠等常见问题;对中文字体、最终尺寸和视觉自检也有明确处理。它的限制同样清楚:判断依赖当前项目提供的数据和论点,不能替研究者决定科学问题;如果你只想快速套一个已有视觉风格,前面的分析步骤可能显得偏慢。
2 AgentFigureGallery
AgentFigureGallery 包含图表
AgentFigureGallery 更像“先找视觉参照,再交给 Agent 写图”的检索层。它支持多种 coding agent,安装后可以从小型内置包开始,也能扩展到大型公开参考池;人工点赞、拒绝和选择让审美偏好有了可记录的中间产物。它不负责数据统计诊断,也不会自动证明某种图型适合你的数据。图库选择之后,仍要回到绘图代码检查量纲、误差和图注。
小编推荐:scipilot-figure-skill
按功能丰富度看,前者的一条链更完整;按视觉参考和平台协作看,后者更有特色;按工作流位置看,前者适合“数据已经在手、准备正式出图”,后者适合“知道想要的视觉方向、但还没有可执行范式”。
但如果只选一个,我会先选 `scipilot-figure-skill`,科研图的第一道关通常是论点和数据是否匹配,然后才是选择合适的图片布局,而
scipilot-figure-skill 所采取的步步推进形式,更适合没有代码,需要从零开始绘图的场景。
已有稳定绘图代码、经常需要模仿期刊布局的团队,再把 `AgentFigureGallery` 接在前面,会更划算。
03 实战演示
本次演示材料来自论文《A sustainable supply chain network considering lot sizing with quantity discounts under disruption risks:》
接下来,我们想比较 ICA、PSO 和 ICA-PSO 在 8 个大规模测试实例上的解质量、波动和达到结果所需时间,同时展示问题规模与运行时间一起增长这一实验边界。
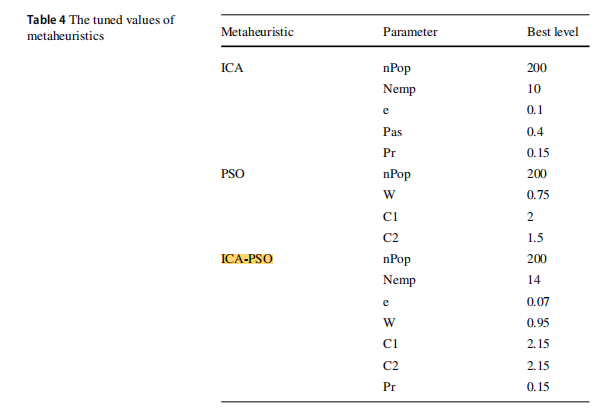 在最开始,我们可以只让AI先读取一下我们给出的数据,关于我们的数据最适合什么样的科研图,AI会先给出一个大致判断。
结合 scipilot-figure-skill 自己的判断和我们实际的需要,我们定下需求,并选择一种合适的图形。
接下来是确认图片的规范,这个大家视自己要发表的期刊而定,这里我们先按照一般的英文SCI 通用规则来执行,剩下的工作交给AI,输出图像如图所示。
相比原作者的图表,可以看出在 scipilot-figure-skill 的帮助下,成图质量还是有显著改善的。并且相关结论也基本准确。ICA-PSO 在 8 个实例中的 5 个取得最低平均目标值,整体平均目标值也最低。
04 尾声
科研图表的工作流,最好从一句可检查的论点开始。你要比较什么,数据的单位是什么,样本量能支撑哪种图,误差和检验如何写进图注,这些决定了图是否有用。颜色和字体当然要处理,但它们排在后面。
对刚开始做科研图的人,先跑通“数据剖析—论点确认—图型选择—视觉检查”这一小条链,比收藏一堆绘图库更重要。等你已经知道自己的图要长什么样,再用参考图库固定风格,会省下不少沟通和返工时间。



