十个算法挨个死记硬背?
十个经典算法 别背,先搭框架
一张地图记到底
三个问题分类 · 监督/无监督/集成 · 面试高频对比 · 十句口诀
📦 8 Parts + Conclusion
👉 滑动
PART 04
无监督学习
K-means与DBSCAN
上周一个朋友去面试算法岗,回来跟我吐槽:面试官问他“随机森林和AdaBoost有什么区别”,他脑子里过了一遍两个算法的原理,居然憋了半天说不出个所以然来。
不是不会,是记混了。
这种事我太理解了。KNN、K-means,一个是分类一个是聚类,名字长得像双胞胎,学的时候觉得懂了,隔两周再看又对不上号。机器学习经典算法就这么十来个,翻来覆去就是那些名词,可为什么老是记不牢?
我琢磨了很久,发现问题不在于算法本身有多难,而在于大部分教程都是把十个算法当成十个孤立的知识点在讲,一个个背,背完就忘。但如果你换个角度,先搭一个框架,把每个算法往框架里一放,你会发现它们之间的关系反而很清楚。
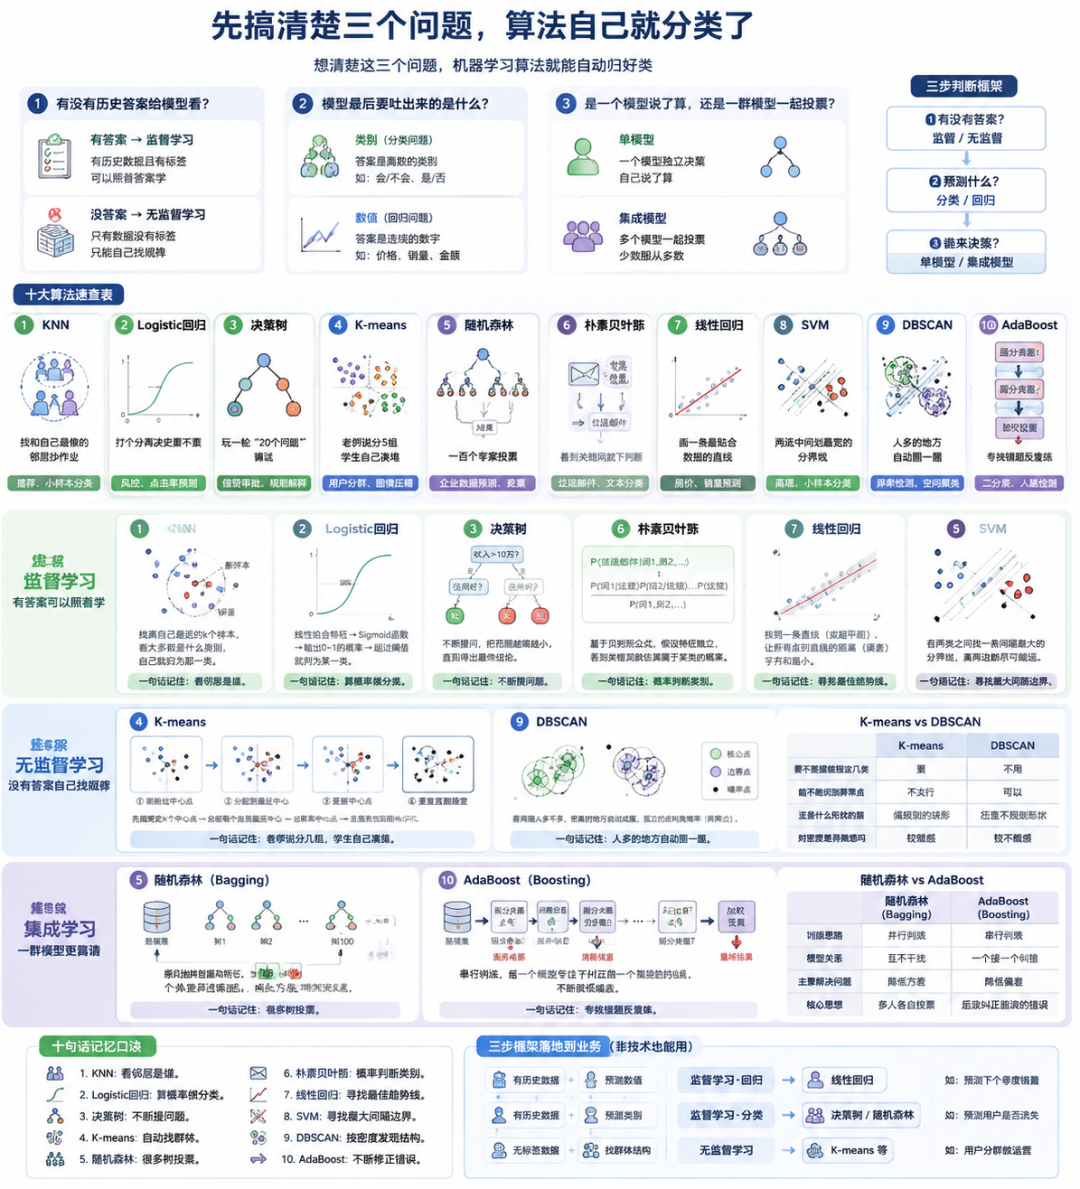
今天就用这个思路,把十大经典算法捋一遍。文章有点长,但看完之后,面试被问“XX和XX的区别”应该就不会卡壳了。文末还留了一份十句话的记忆口诀,建议先点个收藏。
先搞清楚三个问题,算法自己就分类了
CLASSIFICATION · 三个问题自动归类
在具体讲算法之前,有三个问题必须先想明白,这三个问题基本上能把机器学习的算法自动归好类。
第一个问题:有没有历史答案给模型看?
比如银行手里有一堆历史贷款记录,每笔记录都标注了这个人最后有没有违约——这就是“有答案”,模型可以照着答案学,这叫监督学习。
但如果你手里只有一堆用户的消费数据,压根不知道该把用户分成几类、每类叫什么名字,这就是“没有答案”,只能让模型自己去找数据里的规律,这叫无监督学习。
第二个问题:模型最后要吐出来的是什么?
预测“这个用户会不会流失”,答案是“会”或“不会”,这是类别,对应分类问题。预测“下个月能卖出多少件”,答案是一个具体数字,这是回归问题。
第三个问题:一个模型说了算,还是一群模型一起投票?
一棵决策树自己拍板,这是单模型。而如果是一百棵树一起投票选多数意见,那就是集成模型。
把这三个问题在脑子里过一遍,接下来讲的十个算法,你其实可以先自己猜一猜它属于哪一类,猜完了再往下看答案,记忆会深刻很多。
十大算法速查表
CHEAT SHEET · 一张全景图
先给一张全景图,心里有个数:
接下来按“从直觉到抽象”的顺序,一个个拆开讲。
监督学习:有答案可以照着学
SUPERVISED · 六个算法逐个拆
监督学习的逻辑很像老师带学生做题——给你一堆题目和标准答案,你从中总结规律,以后遇到没见过的新题,也能照着规律给出答案。
KNN的原理说白了就一句话:找离自己最近的k个样本,看它们大多数是什么类别,自己就归为那一类。
举个例子,想判断一个新用户会不会喜欢某件商品,你不需要什么复杂模型,只要找出兴趣爱好最接近这个新用户的5个老用户,看看这5个人里有几个买过这件商品。买的人多,那就大概率推荐购买。
KNN有个挺有意思的特点,叫“懒学习”。别的模型训练阶段要拼命计算,它倒好,训练的时候几乎什么都不干,就是把数据存起来,真正的计算全留到预测的那一刻——来一个新样本,现场算距离,现场找邻居,现场投票。
也正因为这样,数据量一大,它预测起来就很慢;维度一高,“距离”这个概念也会变得没那么可靠。所以KNN更适合小数据、低维度的场景。
决策树做的事情,跟人做判断的思路几乎一模一样——不断提问,把问题范围越缩越小。
比如银行审批贷款,决策树可能是这么想的:收入超过10万吗?超过的话,再看信用记录好不好,好就批,不好就拒;收入没超过10万,直接拒。
这套逻辑写下来,业务人员一看就懂,不用你解释太多。这也是决策树最大的优势——可解释性强。很多场景里,模型给出结论不够,还得说清楚“为什么”,决策树天生适合干这个。
至于每一步该拿哪个特征来问、怎么切分才最合理,背后靠的是信息熵、信息增益、基尼系数这些指标,感兴趣的话可以单独展开讲,这里先不深挖。
如果要预测的是一个具体数字,比如房价,线性回归通常是最先被想到的方法。
它的思路是找一条直线(或者更高维的超平面),让这条线尽量贴合已有的数据点。比如房价可能跟面积、地段、房龄都有关系,线性回归就是要给这几个因素分别找一个合适的权重,加起来算出一个预测价格,然后让这个预测价格和真实成交价的误差尽可能小。
这个“误差尽可能小”用数学语言表达,就是让误差平方和最小,业内管这个指标叫MSE。不用记公式,记住这个思路就够了:找一条线,让它离所有点都尽量近。
ALGO 4Logistic回归:名字里带“回归”,干的却是分类的活
这是最容易被名字骗到的算法。
Logistic回归的做法是,先把各个特征线性组合一下,像线性回归那样算出一个数值,但这个数值不直接当结果用,而是丢进一个叫Sigmoid的函数里,转换成一个0到1之间的概率。
比如预测用户会不会购买,模型算出来的可能是0.87这个数字,代表购买概率87%,超过设定的阈值就判定为“会买”。
这里有个很多人会搞混的点:线性回归预测的是一个连续数字,比如具体的房价;Logistic回归预测的是一个概率,本质上还是在做分类。名字都叫“回归”,干的事完全不一样,记住这一点,面试被问到俩算法的区别就不会答错方向了。
假设有两类数据点,想找一条线把它们分开,其实能画出无数条线都能分开。SVM挑的不是随便一条能分开的线,而是离两边样本都尽可能远的那一条——间隔最大的那条分界线。
这么做的好处是,对新数据的容忍度更高。想象一下,如果这条线贴着某一类样本贴得很近,稍微来个新样本就可能站错边;但如果这条线两边留足了空间,判断起来就稳当得多。
SVM还有个特点是不太依赖海量数据就能学出不错的效果,所以在高维文本分类、生物信息这些样本量不算大、但特征维度很高的场景里特别吃香。
垃圾邮件过滤是朴素贝叶斯最经典的应用场景。一封邮件里如果频繁出现“中奖”“免费”“限时优惠”这些词,模型会根据这些词在垃圾邮件里出现的概率,反推这封邮件是垃圾邮件的可能性有多大。
这背后用的是贝叶斯公式——已知一些证据,推算某个结论成立的概率。
至于为什么叫“朴素”,是因为它做了一个简化假设:每个特征之间互相独立,互不影响。现实里这个假设其实很难完全成立,一个词出现往往会影响另一个词出现的概率。但神奇的是,在文本分类这种特征数量巨大的场景里,朴素贝叶斯即便假设不完全准确,效果依然很能打。
无监督学习:没有标准答案,自己找规律
UNSUPERVISED · 数据里自己摸索
前面六个算法,好歹都有“标准答案”可以照着学。接下来这两个算法就不一样了,没人告诉它正确答案,全靠自己在数据里摸索规律。
ALGO 7K-means:老师说分5组,学生自己凑堆
K-means要解决的问题很典型:一堆用户数据,没有任何标签,但想把他们自动分成几类,比如高消费用户、高频购买用户、低价值用户。
它的做法是先随便定几个中心点,然后让每个数据点找离自己最近的中心归堆,归堆之后再重新计算每堆的中心位置,如此反复,直到中心点不再变化。
这里有个绕不开的问题:你得提前告诉模型要分成几类,也就是k值是多少。分3类还是5类,效果可能天差地别,而这个数字并不总是那么容易确定。
另外K-means默认每一类数据大致长得像个圆球,如果实际的数据分布形状很不规则,它就容易分错。这也是DBSCAN要登场的原因。
DBSCAN换了个思路,不看“离哪个中心最近”,而是看“周围人多不多”。数据点扎堆密集的地方,自动被划成一个簇;那些孤零零、周围没什么邻居的点,直接被判定为噪声点、异常点。
这跟K-means比起来,有几个明显不同:
所以像异常交易检测、地理位置聚类这类场景,数据分布形状复杂、还需要识别噪声点,DBSCAN往往比K-means更合适。
集成学习:一群模型比一个模型靠谱
ENSEMBLE · 群智优于个体
前面讲的都是“一个模型自己拿主意”,接下来这两个算法的核心思路完全不同——找一群模型一起判断,再把结果综合起来。这也是数据竞赛和工业界用得最多的一类方法。
随机森林的做法很直接:训练一大堆决策树,每棵树训练时用的数据和特征都是随机抽出来的一部分,不完全一样,这样每棵树学出来的判断标准都会有点差异。最后预测的时候,让所有树投票,少数服从多数。
这套思路在统计学里叫Bagging。核心逻辑是:单棵决策树很容易因为训练数据的一点点波动就学出完全不同的规则,不太稳定;但很多棵不完全一样的树凑在一起投票,个体的偏差会互相抵消,整体反而稳了。用一句话说就是降低方差。
如果说随机森林是“一群人各自独立判断再投票”,AdaBoost走的是另一条路——一群人接力,后面的人专门盯着前面的人做错的题。
具体流程是这样的:先训练一个比较简单的弱分类器,看看它把哪些样本判断错了,把这些判断错的样本的权重调高,再训练下一个分类器,这个分类器就会更加关注上一轮做错的那些样本。这样一轮接一轮地训练下去,最后把所有弱分类器按各自的表现加权组合起来。
这套思路叫Boosting,跟随机森林最大的区别是,这些模型不是同时独立训练的,而是一个接一个串行训练的,后面的模型是在纠正前面模型的错误。用一句话说就是降低偏差。
现在可以回答开头那个面试问题了
Q&A · 森林 VS AdaBoost
回到文章开头那个让朋友卡壳的问题——随机森林和AdaBoost的区别,现在应该很清楚了:
不要迷信任何一个模型,让多个模型互相纠错、互相制衡
集成学习说到底就是这一句话
不懂技术也能用:三步判断框架落地到业务里
APPLY · 框架套进业务场景
如果你不是做算法的,只是想知道遇到实际问题该怎么想,前面那三个问题依然管用,只是换成业务场景来套:
想预测“下个季度能卖多少货”
有历史销量数据,要预测的是一个具体数字,这就是监督学习里的回归问题,线性回归就能上手试试。
想知道“哪些用户下个月可能会流失”
有历史数据,预测的是“流失”或“不流失”这样的类别,这是监督学习里的分类问题,决策树、随机森林都合适。
想把“十万用户自动分成几类做精细化运营”
完全没有标签,这就是无监督学习,K-means是最常见的起点。
不用记住每个算法的数学公式,记住这套判断逻辑,遇到实际问题至少能知道该往哪个方向去找工具。
看到这里,信息量确实不小,给一份浓缩版,方便截图保存,复习的时候五分钟就能过一遍:
这十个算法看着分散,名字也各不相同,但拆开来看,其实都在回答同一个问题:怎么从已有的数据里找到规律,再用这个规律去预测还没发生的事。
搞懂了这张地图,以后再往深度学习、推荐系统、大模型应用这些方向学,底层逻辑是相通的,理解起来会顺畅很多。
这篇建议收藏一下,面试前翻出来过一遍应该能省不少事。你工作或学习中用得最多的是哪个算法?评论区聊聊。



