我的看法是:不要搞二选一,并行学最好,但要以能跑通模型为第一目标。
因为准研一最容易踩的坑,就是不知道先学什么、学到什么程度、学完之后又该干什么。
这里我自己也整理了一份《准研一深度学习实战工具包》,里面放了PyTorch常用代码模板、深度学习实战项目、经典模型复现清单、深度学习数据集,刚好对应新手前期最容易卡住的“代码、项目、数据、复现”几个环节,拿来就能用!
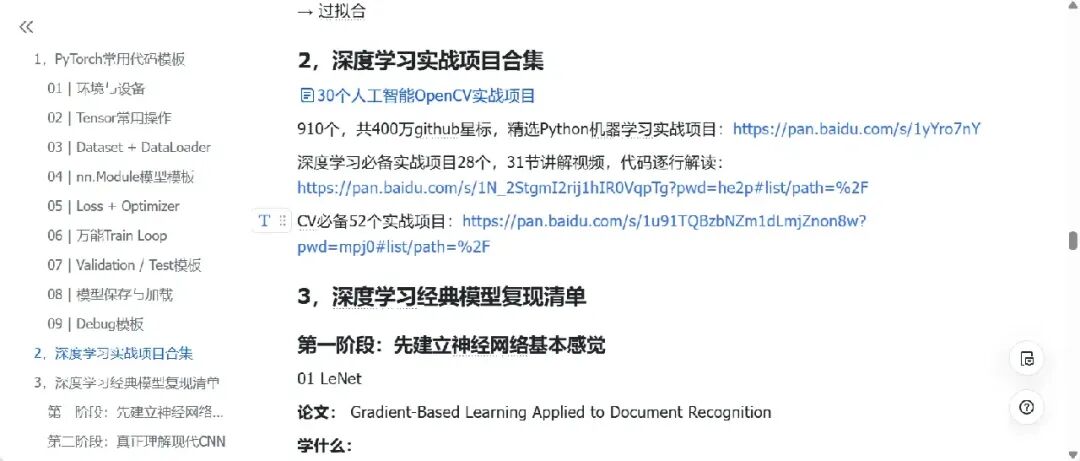
如果你也是零基础准备入组,可以先收着,扫码加小享让TA无偿发你就行,下面这套路线基本可以直接照着走。
分享我的实操路线(四周速通版)
第一周:装好Python、PyTorch、CUDA,学会张量操作(torch.tensor、matmul)。不用深究,能跑通官方60分钟入门就行。
第二周:边看吴恩达的线性回归、逻辑回归(只看前几章),边用PyTorch手写一遍,把 nn.Linear 对应到权重,loss.backward() 对应到求导,optimizer.step() 对应到梯度下降。这一步打通理论和代码两部分。
第三周:搞懂多层感知机、激活函数、交叉熵,搭一个简单分类网络(比如全连接层识别Fashion-MNIST)。不用纠结反向传播的链式法则细节,只要先知道自动求导帮我算了就行。
第四周:找一个完整小项目(比如LeNet在手写数字上),完整走一遍:数据加载、训练、验证、画损失曲线、调参、诊断过拟合。跑通后,你基本就熟悉PyTorch套路了。
看到这里你发现没,准研一前期真正需要的就不是学完所有东西,而是先建立一个完整闭环:学概念→写代码→跑项目→看实验→复现模型→尝试修改。
所以我整理的那份工具包也没继续堆各种课程,而是按照这个闭环整理的。
这样你缺项目,就从里面挑一个;不知道用什么数据,就直接找数据集;不知道经典模型怎么入手,就按复现清单来。可以说你今天拿到,明天就能开始写代码 。
理论怎么补?
不要一上来就啃西瓜书或花书了,真的很容易劝退。优先搞懂三个核心:线性回归(理解权重和损失)、逻辑回归(理解分类和激活)、多层网络(理解反向传播的大致含义)。遇到矩阵求导、概率统计卡壳时,再去B站搜相关的视频定点补,教材当字典用。
吴恩达课程可以当综述听,但不用全刷;李沐的《动手学深度学习》直接照着敲代码,比看书管用。
然后呢?
四周后,你已经有跑得通的模型了。这时候就可以去找师兄师姐问清组里GPU怎么用、代码规范是什么,然后找2~3篇近年的方向综述,挑有开源代码的经典模型(比如ResNet、ViT)复现。复现完再读论文,把别人的小改进往里加,看性能变不变。
这里要记住:读论文先看摘要,创新点能看懂就继续,看不懂直接跳过。攒两个有效改进,找导师聊,能发就赶紧发,第一次写论文会恶心到怀疑人生,但走完一遍后,后面会快很多。
最后的建议
如果你只想毕业找工作,研一可以不用太苦,多享受生活;如果想读博或卷科研,那一定别在基础理论里耗太久。计算机这行讲究“不要重复造轮子”,前人把工具封装好,就是为了让我们站在肩膀上跑得更快。基础是慢慢补的,但论文是按时要出的。
总之,上午学概念,下午写代码,晚上看实验现象,这样一个月后你既能跑模型,也能讲清原理,这才是导师想要的,别当纯调包侠,也别当纯理论家,站中间走最快。



