OPENAI · IMAGE PROMPTING
GPT Image 2.5
提示词指南
选择模型,编写有效的提示词,并在多次编辑中保留细节。
原文:OpenAI 图像提示词文档
https://developers.openai.com/api/docs/guides/image-prompting
概览
先明确你需要什么图像,再描述主体、构图、风格和约束。进行编辑时,指出哪些内容需要修改、哪些内容必须保留。每次只调整一项,并检查结果。
GPT Image 2.5 提供两种模型。GPT Image 2.5 Flare 是针对速度优化的小型模型,图像质量与 GPT Image 2 相当。GPT Image 2.5 Sunburst 是针对质量优化的基础模型,图像质量高于 GPT Image 2。两种模型都改进了精确编辑和主体保留能力。
API 设置和请求示例见图像生成指南。
选择模型
对于新的工作流程,如果优先考虑速度,可以从 GPT Image 2.5 Flare 开始;如果优先满足较高的质量要求,可以从 GPT Image 2.5 Sunburst 开始。输出达到要求后,再寻找降低延迟的机会。
从当前图像模型迁移时,以现有图像质量为起点。两种模型都支持图像生成、编辑和透明背景。
| |
|---|
| 已经过验证的 GPT Image 2 工作流程已满足质量要求 | GPT Image 2.5 Flare。检查能否在保持可接受质量的同时降低延迟。 |
| GPT Image 2 无法满足质量要求的复杂用例 | GPT Image 2.5 Sunburst。先确认它能提供所需的质量。 |
如果 GPT Image 2.5 Sunburst 满足质量要求,再使用相同的提示词和输入测试 GPT Image 2.5 Flare。如果 Flare 也满足要求,并且缩短了响应时间,就切换到 Flare。如果工作流程需要 Sunburst 的质量优势,则继续使用 Sunburst。
使用你自己的工作负载测量响应时间和质量。结果取决于提示词、参考图、输出尺寸和质量设置;某一种工作负载的提速幅度,无法确定另一种工作负载也会获得相同幅度的提升。
模型参数
API 参数应与提示词分开设置。
| |
|---|
model | gpt-image-2.5-flare(小型模型)或 gpt-image-2.5-sunburst(基础模型) |
quality | auto(默认)、low、medium、high、
xhigh 或 max |
size | auto 或自定义分辨率。常用尺寸:1024x1024(正方形)、1536x1024(横向)、1024x1536(纵向)、2048x2048(2K 正方形)、2048x1152(2K 横向)、3840x2160(4K 横向)、2160x3840(4K 纵向) |
background | auto |
自定义分辨率使用 WIDTHxHEIGHT 格式,并遵守以下限制:
- • 总像素数必须在 655,360 至 8,294,400 之间。
总像素数超过 3,686,400(2560x1440)的输出属于实验性功能。
调整 quality 之前,先按上述流程选择模型。首次比较时,如果两种模型都支持你明确选定的质量设置,应保持该设置一致,同时保持提示词、参考图和输出尺寸一致。同一个质量档位名称,在不同模型上对应的图像质量和响应时间可能不同。
如果输出未达到要求,测试更高的质量档位。达到要求后,测试较低的档位,看看能否在保持可接受质量的同时缩短响应时间。只有当 xhigh 或 max 能在允许的延迟范围内改善尚未满足的质量要求时,才使用它们。提高档位无法保证每个提示词都获得更好的结果。
制作透明素材时,明确设置 background="transparent",并使用 PNG 或 WebP。检查解码后图像的 Alpha 通道,包括头发、玻璃、阴影和物体边缘。output_compression 仅用于 JPEG 或 WebP 输出,PNG 不使用此参数。
迁移现有工作流程
- 1. 保存基准。 收集具有代表性的生产环境提示词和参考图,包括高难度编辑、精确文字、人脸、产品几何形状和透明素材。记录当前模型、请求设置和结果。
- 2. 选择第一个候选模型。 如果 GPT Image 2 已满足质量要求,从 GPT Image 2.5 Flare 开始测试延迟是否改善。如果 GPT Image 2 在复杂用例中表现不足,从 GPT Image 2.5 Sunburst 开始,先确认它满足质量要求。首次比较时,保持提示词、参考图、尺寸和输出格式一致。
- 3. 检查完整结果。
比较指令遵循、人物身份与产品特征保留、文字准确性、非预期改动以及透明度。重复请求以测量一致性。对于编辑工作流程,既要测试单个步骤,也要测试完整的编辑序列。
- 4. 质量达标后再测试延迟收益。 如果最初使用 GPT Image 2.5 Sunburst,且它满足质量要求,再以同样的要求评估 GPT Image 2.5 Flare。只有质量仍然可接受、延迟也得到改善时才切换;否则继续使用 GPT Image 2.5 Sunburst。
- 5. 每次只调整一个设置。 先比较质量档位,再改写提示词。测量典型响应和较慢响应、失败、重试,以及每张通过验收的图像的成本。核实当前价格,避免直接假定速度更快的模型价格更低。
- 6. 按工作流程逐步上线。 已发布的模型通过验收标准后,先迁移一小部分流量,持续监测相同指标,再逐渐扩大范围。在旧模型仍受支持期间,保留它以便回退。
从 GPT Image 1 或 1.5 迁移时,请查看文末的参考内容,核对参数差异和停用日期。测试候选模型支持的请求设置,避免直接照搬旧设置。对于 GPT Image 2,在比较时保留现有的分辨率和透明背景要求。
反复编辑仍可能改变你希望保留的细节。重新说明这些约束,并检查每次结果。如果某个区域必须逐像素保持一致,请将验收通过的编辑部分合成到原图中,单靠提示词无法保证这一点。
提示词基础
- 1. 定义结果。 说明主体和预期用途,例如产品照片、广告或示意图。指定构图、宽高比和重要的位置约束。复杂请求可按场景、主体、细节和约束组织,并为各部分添加标签。
- 2. 选择便于维护的格式。 简短提示词、描述性段落、类似 JSON 的结构、指令和标签,都能表达相同的意图。选择最容易阅读和更新要求的格式,无需依赖特殊语法。
- 3. 描述可见细节。 说明材质、光线、颜色和表现媒介。如果目标是照片效果,明确要求“照片级写实”或“真实照片”,并描述取景和纹理。相机规格可以提示外观,但无法保证精确的物理模拟。对于宽幅、电影感、低光、雨景或霓虹场景,要说明尺度、氛围和色彩,避免只使用情绪词。
- 4. 说明人物和动作。 描述身体在画面中的范围、相对大小、视线,以及与物体的互动。例如“全身可见,包括双脚”“低头看着摊开的书”“双手自然握住车把”,可以更清楚地表达姿态和动作。
- 5. 指定准确文字。 将必须出现的文字放在引号中,并描述位置和字体排版。必要时,逐字母拼出不常见的词或品牌名。要求不添加额外文字,再检查输出中的拼写和可读性。对于小字、密集信息或多种字体,比较 medium 或 high 质量档位的表现。
- 6. 分别说明改动和约束。 编辑时,说明“只修改 X”,并列出需要保留的细节,例如人物身份、几何形状、布局、光线或标签。明确排除不需要的文字、标志或水印。对于精确的局部编辑,还要指出必须保持原样的饱和度、对比度、箭头、相机角度和周围物体。
- 7. 为参考图指定用途。 按编号说明每张输入图的用途:主体、风格、服装或背景。解释各输入如何组合,以及哪些元素应移动到哪里。
- 8. 有步骤地迭代。 将上一次输出作为下一次编辑的输入,每次提出一个改动,并重复需要保留的细节。“与之前相同的风格”等表述可以承接上下文;如果结果发生偏移,请重新说明关键约束。先比较结果,再增加更多指令。
下面的每个示例演示一种不同技巧。可以将这些提示词作为起点,根据自己的图像和要求进行调整。
生成图像
控制风格与光线
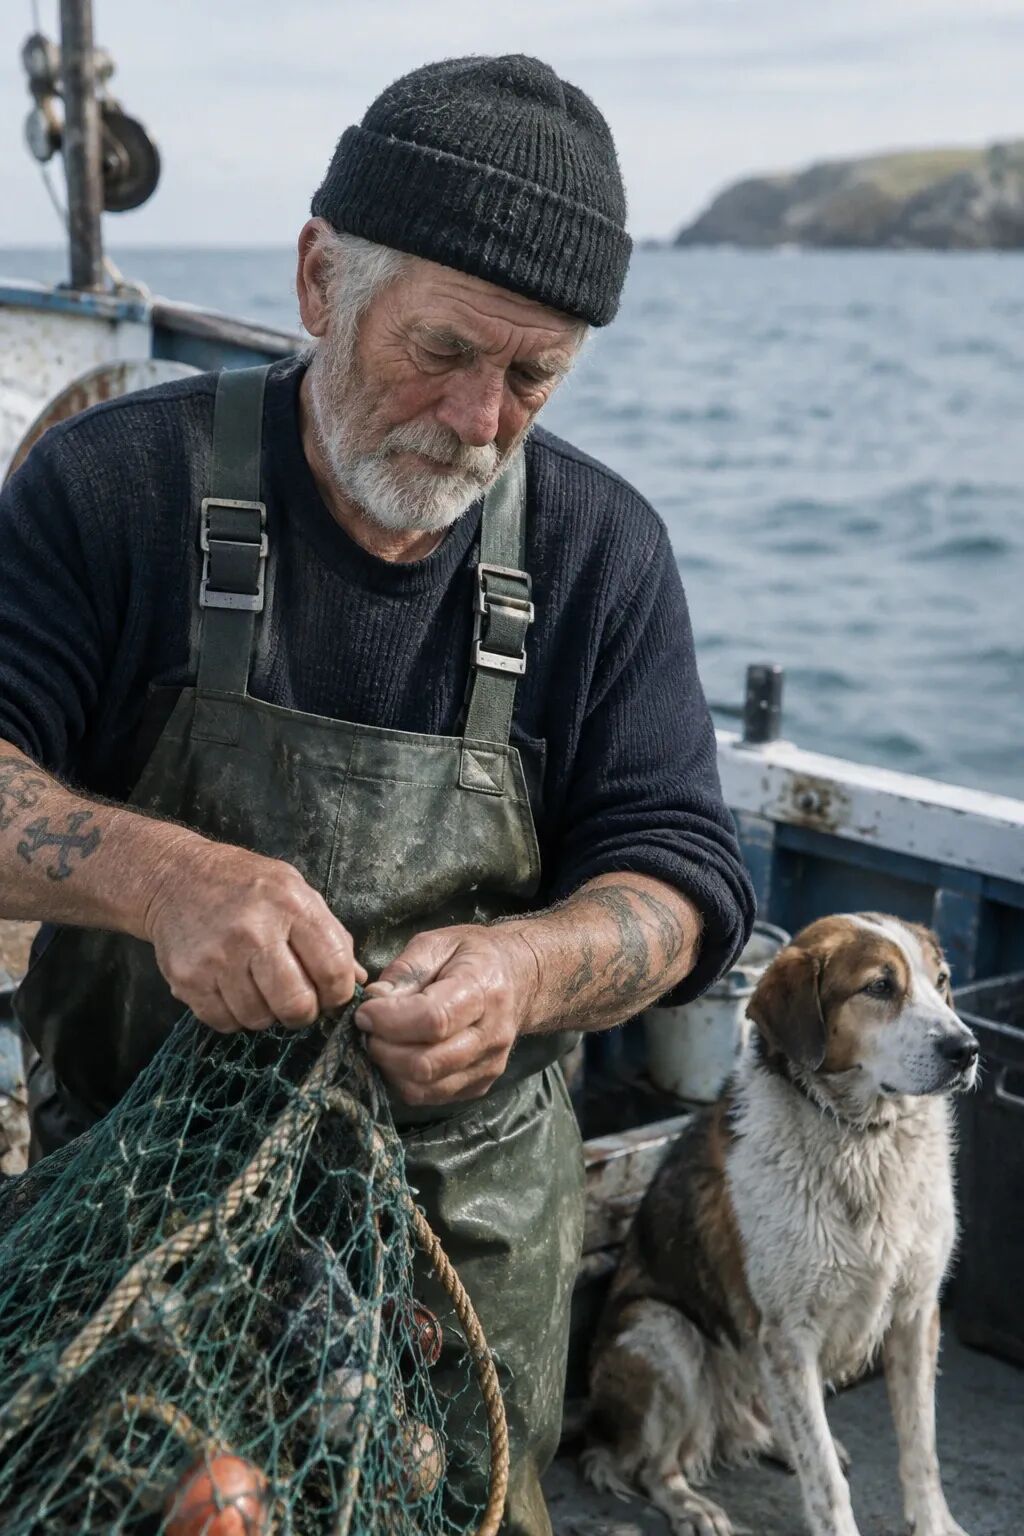
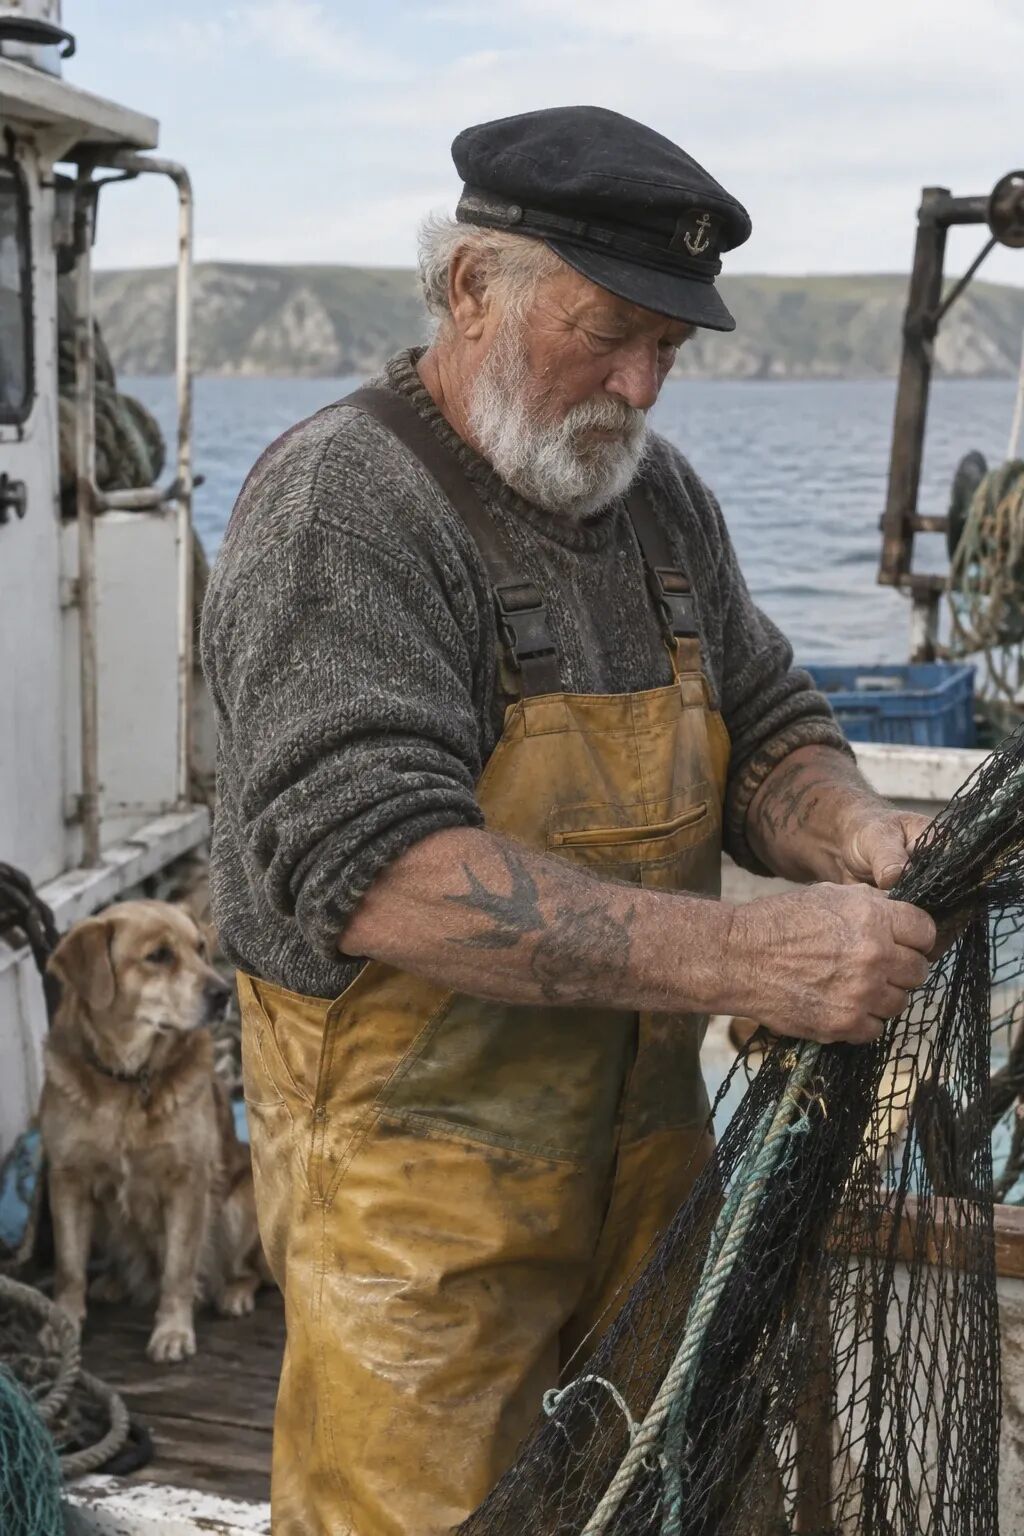
通过主体、取景、光线和纹理描述一张照片。本例指定了自然抓拍的构图,并明确排除重度修图。
生成设置:size="1024x1536" · quality="medium"。
提示词 · 01
创作一张照片级写实的自然抓拍照片:一位年长的水手站在一艘小渔船上。
他的皮肤饱经风霜,可以看见皱纹、毛孔和日晒留下的痕迹,手臂上有几处褪色的传统水手纹身。
他正平静地整理渔网,狗坐在附近的甲板上。画面呈现 35 毫米胶片照片的观感,以平视角度拍摄中近景,使用 50 毫米镜头。
柔和的海边日光,浅景深,细微的胶片颗粒,自然的色彩平衡。
图像应显得真实、没有摆拍感,保留真实的皮肤纹理、磨损的材质和日常细节。不要美化,不要重度修图。
输出示例 · 左右滑动查看
GPT Image 2.5 Flare
GPT Image 2.5 Sunburst
用图像解释一个过程
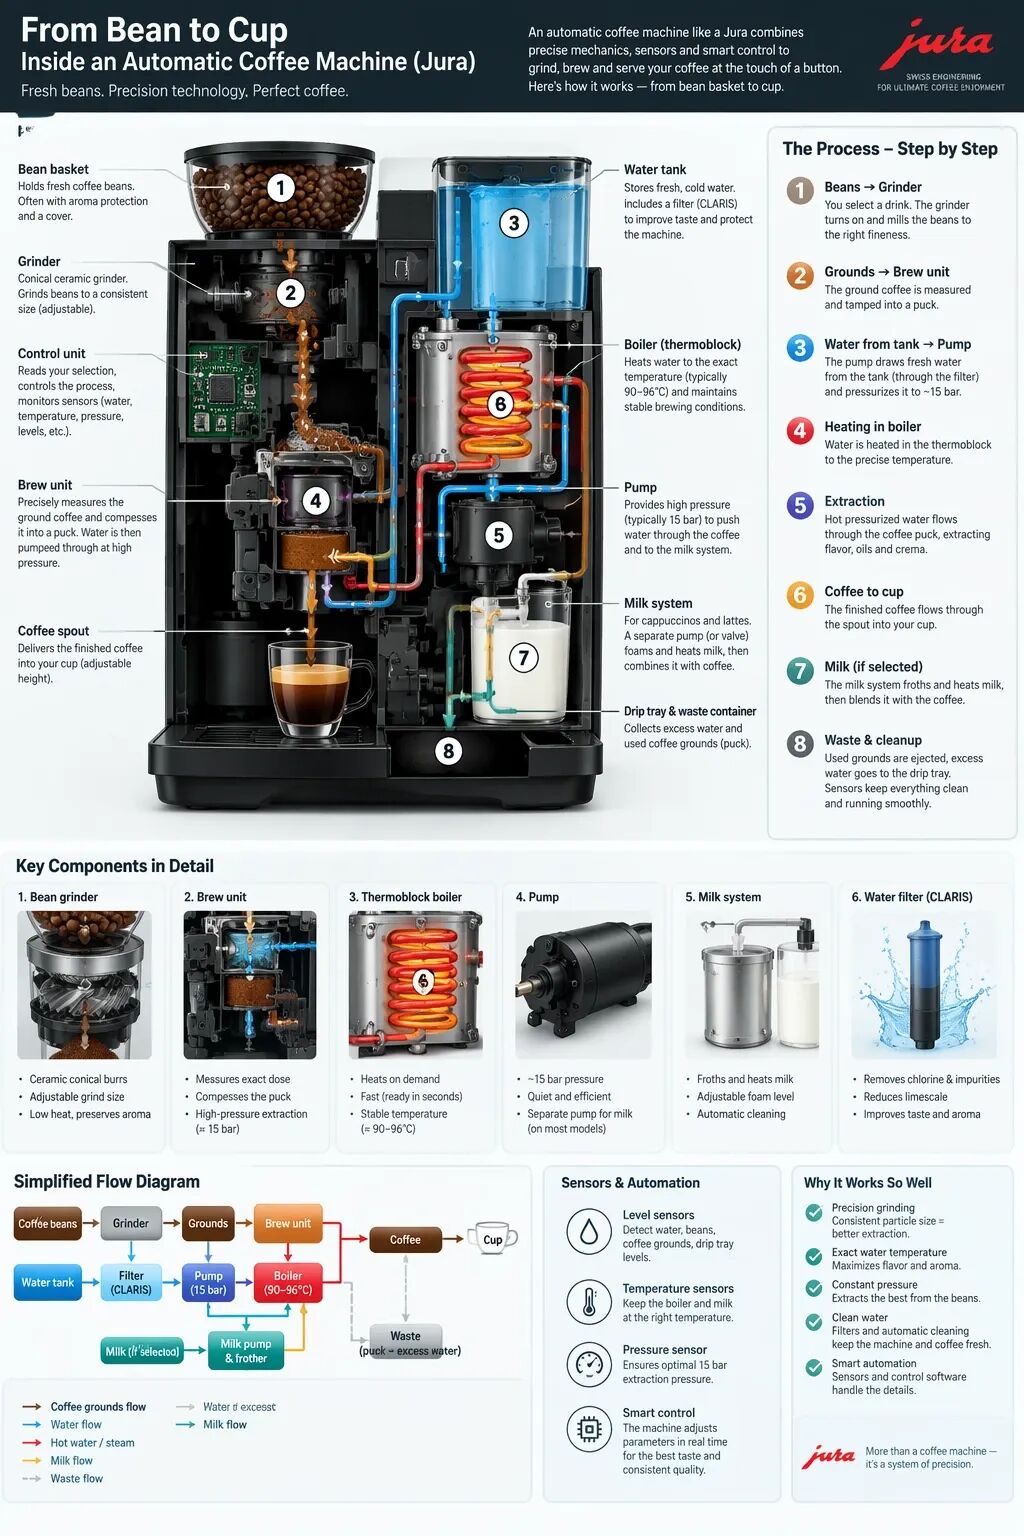
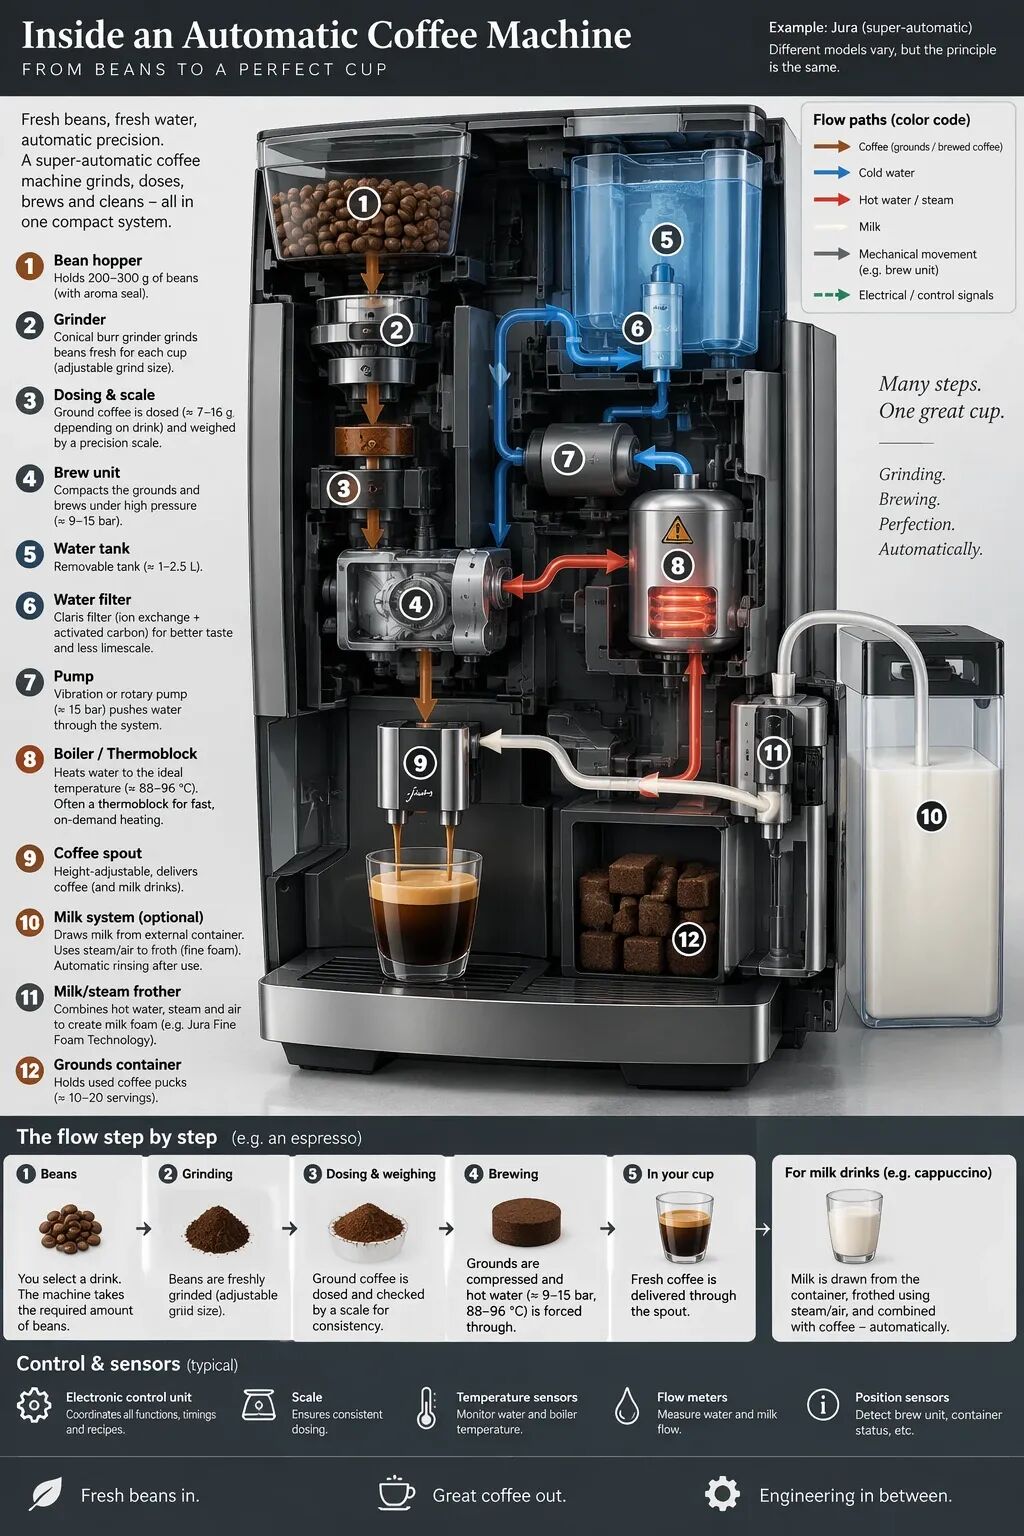
说明过程、受众,以及图像应传达的信息。对于示意图和信息图,除了检查外观,还要核实标签和事实关系。
生成设置:size="1024x1536" · quality="medium"。
提示词 · 02
制作一张详细的信息图,说明 Jura 一类全自动咖啡机的工作原理和流程。
从豆仓,到研磨、称重、水箱、锅炉等环节。
我希望从技术层面直观地理解整个流程。
输出示例 · 左右滑动查看
GPT Image 2.5 Flare
GPT Image 2.5 Sunburst
准确呈现指定文字
用引号标出必须出现的文案,并说明它应出现几次。指定受众和视觉处理方式,避免添加无关指令。
生成设置:size="1024x1536" · quality="medium"。
提示词 · 03
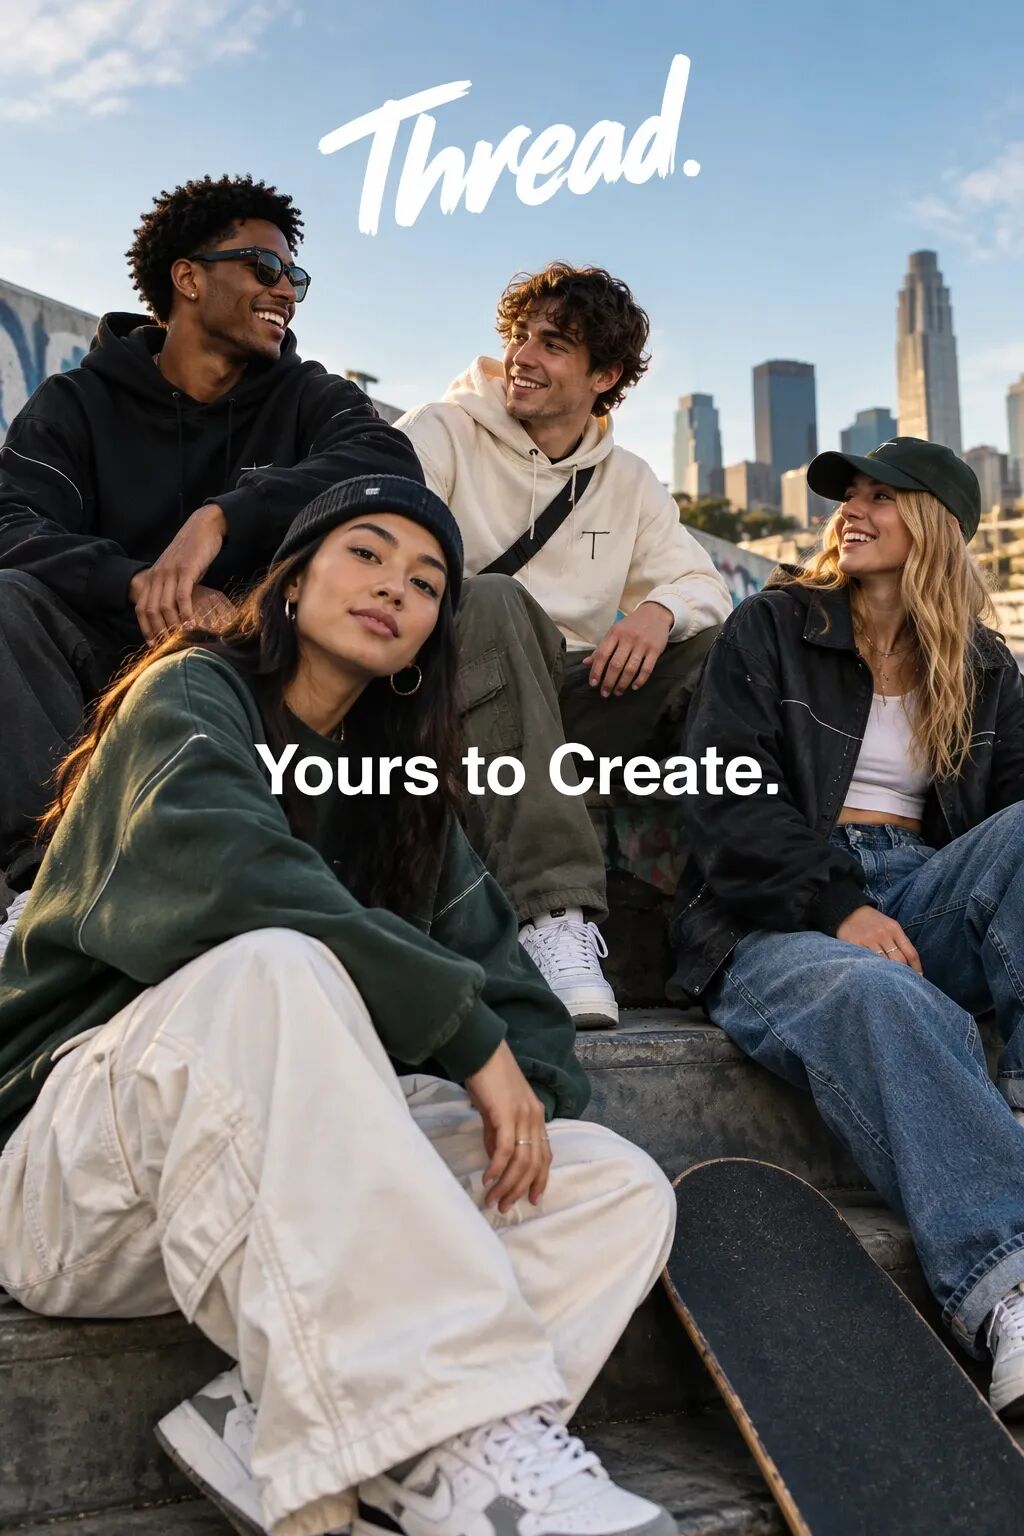
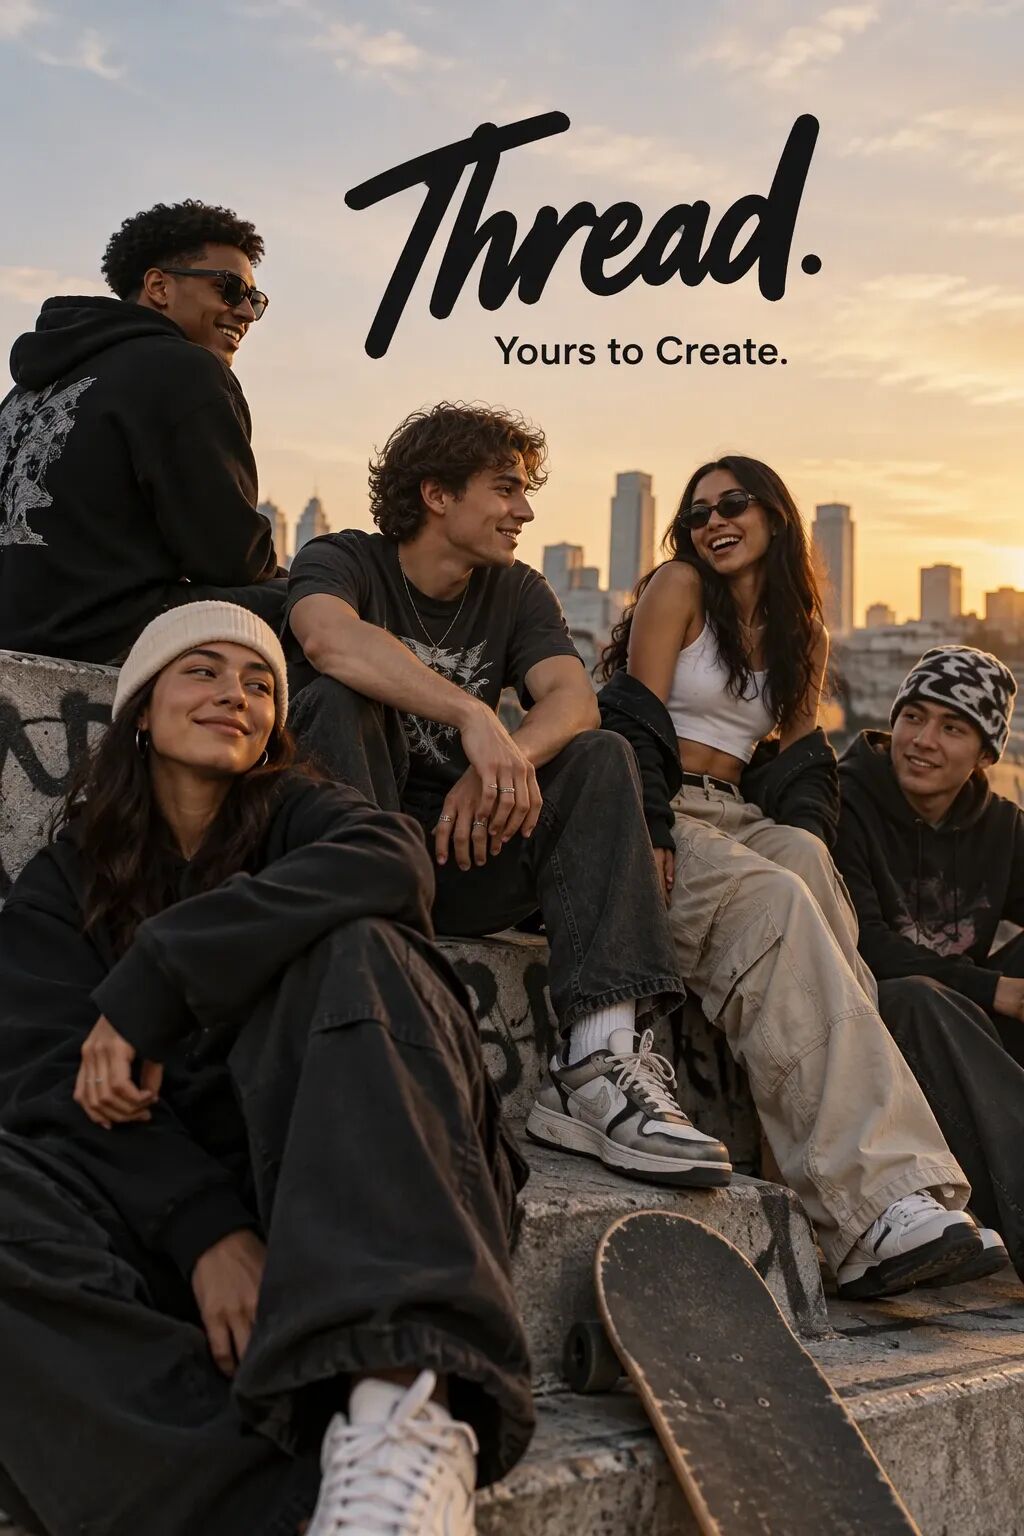
为一个名为 Thread 的品牌创作一张酷且贴近潮流文化的广告/时尚照片。
这是一个面向年轻人的潮流街头品牌。广告中是一群朋友聚在一起,配上标语“Yours to Create.”。
画面应像一张面向年轻街头服饰受众的成熟广告大片:时尚、当代、有活力,而且有品位。
采用干净的构图、明确的色彩方向、自然的姿态,以及高端时尚摄影的视觉特征。
标语准确出现一次,清晰易读,并融入广告版式。
不要额外文字,不要水印,不要无关标志。
文案译意:“Yours to Create.”:由你创造。
输出示例 · 左右滑动查看
GPT Image 2.5 Flare
GPT Image 2.5 Sunburst
设计可重复使用的标志
描述品牌,以及构成标志的主要形状。指定清晰的构图,使标志在不同尺寸下都容易辨认。使用 n 请求多个变体。
生成设置:size="1024x1536" ·
quality="medium" · background="transparent" · output_format="png" · n=1。
提示词 · 04
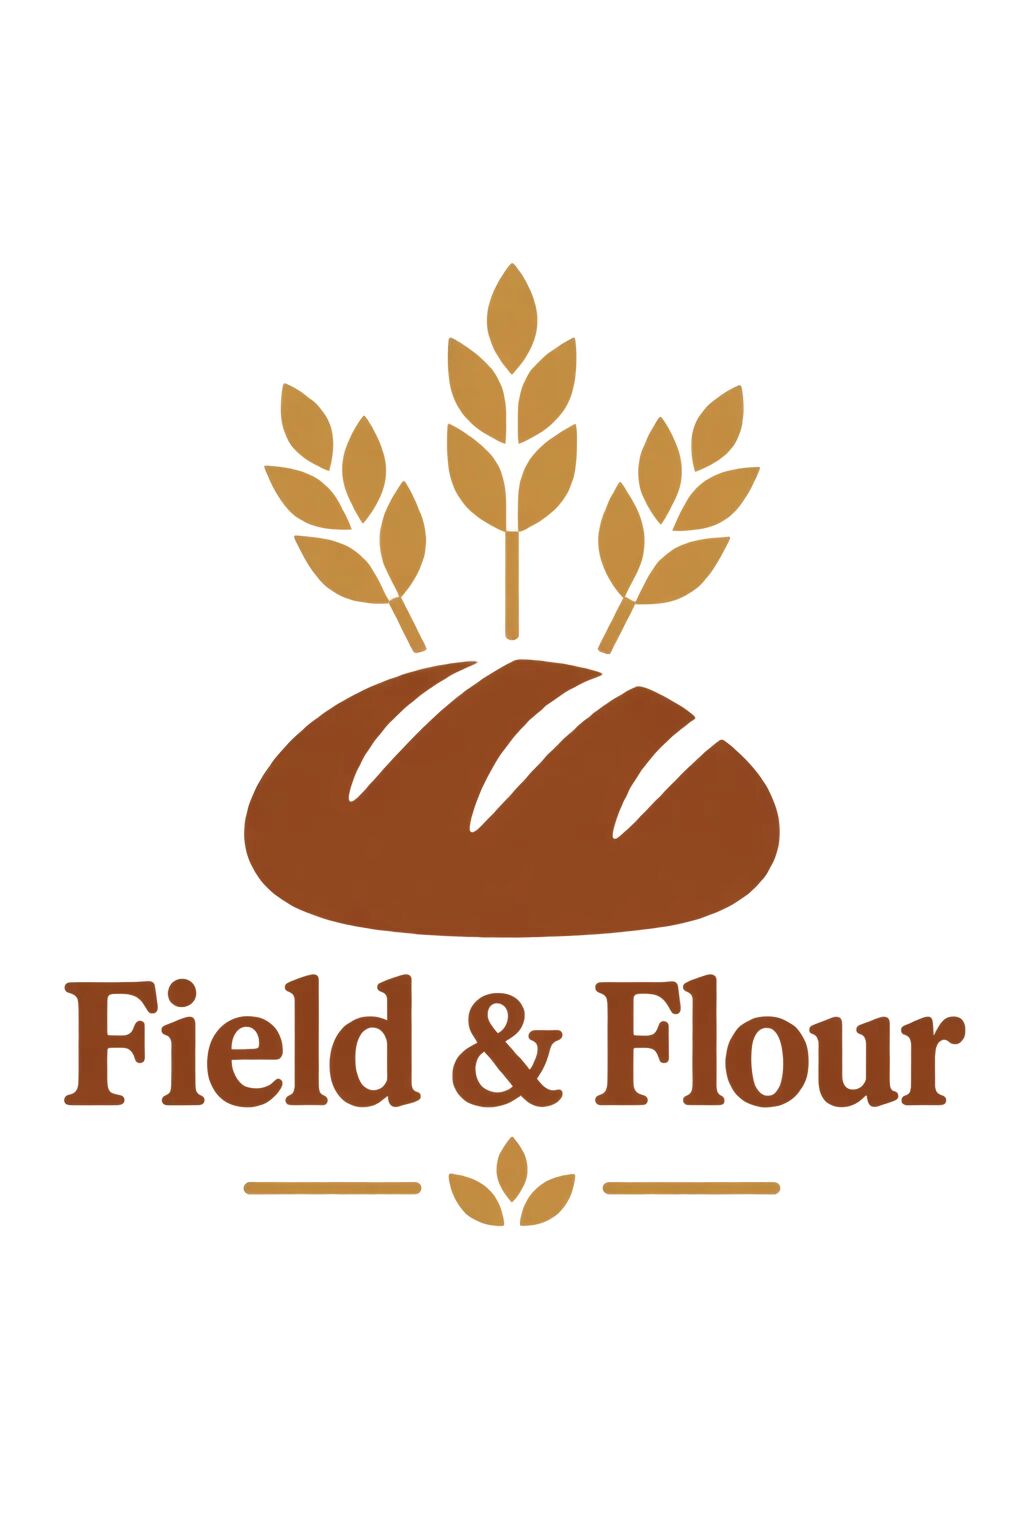
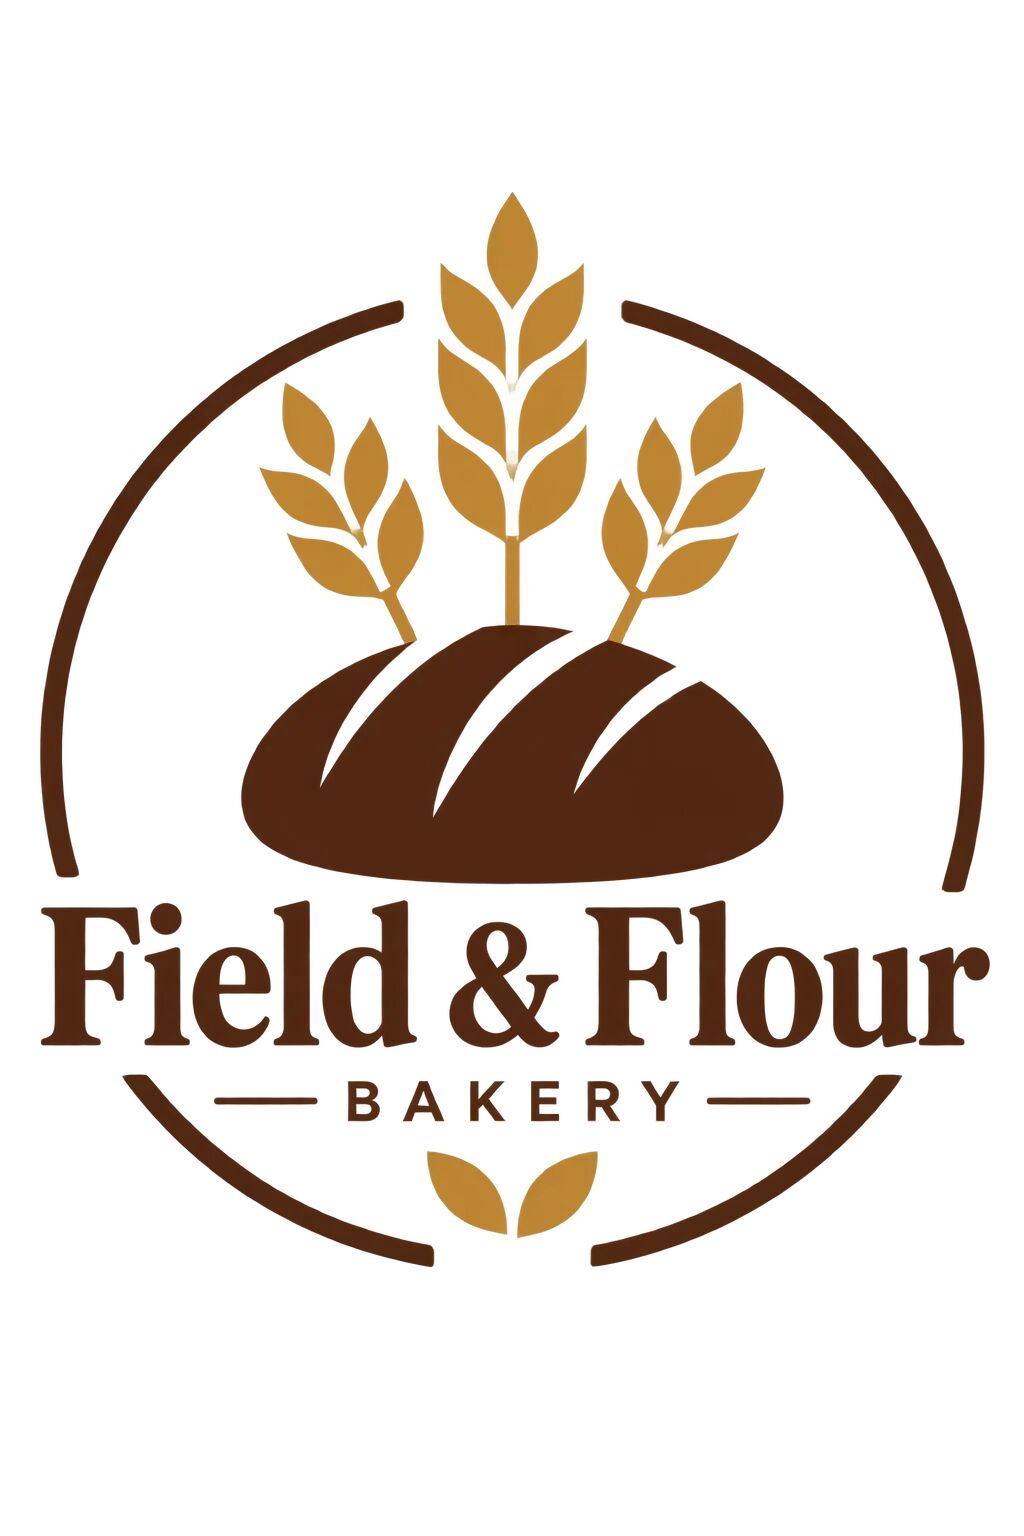
为一家名为 Field & Flour 的本地烘焙店创作原创、不侵权的标志。
标志应给人温暖、简洁、经久耐看的感觉。使用干净的类矢量形状、鲜明的轮廓,以及均衡的负空间。
优先保持简洁,减少细节,使其在小尺寸和大尺寸下都清晰可辨。采用扁平化设计,尽量减少线条;除非必要,否则不使用渐变。
背景完全透明。交付一个居中的标志,四周留白充足,Alpha 边缘干净,不要纯色底、场景、棋盘格或水印。
每一组对比两个模型各自生成的一个变体。
输出示例 · 左右滑动查看
变体 1 · GPT Image 2.5 Flare
变体 1 · GPT Image 2.5 Sunburst
变体 2 · GPT Image 2.5 Flare
变体 2 · GPT Image 2.5 Sunburst
变体 3 · GPT Image 2.5 Flare
变体 3 · GPT Image 2.5 Sunburst
变体 4 · GPT Image 2.5 Flare
变体 4 · GPT Image 2.5 Sunburst
使用历史与现实背景
说明地点和日期,以建立历史场景。模型可以推断背景细节,但仍需检查服装、场面布置和周围环境是否符合历史。
生成设置:size="1024x1536" · quality="medium"。
提示词 · 05
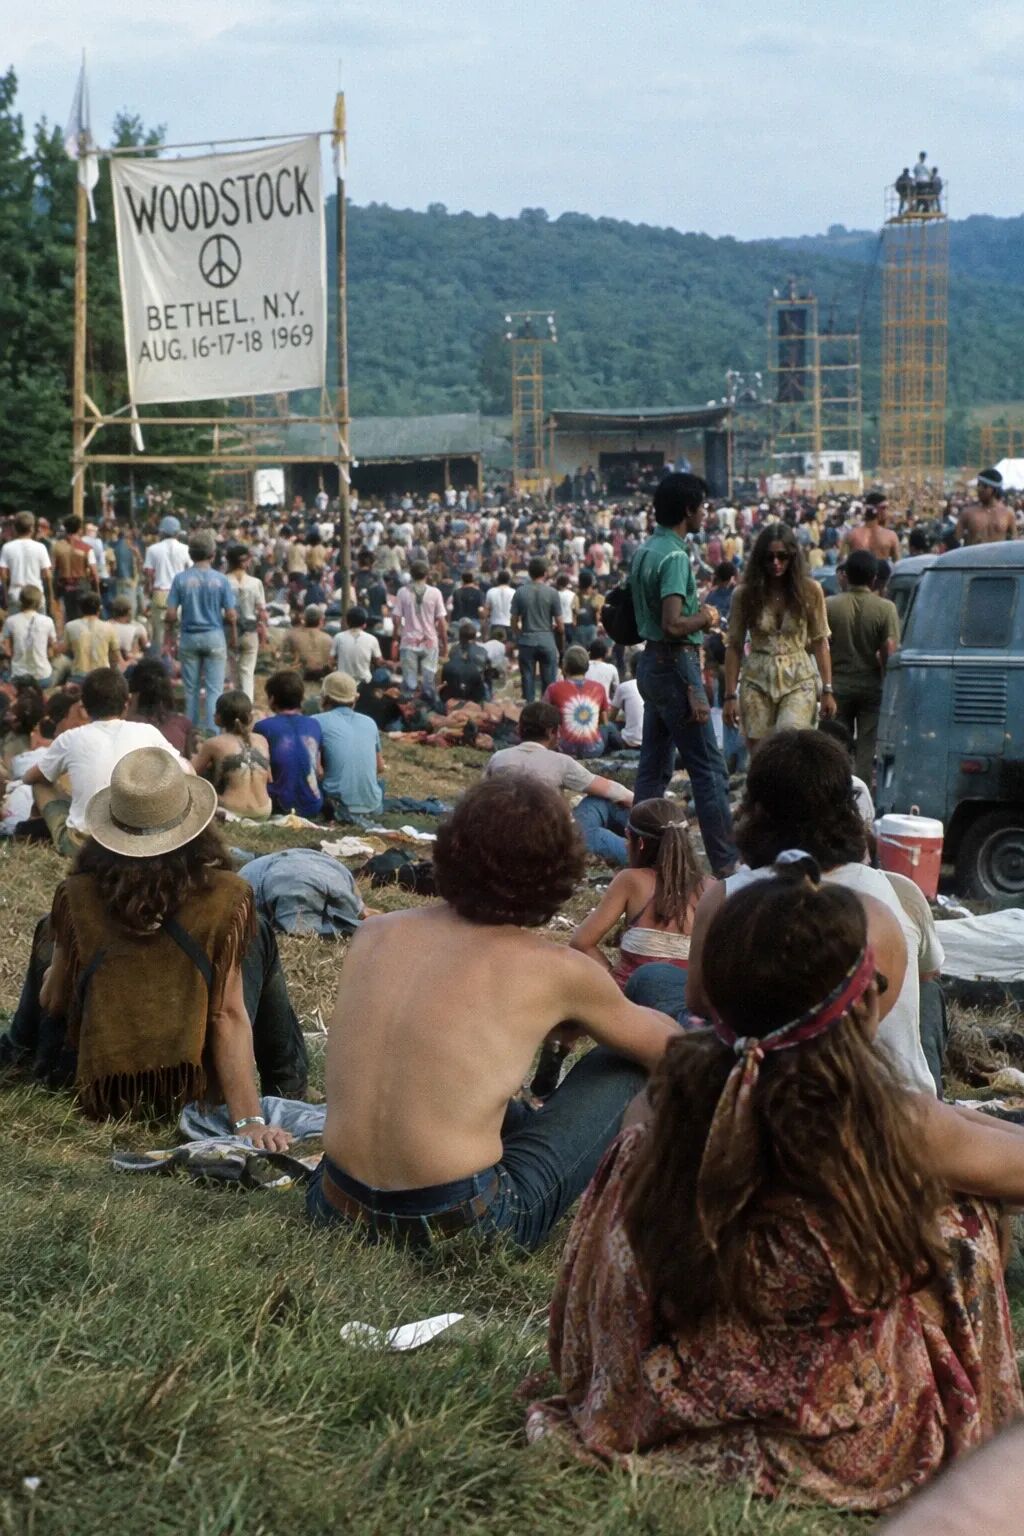
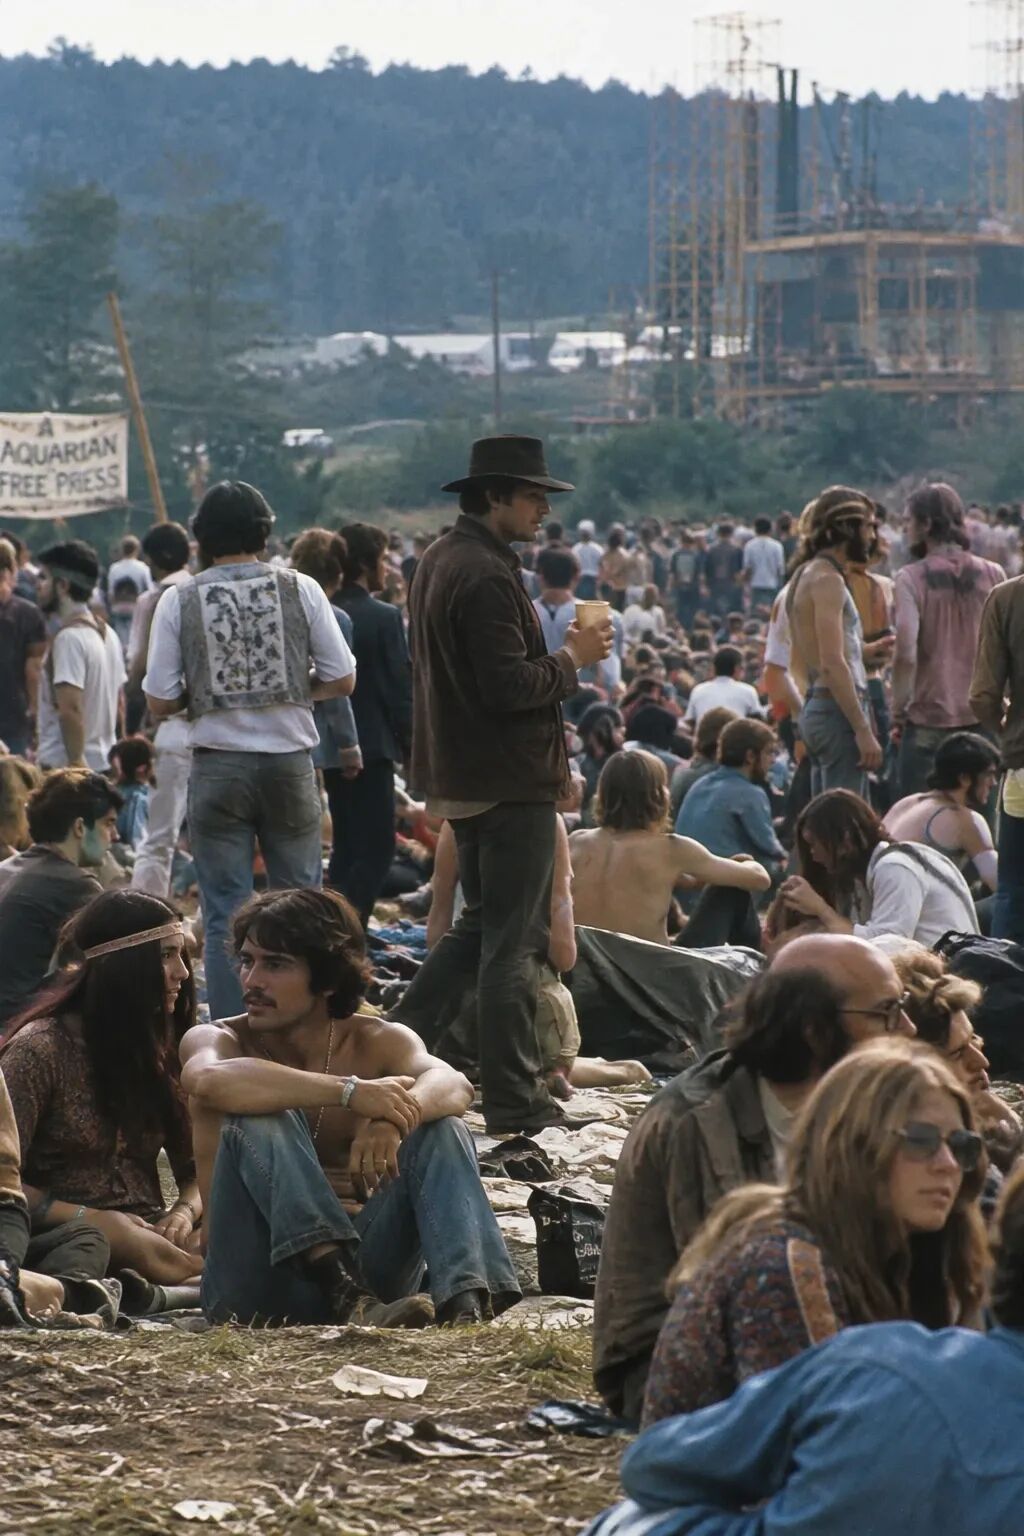
创作一个真实的户外人群场景,地点是纽约州贝瑟尔,时间是 1969 年 8 月 16 日。
照片级写实,服装、场面布置和环境符合当时的年代。
输出示例 · 左右滑动查看
GPT Image 2.5 Flare
GPT Image 2.5 Sunburst
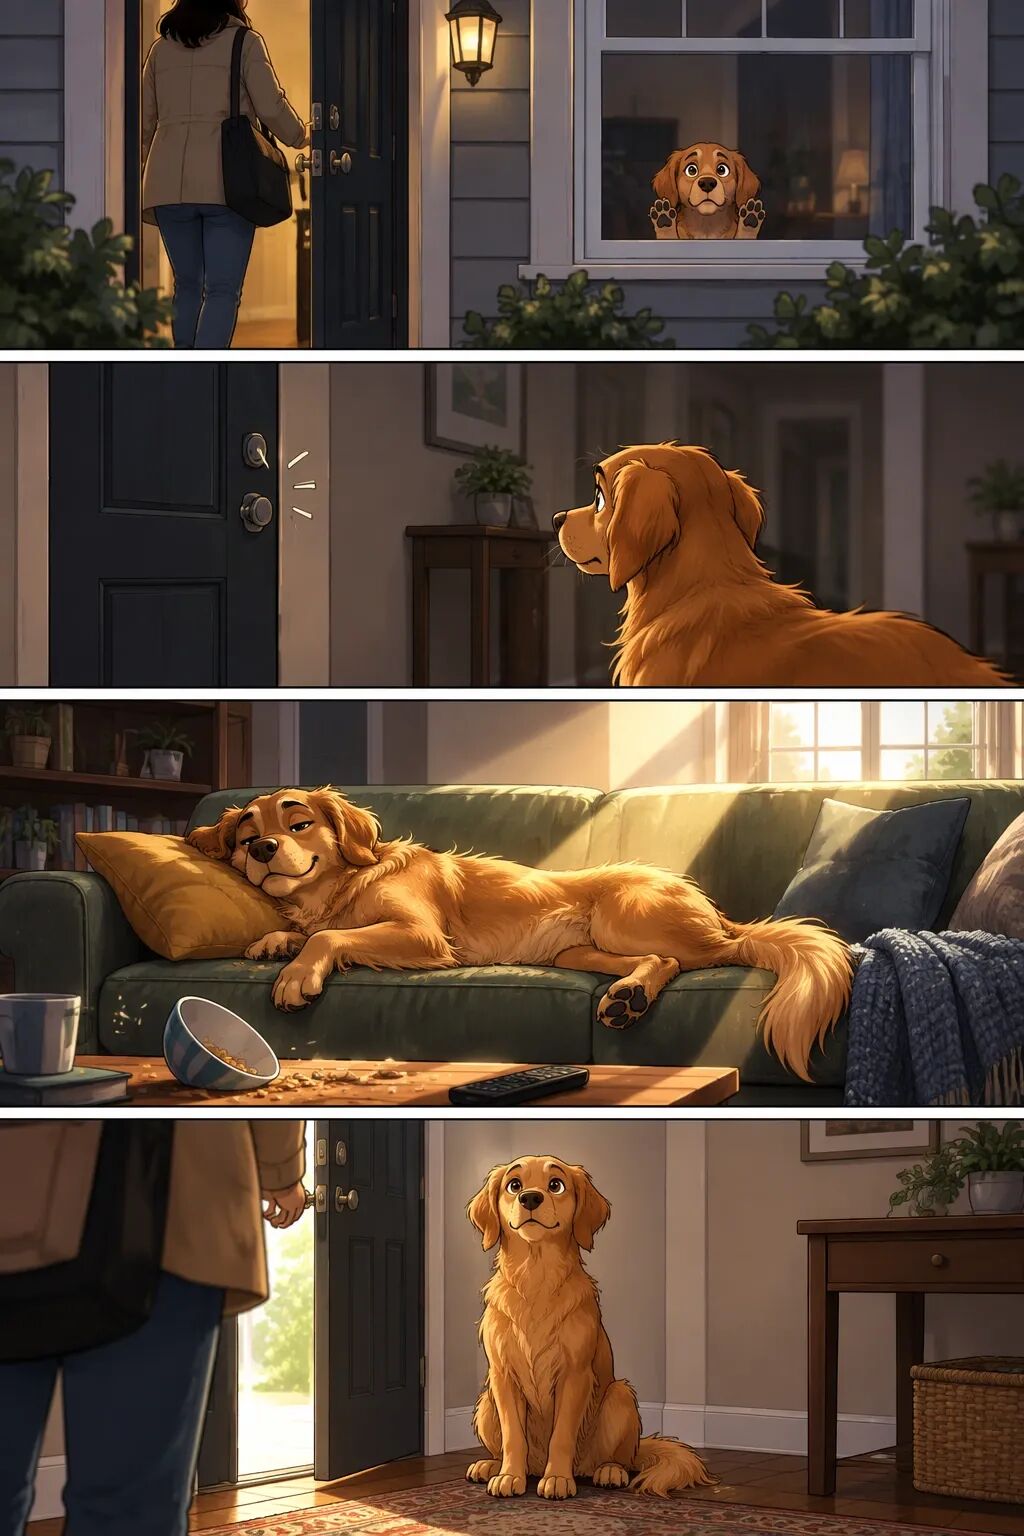
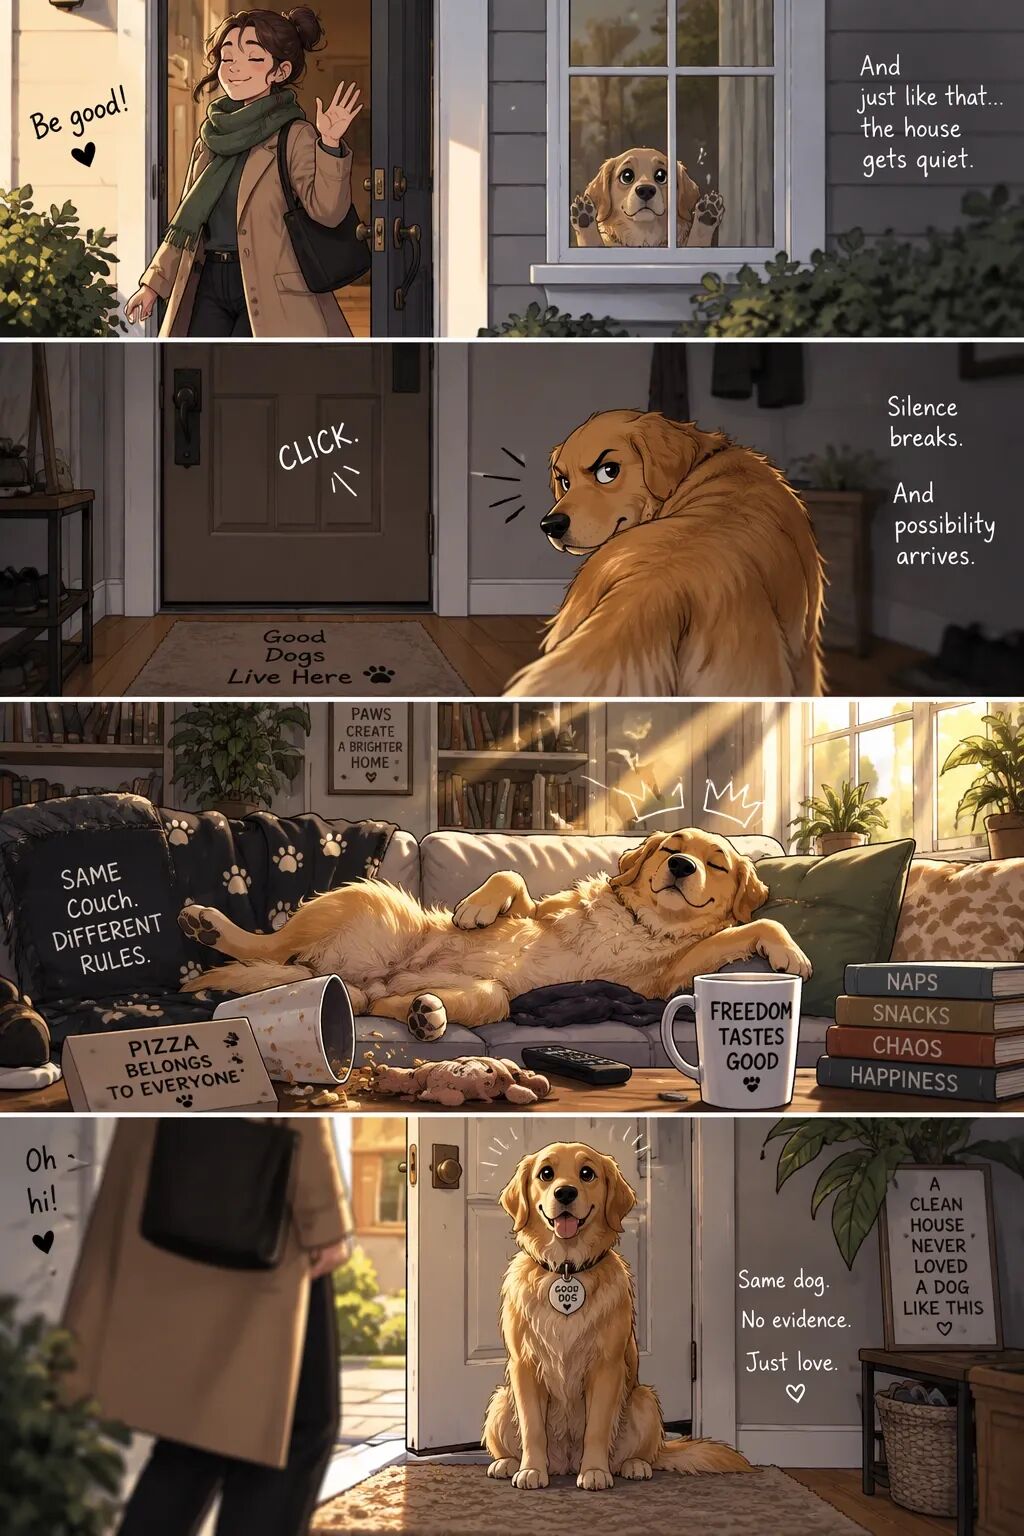
把故事变成连环漫画
将故事生成漫画时,把叙事拆成一连串清楚的视觉情节,每格对应一个情节。描述应具体,并以动作为重点,帮助模型将故事转化为易读、节奏恰当的画格。
生成设置:size="1024x1536" · quality="medium"。
提示词 · 06
创作一则由 4 格组成的竖版漫画短篇。
第 1 格:主人从前门离开。身后的窗户框住了宠物的身影;它在玻璃前显得小小的,眼睛睁大,爪子高高地贴着玻璃,屋子突然安静下来。
第 2 格:门咔嗒一声关上,打破了寂静。宠物慢慢转向空荡荡的房子,姿态发生变化,目光敏锐,仿佛发现了许多可能。
第 3 格:屋里变了样。宠物摊在沙发上,像是这里的主人,旁边散落着食物碎屑,阳光像聚光灯一样斜照进房间。
第 4 格:门开了。宠物端端正正地坐在入口旁,机警而镇定,仿佛什么都没发生。
输出示例 · 左右滑动查看
GPT Image 2.5 Flare
GPT Image 2.5 Sunburst
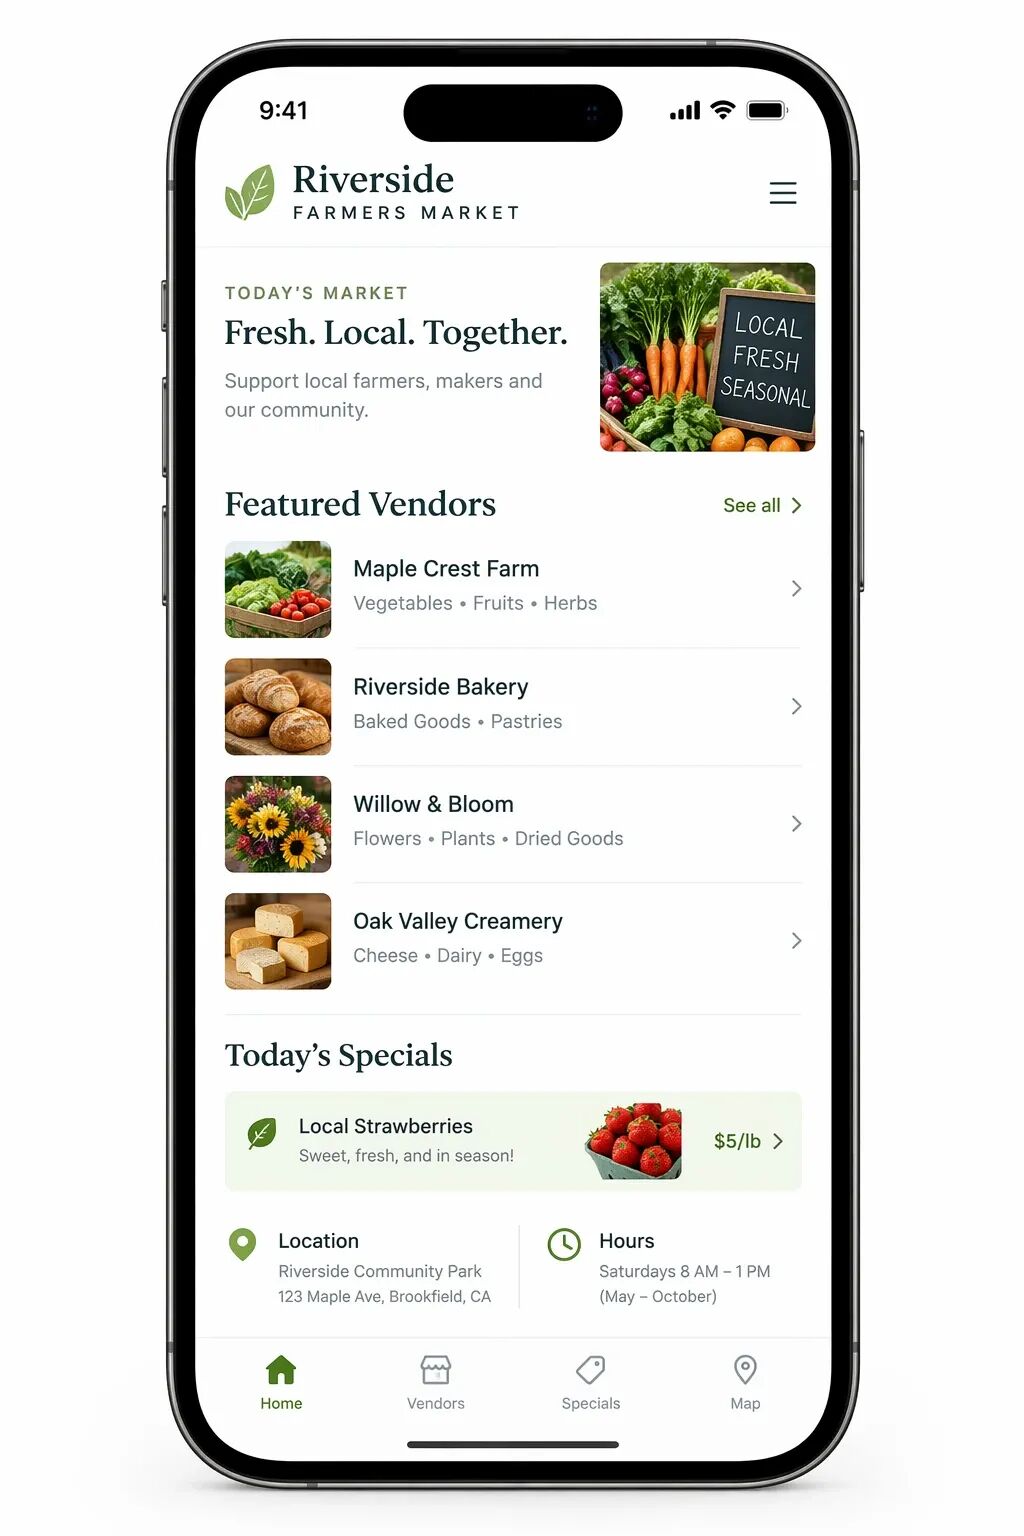
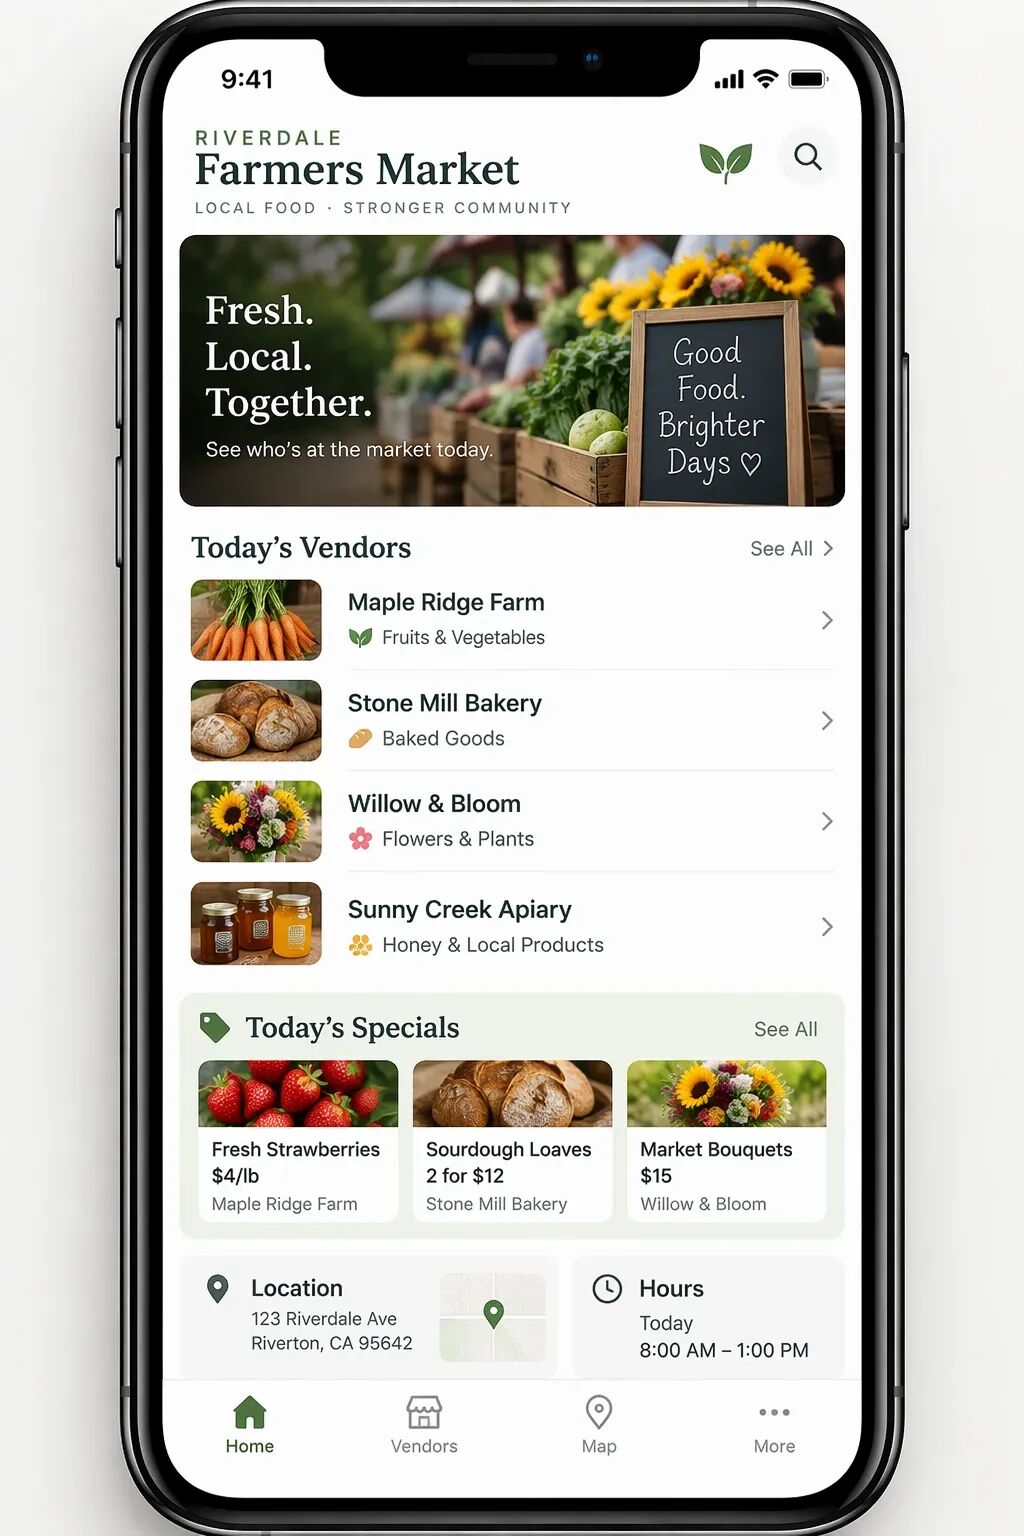
创建界面预览
描述界面预览时,将产品当作已经存在的产品来介绍,通常效果最好。重点说明布局、层级、间距和真实的界面元素,避免使用概念艺术式语言,让结果呈现出可实际使用、已经上线的界面质感。
生成设置:size="1024x1536" · quality="medium"。
提示词 · 07
为一个本地农夫市集创建真实的移动应用 UI 模型图。
展示今日市集:简洁的页头、带小照片和分类的简短摊主列表、小型“今日特惠”区域,以及地点和营业时间等基本信息。
设计应实用、易于操作。白色背景,柔和的自然色点缀,清晰的字体排版,尽量少用装饰。
它应像一款为本地小型市集打造的真实应用,设计合理且美观。
将 UI 模型图放入 iPhone 边框中。
输出示例 · 左右滑动查看
GPT Image 2.5 Flare
GPT Image 2.5 Sunburst
制作科学与教育图像
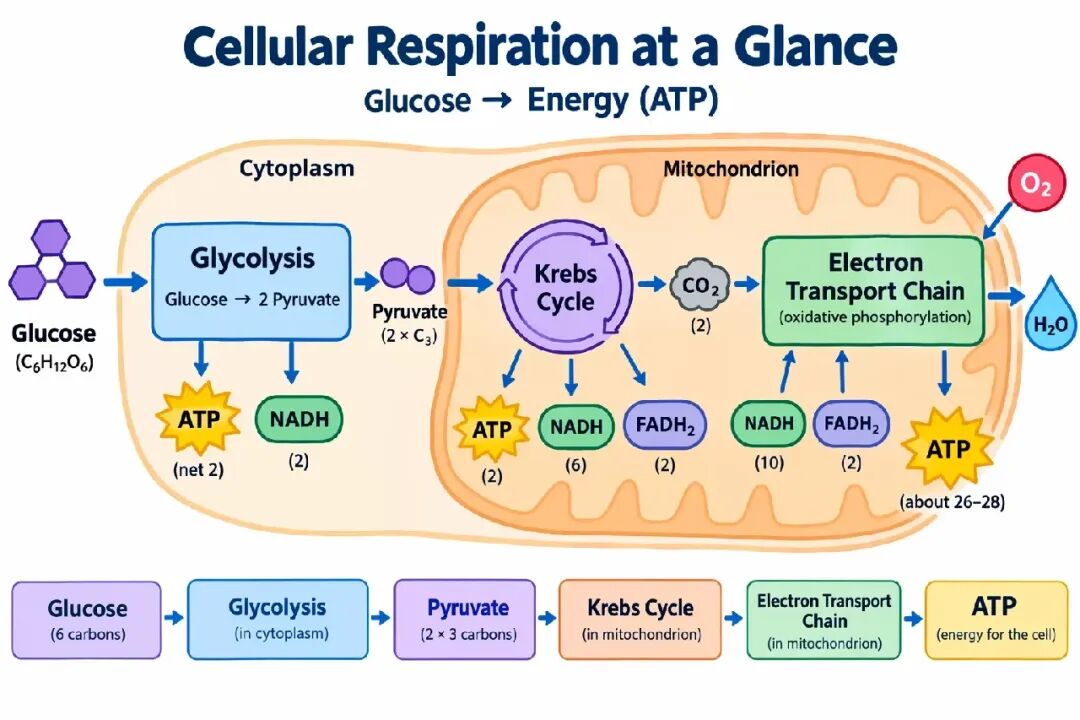
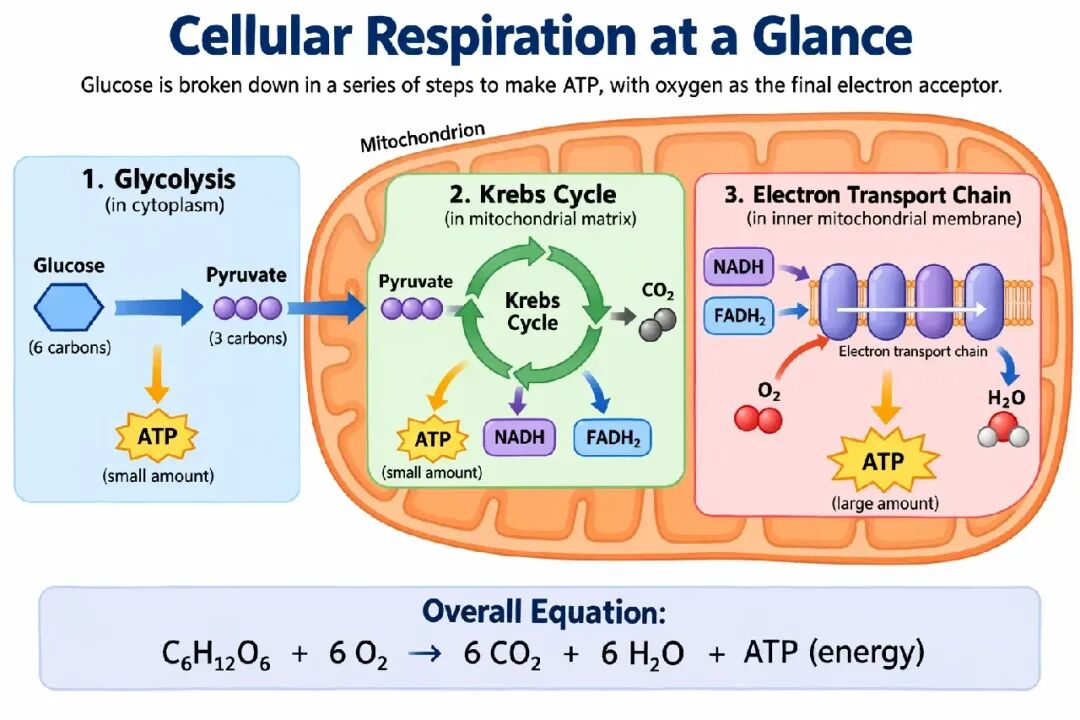
科学与教育图像适合生物、化学、课堂讲解、扁平化科学图标体系、示意图和学习素材。像撰写教学设计需求一样编写提示词:明确受众、教学目标、视觉形式、必需标签和科学约束。为获得更好的结果,要求采用干净、扁平化的视觉体系,统一图标风格,使用清晰的箭头、易读的标签,并保留足够留白,方便学生快速理解概念。
需要准确性时,明确列出必需组成部分,并说明不应包含的内容。对于标签密集的图像、示意图,或要用于幻灯片与课程材料的素材,使用 quality="high"。
生成设置:size="1536x1024" · quality="high"。
提示词 · 08
为高中生制作一张简明的生物学示意图,标题为“细胞呼吸一览”。
展示葡萄糖如何在细胞内转化为能量。包括糖酵解、克雷布斯循环和电子传递链。
使用箭头连接各步骤,标注主要分子:葡萄糖、丙酮酸、ATP、NADH、FADH2、CO2、O2 和 H2O。
呈现为一张干净的课堂讲义或幻灯片:白色背景、简洁图标、清晰标签和易读文字。
避免过小的文字、额外装饰,以及任何使示意图难以理解的内容。
输出示例 · 左右滑动查看
GPT Image 2.5 Flare
GPT Image 2.5 Sunburst
制作幻灯片、示意图与图表
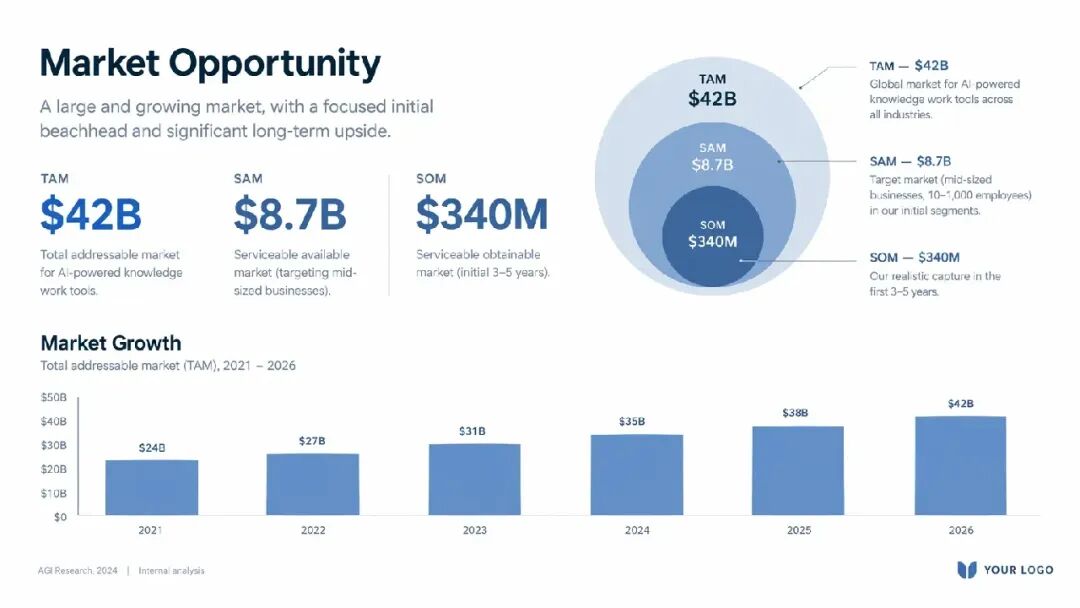
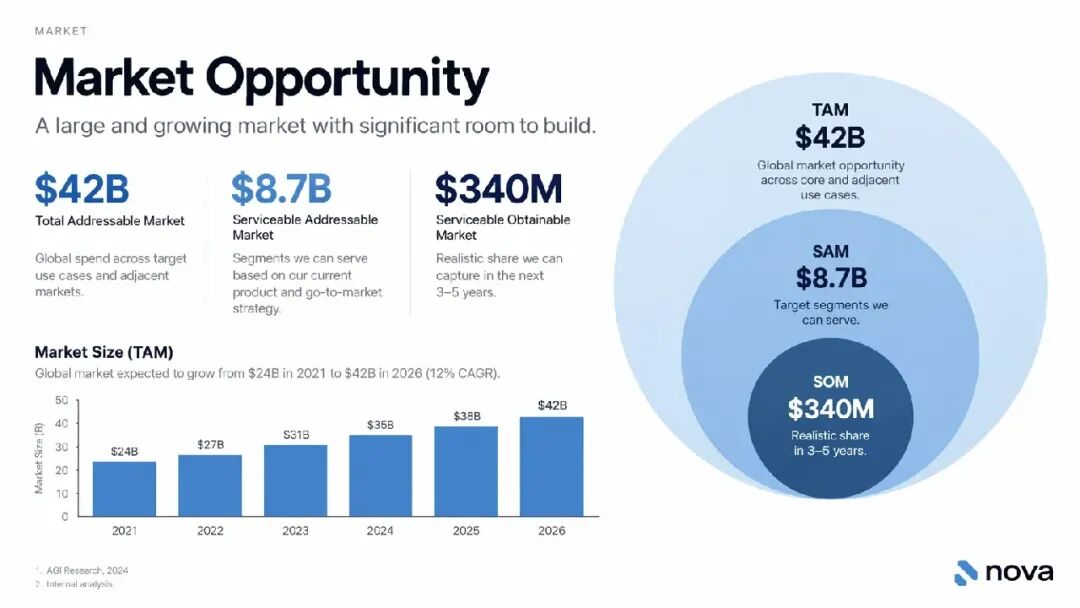
制作工作用途的图像时,将提示词写成具体交付物的规格说明,通常更有效。明确交付物是幻灯片、工作流程图、图表还是页面图像,定义画布和层级,提供实际文字或数据,并描述视觉语言。这类提示词应包含实用约束:字体易读、间距精细、没有杂乱装饰,并避免通用图库照片式处理。
对于幻灯片、图表和以示意图为主的素材,直接在提示词中提供数字和标签。演示文稿类输出使用横向尺寸;图像包含小字、图例、坐标轴或脚注时,使用 quality="high"。
下面的示例市场数据和引用是虚构的设计输入。使用这张幻灯片之前,请替换为已经核实的数据。
生成设置:size="1536x864" · quality="high"。
提示词 · 09
创建一张标题为“市场机会”的融资演示幻灯片,呈现出一家获得 YC 支持的初创企业进行 A 轮融资时所使用的真实幻灯片的质感。
采用干净的白色背景、类似 Inter 的现代无衬线字体,以及清晰、极简的布局。幻灯片应包含:
• 以柔和蓝色和灰色绘制的 TAM/SAM/SOM 同心圆示意图。
• 具体、可信的市场规模数字:
TAM:420 亿美元($42B)
SAM:87 亿美元($8.7B)
SOM:3.4 亿美元($340M)
• 下方放置一张简洁的柱状图,展示 2021 至 2026 年的市场增长,呈现轻微的上升趋势。
• 小字脚注:“AGI Research, 2024”和“内部分析”。
• 右下角放置一个公司标志占位符。
设计应像一份实际成功获得融资的演示文稿中的页面:文字高度易读,数据层级清晰,间距精细,采用专业的初创企业视觉语言。
避免剪贴画、图库照片、渐变、阴影、装饰元素,以及任何显得千篇一律或设计过度的内容。
输出示例 · 左右滑动查看
GPT Image 2.5 Flare
GPT Image 2.5 Sunburst
编辑图像
使用 client.images.edit,并传入所引用的输入图像。对于需要蒙版的局部编辑,参见使用蒙版编辑图像。
翻译文字并保留布局
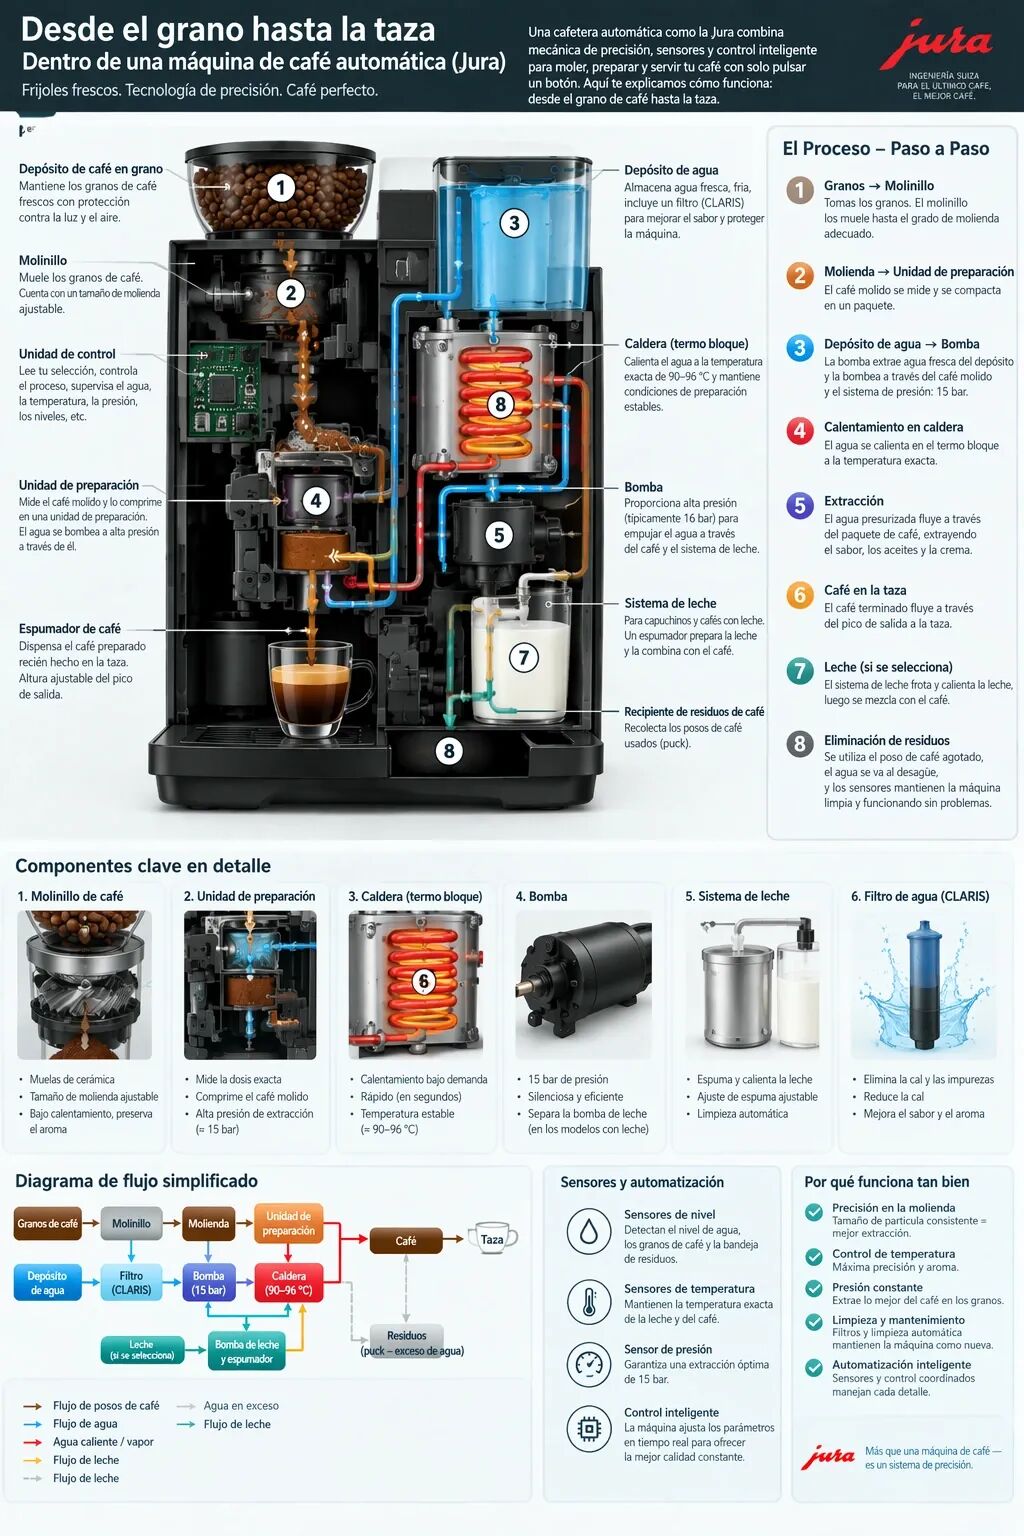
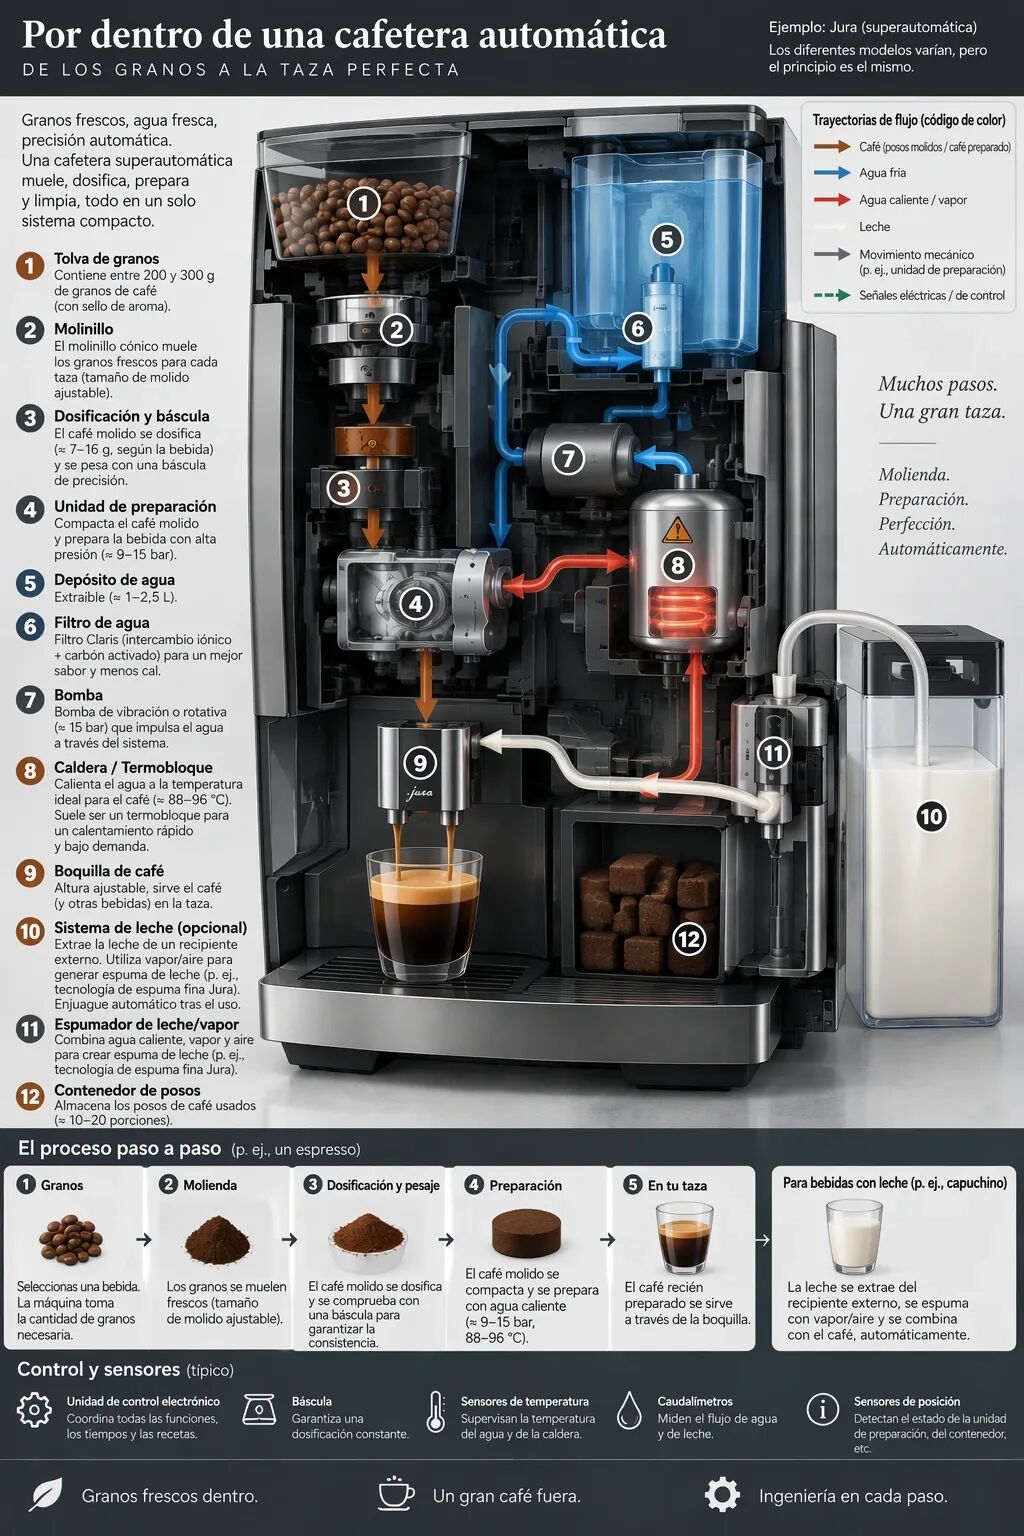
使用各模型在“用图像解释一个过程”中生成的咖啡机示意图作为输入。要求替换文字并保留原有设计,然后检查译文,以及是否仍有未翻译的原语言文字。
编辑设置:size="1024x1536" · quality="high"。
提示词 · 10
将信息图中的文字翻译成西班牙语。不要改动图像的任何其他部分。
输出示例 · 左右滑动查看
GPT Image 2.5 Flare
GPT Image 2.5 Sunburst
迁移视觉风格
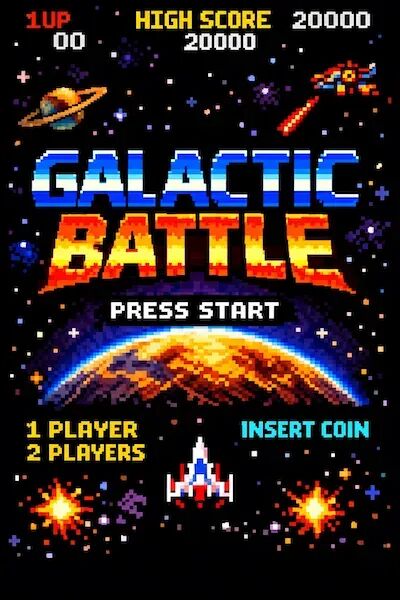
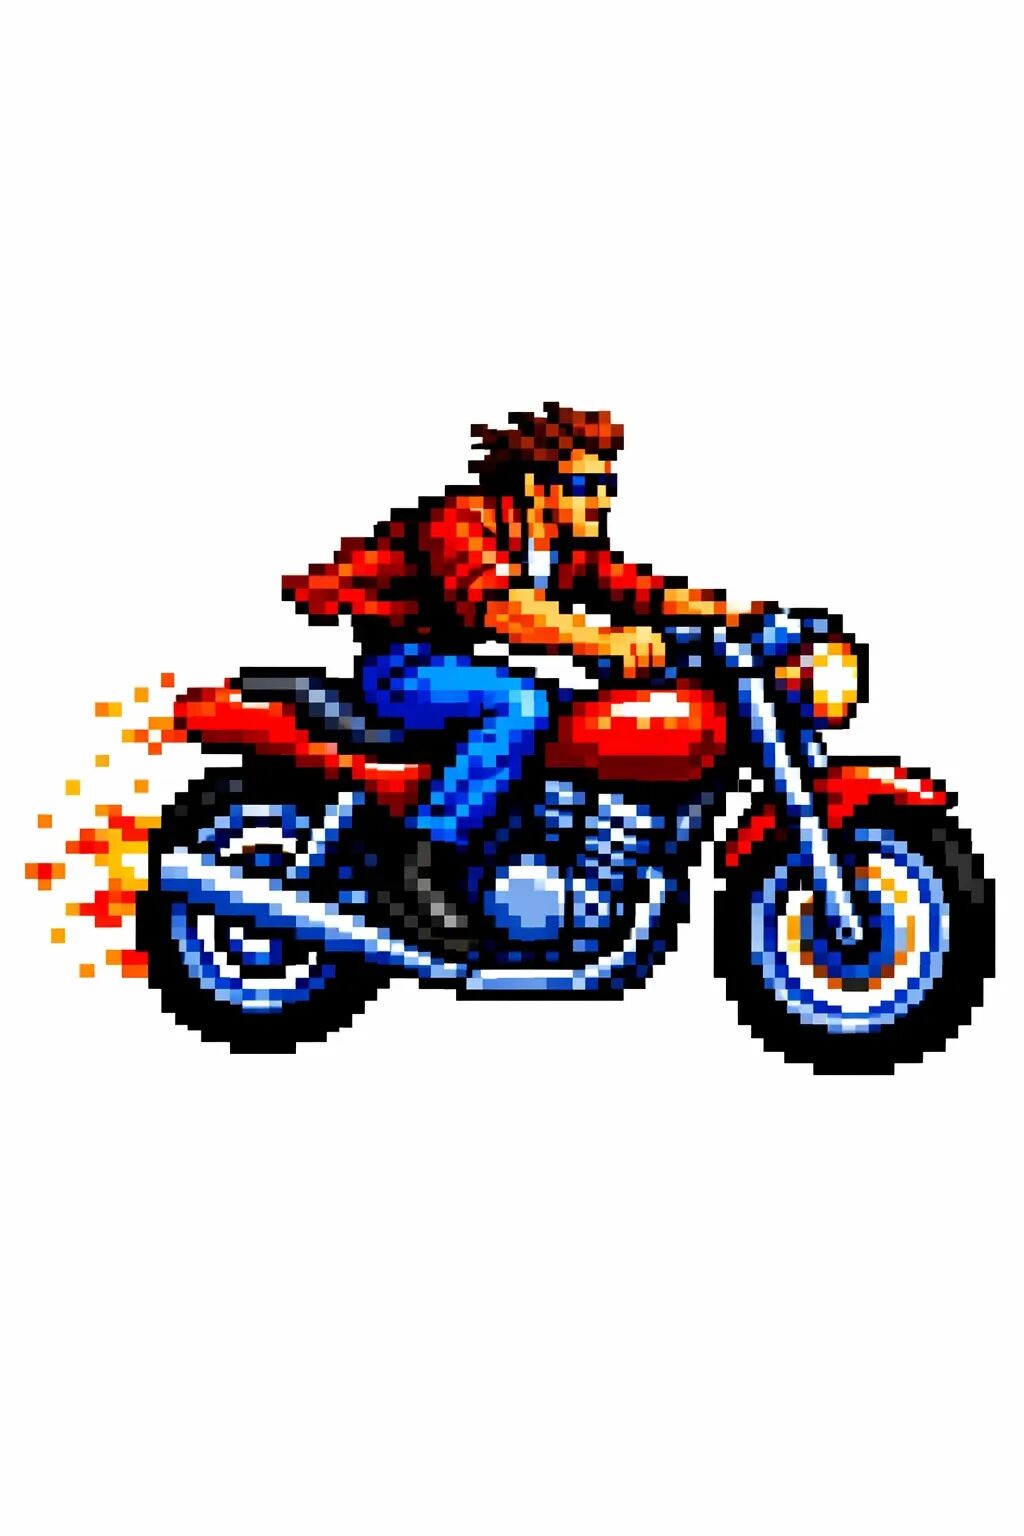
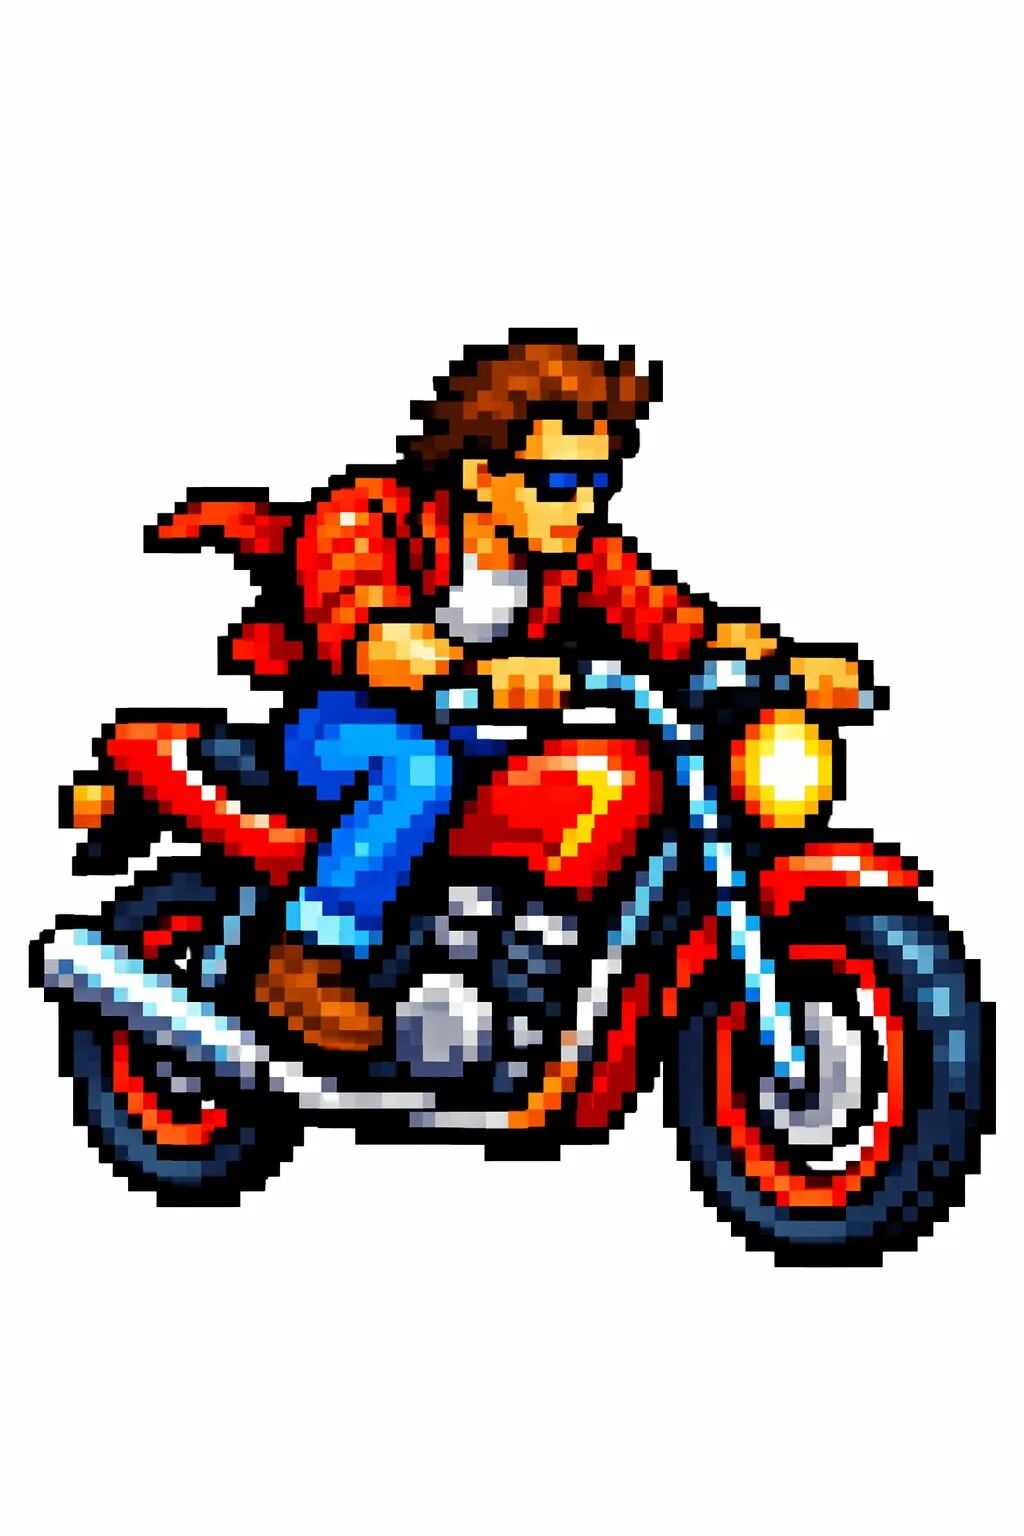
为参考图指定具体用途,例如提供配色、纹理或表现媒介。单独描述新的主体。使用下方的像素风图像作为输入。
编辑设置:size="1024x1536" · quality="medium"。
提示词 · 11
沿用输入图像的风格,生成一名骑摩托车的男子,背景为白色。
输入图像
风格参考 · 像素风游戏画面
输出示例 · 左右滑动查看
GPT Image 2.5 Flare
GPT Image 2.5 Sunburst
保留人物身份并更换服装
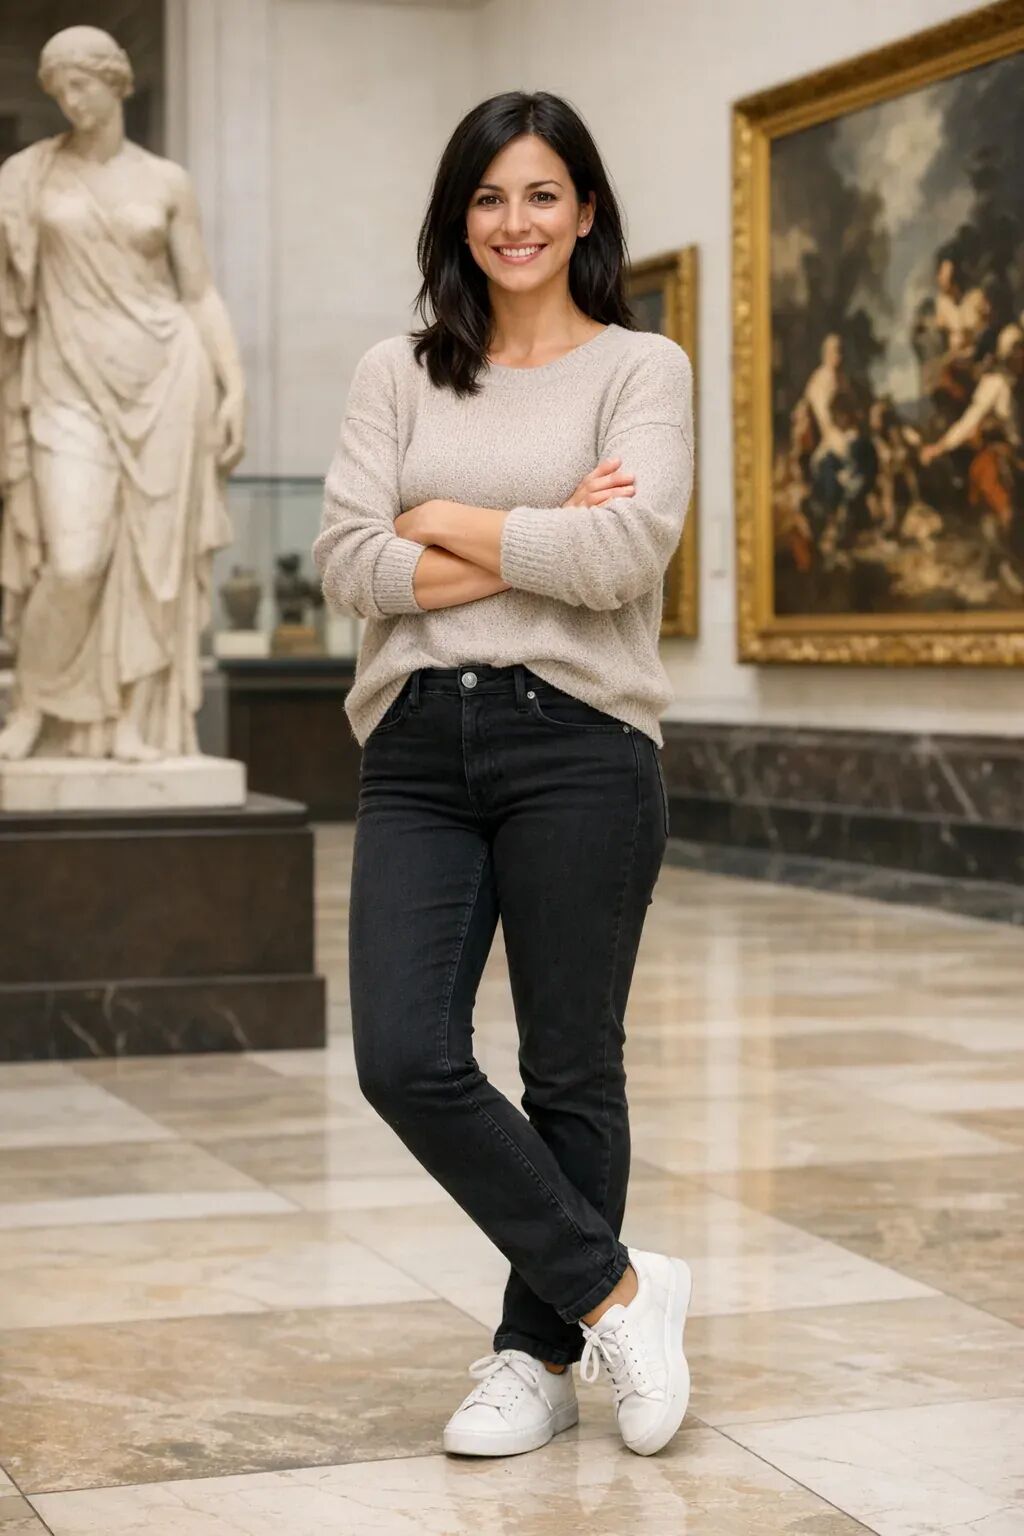
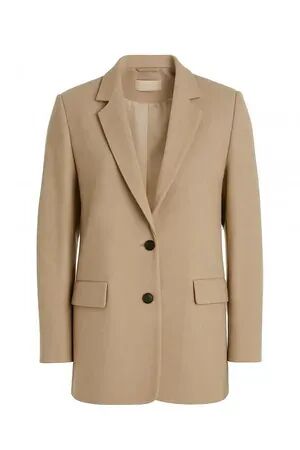
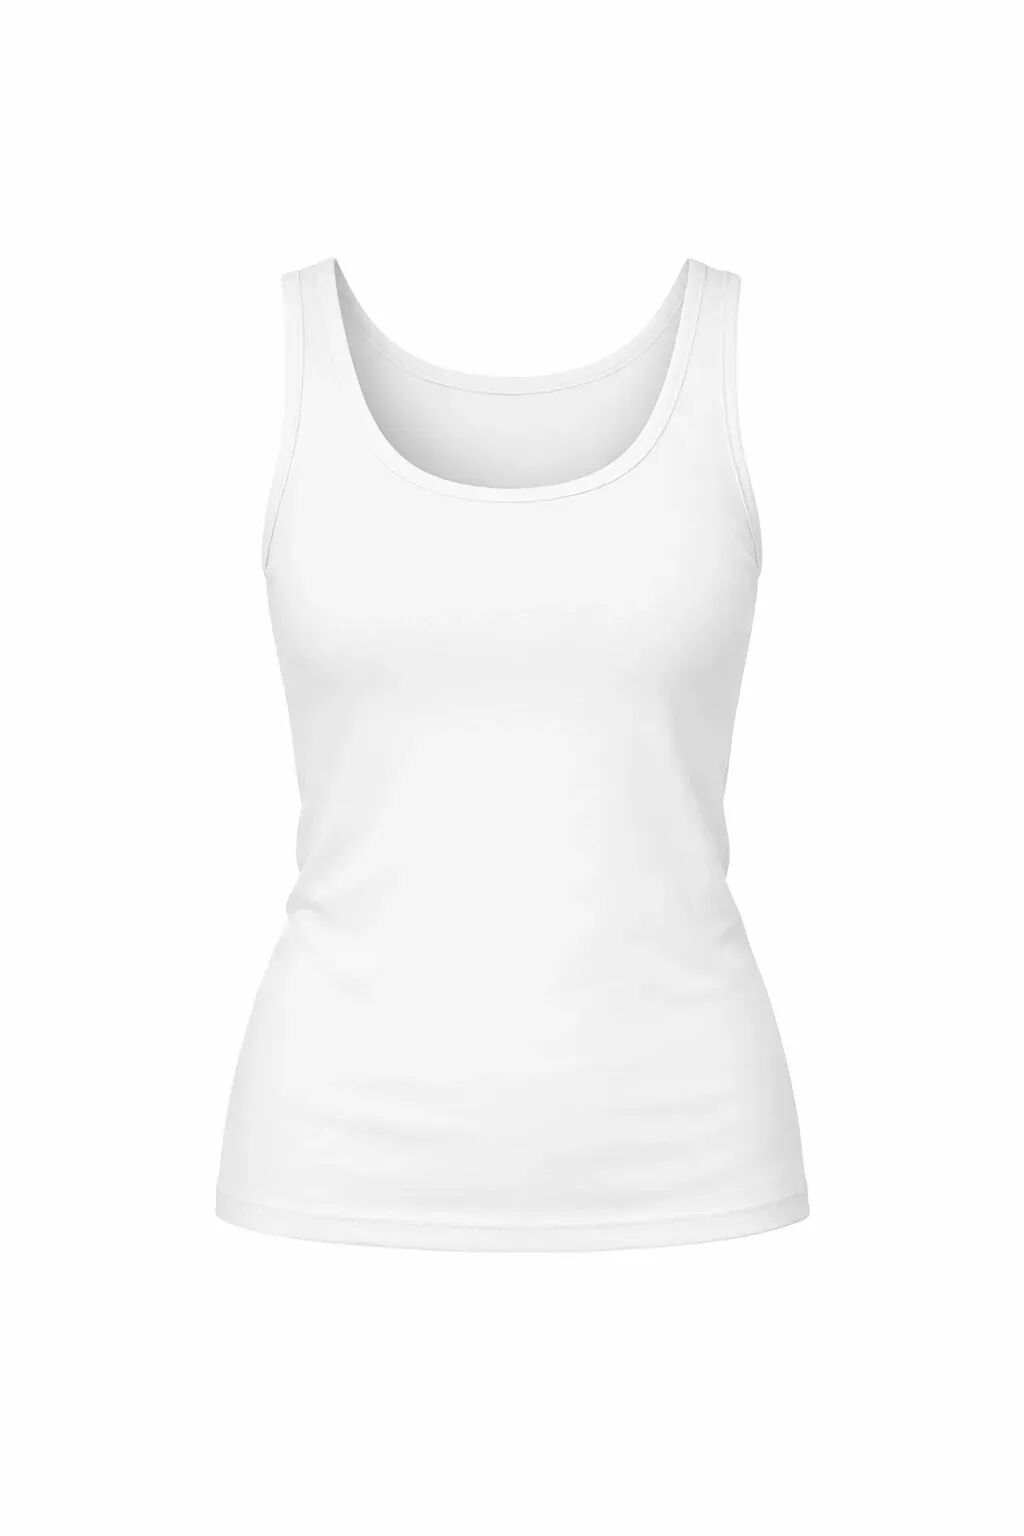
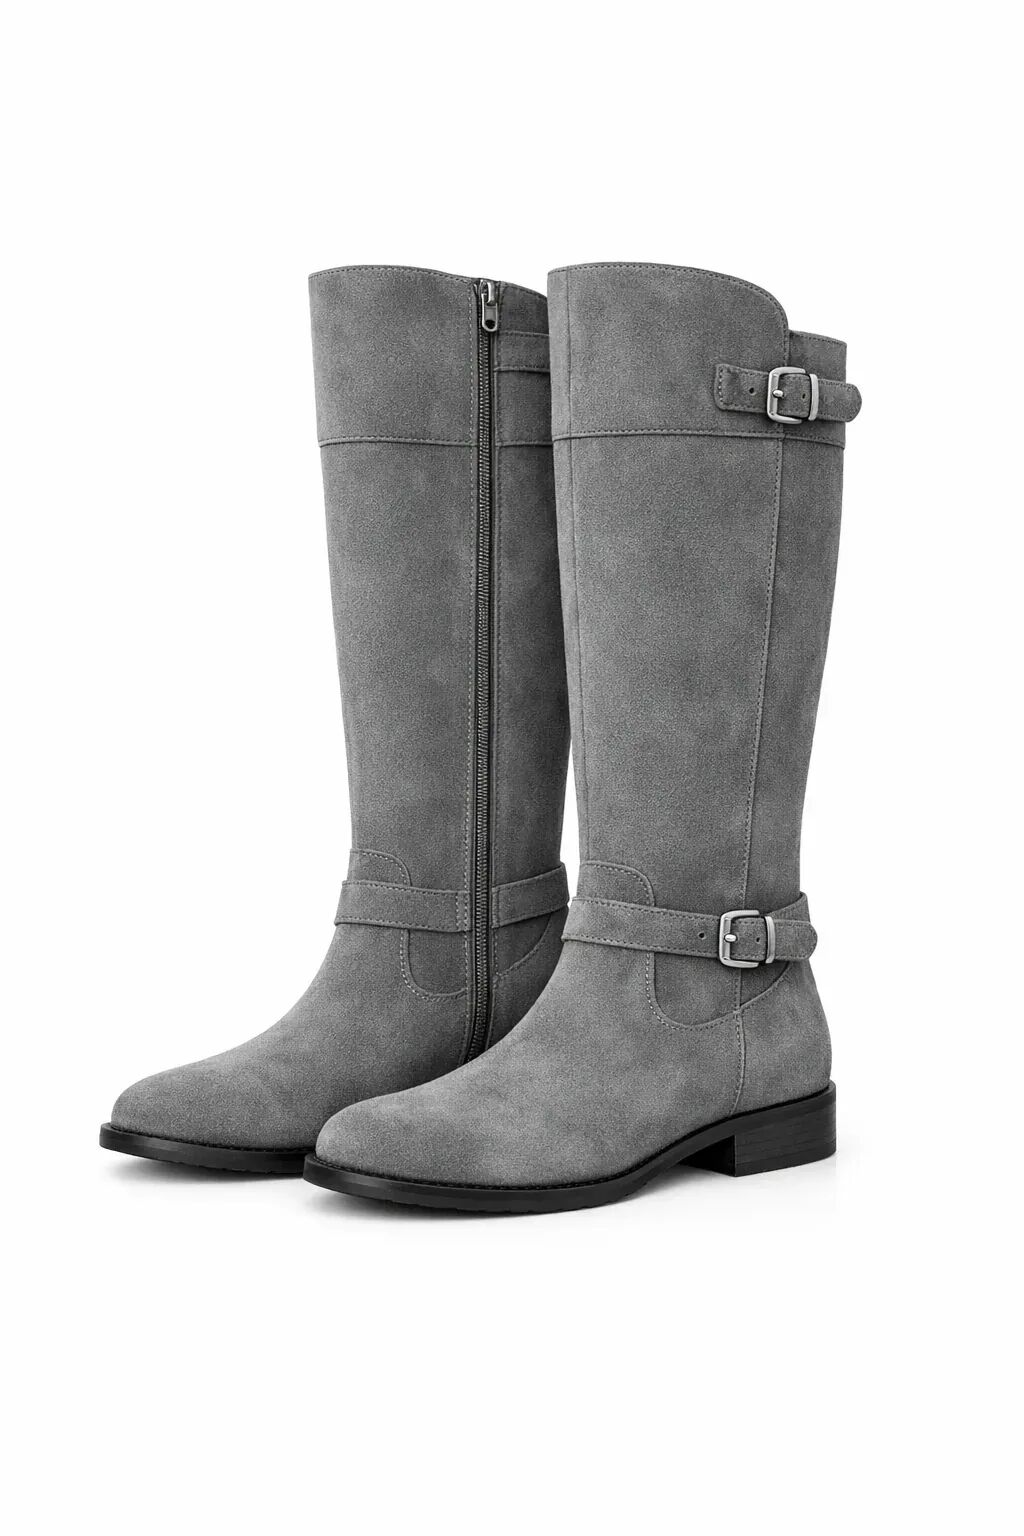
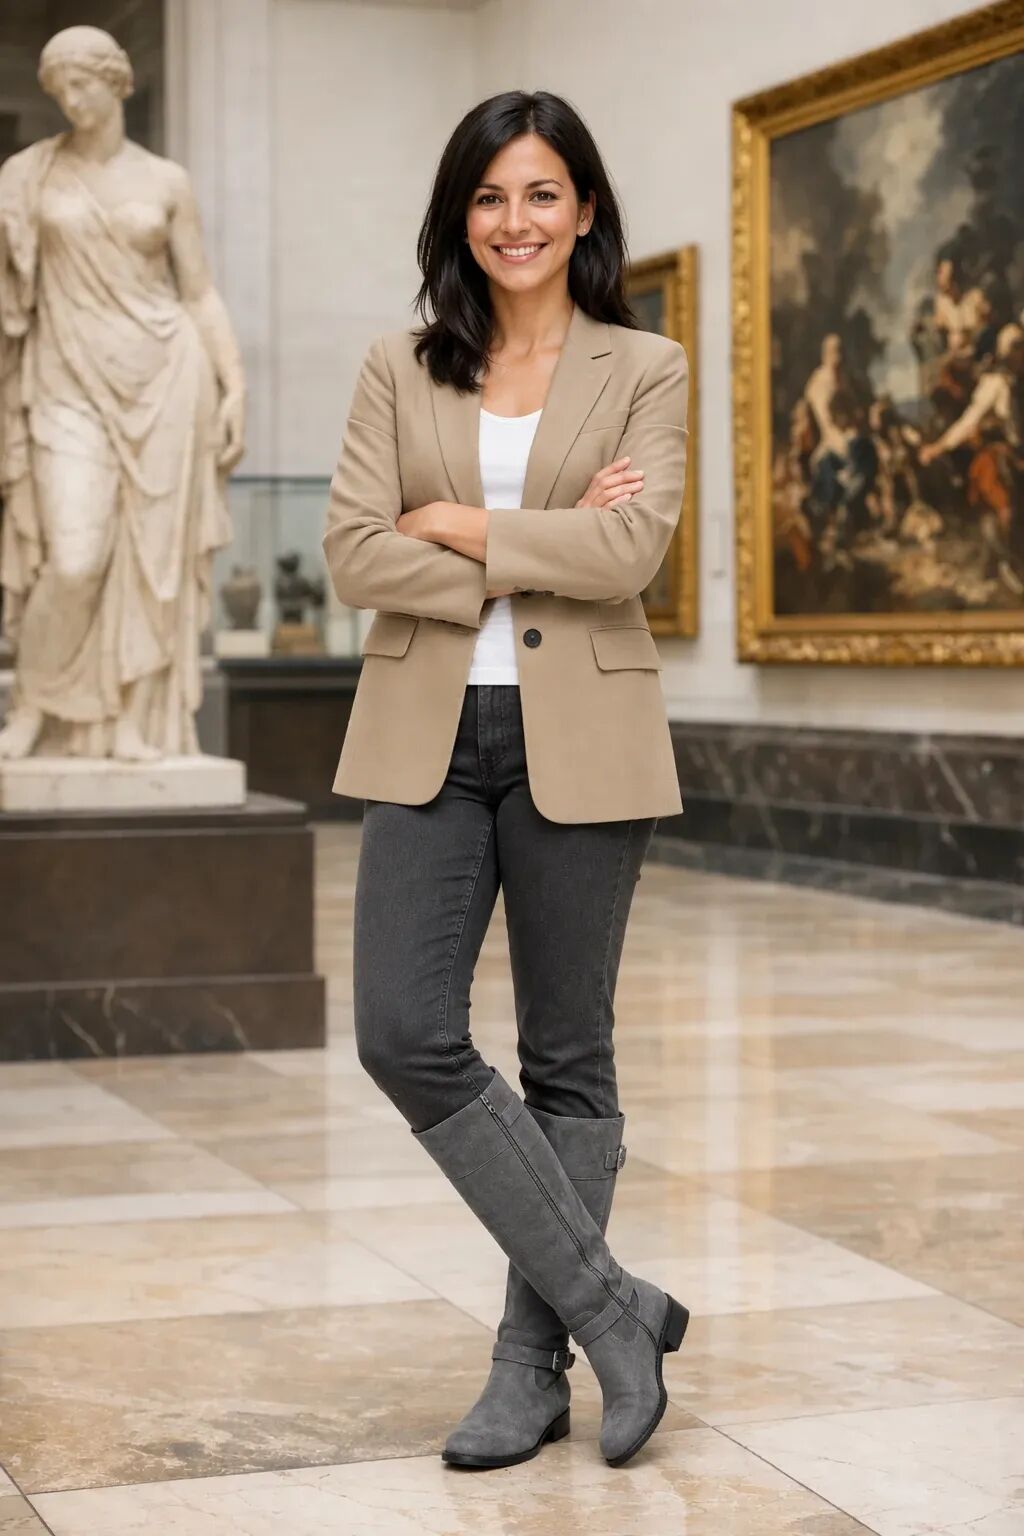
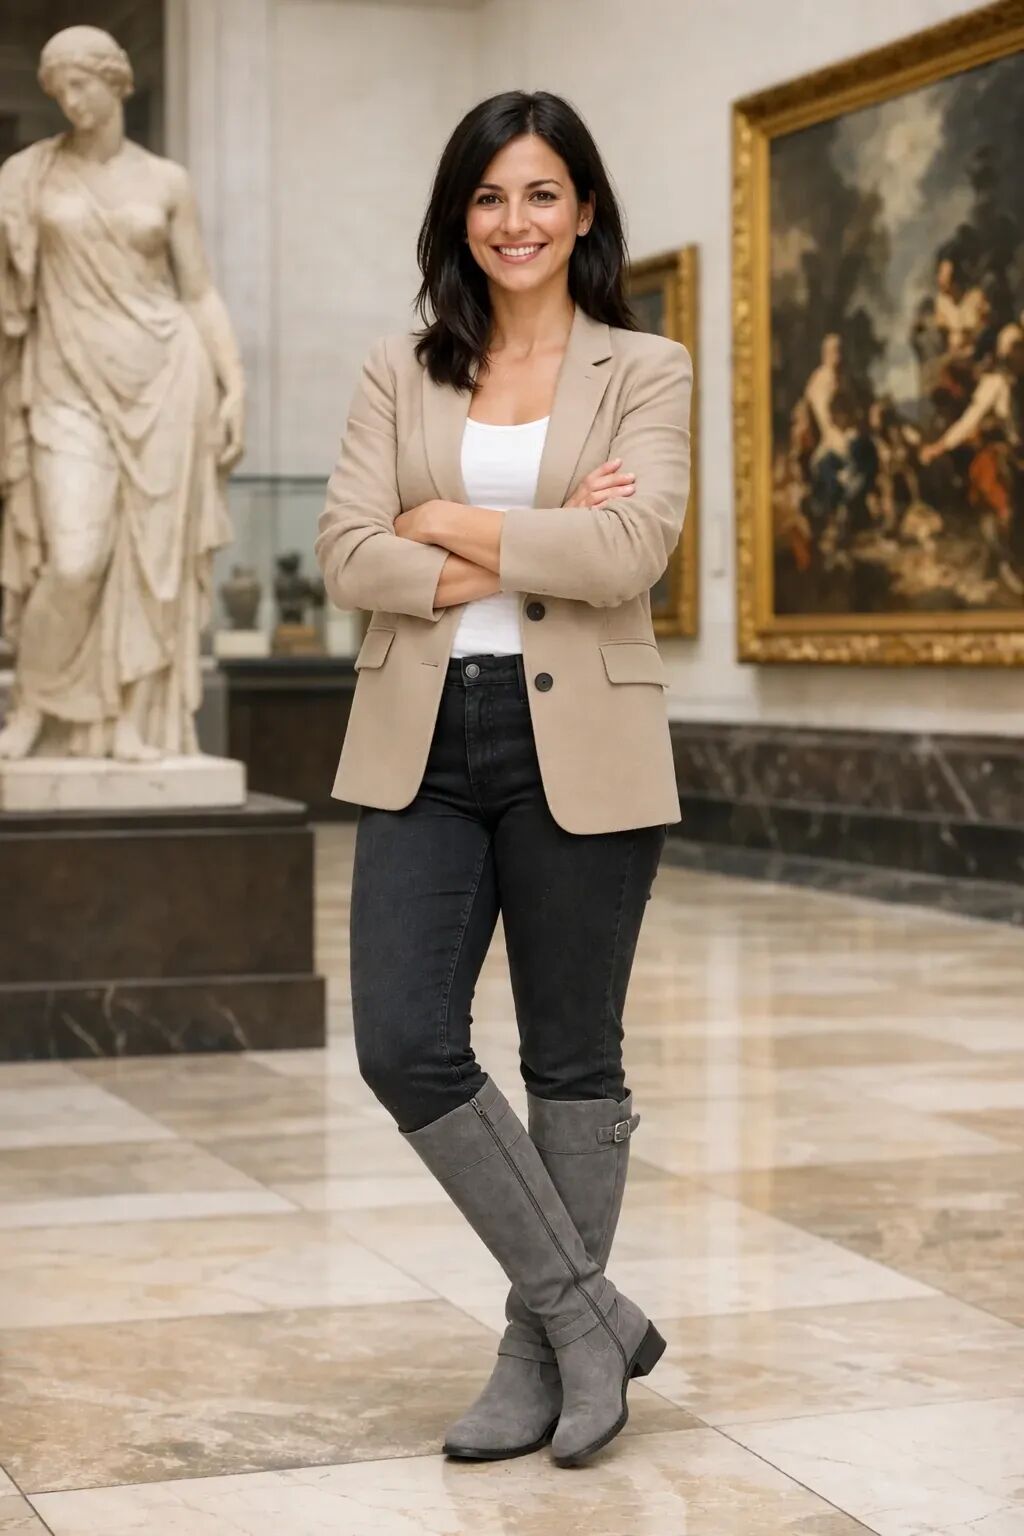
使用下方的人物照片和三张服装参考图作为输入。说明人物的哪些方面必须保持原样,仅允许修改服装。这种方式也适用于需要保持产品或物体可辨识特征的编辑。
编辑设置:size="1024x1536" · quality="medium"。
提示词 · 12
编辑图像,使用提供的服装图片为这位女性换装。不要以任何方式改变她的脸部、五官、肤色、体形、姿势或人物身份。准确保留她的相貌、表情、发型和身体比例。
仅替换服装,让衣物自然贴合她现有的姿态和身体几何形状,呈现真实的面料表现。匹配原照片的光线、阴影和色温,让服装以照片级写实的方式融入画面,避免产生贴上去的感觉。
不要改变背景、相机角度、取景或图像质量,也不要添加配饰、文字、标志或水印。
输入图像 · 左右滑动查看
人物参考 · 博物馆中的女性
服装参考 · 米色夹克
服装参考 · 白色背心
服装参考 · 灰色靴子
输出示例 · 左右滑动查看
GPT Image 2.5 Flare
GPT Image 2.5 Sunburst
组合参考图
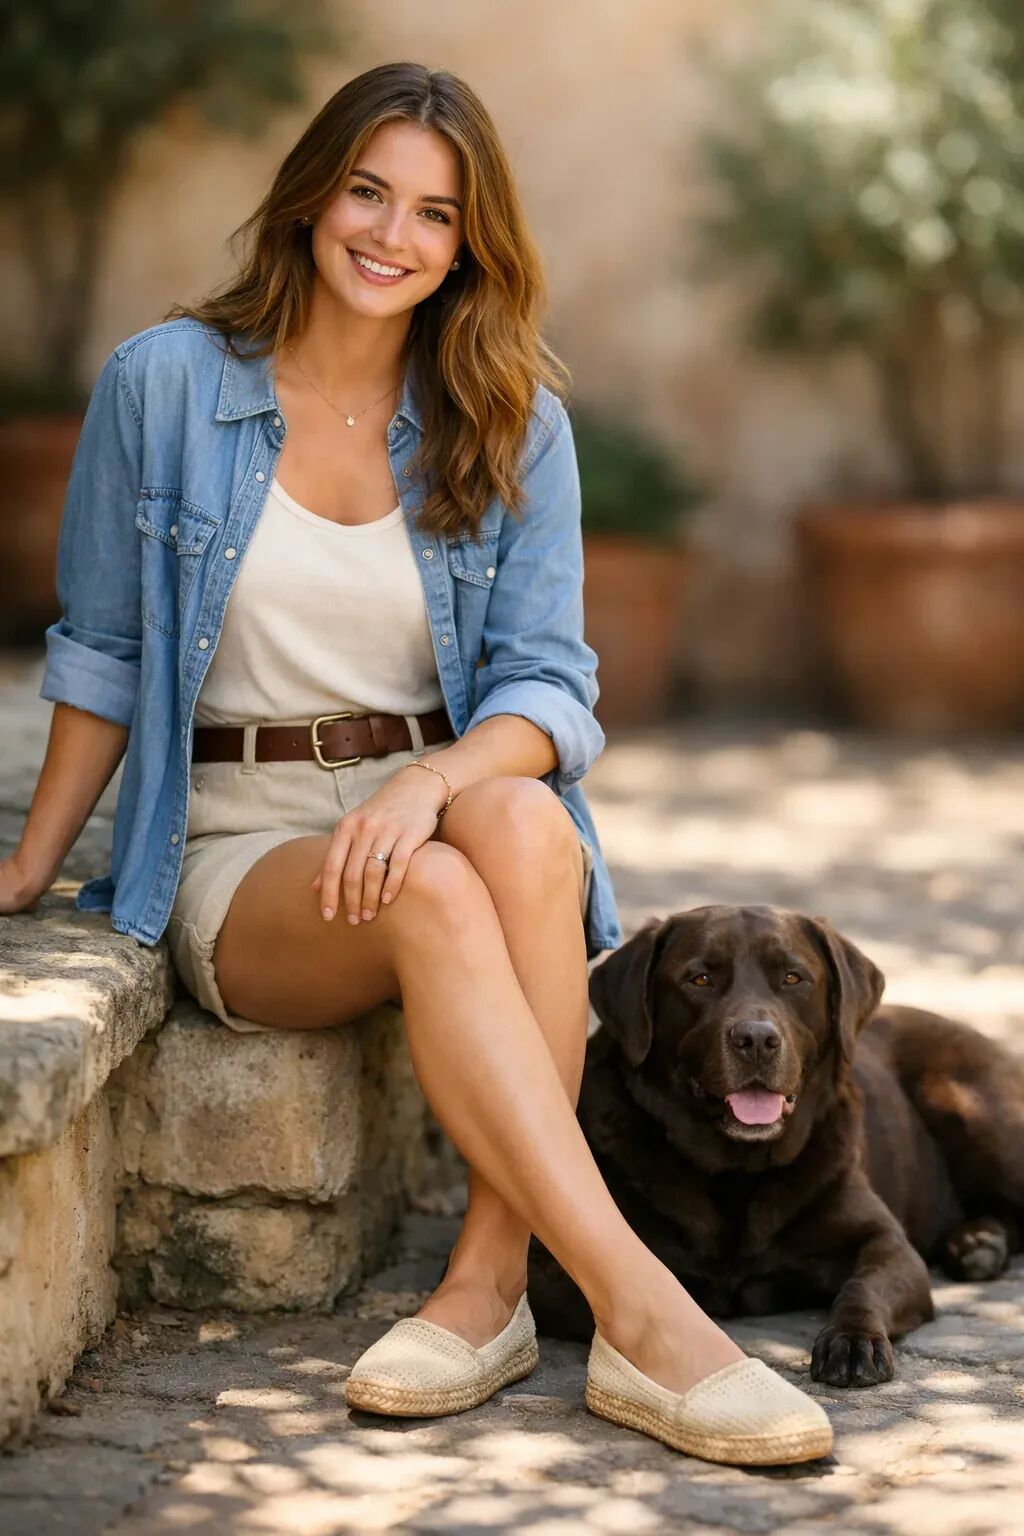
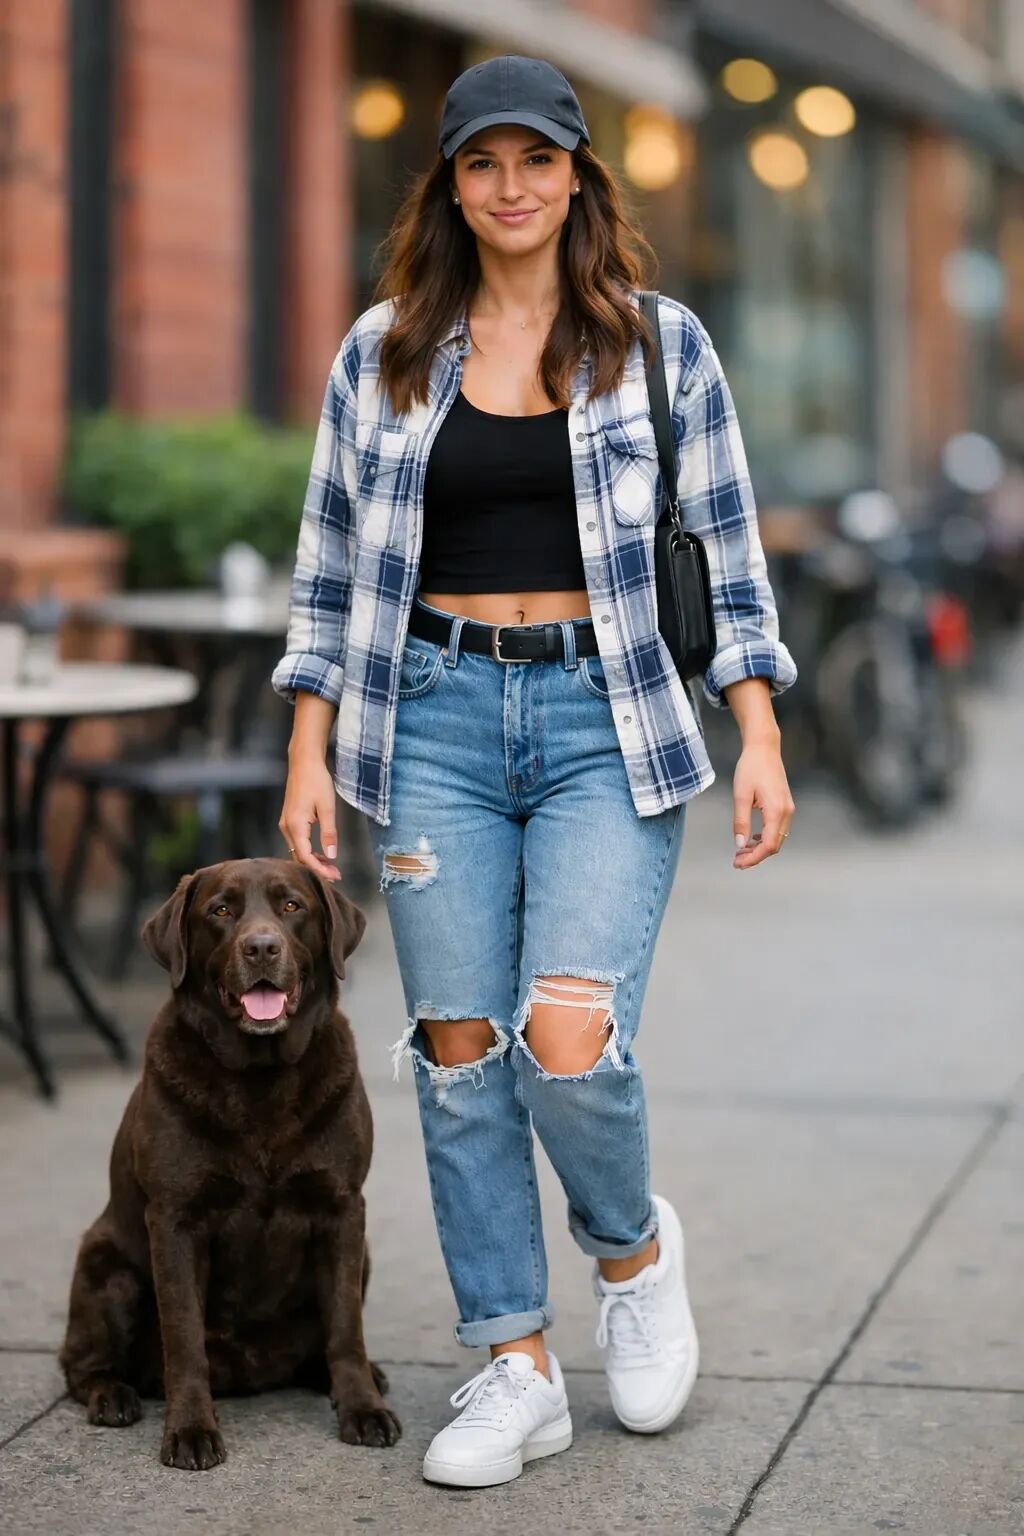
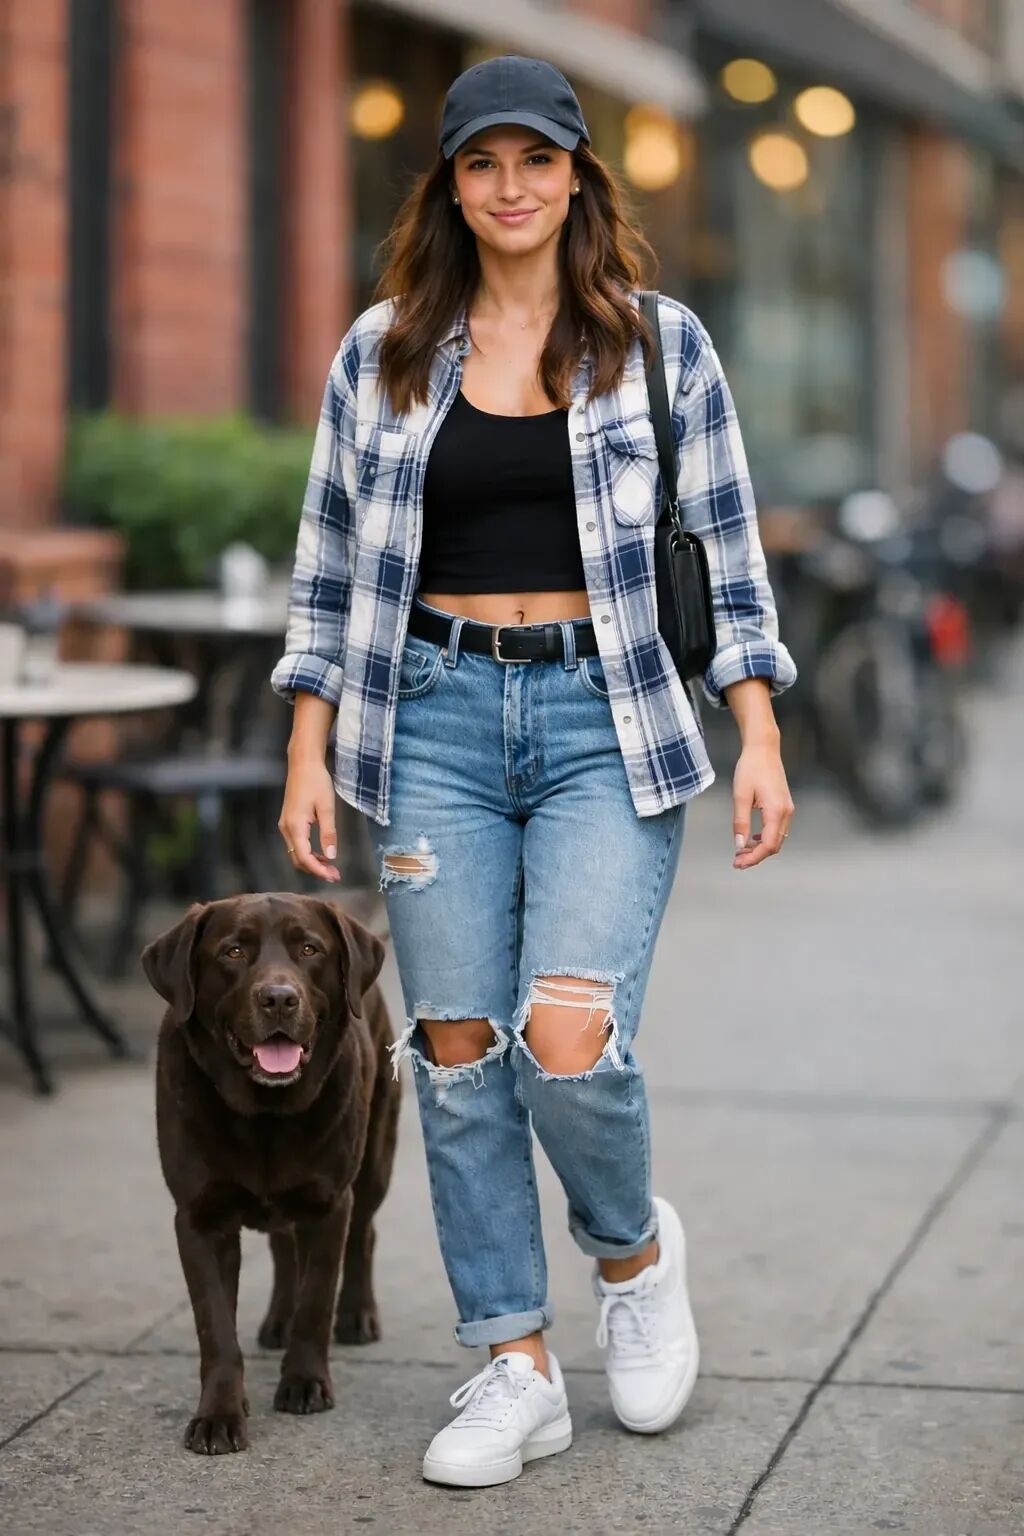
将场景照片作为图像 1,将狗的照片作为图像 2。指定要移动的元素、目标位置,以及必须保留的内容。
编辑设置:size="1024x1536" · quality="medium"。
提示词 · 13
将第二张图中的狗放入图像 1 的场景中,紧挨着那位女性,使用相同的光线风格、构图和背景。不要改动其他任何内容。
输入图像 · 左右滑动查看
输入 1 · 街头场景中的女性
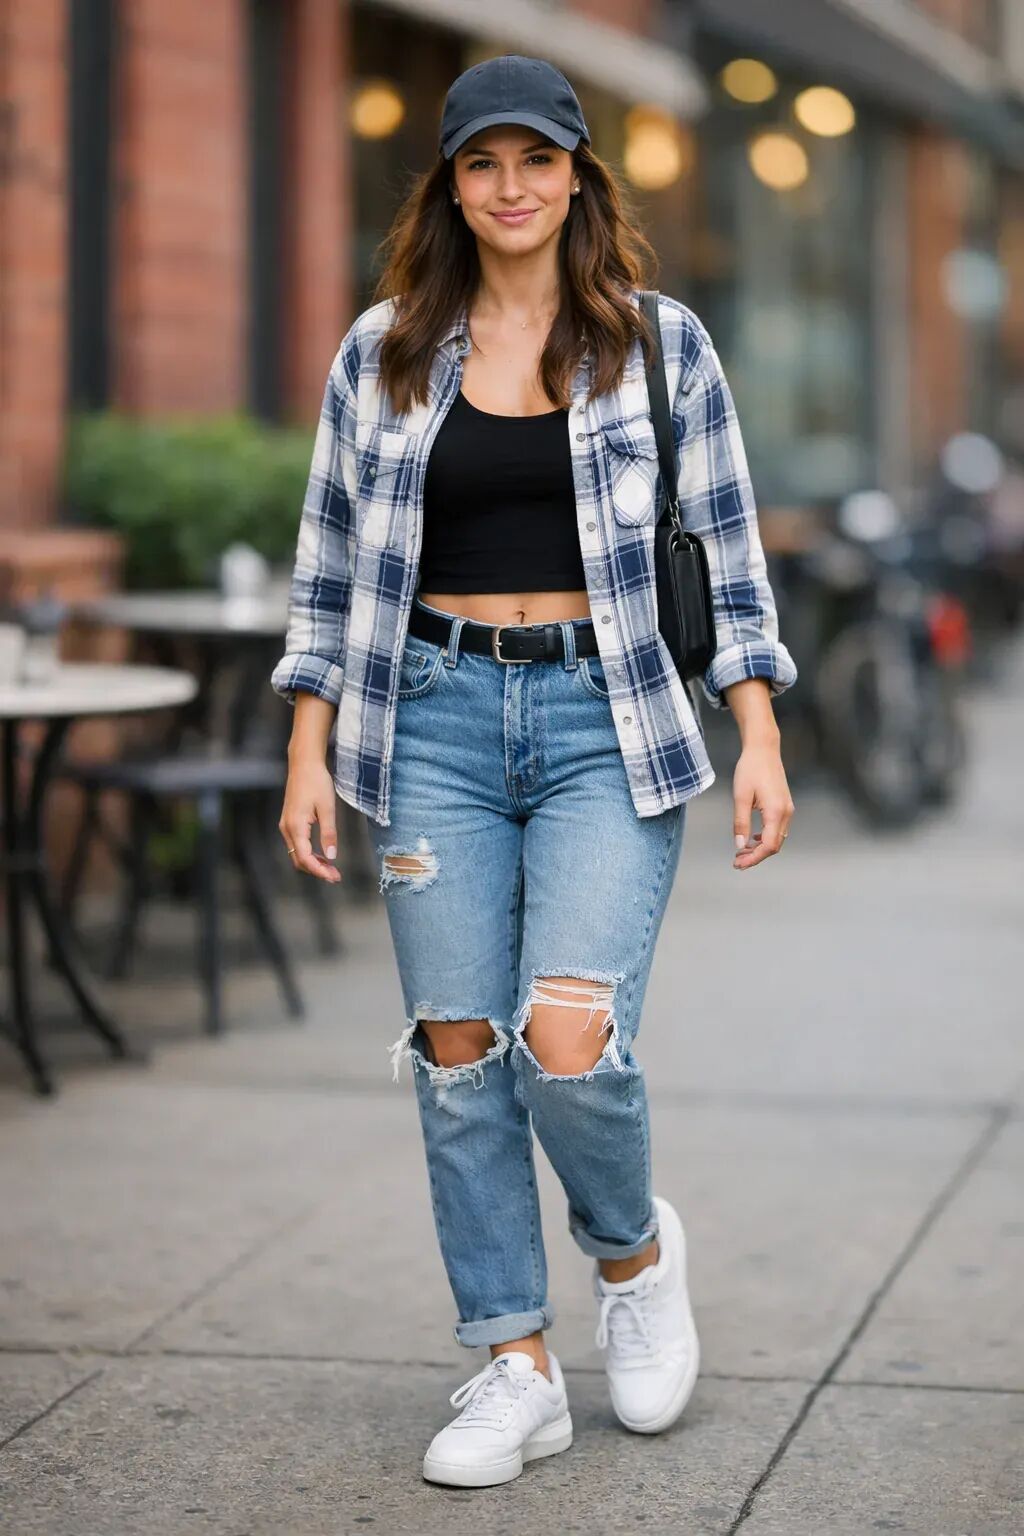
输入 2 · 女性与狗
输出示例 · 左右滑动查看
GPT Image 2.5 Flare
GPT Image 2.5 Sunburst
制作透明背景的产品抠图
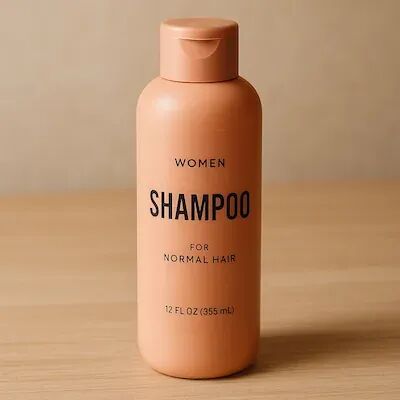
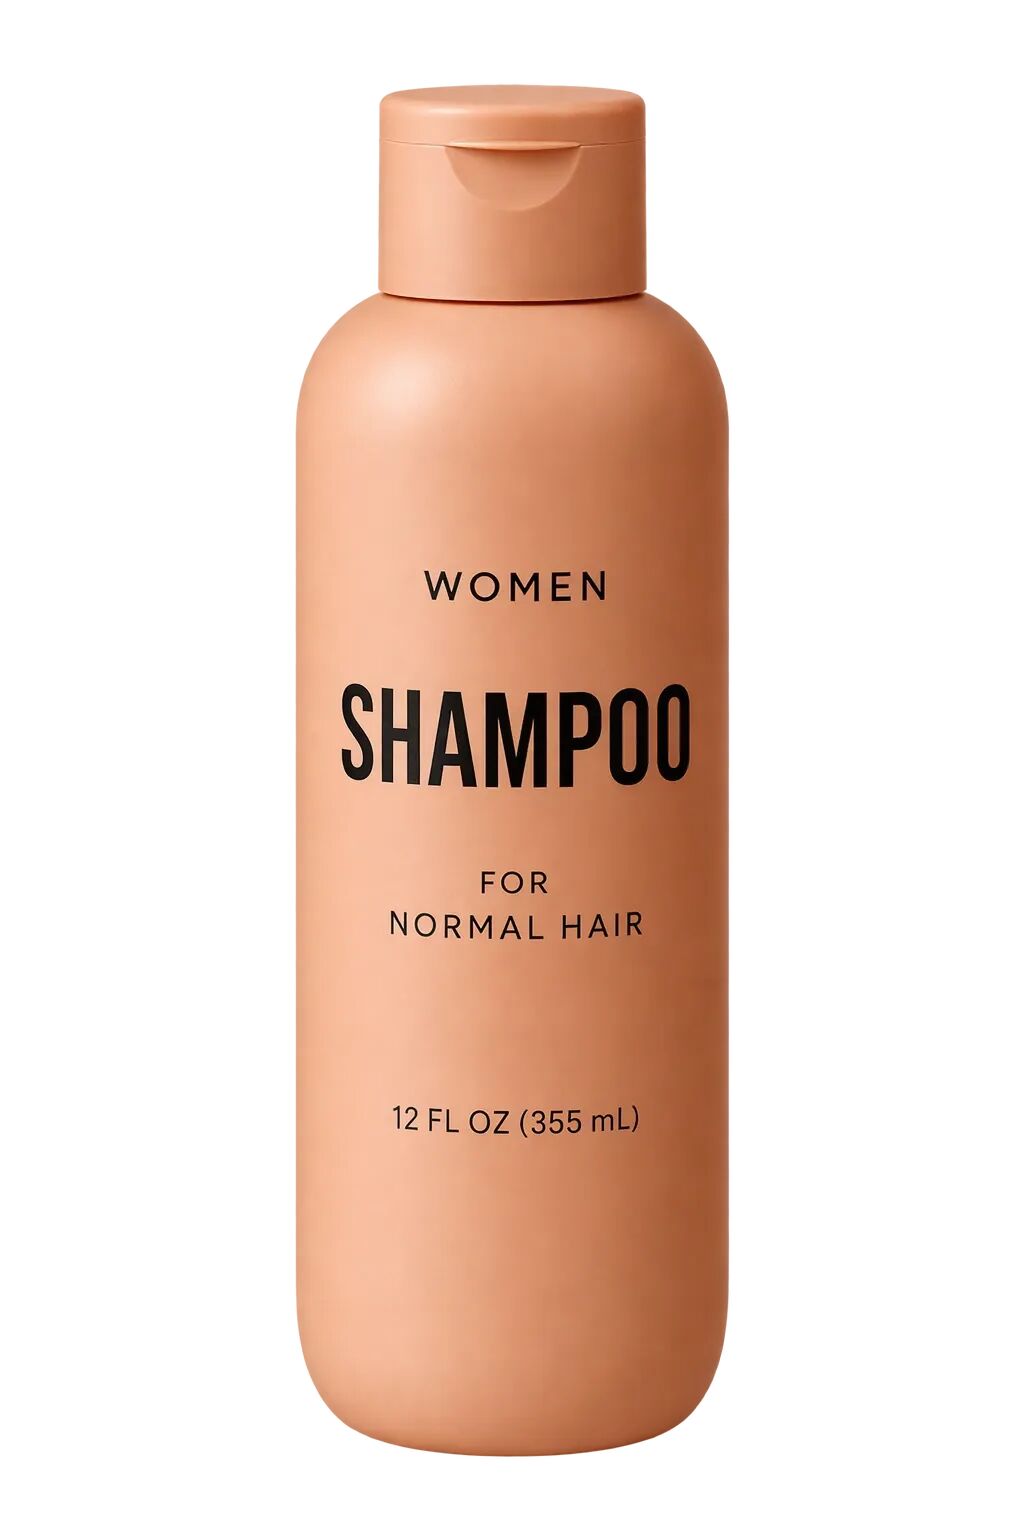
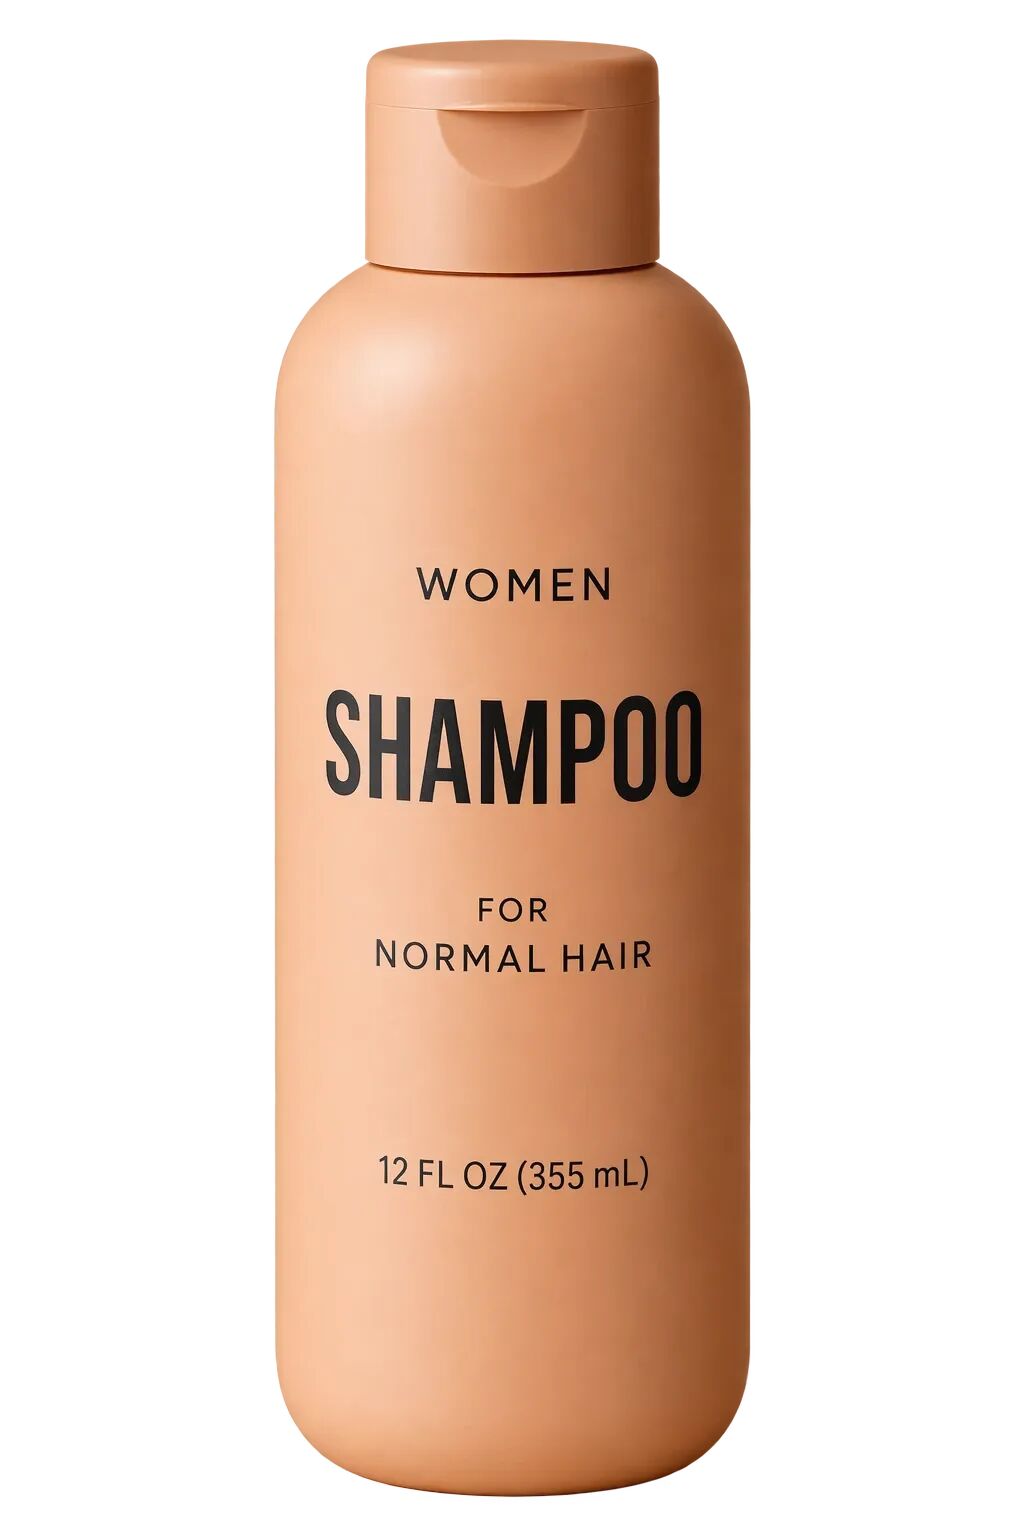
在提示词中要求单独提取主体,并在 API 中设置 background="transparent"。使用 PNG 或 WebP,保留返回的 Alpha 通道;PNG 应省略 output_compression。绘制出来的棋盘格不具备透明度。后续编辑时,重复说明需要保留透明背景。使用下方的产品照片作为输入。
编辑设置:size="1024x1536" · quality="medium" · background="transparent" · output_format="png"。
提示词 · 14
从输入图像中提取产品,将其单独置于完全透明的背景上。
输出要求:产品居中,轮廓清晰,没有光晕或杂边。
准确保留产品的几何形状和标签的可读性。
只做轻微润饰。不要添加纯色底、棋盘格、场景或阴影。
不要重新设计产品风格;移除背景,并保留干净的 Alpha 透明度。
输入图像
输入图 · 洗发水产品照片
输出示例 · 左右滑动查看
GPT Image 2.5 Flare
GPT Image 2.5 Sunburst
将绘画转化为写实图像
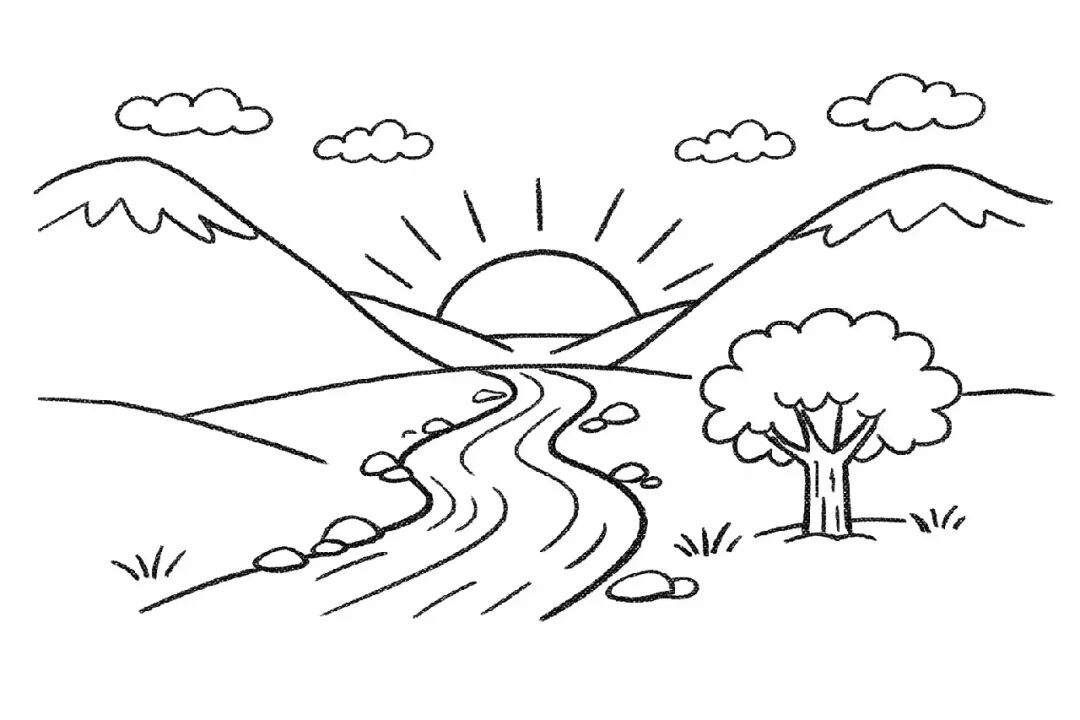
从草图到渲染图的工作流程,适合在保留原有意图的同时,将粗略绘画转化为照片级写实概念图。像撰写规格说明一样组织提示词:保留布局和透视,再通过指定合理的材质、光线和环境来增加真实感。加入“不要添加新元素或文字”,以避免模型进行创造性的重新诠释。
编辑设置:size="1024x1536" · quality="medium"。
提示词 · 15
将这幅绘画转化为照片级写实图像。
准确保留布局、比例和透视。
选择符合草图意图的真实材质和光线。
不要添加新元素或文字。
输入图像
输入图 · 河谷线稿
输出示例 · 左右滑动查看
GPT Image 2.5 Flare
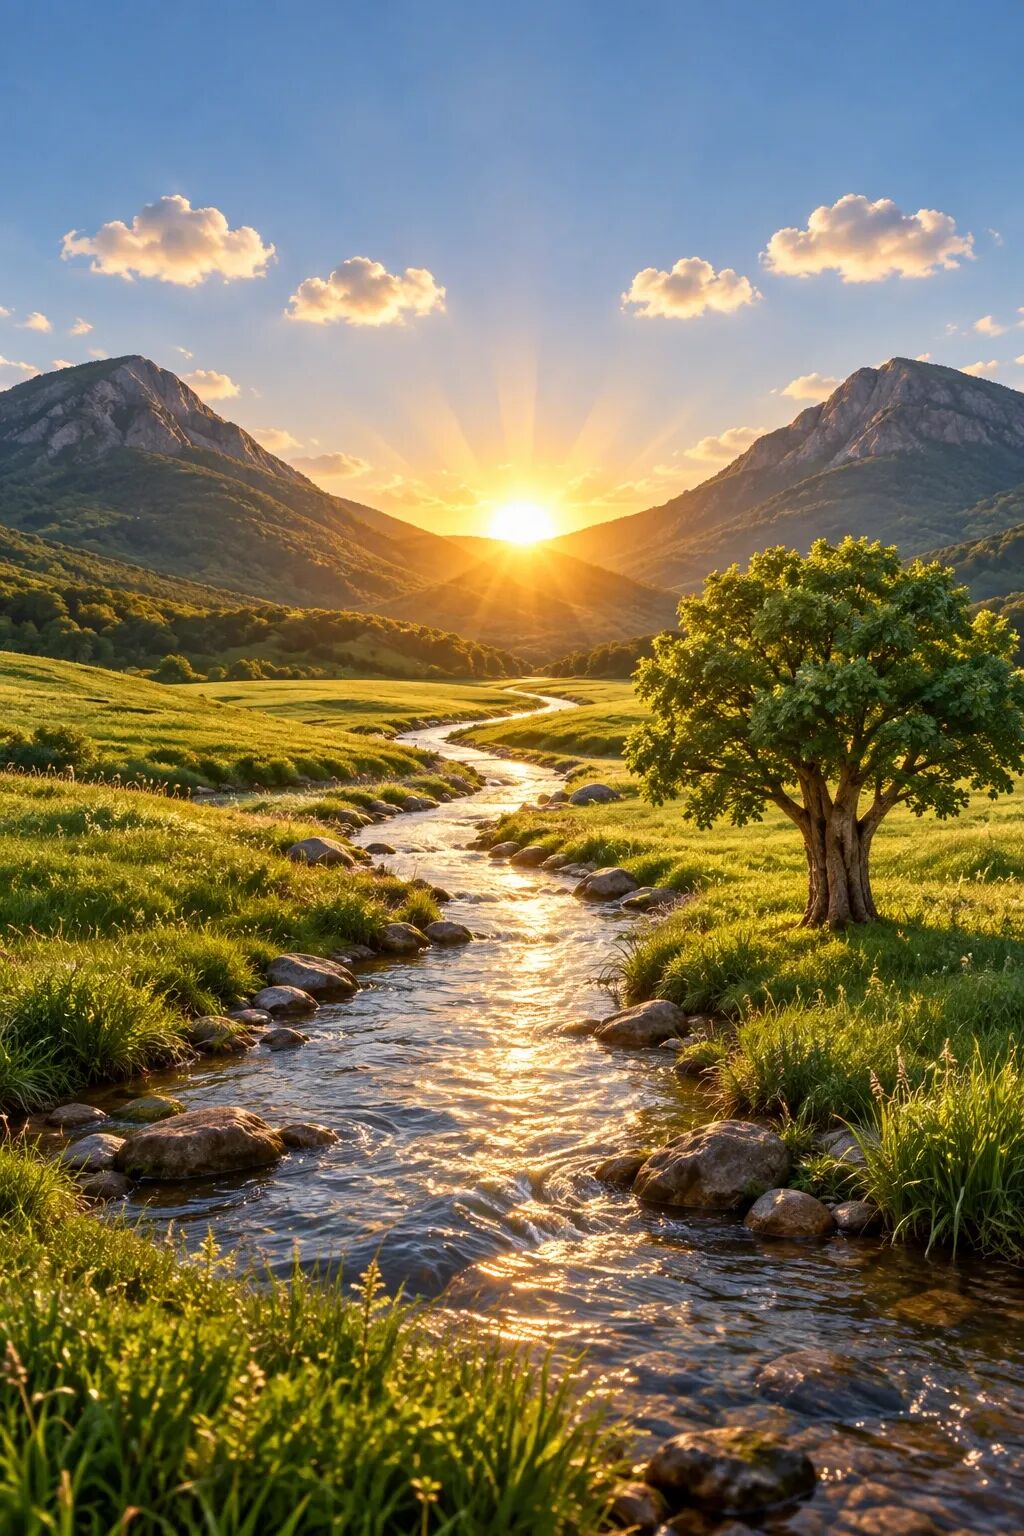
GPT Image 2.5 Sunburst
移除一个物体
明确指出要移除的物体,并保留它周围的所有内容。保持人物、姿势、光线和构图一致,使编辑限定在局部。
编辑设置:size="1024x1536" · quality="medium"。
提示词 · 16
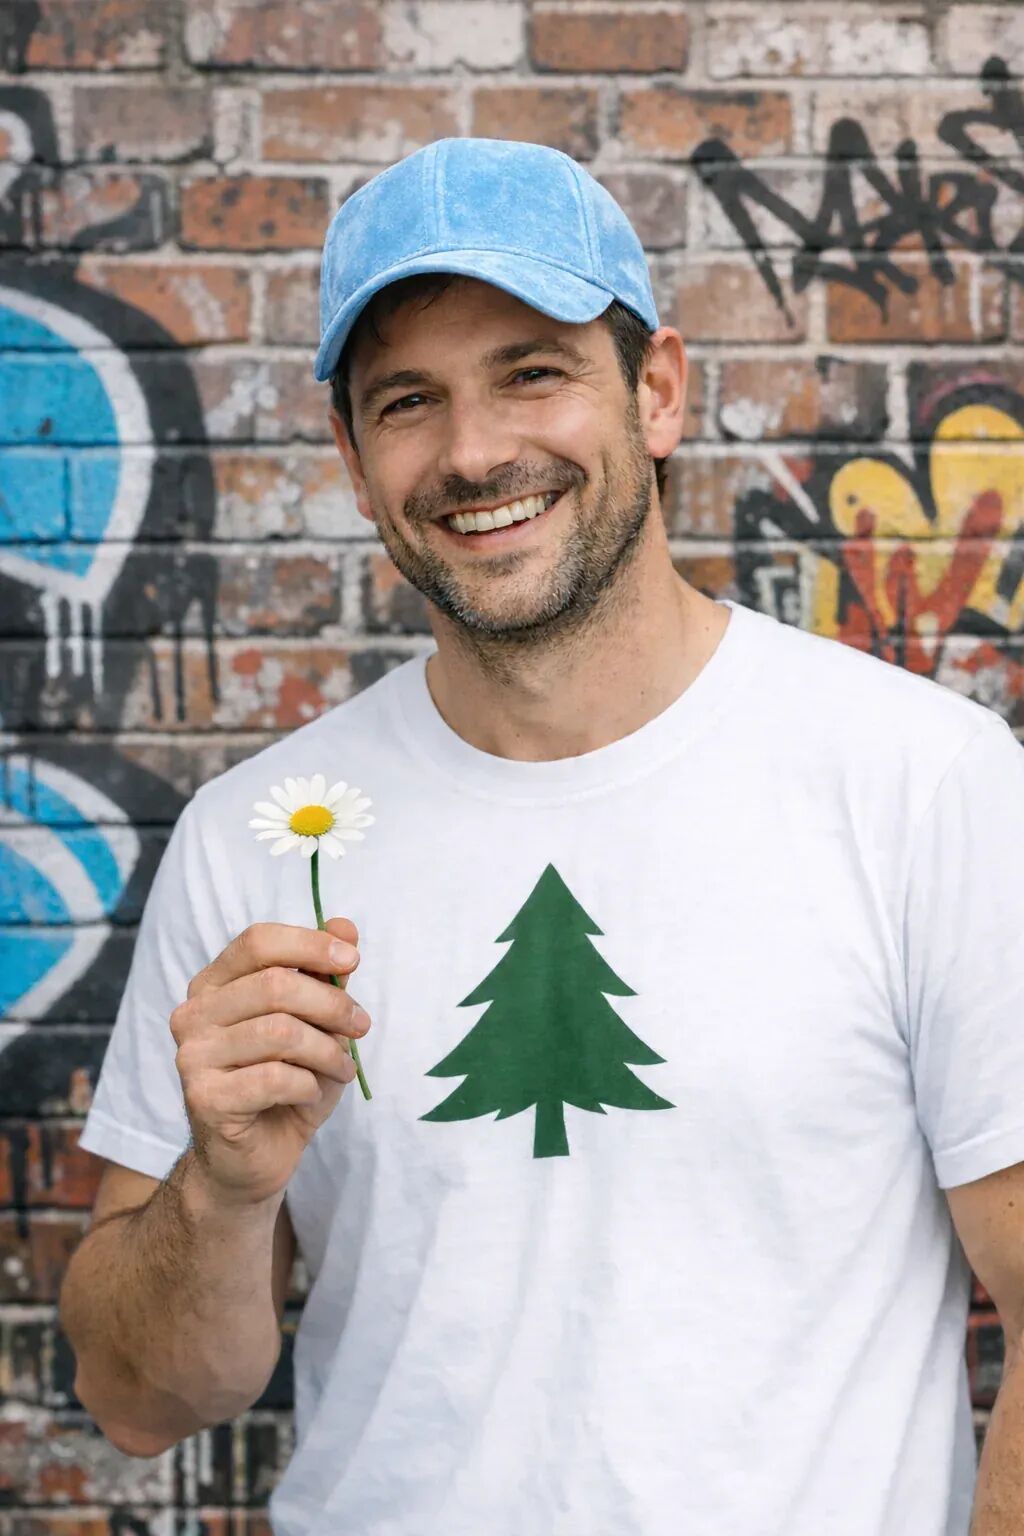
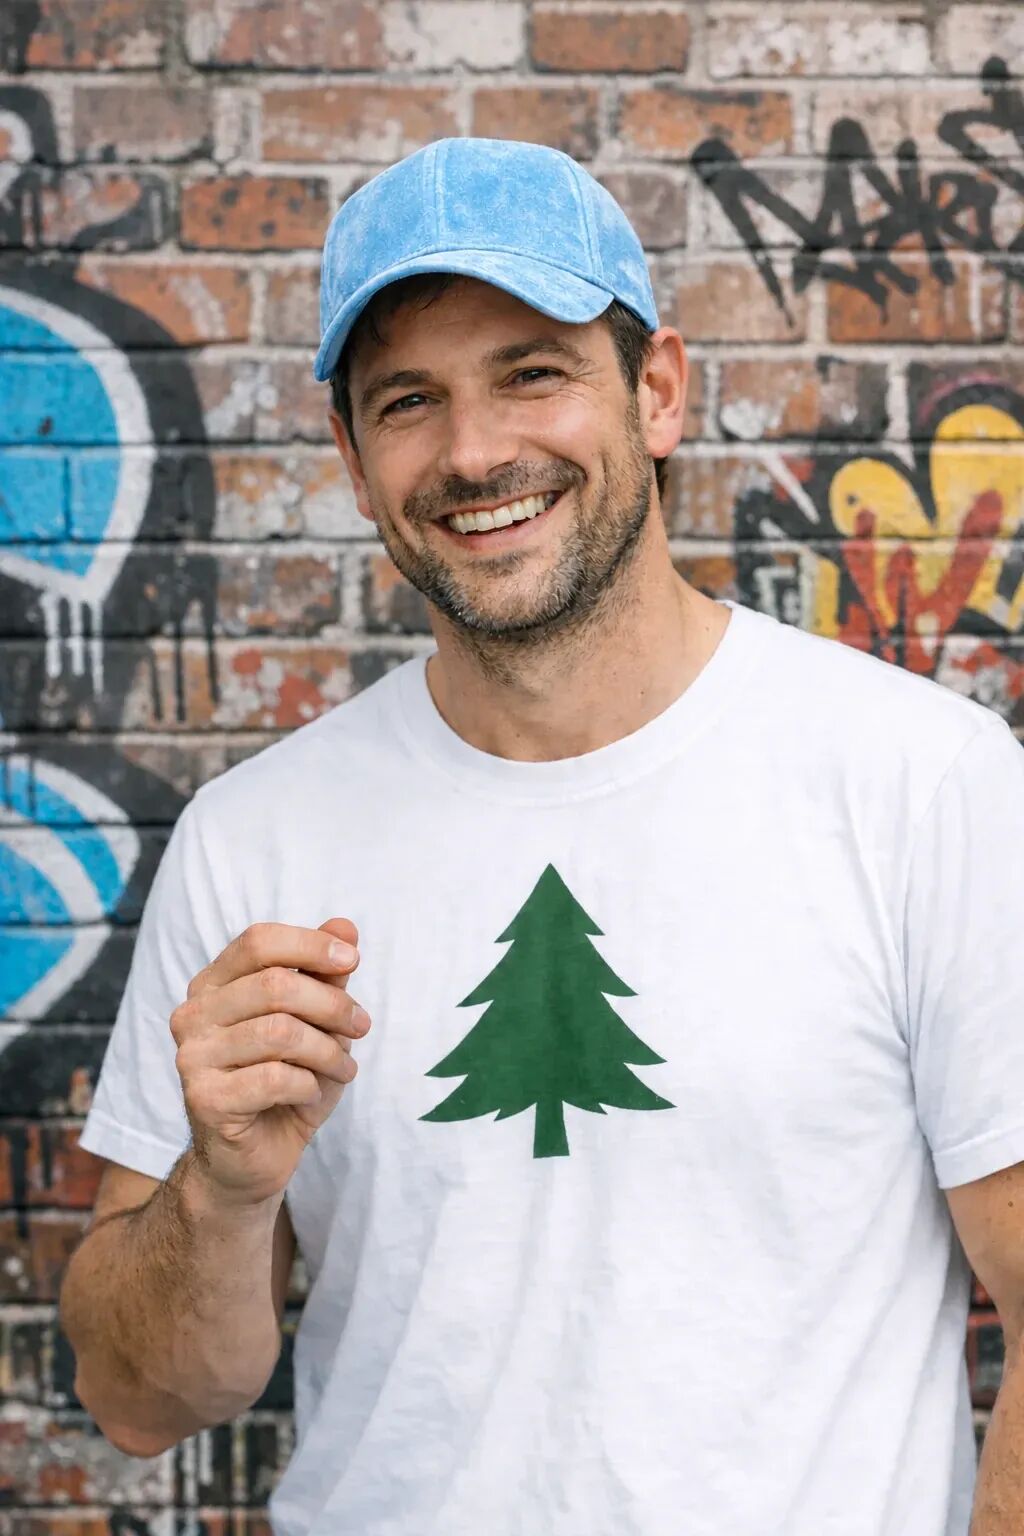
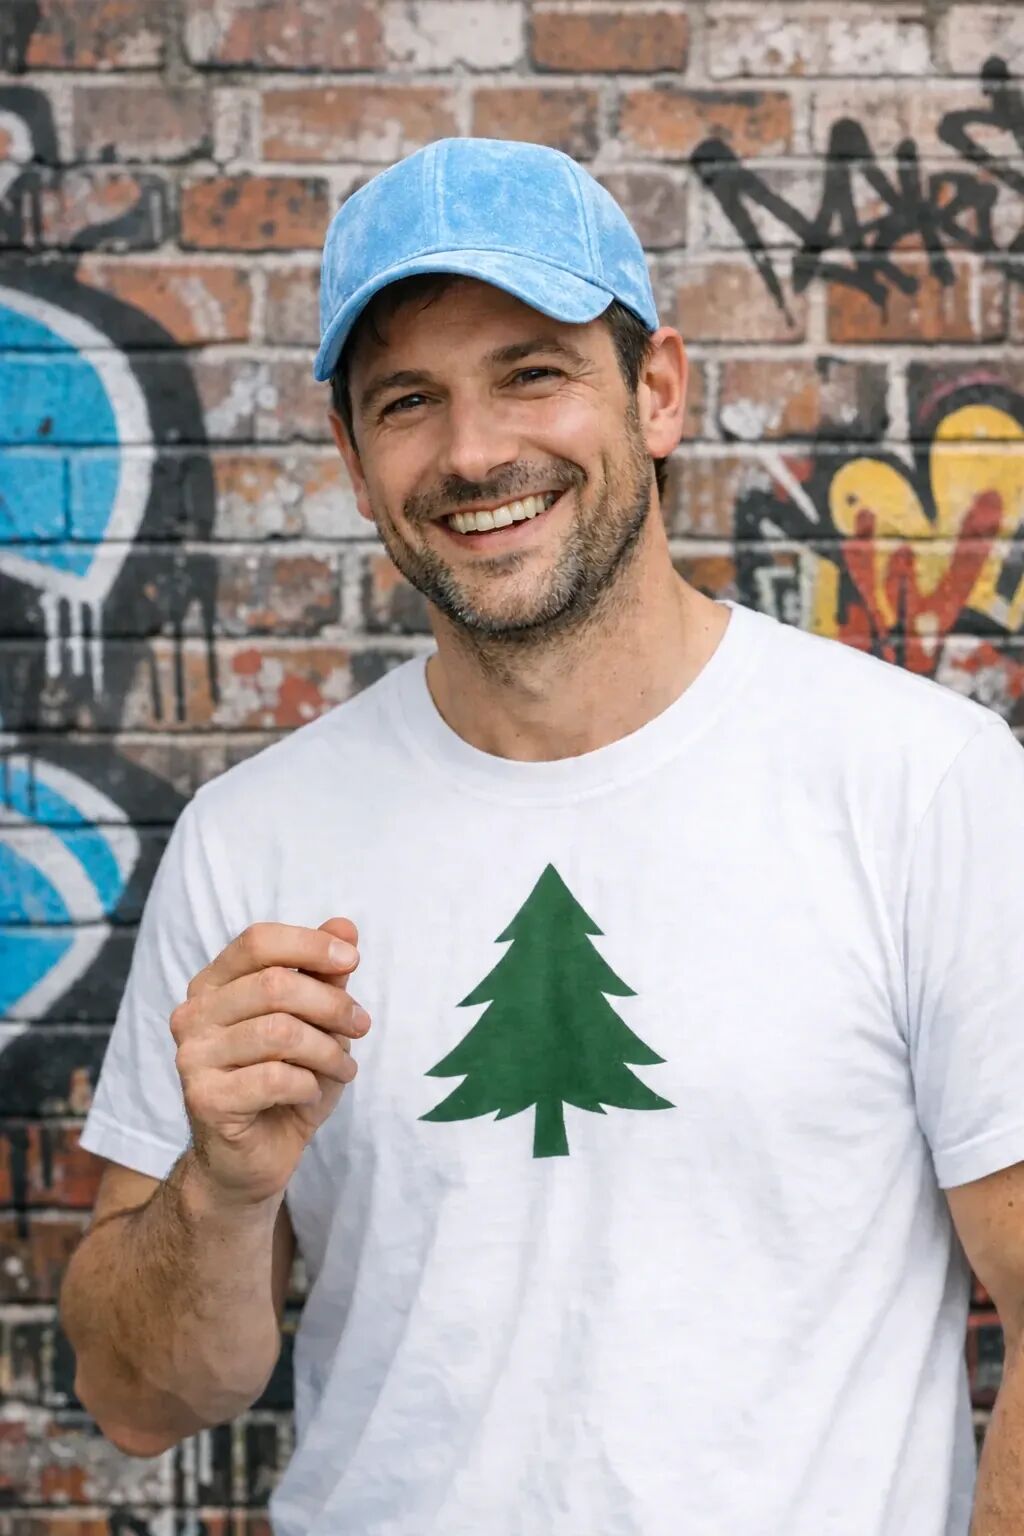
移除男子手中的花。不要改动其他任何内容。
输入图像
输入图 · 戴蓝帽、手持鲜花的男子
输出示例 · 左右滑动查看
GPT Image 2.5 Flare
GPT Image 2.5 Sunburst
将人物放入场景
将人物放入新场景,同时保留其身份特征。指定自然光线、可信的细节、人物取景范围、视线,以及人物与场景的互动。说明哪些面部特征和比例必须保持原样。对于 gpt-image-2,省略 input_fidelity;图像输入始终以高保真方式处理。
使用博物馆中的女性作为输入图像。
编辑设置:size="1024x1536" · quality="medium"。
提示词 · 17
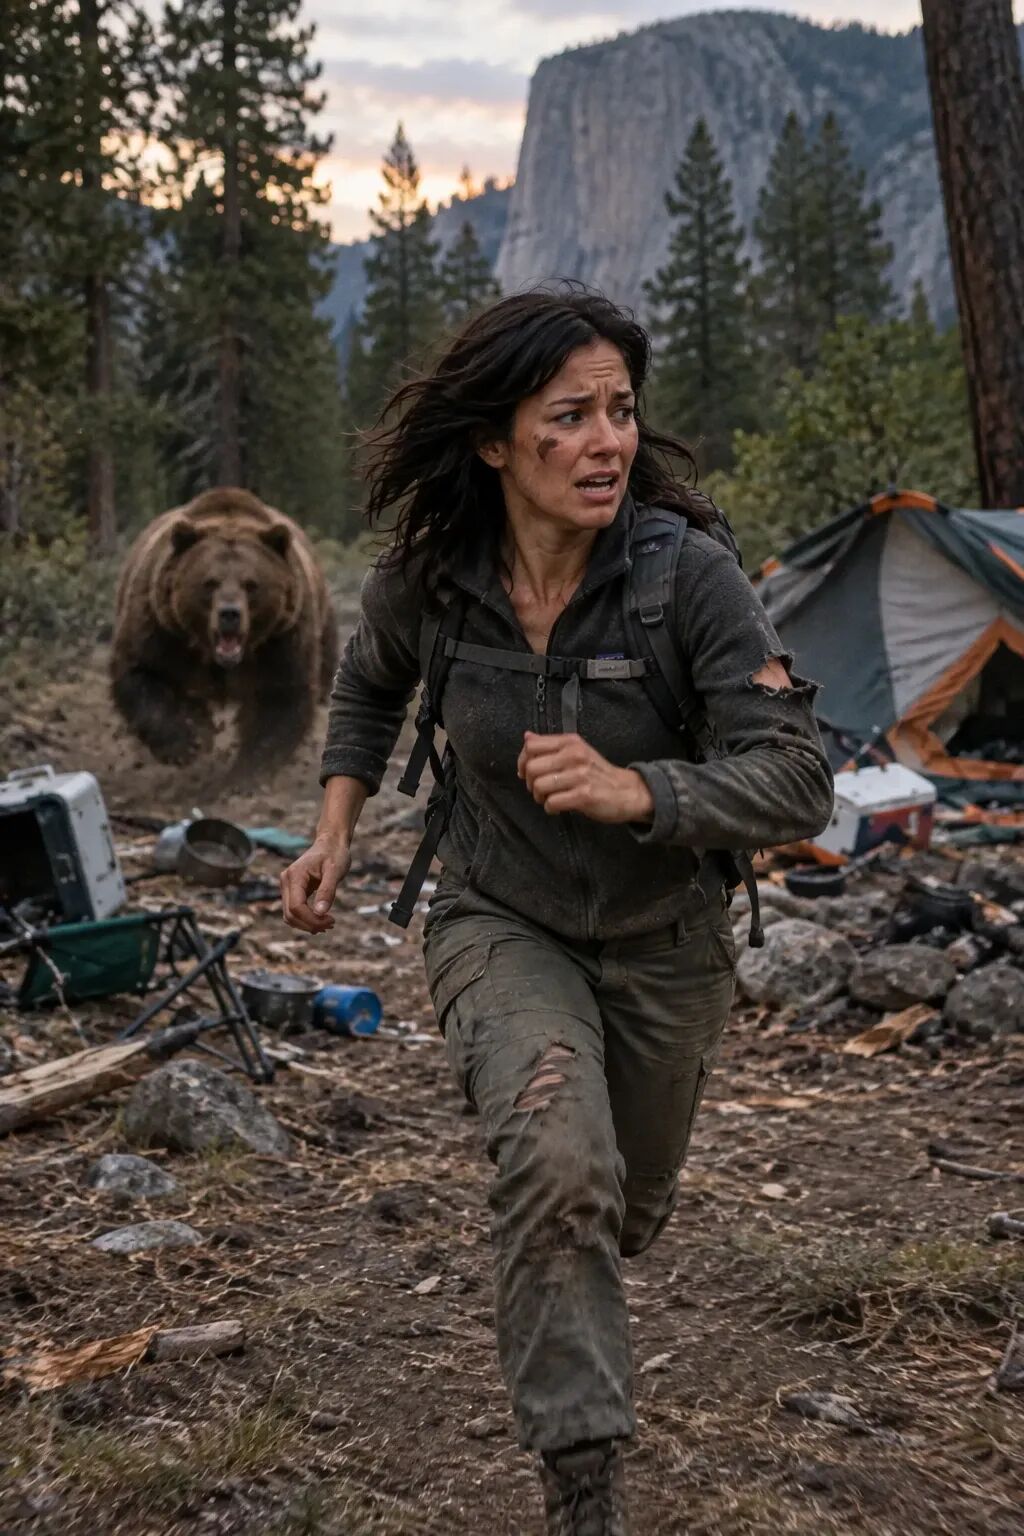
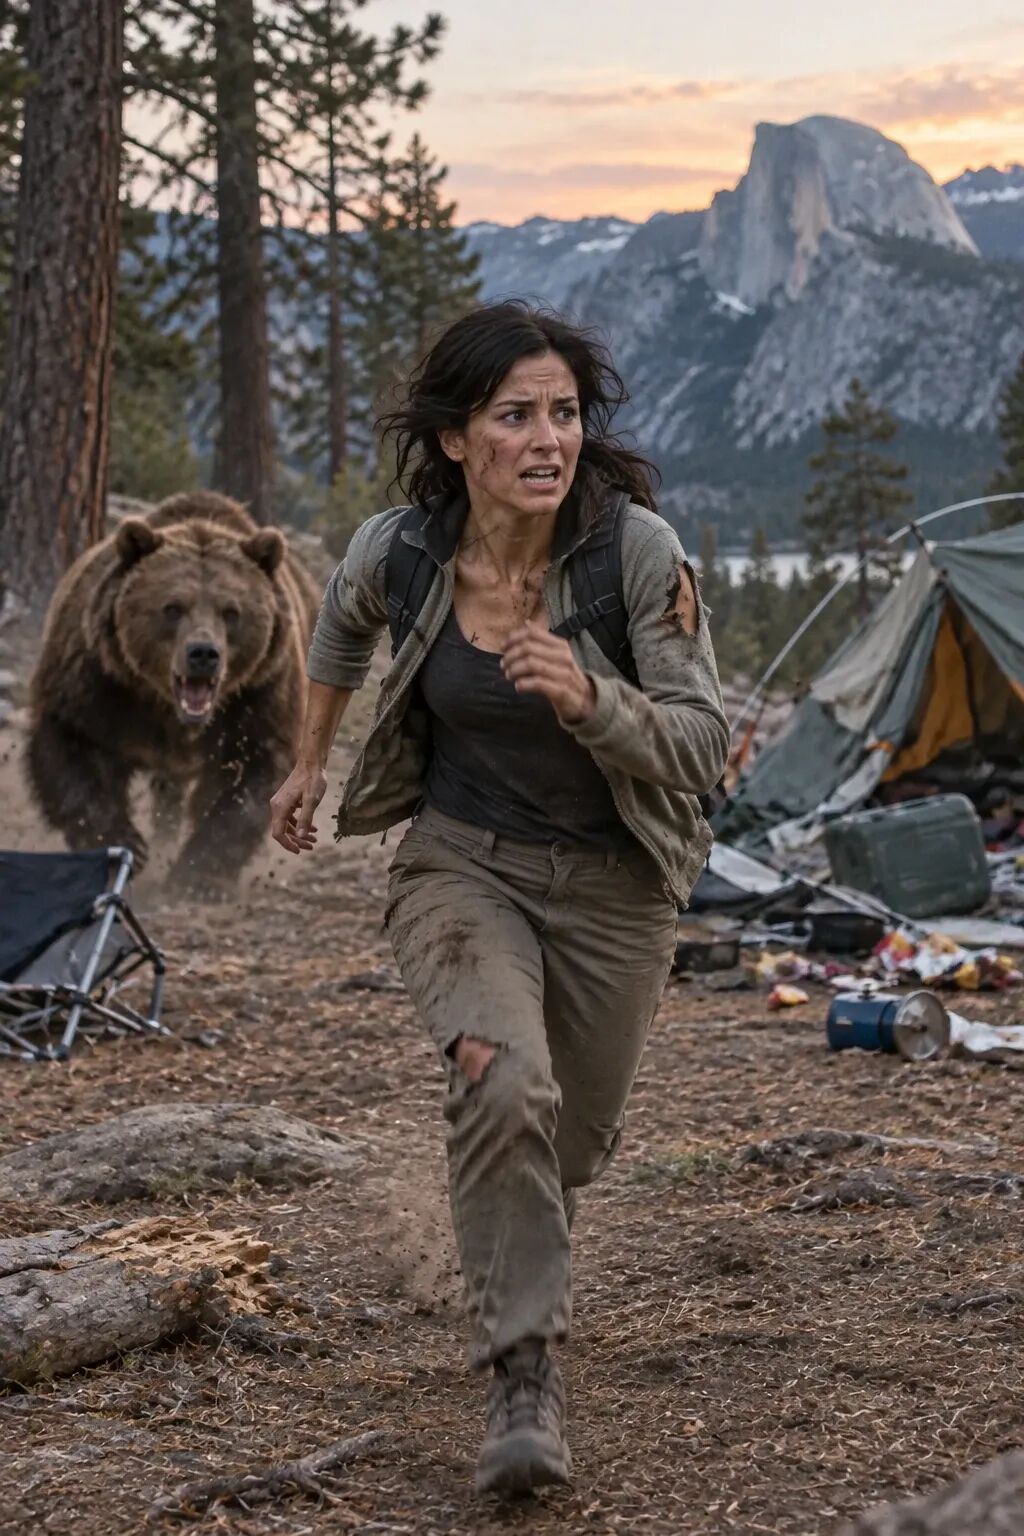
生成一个高度写实的动作场景:这个人正在逃离一只袭击营地的大型棕熊,棕熊的外观要真实。画面应像有人实际拍下的照片,避免过度增强或电影海报式的处理。
她位于画面中央,但视线朝向镜头以外,穿着适合露营的户外服装,脸上有泥土,衣服有破损。她明显感到害怕,但专注于逃离;她正在奔跑,身后的棕熊正在破坏营地。
营地位于优胜美地国家公园,具有可信的自然细节。时间是黄昏,使用自然光线和真实色彩。整个画面应自然、可信、未经风格化处理,像是捕捉到的真实瞬间。避免电影式照明、戏剧化调色或风格化构图。
输出示例 · 左右滑动查看
GPT Image 2.5 Flare
GPT Image 2.5 Sunburst
通过多轮交互细化图像
从一次输出开始,检查结果,再将它作为下一次的输入。每条后续请求都应聚焦于较小范围,以便判断是哪项改动带来了改善。
创建起始图像
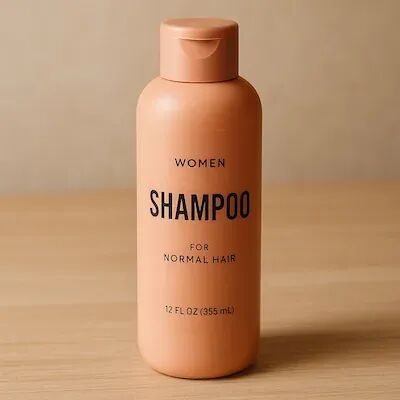
使用“制作透明背景的产品抠图”中的洗发水照片作为输入,制作这幅广告牌场景。准确引用标签文字。
编辑设置:size="1024x1536" · quality="medium"。
提示词 · 18
制作一张真实的洗发水广告牌效果图,场景是日落时的高速公路。
广告牌文字(必须逐字准确,不添加任何其他字符):
“Fresh and clean”
字体排版:粗体无衬线字,高对比度,居中,字距整洁。
确保文字只出现一次,并且完全清晰易读。
不要水印,不要标志。
文案译意:“Fresh and clean”:清新洁净。
输入图像
输入图 · 洗发水产品照片
输出示例 · 左右滑动查看
GPT Image 2.5 Flare
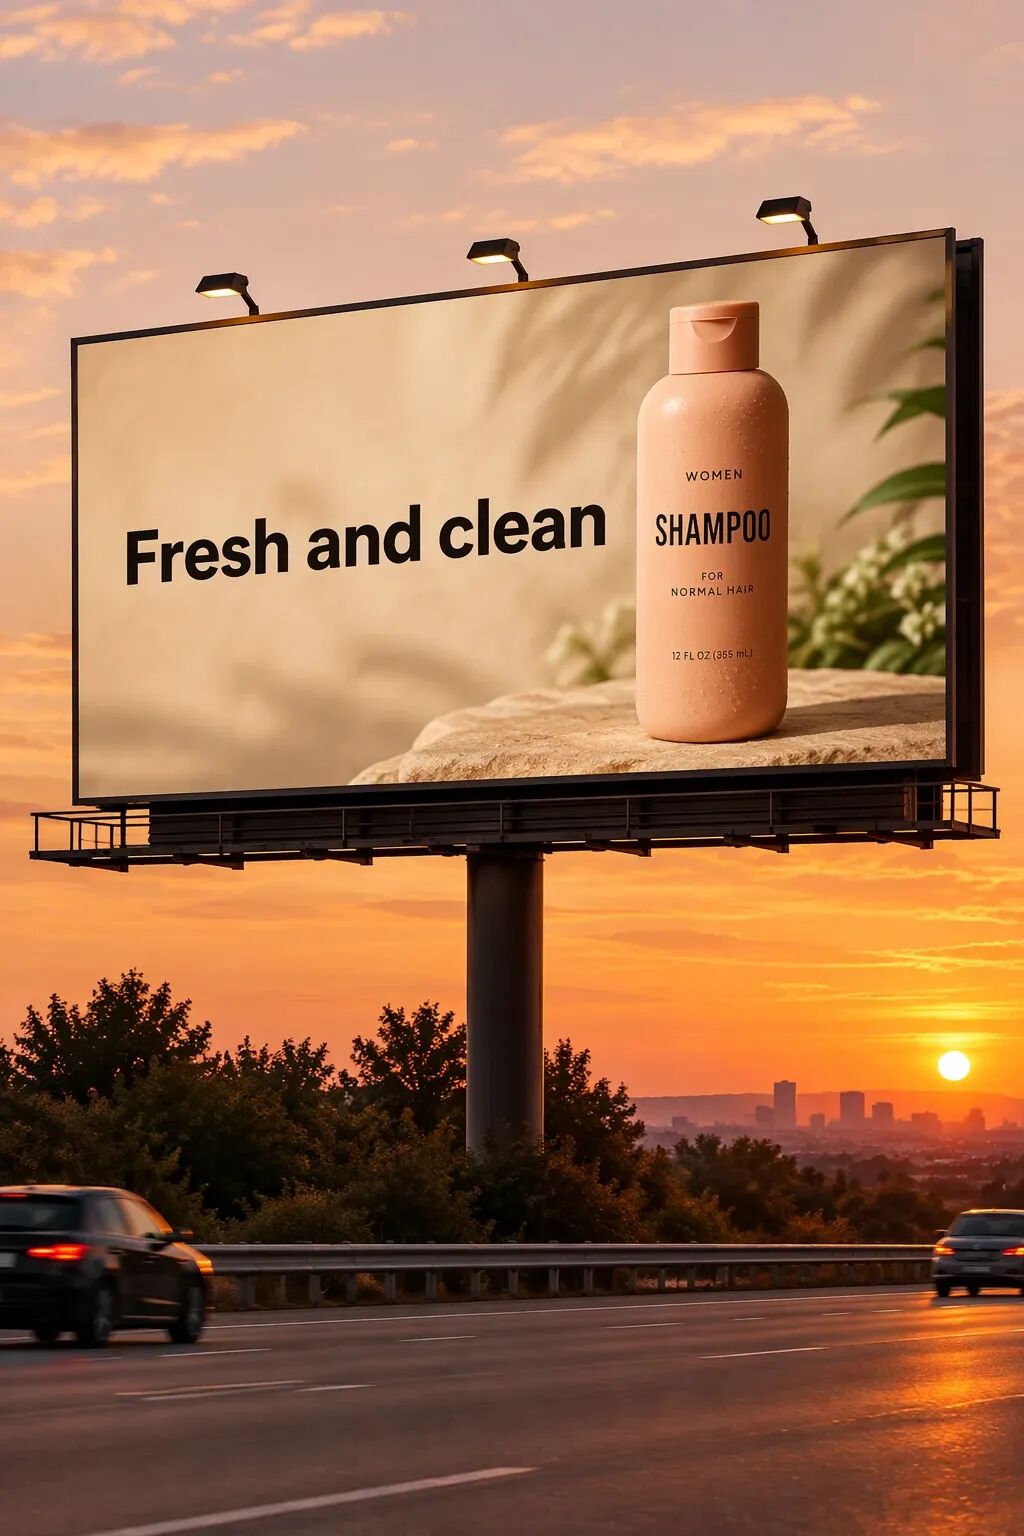
GPT Image 2.5 Sunburst
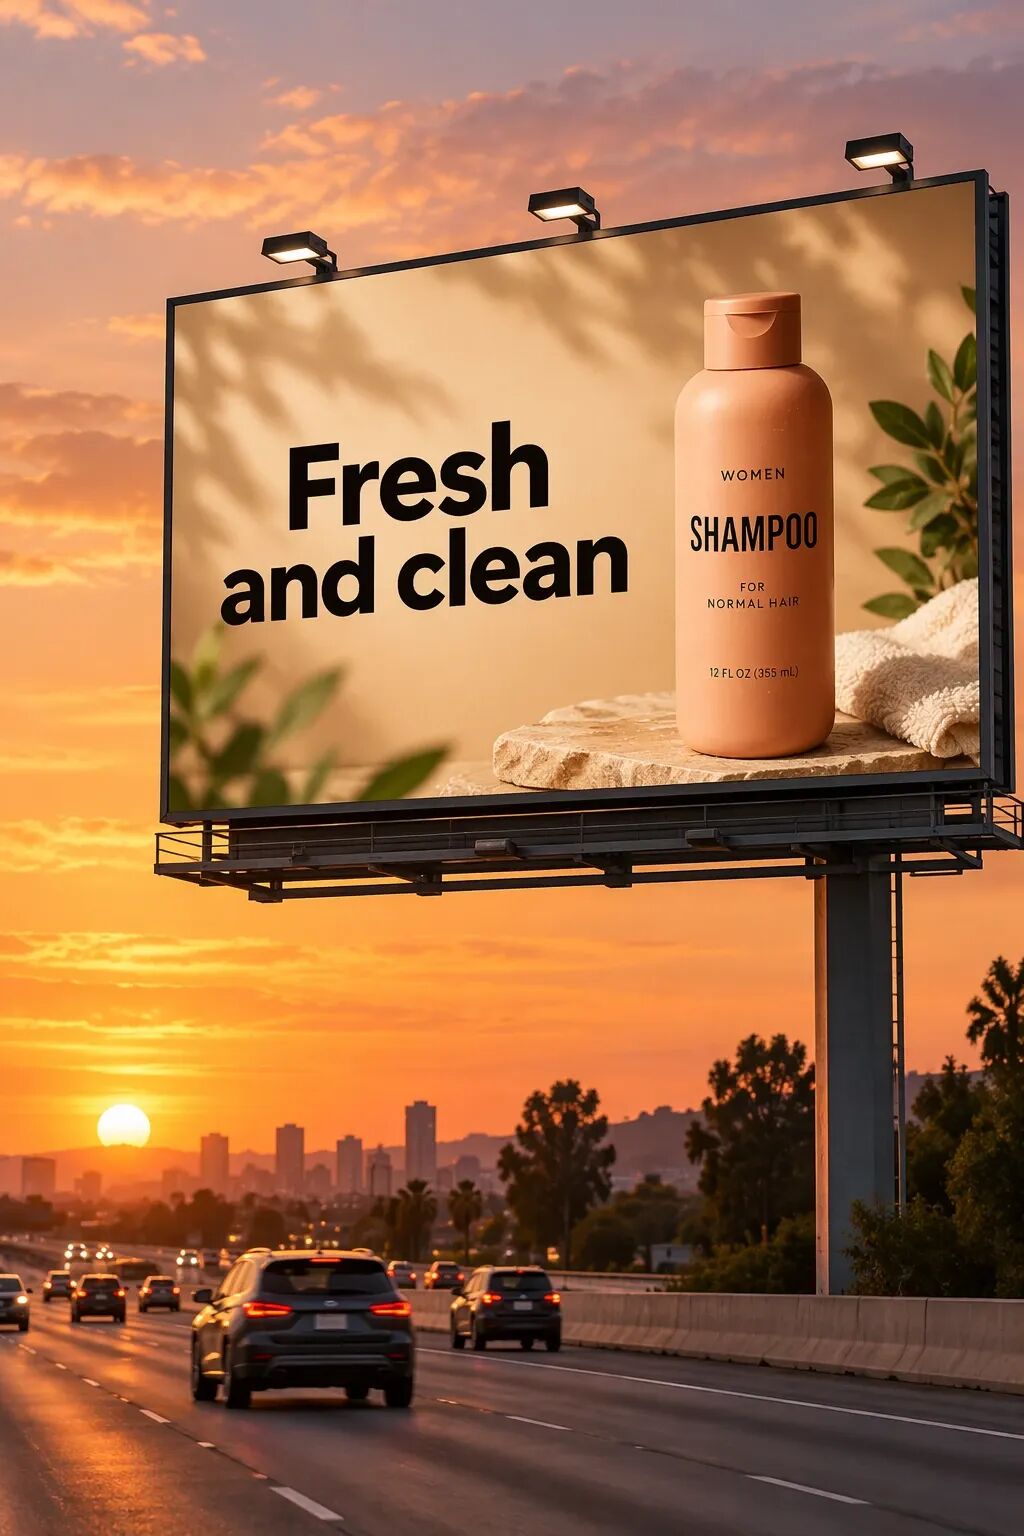
修改一个条件
将各模型在上一步生成的广告牌图像传入各自的下一次编辑请求。这条简短的后续提示词会改变天气,同时保留现有场景。
编辑设置:size="1024x1536" · quality="medium"。
输出示例 · 左右滑动查看
GPT Image 2.5 Flare
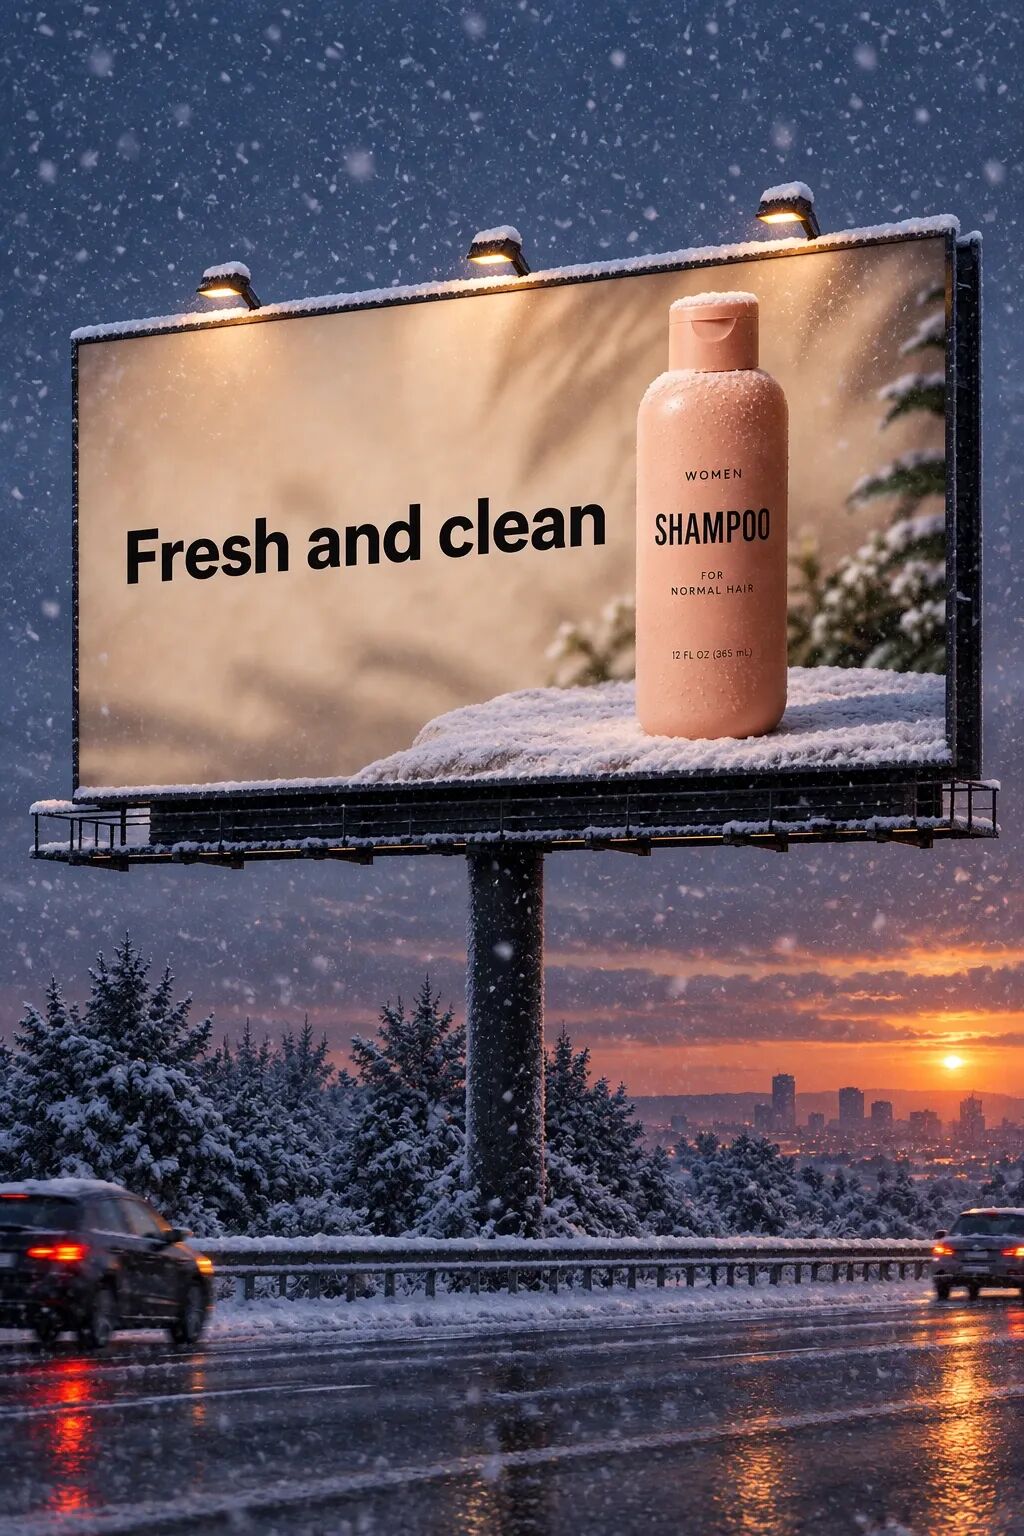
GPT Image 2.5 Sunburst
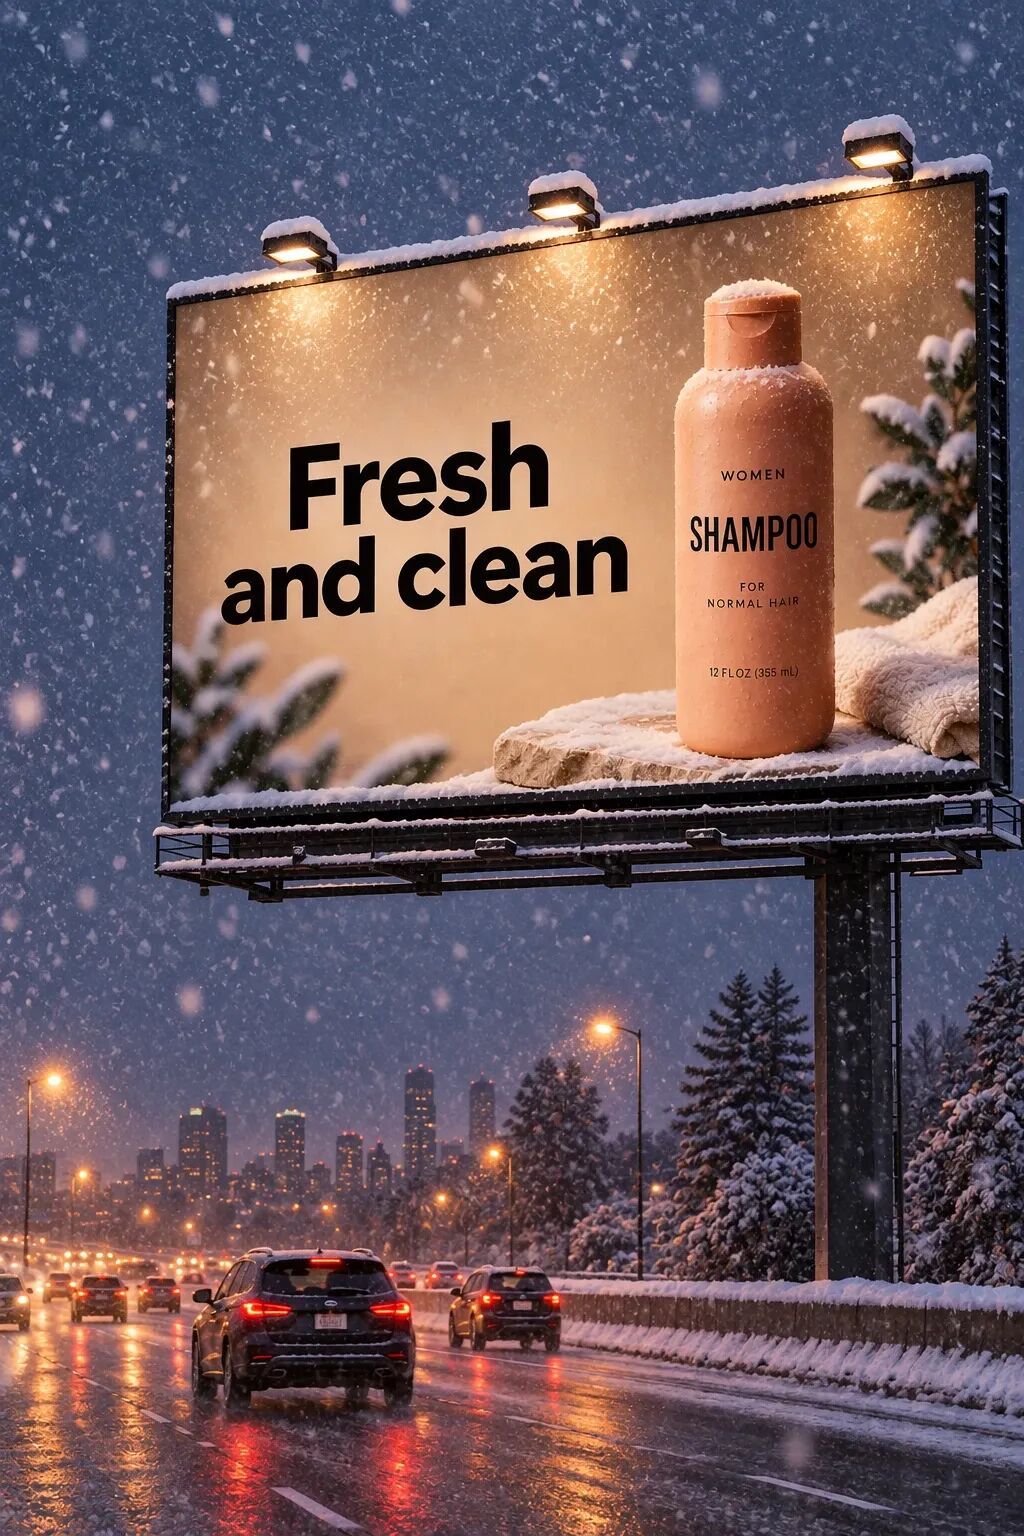
保持角色一致
对于包含多幅插画的书籍,创建可重复使用的角色参考图,有助于在不同场景、姿势和页面之间保留角色外观。改变环境和故事,同时重复角色的标志性细节。
建立角色
定义角色的外貌、比例、服装和气质。
生成设置:size="1024x1536" · quality="medium"。
提示词 · 20
创作一幅介绍主角的儿童读物插画。
角色:
一位童话风格的年轻英雄,灵感来自一名小小的森林侠盗,身穿简洁的绿色连帽短袍、柔软的棕色靴子,腰间带着一个小腰包。
角色表情友善、眼神温柔,气质勇敢而温暖。
携带一把小木弓,只用于帮助他人,绝不用于伤害。
主题:
角色保护和救助松鼠、鸟和兔子等森林小动物。
风格:
儿童读物插画,手绘水彩质感,轮廓柔和,温暖的大地色,充满奇想且亲切友好。
比例适合绘本:头部略大,面部富有表现力。
约束:
• 原创角色,不使用受版权保护的角色。
• 不要文字。
• 不要水印。
• 使用简洁的森林背景,以清楚展示角色。
输出示例 · 左右滑动查看
GPT Image 2.5 Flare
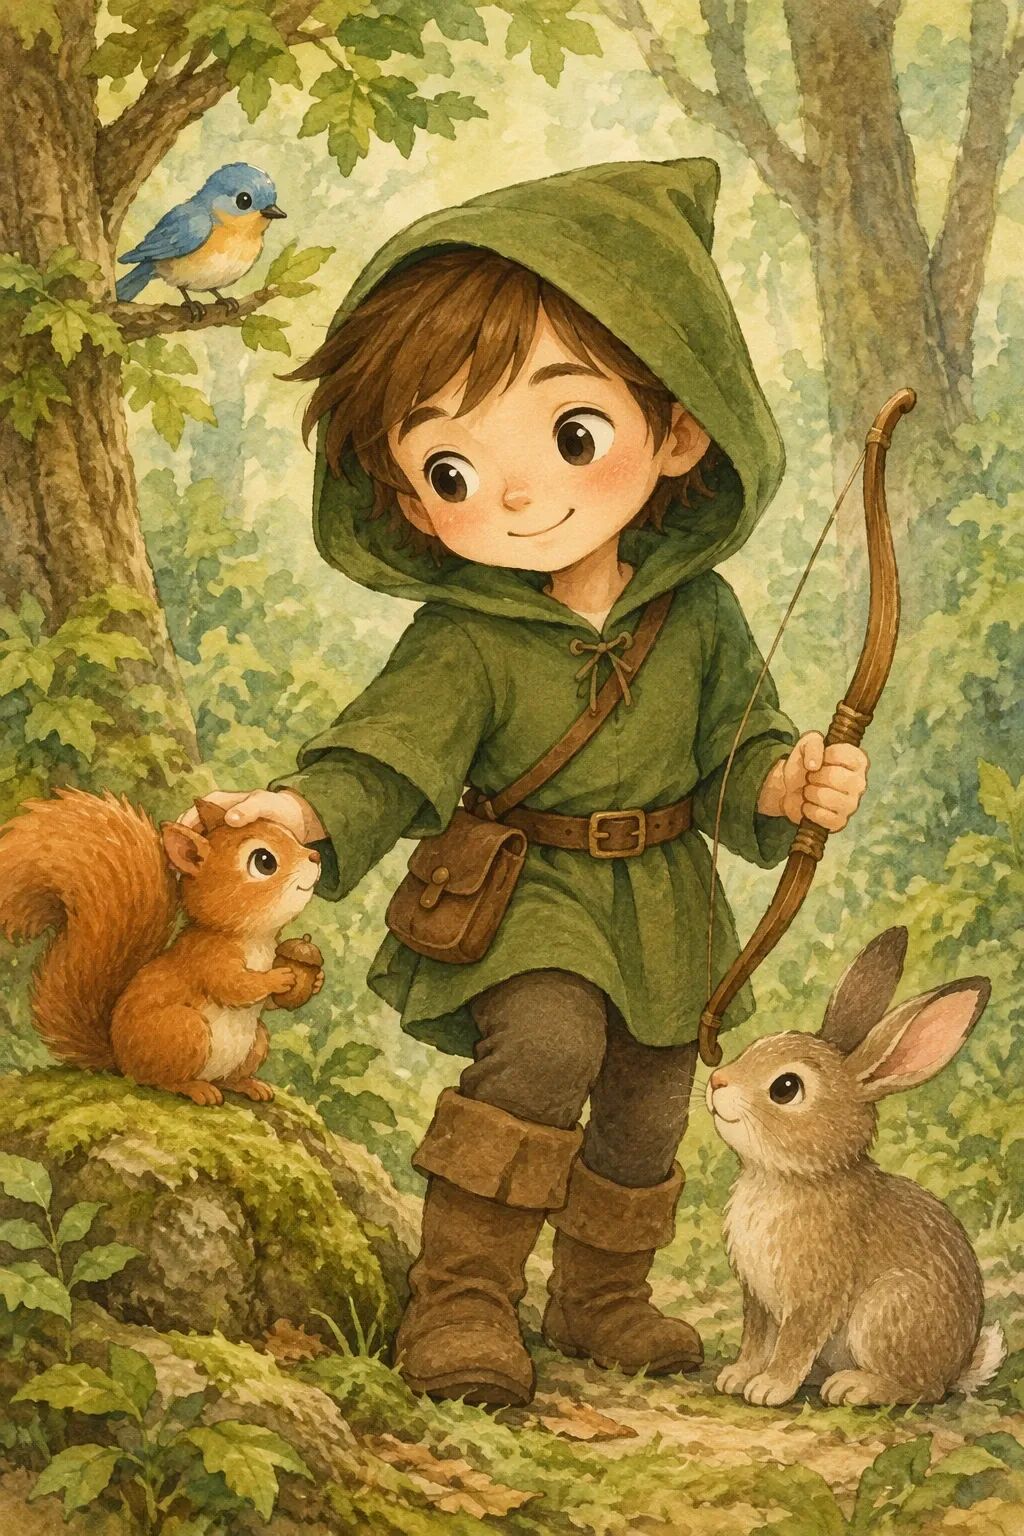
GPT Image 2.5 Sunburst
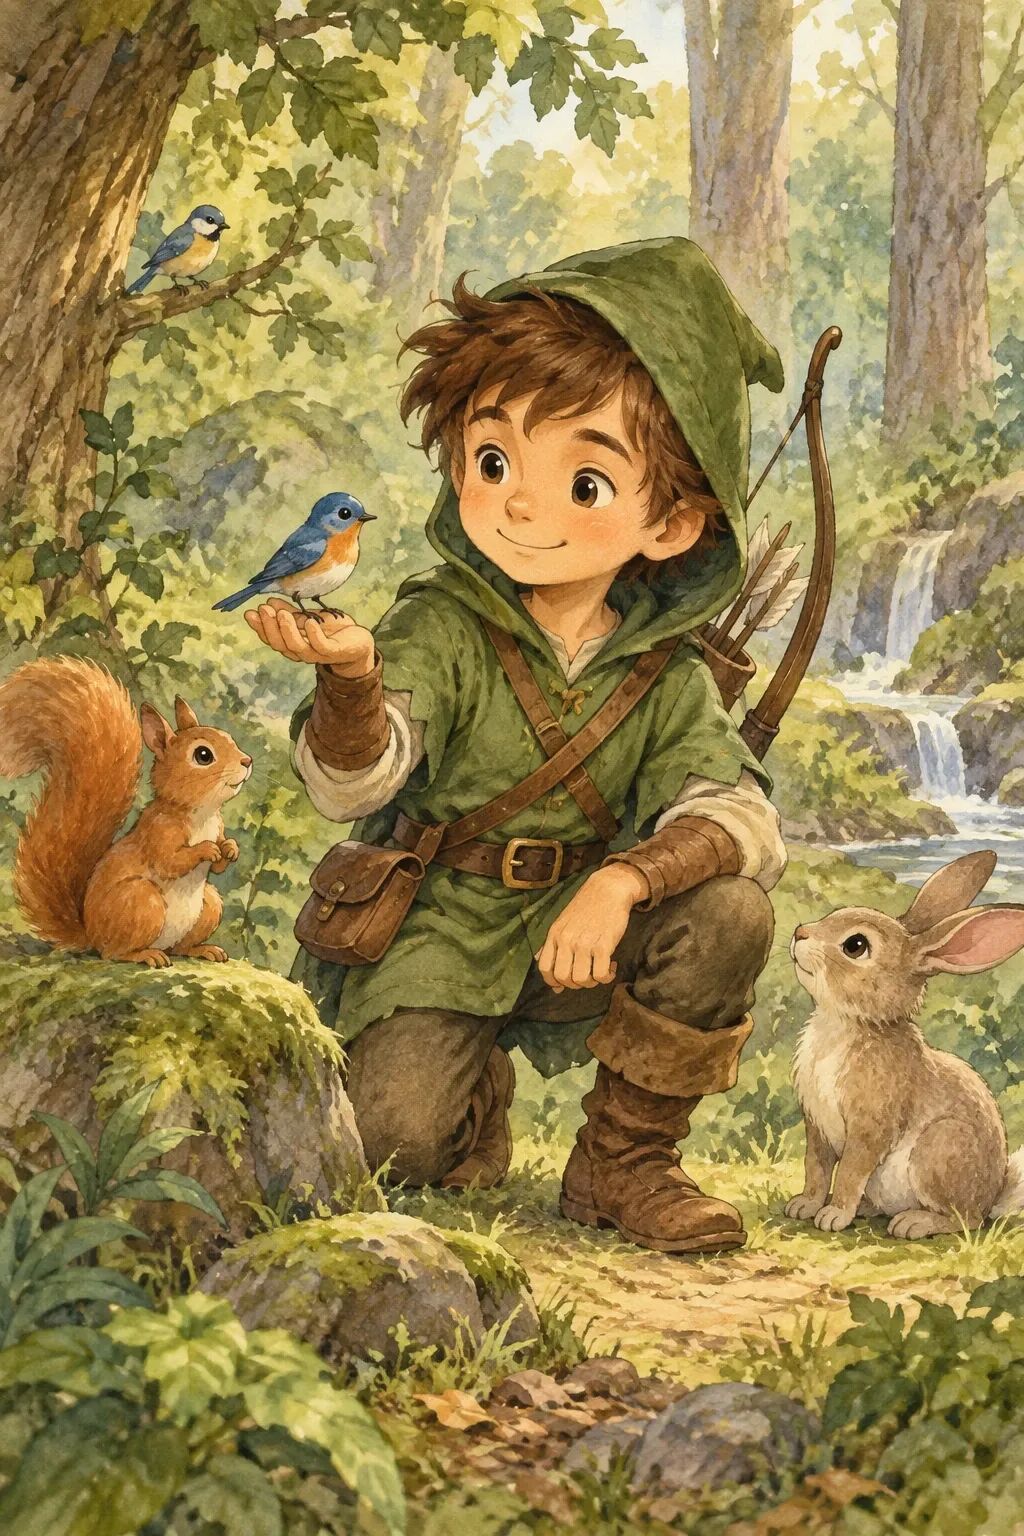
延续故事
重复使用各模型生成的角色图像,并描述一个新场景。再次说明外貌约束,使角色保持一致。
编辑设置:size="1024x1536" · quality="medium"。
提示词 · 21
使用同一个角色,继续这个儿童读物故事。
场景:
冬季风暴过后,同一位年轻森林英雄正温柔地帮助一只受惊的松鼠,从倒下的树中脱困。
角色跪在松鼠旁边,安抚它。
角色一致性:
• 相同的绿色连帽短袍。
• 相同的面部特征、比例和配色。
• 相同的温柔、勇敢的个性。
风格:
儿童读物水彩插画,柔和光线,积雪覆盖的森林环境,温暖且令人安心的氛围。
约束:
• 不要重新设计角色。
• 不要文字。
• 不要水印。
输出示例 · 左右滑动查看
GPT Image 2.5 Flare
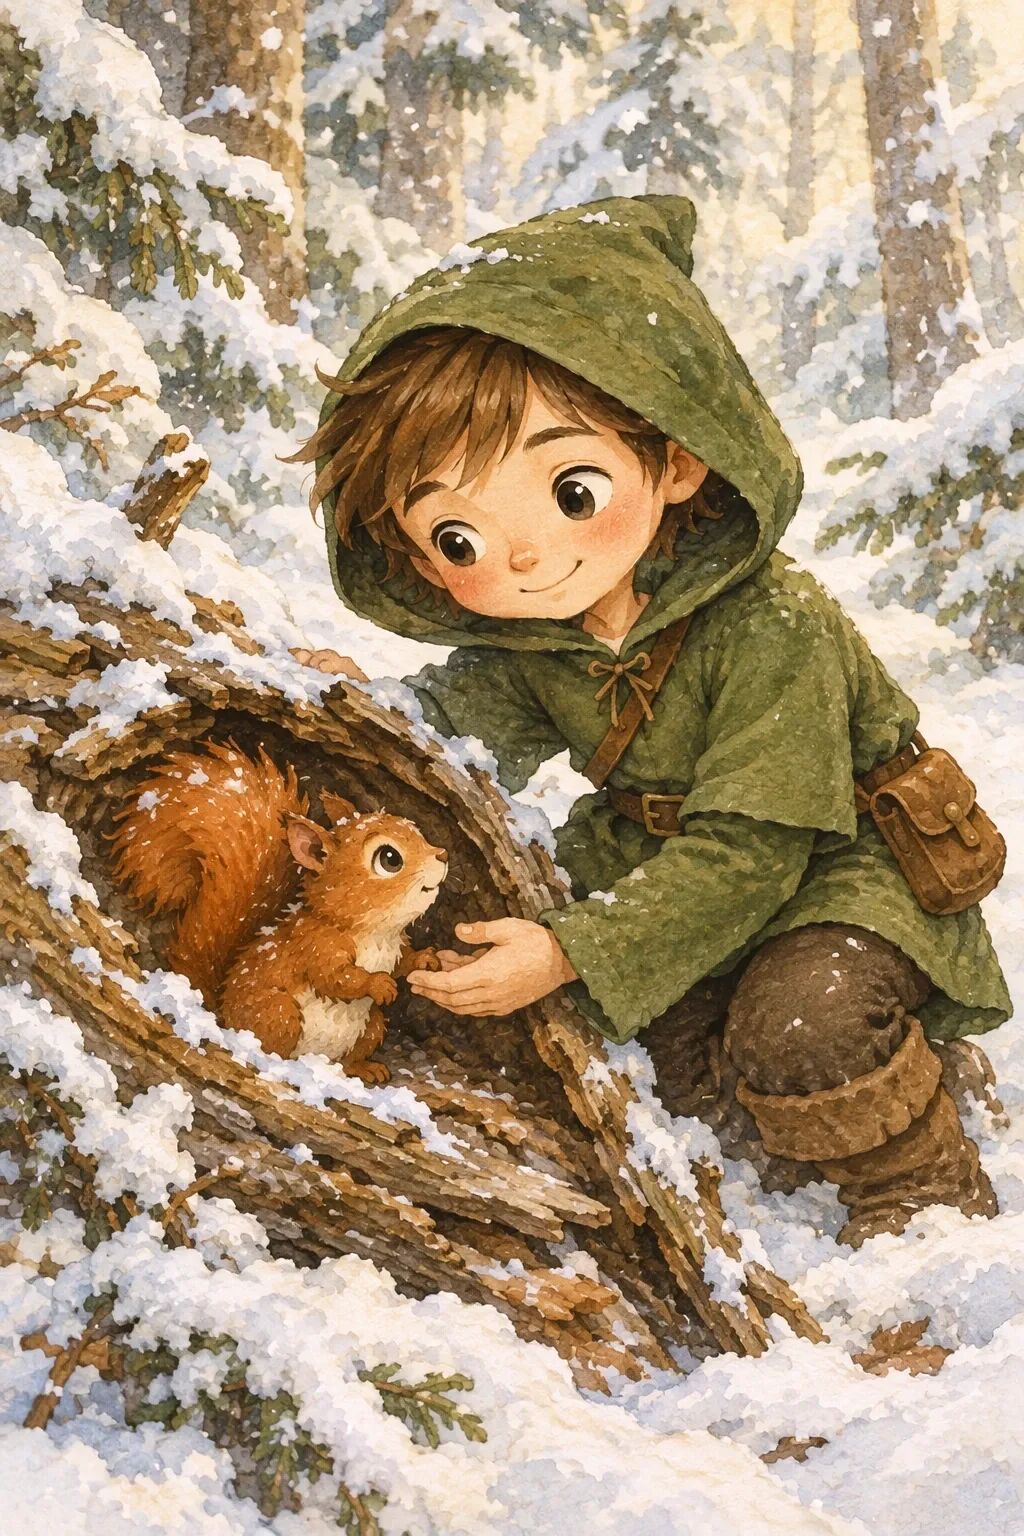
GPT Image 2.5 Sunburst
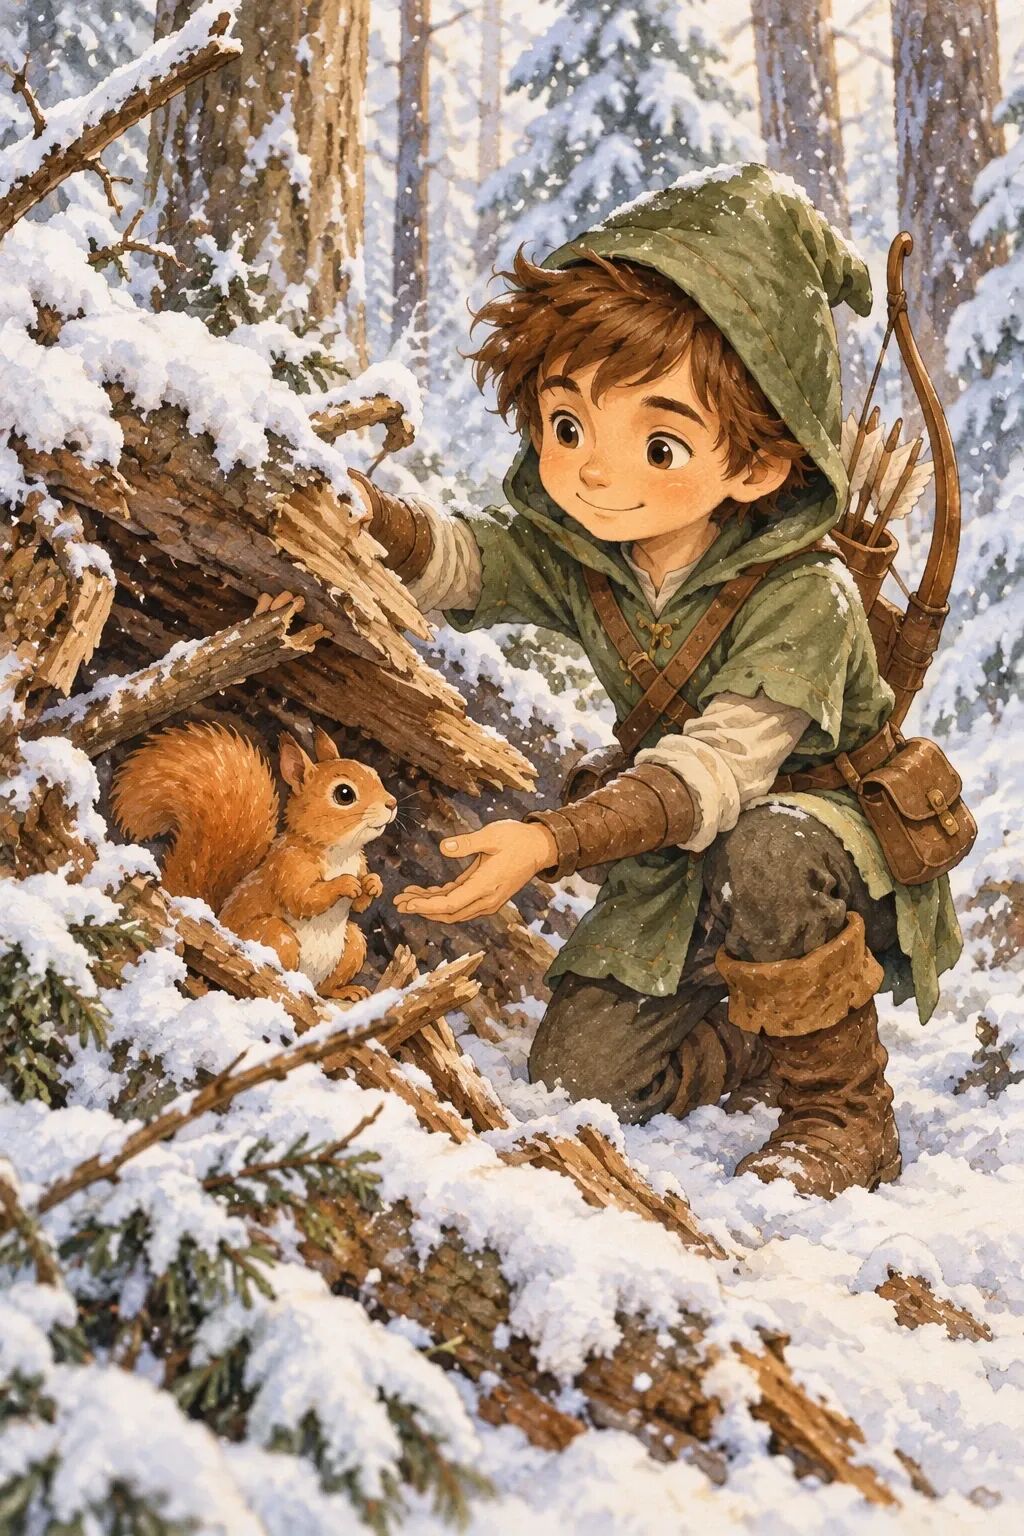
更多工作流程
更换房间里的家具
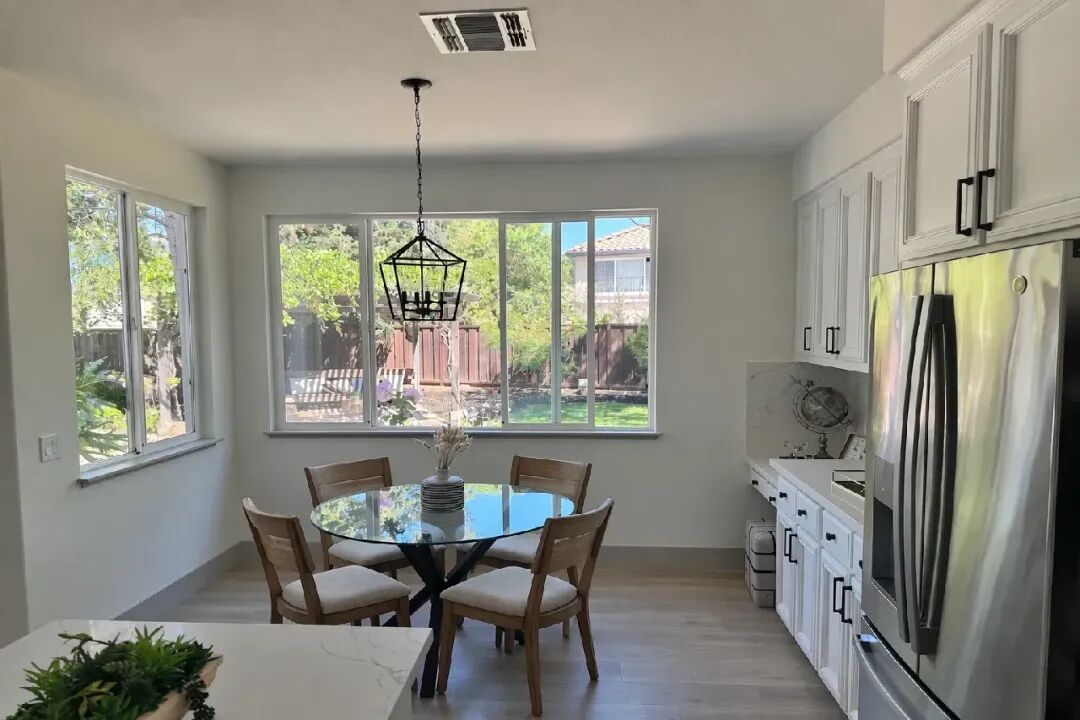
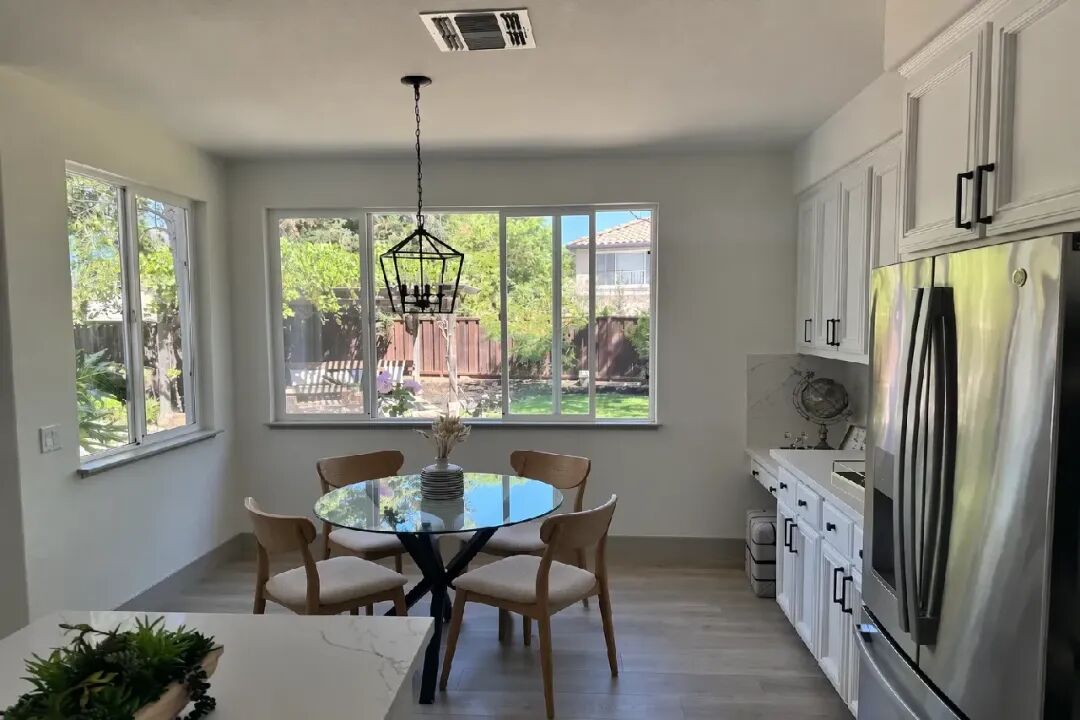
在真实空间中呈现家具或装饰的变化,无需重新构建整个场景。目标是精确局部编辑的真实感:更换单个物体,同时保留相机角度、光线、阴影和周围环境,让编辑结果像一张真实照片,避免变成一次整体重新设计。
编辑设置:size="1536x1024" · quality="medium"。
提示词 · 22
在这张房间照片中,只将白色椅子替换为木制椅子。
保留相机角度、房间光线、地板上的阴影和周围物体。
保持图像的其他所有方面不变。
呈现照片级写实的接触阴影和织物纹理。
输入图像
输入图 · 摆放白色椅子的厨房
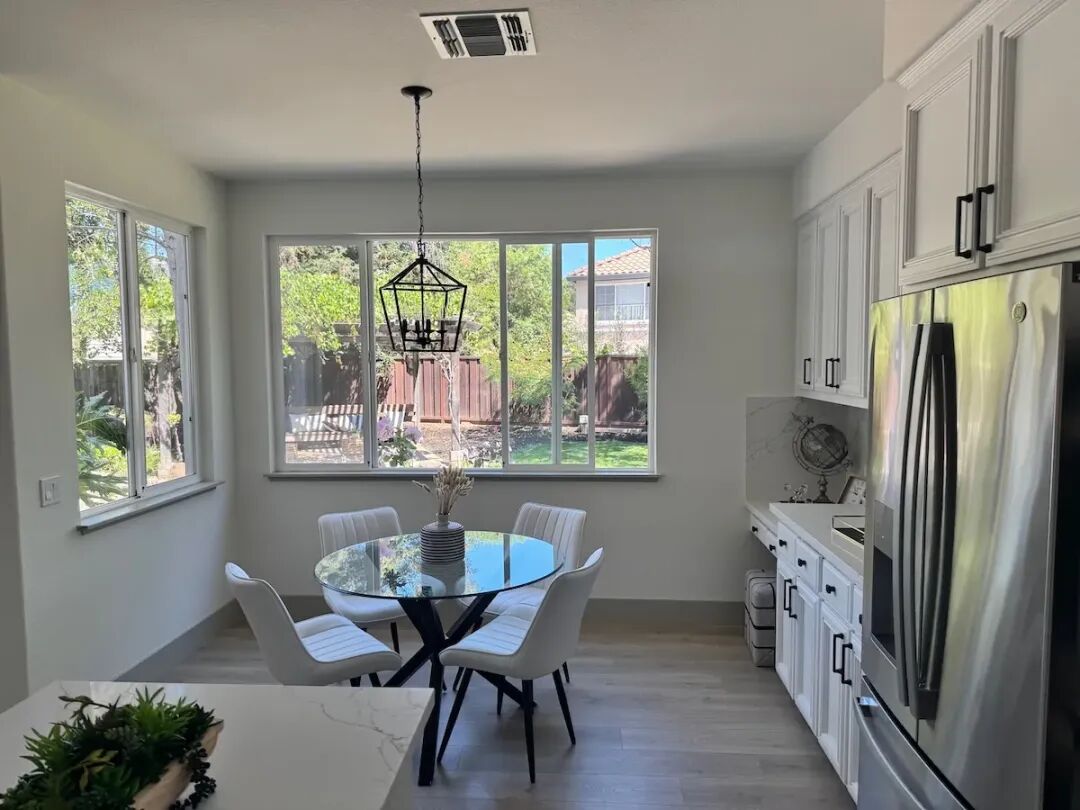
输出示例 · 左右滑动查看
GPT Image 2.5 Flare
GPT Image 2.5 Sunburst
设计节日贺卡
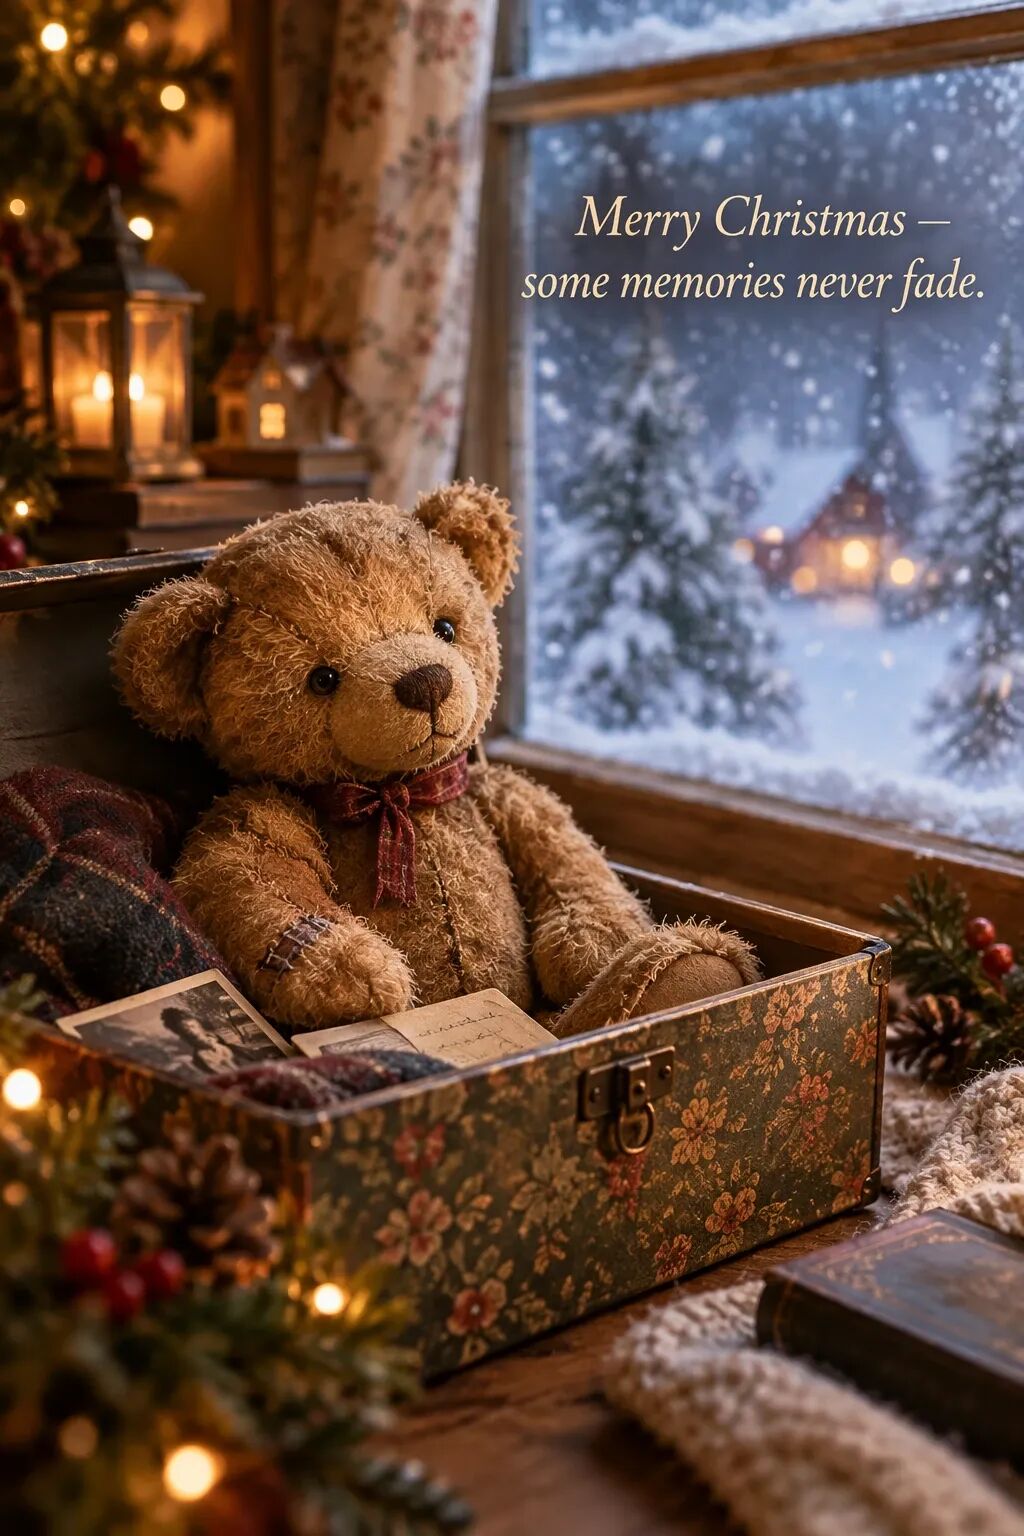
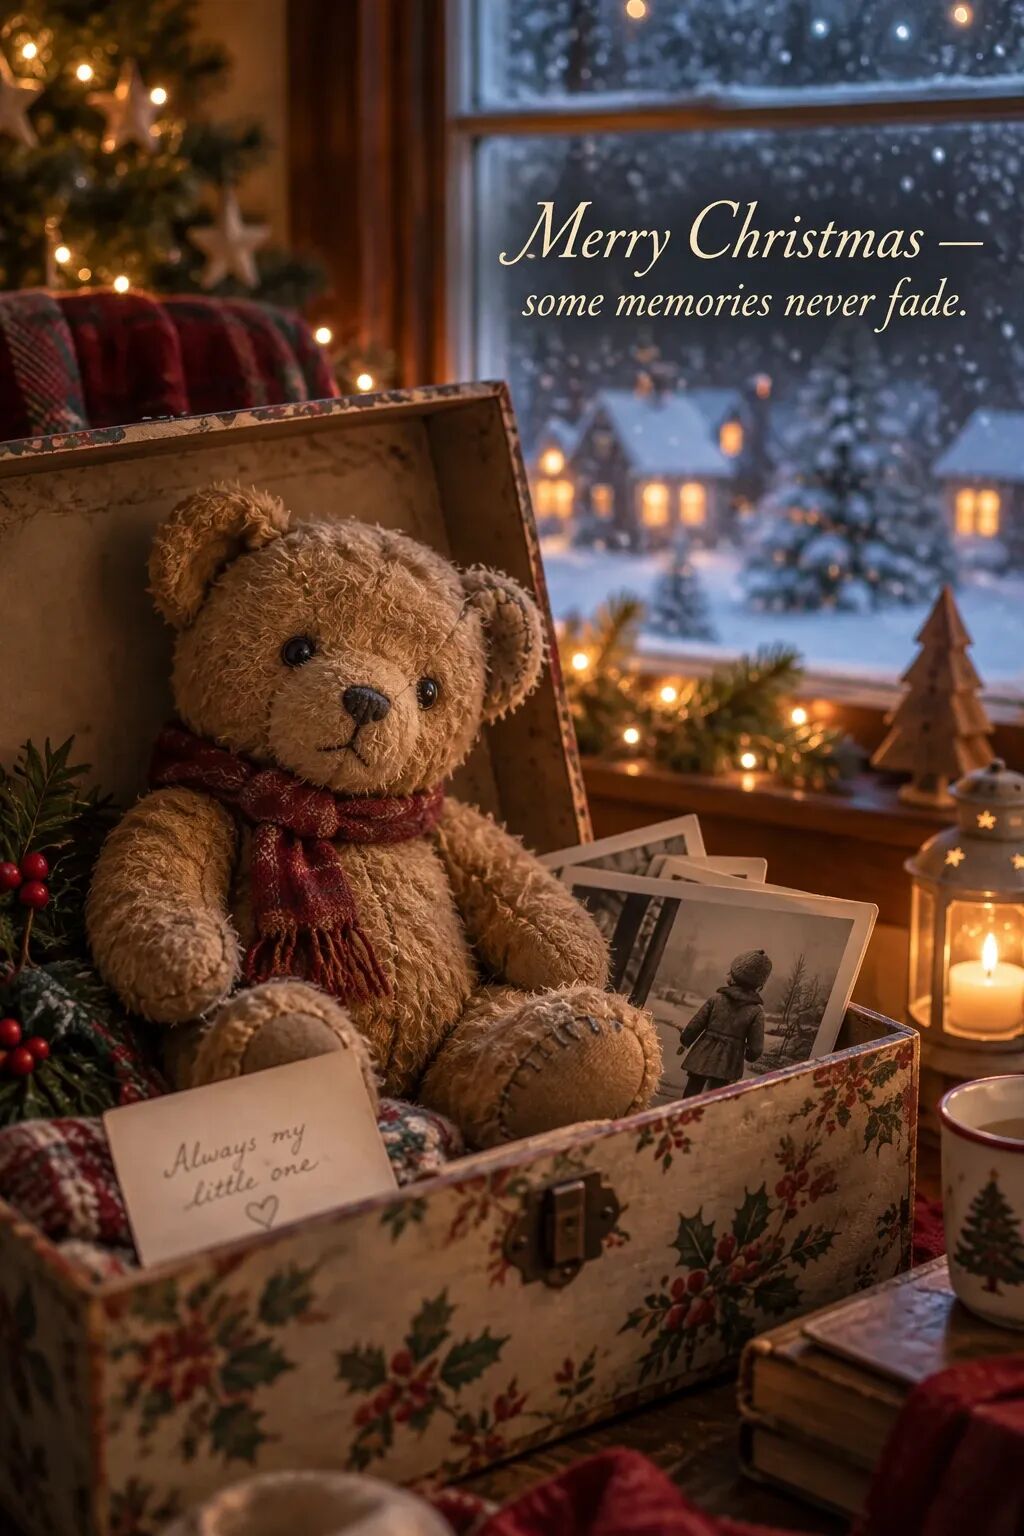
构思节日贺卡时,描述场景、情绪基调、材质、光线和准确文案。如果采用 3D 立体贺卡或实拍贺卡的表现方式,要指定纸张层次、纤维、折痕,以及柔和的棚拍光线。下面的示例采用怀旧的泰迪熊场景。
生成设置:size="1024x1536" · quality="medium"。
提示词 · 23
创作一幅圣诞节贺卡插画。
场景:
一个温馨的圣诞场景:一只旧泰迪熊坐在纪念品盒里,毛发略有磨损,身上有柔软的缝补痕迹。盒子放在窗边,窗外正在飘雪。场景暗示孩子已经长大,但回忆仍在。
情绪:
温暖、怀旧、温柔、富有情感。
风格:
高品质节日贺卡摄影,柔和的电影式光线,真实纹理,浅景深,有品位的散景灯光,适合高品质印刷的构图。
约束:
• 仅使用原创作品。
• 不要商标。
• 不要水印。
• 不要标志。
仅包含以下贺卡文字,逐字呈现:
“Merry Christmas — some memories never fade.”
文案译意:“Merry Christmas — some memories never fade.”:圣诞快乐,有些回忆永不褪色。
输出示例 · 左右滑动查看
GPT Image 2.5 Flare
GPT Image 2.5 Sunburst
设计收藏商品
使用产品摄影中的材质、包装和印刷清晰度等视觉特征,探索商品与包装概念。保持设计原创且不侵权,并比较多个角色或包装变体。
生成设置:size="1024x1536" · quality="medium"。
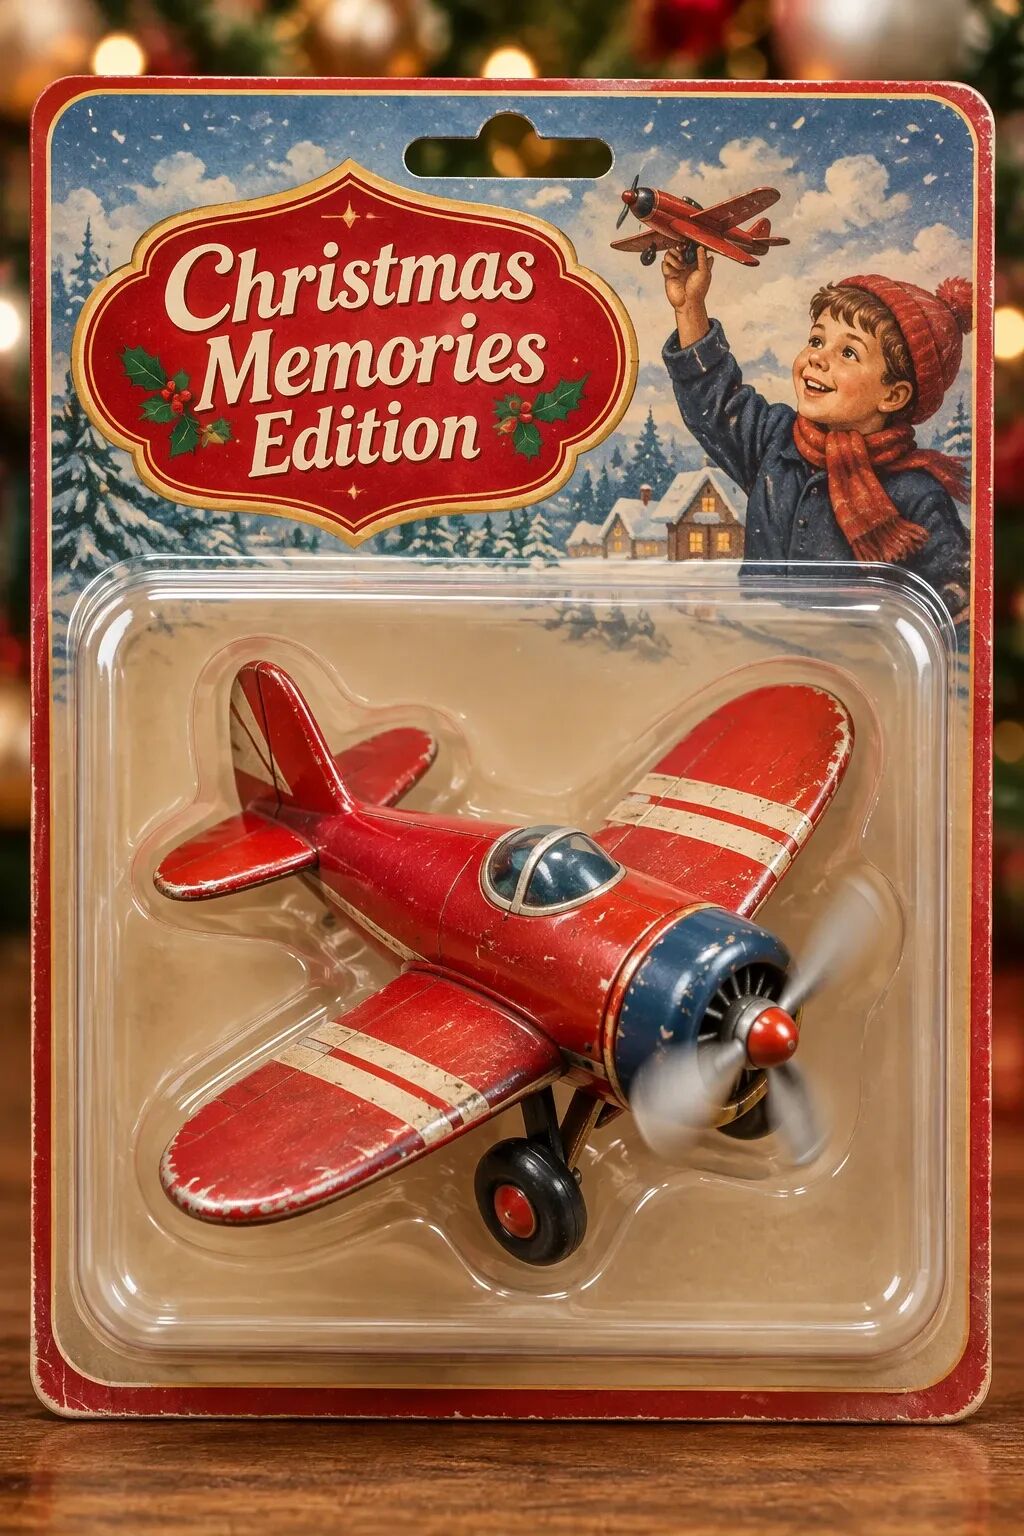
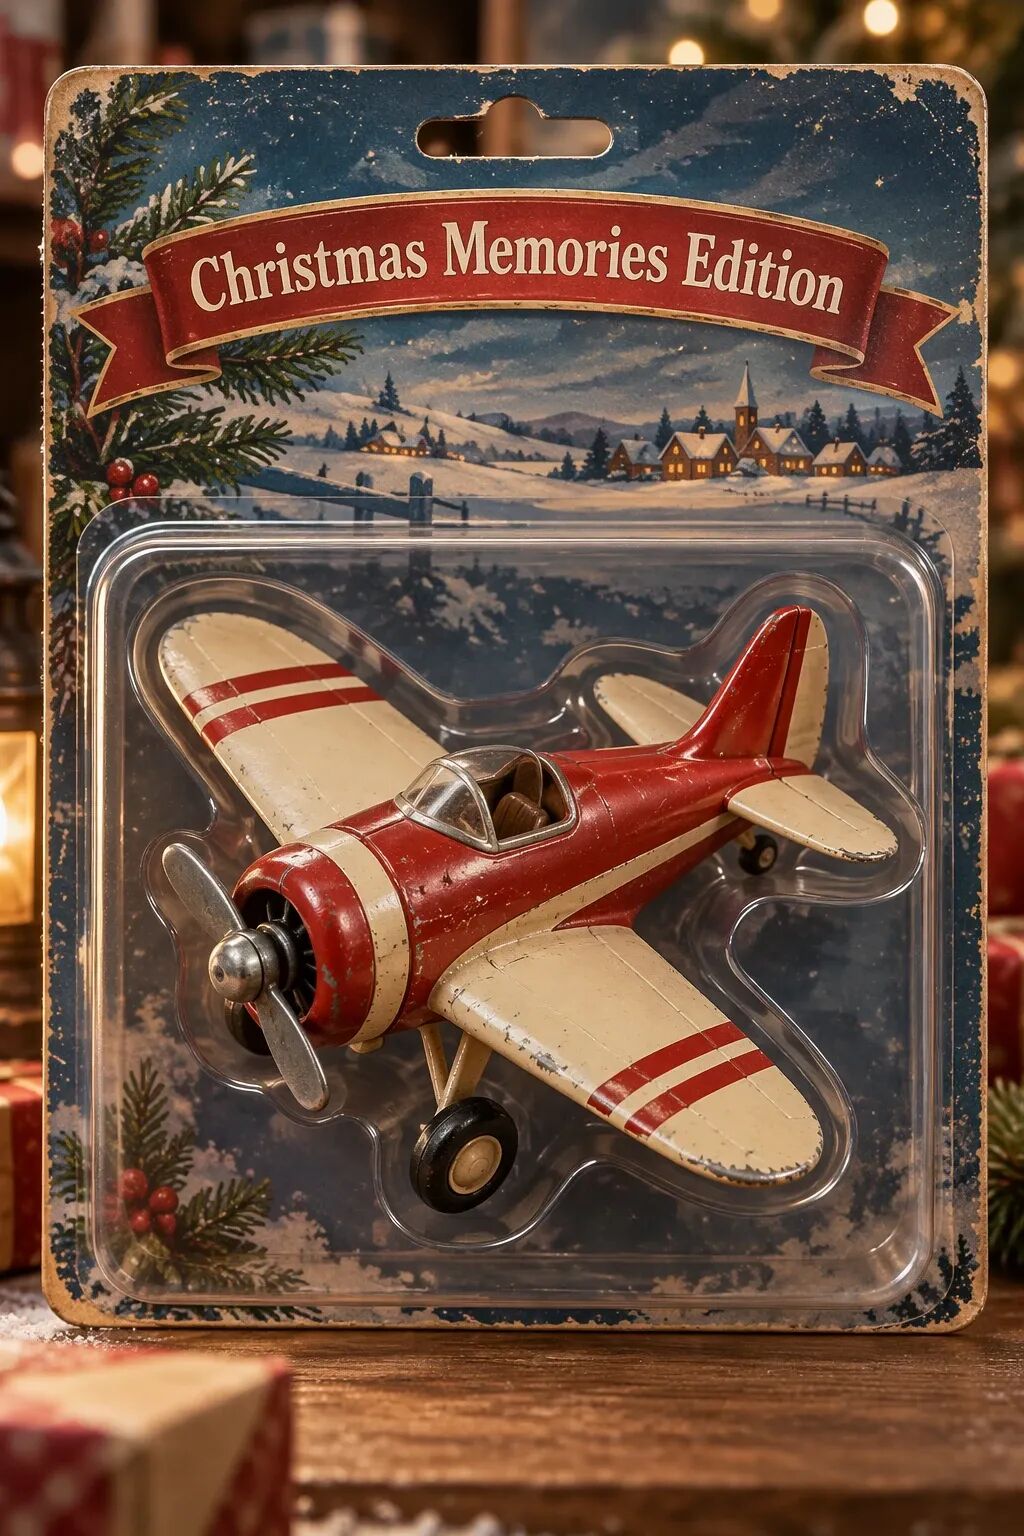
提示词 · 24
制作一款可收藏的复古玩具螺旋桨飞机模型:圆润的机翼、前置旋转螺旋桨、边缘略有磨损的漆面,以及经典的童年玩具比例。将其设计为怀旧节日收藏品,采用吸塑包装。
概念:
一款怀旧的节日收藏品,灵感来自孩子们过去在冬季假期里玩的简易玩具飞机。
唤起温暖、想象力和童年的惊奇感。
风格:
高品质玩具摄影,真实的塑料和喷漆金属纹理,棚拍光线,浅景深,清晰的标签印刷,以及高端零售陈列效果。
约束:
• 仅使用原创设计。
• 不要商标。
• 不要水印。
• 不要标志。
仅包含以下包装文字,逐字呈现:
“Christmas Memories Edition”
文案译意:“Christmas Memories Edition”:圣诞回忆版。
输出示例 · 左右滑动查看
GPT Image 2.5 Flare
GPT Image 2.5 Sunburst
运行完整示例
这段可运行的示例仍固定使用 gpt-image-2。将它作为基准,再选择可用模型及其支持的请求设置进行评估。
下面的示例会生成四个标志变体,并将产品提取到透明背景上。Python 使用 pip install openai,Ruby 使用 gem install openai 安装 OpenAI SDK。设置 OPENAI_API_KEY,并将产品照片保存为 input_images/shampoo.webp。实际发出请求会产生 API 使用费用。
查看完整示例
生成和编辑透明素材 · Python
import base64
from pathlib import Path
from openai import OpenAI
client = OpenAI()
prompt = """
为一家名为 Field & Flour 的本地烘焙店创作原创、不侵权的标志。
标志应给人温暖、简洁、经久耐看的感觉。使用干净的类矢量形状、鲜明的轮廓,以及均衡的负空间。
优先保持简洁,减少细节,使其在小尺寸和大尺寸下都清晰可辨。采用扁平化设计,尽量减少线条;除非必要,否则不使用渐变。
背景完全透明。交付一个居中的标志,四周留白充足,Alpha 边缘干净,不要纯色底、场景、棋盘格或水印。
"""
result = client.images.generate(
model="gpt-image-2",
prompt=prompt,
size="1024x1536",
quality="medium",
background="transparent",
output_format="png",
n=4, # 生成 4 个标志版本
)
# 保留返回的 PNG 字节,包括 Alpha 通道。
for index, item in enumerate(result.data, start=1):
Path(f"logo-generation-{index}-gpt-image-2.png").write_bytes(
base64.b64decode(item.b64_json)
)
# 从参考图中提取产品。
prompt = """
从输入图像中提取产品,将其单独置于完全透明的背景上。
输出要求:产品居中,轮廓清晰,没有光晕或杂边。
准确保留产品的几何形状和标签的可读性。
只做轻微润饰。不要添加纯色底、棋盘格、场景或阴影。
不要重新设计产品风格;移除背景,并保留干净的 Alpha 透明度。
"""
result = client.images.edit(
model="gpt-image-2",
image=[
Path("input_images/shampoo.webp"),
],
prompt=prompt,
size="1024x1536",
quality="medium",
background="transparent",
output_format="png",
)
Path("extract-product-gpt-image-2.png").write_bytes(
base64.b64decode(result.data[0].b64_json)
)
生成和编辑透明素材 · Ruby
require "base64"
require "openai"
require "pathname"
client = OpenAI::Client.new
result = client.images.generate(
model: "gpt-image-2",
prompt: "为本地烘焙店 Field & Flour 创建原创标志。在完全透明的背景上使用温暖、简洁的形状,Alpha 边缘干净,不要阴影或棋盘格。",
size: "1024x1536", quality: :medium, background: :transparent, output_format: :png, n: 4
)
Array(result.data).each_with_index do |item, index|
File.binwrite("logo-generation-#{index + 1}-gpt-image-2.png", Base64.strict_decode64(item.b64_json || raise("未返回 PNG")))
end
result = client.images.edit(
model: "gpt-image-2", image: OpenAI::FilePart.new(Pathname("input_images/shampoo.webp"), content_type: "image/webp"),
prompt: "将产品提取到完全透明的背景上。保留其几何形状和标签,边缘干净,不要阴影,也不要重新设计风格。",
size: "1024x1536", quality: :medium, background: :transparent, output_format: :png
)
File.binwrite("extract-product-gpt-image-2.png", Base64.strict_decode64(Array(result.data).fetch(0).b64_json || raise(
"未返回 PNG")))
更多提示词和完整工作流程,参见原始 Notebook。
检查结果
使用图像之前,对照要求检查输出:
- • 指定文字是否准确、易读?示意图的标签和关系是否正确?
- • 人物身份、产品形状、标签和参考图细节是否完整保留?
- • 如果要求透明背景,文件是否包含 Alpha 通道?需要确认背景具备实际透明度。
更改提示词或模型时,使用具有代表性的输入比较质量、延迟和成本。当前费用见图像生成价格。
GPT Image 2 参考
现有 GPT Image 2 工作流程的概览和请求设置。
概览
GPT Image 2 支持图像生成和编辑,包括文字渲染、基于参考图的编辑,以及灵活的输出尺寸。可使用本参考维护现有集成。提示词指南涵盖构图、文字、参考图,以及编辑过程中保留细节的通用技巧。其中的图文示例使用 GPT Image 2.5 Flare 和 GPT Image 2.5 Sunburst;不同模型的输出可能不同。迁移时,使用指南中的模型选择和评估流程。
模型参数
使用 client.images.generate 生成图像,使用 client.images.edit 编辑图像。API 设置和请求示例见图像生成指南。
| |
|---|
model | gpt-image-2 |
quality | low |
size | auto |
input_fidelity | |
output_format | png |
background | 透明输出需明确设置为 transparent,并使用 PNG 或 WebP。 |
output_compression | 仅用于 JPEG 或 WebP 输出,PNG 不使用此参数。 |
gpt-image-2 的透明背景功能目前以预览形式提供。
原始提示词、输入和可运行的工作流程,参见固定版本的 GPT Image 2 Notebook。
GPT Image 1.5 参考
现有 GPT Image 1.5 工作流程的概览和请求设置。
概览
已弃用的模型。gpt-image-1.5 计划于 2026 年 12 月 1 日停用。参见弃用通知,并在迁移前使用 gpt-image-2 验证现有工作流程。
GPT Image 1.5 支持图像生成和编辑,包括文字渲染、照片级写实图像,以及基于参考图的编辑。可使用本参考维护现有集成。提示词指南涵盖构图、文字、参考图,以及编辑过程中保留细节的通用技巧。使用你自己的模型和输入测试这些技巧;不同模型的输出可能不同。
模型参数
使用 client.images.generate 生成图像,使用 client.images.edit 编辑图像。API 设置和请求示例见图像生成指南。
| |
|---|
model | gpt-image-1.5 |
quality | low |
size | 1024x1024、1024x1536、
1536x1024 或 auto |
output_format | png |
output_compression | 0 至 100,仅用于 JPEG 或 WebP 输出。 |
background | 透明输出需明确设置为 transparent;使用 PNG 或 WebP。 |
input_fidelity | low 或 high;high 用于保留输入细节,quality 控制输出生成。迁移到 GPT Image 2 时省略此参数,该模型始终使用高输入保真度。 |
GPT Image 1 参考
现有 GPT Image 1 工作流程的概览和请求设置。
概览
已弃用的模型。gpt-image-1 计划于 2026 年 10 月 23 日停用。参见弃用通知,并在迁移前使用 gpt-image-2 验证现有工作流程。
GPT Image 1 支持使用参考图和蒙版进行图像生成与编辑。可使用本参考维护现有集成。描述场景、保留细节和细化编辑等通用技巧,参见提示词指南。
模型参数
使用 client.images.generate 生成图像,使用 client.images.edit 编辑图像。API 设置和请求示例见图像生成指南。
| |
|---|
model | gpt-image-1 |
quality | low |
size | 1024x1024、1024x1536、1536x1024 或 auto |
output_format | png |
output_compression | 0 至 100,仅用于 JPEG 或 WebP 输出。 |
background | 透明输出需明确设置为 transparent;使用 PNG 或 WebP。 |
input_fidelity | low 或 high;high 用于保留输入细节,quality 控制输出生成。高输入保真度会使用更多图像输入 Token。迁移到 GPT Image 2 时省略此参数,该模型始终使用高输入保真度。 |






