写 Python notebook 久了,有一种混乱几乎所有人都遇到过:
代码明明没改,重新跑一遍,结果却不一样了。
原因往往不在代码本身,而在于——你已经记不清这些单元格到底按什么顺序跑过。
第三个单元格先跑了,再回头补第一个;删掉一个定义变量的单元格,变量却还活在 kernel 里;页面上看着从上到下整整齐齐,背后的运行状态却可能早就乱了。
等 notebook 再往工程里走,问题更多。
.ipynb 提交到 Git,diff 经常变成一大段 JSON;想交给同事继续维护,要先解释“你最好从头重新跑一遍”;探索完成准备改成正式脚本,最后又免不了复制、粘贴、重新整理代码。
这些问题存在太久了,以至于大家慢慢接受了一件事:
notebook 大概天生就是这样的。
marimo 偏偏不这么想。
它没有继续在传统 notebook 上补功能,而是直接动了更底层的执行模型:单元格不再依赖“你刚才点了谁”,而是根据变量之间的依赖关系自动连接;文件也不再是一份特殊的 .ipynb JSON,而是普通的 Python 文件。
这意味着,同一份代码可以先拿来交互探索,之后继续当脚本运行,甚至直接变成应用,而不用在 notebook 和正常 Python 工程之间反复搬家。
所以我觉得 marimo 真正值得聊的,并不是界面又做得多漂亮,而是它重新回答了两个 notebook 一直没解决好的问题:
谁来决定下一步该运行什么?
以及,探索阶段写下来的代码,怎么自然地继续进入正常的 Python 工程?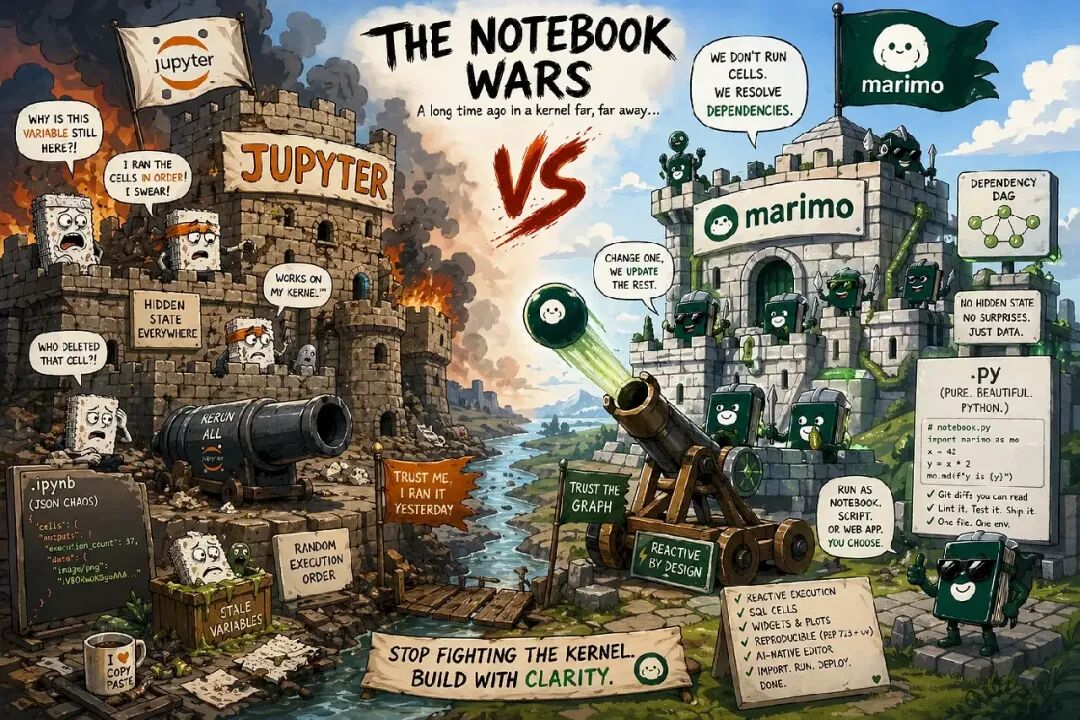 marimo notebook 示例
01先看懂 marimo 的执行模型
Jupyter 的执行方式很好理解:每个单元格都在往一个长期运行的 Python 进程里塞代码。你执行过一次,状态就留在 kernel 里;下一次跑什么、跑几遍、按什么顺序,主要靠人自己记。
marimo 把“靠人记顺序”换成了依赖图。
一个单元格定义 x,另一个单元格读取 x,marimo 就知道后者依赖前者。当上游值变化时,受影响的下游单元格会重新计算。你不需要先判断“我是不是从头运行过”,也不需要手动点一遍所有单元格。
最小例子可以这样看。先创建一个 notebook 文件:
pip install marimo
marimo edit hello.py
在编辑器里放入几个单元格:
x = 10
y = x * 2
print(y)
z = x + y
print(z)
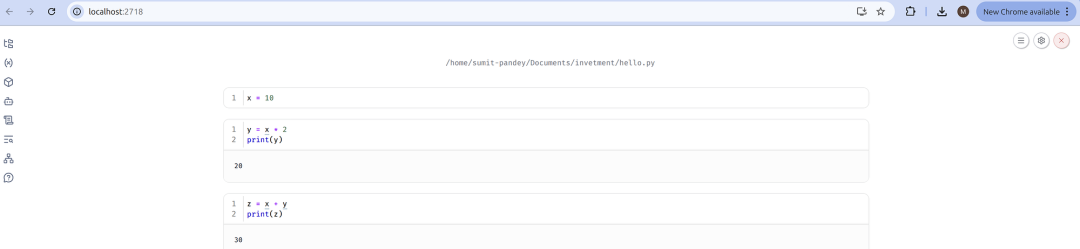
此时输出分别是 20 和 30。把第一个单元格的 x = 10 改成 x = 50,引用 x 的下游单元格会跟着更新。
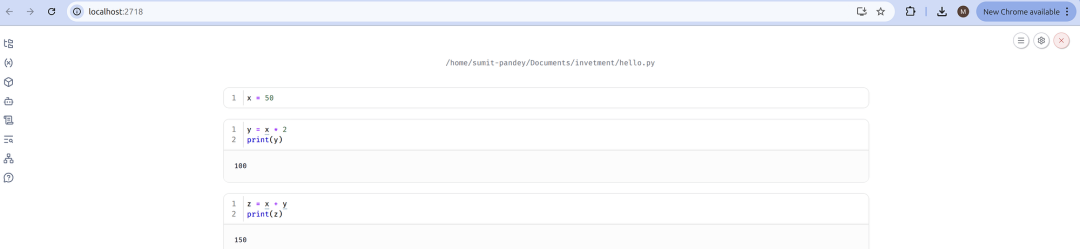
这个例子很小,但差别已经出来了:marimo 不只是“能在浏览器里写 Python”,而是真的把依赖关系接进了执行过程。
marimo 还会把几个容易制造隐式状态的动作变成约束。
- 一个变量只能在一个单元格里定义,不能在多个单元格里反复覆盖。
- 删除定义变量的单元格时,对应的变量不会继续作为隐藏状态留在 notebook 里。
刚上手时,这几条规则可能会让人觉得不够自由。但它们做的其实是一件很具体的事:把“这段 notebook 到底依赖什么”从人的记忆里拿出来,变成系统能检查的结构。
当然,它没有消灭 Python 里所有状态问题。可至少 notebook 里最常见的那类“幽灵变量”和执行顺序问题,先被挡住了一大截。
02.py 文件怎样接进工程
如果说依赖图解决的是“怎么运行”,那 .py 文件解决的就是“怎么进入工程”。
marimo 不再把 notebook 主要保存成 .ipynb JSON,而是普通的 .py 文件。这个变化看起来没那么炫,但对日常开发反而很实在。
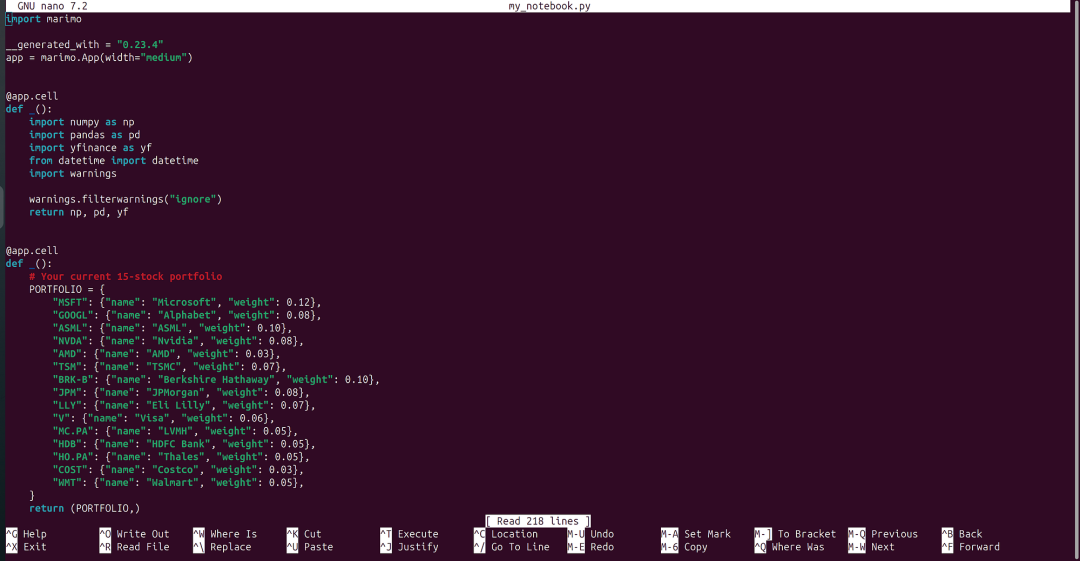
你可以直接 git diff 看代码改了什么,可以让 Ruff 或其他 Python 工具检查它,也可以用 pytest 测试其中的函数。需要脚本化运行时,文件仍然是 Python;需要复用其中的逻辑时,也不必先把 notebook 手工拆成另一个 .py 文件。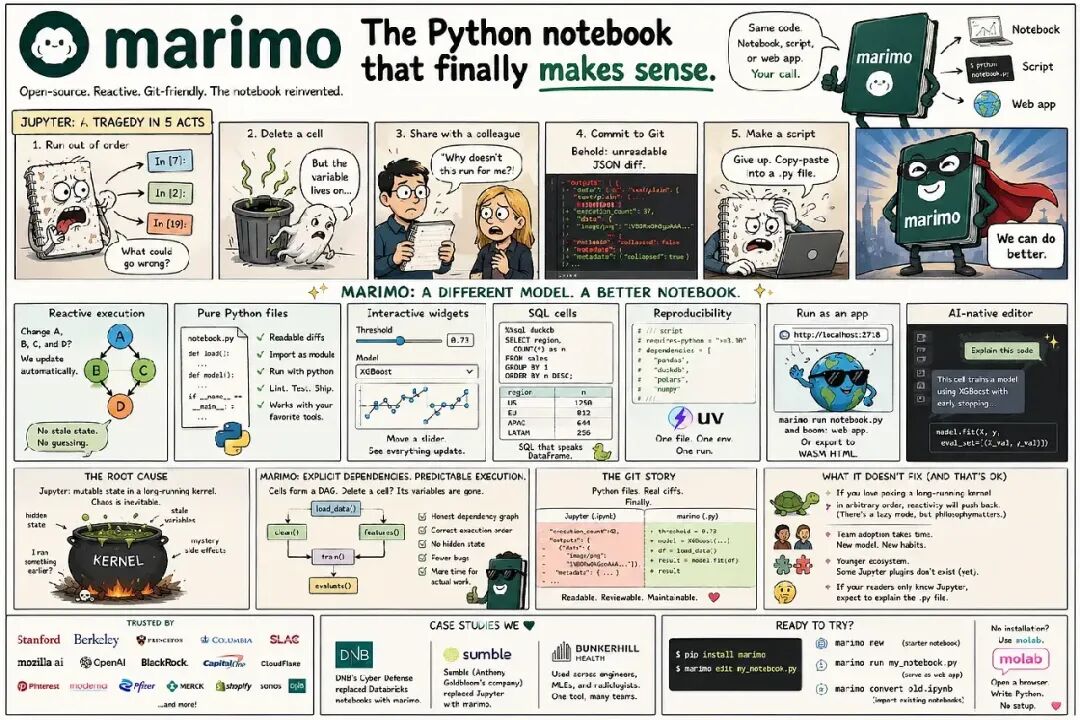
marimo Python 文件与编辑器示例
当然,换成 .py 不会自动把一份乱糟糟的 notebook 变成好工程。函数边界、依赖组织、测试覆盖、数据路径,这些还是要自己处理。
但至少代码交付这一步正常了:审阅者看到的是 Python 变更,而不是输出、元数据和执行结果混在一起的序列化文档。
如果 notebook 只用一次,这个变化未必有多大价值;可一旦它要复用、审阅、定期重跑,或者交给别人接手,差别就会很明显。
03交互控件和 SQL,不必另起一个应用
marimo 的反应式模型也延伸到交互控件。控件的值可以成为 Python 变量,下游单元格读取这个变量,控件变化后下游逻辑就会重新计算。
例如,一个样本量滑块可以这样写:
import marimo as mo
slider = mo.ui.slider(start=1, stop=100, value=10, label="Sample size")
slider
df.sample(slider.value)
这里真正有意思的不是“多了一个滑块”,而是它没有跳出前面的执行模型。用户操作产生一个值,这个值还是 Python 变量,下游单元格继续沿着依赖图更新,不需要再单独补一层 callback。
SQL 也是类似的思路。对聚合、分组和联表来说,SQL 有时比一长串 DataFrame 方法更直接。marimo 支持在 notebook 中写 SQL 单元格:
SELECT region, SUM(revenue) as total
FROM df
GROUP BY region
ORDER BY total DESC
这里的 df 就是 notebook 里已经存在的数据表,SQL 的结果还能继续回到后续 Python 流程里。
当然,“支持 SQL”不等于什么数据库都能零配置接入。实际使用时,marimo 版本、数据类型、连接方式,以及外部数据库配置还是要按环境确认。
04从探索到可交付:依赖、应用和导出
把 notebook 交给别人时,还有一个经典问题:这玩意当时到底跑在哪个环境里?
marimo 支持在文件里声明依赖,并配合 uv 创建隔离环境。下面采用 PEP 723 inline metadata 形式:
# /// script
# requires-python = ">=3.11"
# dependencies = [
#     "pandas==2.2.0",
#     "scikit-learn==1.4.0",
#     "marimo",
# ]
# ///
随后可以让 uv 读取这段声明并启动 notebook:
uv run marimo edit notebook.py
这样一来,“这个 notebook 需要什么依赖”就不用再从聊天记录、环境截图或者个人记忆里猜,直接跟着文件走。
但这也不是跨平台魔法。Python 版本、操作系统、二进制依赖、数据文件路径这些问题依然存在,还是要按项目验证。
同一份源文件也可以作为应用运行:
marimo run notebook.py
到了应用模式,用户看到的是控件和输出,而不是 notebook 编辑界面。对于已经用控件把探索流程组织好的 notebook,这意味着不必为了“给别人用”再单独搬一次到 Streamlit。
另一条路径是 WebAssembly 静态导出:
marimo export
html-wasm notebook.py -o dist
静态导出很适合把交互结果放到 GitHub Pages 这类托管环境里,不过这里也要稍微克制一点:不是所有 Python 依赖都能无条件塞进浏览器。运行时、包体、可用依赖和数据访问方式,都会决定最终能不能跑。
真到部署阶段,app、静态导出和正式服务还是应该分开看。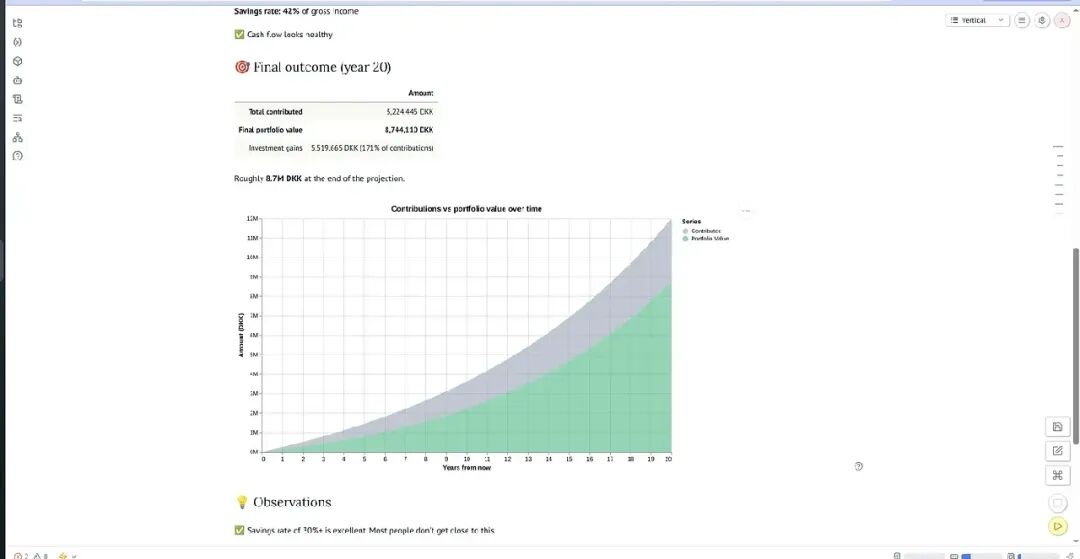
marimo 应用模式示例
05从 Jupyter 迁移,真正要改的是结构
marimo 提供了转换 Jupyter notebook 的路径:
marimo convert old_notebook.ipynb > new_notebook.py
转换命令能把文件搬过来,但不会顺便把旧 notebook 的结构问题一起治好。
如果原文件里多个单元格反复定义同一个变量、存在循环引用,或者高度依赖共享 kernel 的执行顺序,转换以后还是得逐个处理。
反过来看,这其实也是迁移最有价值的一步:以前藏在执行顺序里的依赖,终于被迫暴露出来了。
当然,这套模型也有代价。
长时间运行的单元格不适合每次上游一变化就自动重跑,可以切到 lazy mode,让单元格先标记为过期,等确认以后再执行。
另一个更容易踩坑的是共享对象的原地修改:
df["new_col"] = transform(df)
如果后面的单元格继续读取同一个 df,代码表面上只有一个变量名,但真正的变化发生在对象内部。依赖图能看到变量之间的引用关系,却不等于能完整理解所有可变对象的副作用。更稳妥的写法通常是返回一个新的 DataFrame,让数据流显式一点。
所以,marimo 并不是把 .ipynb 换成 .py 就完事了。它真正要求你接受的是:notebook 也应该更像一段有明确依赖关系的 Python 程序。
06写在最后
看到这里,其实不必急着讨论“要不要替代 Jupyter”。
先看你的工作流是不是刚好卡在下面这些地方:
- notebook 需要被别人接手,而不是只在自己的 kernel 里使用;
- 你在意 Git diff、代码检查、测试和脚本运行;
反过来,如果你的工作流就是强依赖一个跑几小时的共享 kernel,经常任意顺序试变量,或者团队已经围绕 Jupyter 搭好了一整套基础设施,那直接迁移未必划算。
这种情况下,最合适的做法反而不是“换掉 Jupyter”,而是先拿一个新项目、一条独立分析流程试试 marimo,看它的规则到底适不适合团队。
marimo 真正让我觉得有意思的地方,不是界面更现代,也不是多了几个交互控件。
它把 notebook 里最容易被忽略的几件事重新排了一遍:执行依赖更明确,文件重新回到普通 Python,探索结果也更容易继续走向脚本、测试和应用。
所以它最适合的,并不是所有正在用 Jupyter 的人,而是那些已经开始要求 notebook 可复现、可审阅、可交付 的工作流。
如果你刚好已经被 stale state、Git diff、环境复现或者“notebook 怎么交给别人”折腾过,marimo 很值得拿一个真实项目试一次。



