先说明,涨点不存在万能方案,不过按下面这套流程系统实验,一般都能再往上冲几个点。
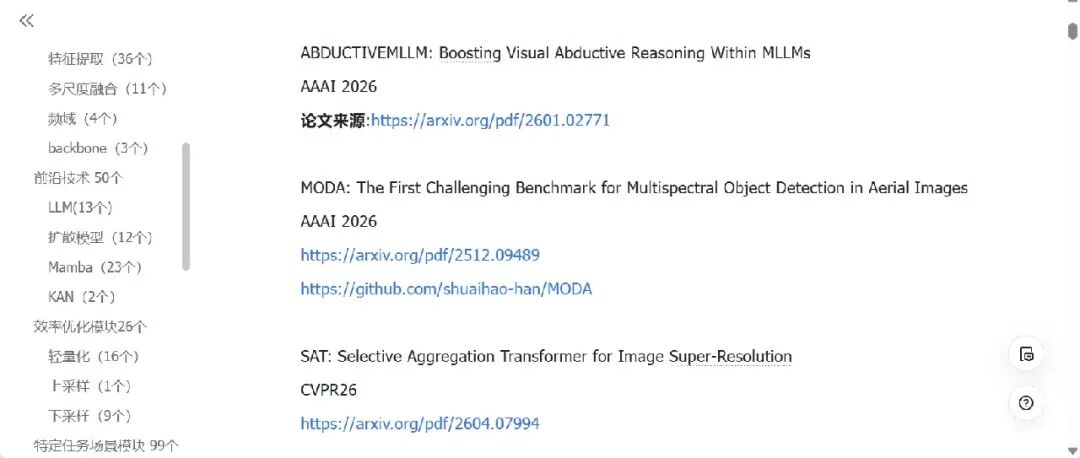
另外我在整理这套涨点方法时,发现最麻烦的还是不知道具体有哪些东西能改、应该往哪里改。所以顺手也整理了一份深度学习即插即用模块(366个),按模型增强、结构创新、效率优化、前沿技术、特定任务等分了类,今天也一并分享给大家,这样搭配着用,遇到Baseline不知道往哪改的时候,可以直接按类别去找思路。
1. 先从数据入手,容易白捡分数
数据是性价比很高的优化方向。优先尝试RandAugment、AutoAugment这类增强策略,也可以用mixup、cutmix 混合增强,常常能直接捞1‑2个点。
另外不要忽略归一化的统计参数;遇到类别不均衡,做少数类过采样或者样本重加权,有条件还可以尝试伪标签半监督利用无标签数据。
2. 调损失函数,少量代码就有提升
换合适的loss成本很低。分类不平衡试试Focal Loss;回归任务优先SmoothL1/Huber,比MSE训练更稳定。加上Label Smoothing,系数大概0.1,提升模型泛化能力,部分场景改动几行代码就能涨2‑3个点。
3. 精细打磨超参与学习策略
不要靠手搓调参,用optuna、wandb做扫描,重点看学习率、batch size、权重衰减。放弃固定学习率,使用warmup预热+cosine退火。迁移学习推荐分层学习率:预训练主干用小学习率,头部分类器用更大的学习率。
另外EMA指数滑动平均建议直接标配,一般稳定涨0.5‑1 个点,训练曲线也更平滑。显存不足可以用梯度累积模拟大batch。
4. 网络小改动,不做大改
不建议直接全盘换架构,可以做局部微调:ReLU 替换成 GELU/Swish;残差分支增加dropout缓解过拟合;在合适位置插入SE、CBAM注意力模块。
如果想要更大提升,再考虑更换更强主干网络,或者使用更高质量的预训练权重。也可以增加深度监督辅助损失,帮助浅层网络更好学习。
当然,如果你的目的不只是涨几个点,而是想把这些改动进一步做成论文,我更建议去看一些涨点型论文。我自己也整理了一批这类涨点论文,专门看作者是从数据、Loss、网络结构、训练策略里的哪个位置动手,以及一个很小的改动是怎么包装成完整创新点的,也分享给你。
很多时候不是没有创新点,而是不知道别人是怎么把“小改动”做成论文的。
5. 推理侧技巧,不改动训练过程
- TTA 测试时增强:推理阶段做翻转、缩放、多尺度输入,对结果取平均,不训模型,代价是推理速度变慢,通常涨0.5‑1个点。
- 模型集成:多组不同初始化/不同子集训练的模型预测结果取平均。资源有限就保存训练中多个最优checkpoint做快照集成。
- 后处理:分类调动态阈值;检测调整NMS‑IoU;分割做平滑处理,经常会带来小幅增益。
最后给点小提醒
每一轮改动做好记录,不要一次性改一堆东西,分不清到底哪个生效。很多trick单次提升可能只有0.1‑0.3点,但叠加在一起收益可观。



