读顶刊时,很多人喜欢记下那些”写的很棒“的段落,以期未来代入到自己的论文去。
但是轮到自己写的时候,才发现问题、证据和结论统统接不上。
顶刊值得学的是组织问题、证据和结论的方式。
只看句子,换个题目就失效;看清结构,才能迁移到自己的论文。
下面用一篇《管理世界》论文做样例,分析分析它”好“在哪里?又有哪些是我们可以通过AI形成通用模板并借鉴的。
| 先定尺子
开始写作前,我们需要先固定三份输入:目标期刊的官方投稿与格式要求、一篇结构完整的样本论文、自己的研究材料。所有后续步骤都从同一目录读取,换期刊时只替换规则文件和样本论文。
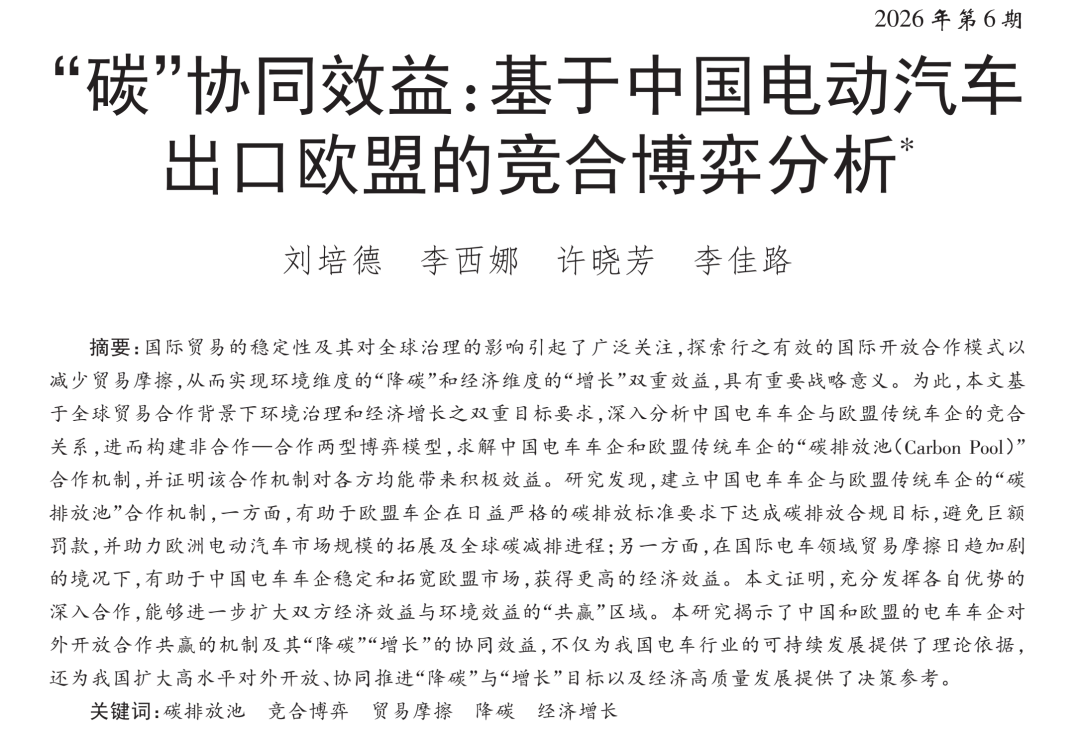
接下来,我们将以《管理世界》2026年第6期的论文《“碳”协同效益:基于中国电动汽车出口欧盟的竞合博弈分析》做样例。
虽然我们只想模仿的话,完全可以只依赖论文本身,但保险起见,我们还是应当尽量去官网了解一下详细的投刊规则。例如我们选择的这篇论文,它的投稿规则如下:
https://glsj.cbpt.cnki.net/WKB2/WebPublication/wkTextContent.aspx?navigationContentID=0a96be87-490b-49ff-90aa-bee7b5d1b2cc&mid=glsj
明晰了规则以后,我们就可以为它搭建一个仓库了,换期刊时,仓库结构保持不变,替换规则文件和样本即可。
top-journal-writing-manager-world/├─ README.md├─ 00-journal-rules.md├─ 01-title.md├─ 02-abstract.md├─ 03-problem-chain.md├─ 04-method-check.md├─ 05-evidence-map.md├─ 06-discussion.md├─ 07-review.md├─ source/│ ├─ journal-requirements.md│ ├─ sample-paper.pdf│ └─ sample-paper.md└─ my-paper/ ├─ draft.md
├─ materials.md └─ results.md
其中,source/ 保存原始依据,00-journal-rules.md 保存提炼后的规则,my-paper/ 存放作者(即我们当前的)材料和结果。README 只负责说明文件顺序和交接关系。
提示词
1 创建 top-journal-writing-manager-world/ 目录;2 建立 README.md、00-journal-rules.md 至 07-review.md,以及 source/、my-paper/ 两个子目录。3 读取目标期刊的官方投稿与格式要求,将来源索引保存为 source/journal-requirements.md;4 将样本论文保存为 source/sample-paper.pdf;结构笔记保存为 source/sample-paper.md;5 将作者现有材料分别整理到 my-paper/draft.md、my-paper/materials.md 和 my-paper/results.md。6 生成 00-journal-rules.md;字段包括期刊定位、标题要求、摘要结构、方法与数据规范、格式要求、审稿关注点和未确认项。7 README 写清 00 → 01 → 02 → 03 → 04 → 05 → 06 → 07 的读取顺序。8 下一步读取 00-journal-rules.md 和 source/sample-paper.md,进入 01-title.md。
| 01 标题
标题要回答三个问题:研究对象是什么,核心发现是什么,方法或范围为何值得保留。只写“基于某方法研究某问题”,读者拿不到结论。
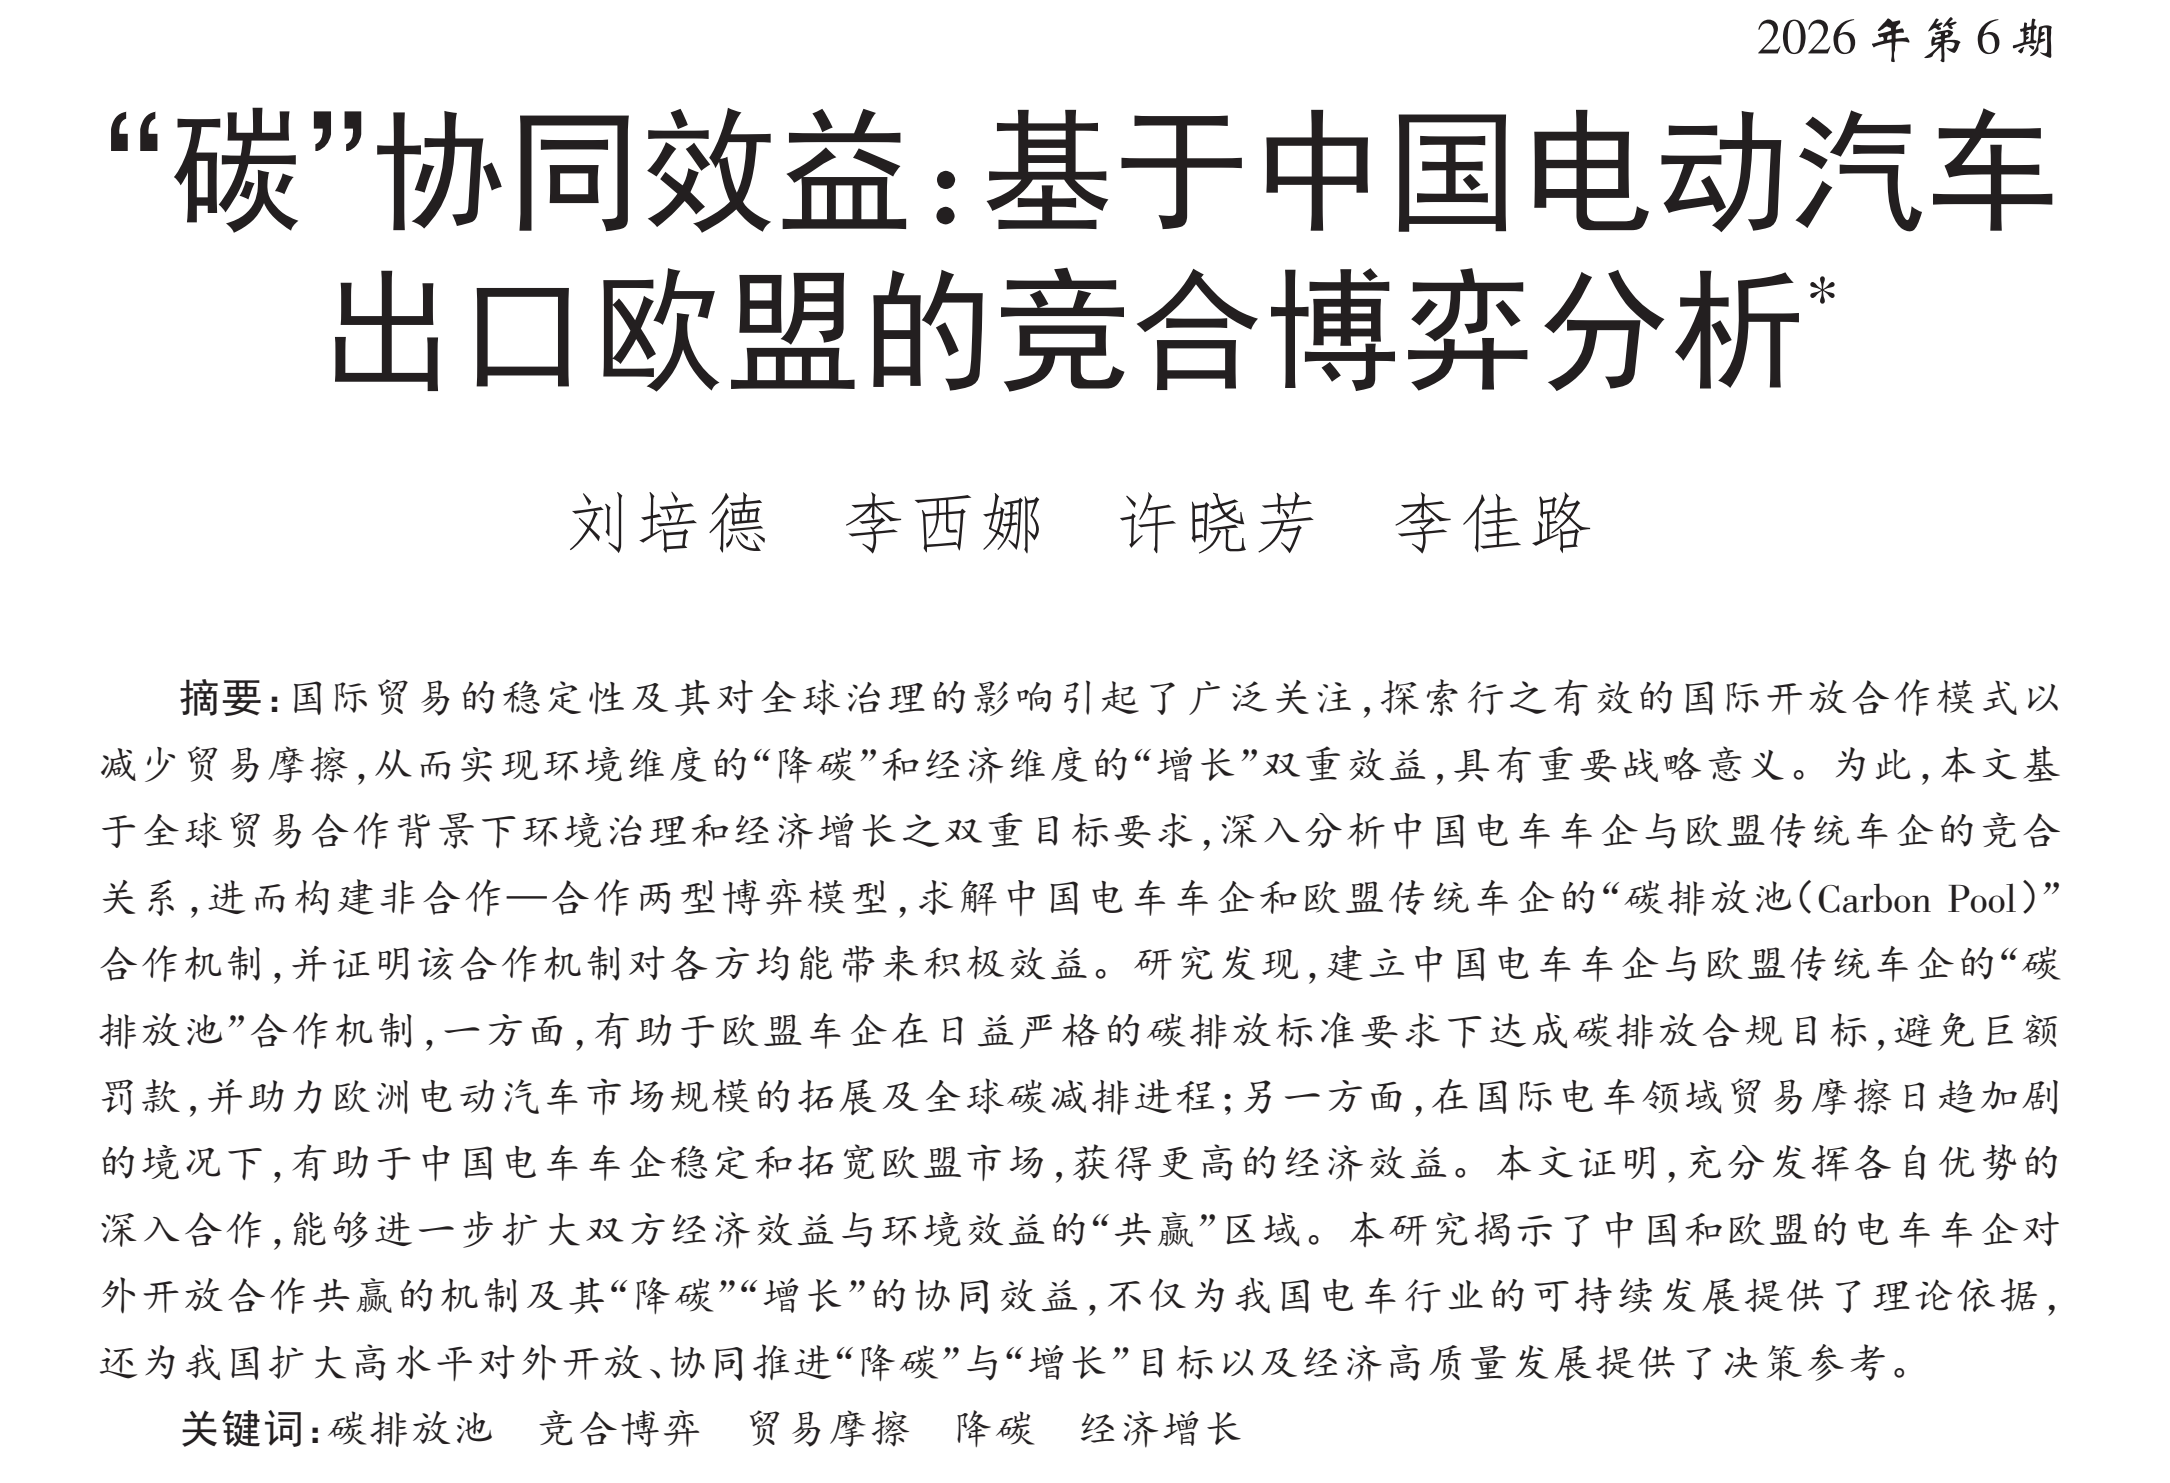
样例标题交代了“中国电动汽车出口欧盟”和“竞合博弈”,对象、关系和方法都清楚。“协同效益”给出方向,具体收益仍要靠摘要补充。
接下来我们可以让AI来对我们进行标题自检:对象、核心发现、方法、范围、证据强度。缺一项就退回。
提示词
读取`00-journal-rules.md`、`source/sample-paper.md`和`my-paper/draft.md`,逐项检查研究对象、核心发现、方法、范围与证据强度。
生成`01-title.md`,列出8个候选标题,标注每个标题包含与缺失的信息,指出超出证据的表述。
下一步交给`02-abstract.md`。
| 02 摘要
摘要要回答研究什么问题、怎么研究、发现了什么、改变了什么认识。
四类信息必须存在,顺序可以随论文调整。
样例摘要把背景、两型博弈模型、碳排放池收益和政策意义串成一条线。信息密度很高,读者不看正文也能判断研究价值。
因此,我们在让AI按照顶刊标准帮我们自检摘要的时候,需要明确每句话属于问题、方法、发现、启示中的哪一类;是否存在重复;结论能否回到正文。
提示词
读取`01-title.md`、`source/sample-paper.md`和`my-paper/draft.md`,逐句标注问题、方法、发现、启示四类功能,删除重复和无法回溯的句子。
生成`02-abstract.md`,保留来源位置和缺失项。下一步交给`03-problem-chain.md`。
| 03 引言
引言要让研究问题自然出现:典型事实推动制度问题,制度问题暴露研究缺口,本文设计回应缺口,贡献句说明知识与政策价值。
样例先写中国电动汽车产业与政策背景,再切入欧盟法规2019/631和碳排放池,随后把中欧车企概括为“局部合作、整体竞争”,最后给出三项贡献。
在检查引言的时候,我们需要让AI 重点检查文章中的现实事实、制度规则、已有研究、未解决问题、本文回应、学术贡献,六段是否首尾相接。
提示词
读取`02-abstract.md`、`source/sample-paper.md`和`my-paper/materials.md`,建立六段问题链,每段附原文位置。
检查哪一段只做背景铺陈,哪一段直接推动研究问题。生成`03-problem-chain.md`。下一步交给`04-method-check.md`。
| 04 方法复现
方法要同时回答设计是否合适、过程能否复现、结果是否可信。研究对象、假设、数据、参数、基准、稳健性和限制缺一不可。
样例的两型博弈对应
“局部合作、整体竞争”:联盟分配用Shapley值,市场竞争用Cournot博弈,碳约束进入同一模型。随后用命题、数值实验和稳健性检查验证。
提示词
读取`03-problem-chain.md`、`source/sample-paper.md`和`my-paper/materials.md`,将每个假设、参数和设计动作映射到具体研究问题,检查基准、数据、复现和稳健性。
生成`04-method-check.md`,列出缺失项。下一步交给`05-evidence-map.md`。
| 05 研究结论
结果按读者理解证据的顺序排列。
原则上每个图表或命题只回答一个主问题,并写清支持什么、不能支持什么、在哪个范围成立。
样例用命题1至命题7推进。中强度减排下,欧盟传统车企的合规成本下降约2%至6%,双方整体利润提升约8%至13%。高强度减排下,合作成为主导解。
接下来,我们应当先核心发现,再机制与稳健性,最后边界。任何图表如果承担两个以上任务,都要重新拆分。
提示词
读取`04-method-check.md`、`source/sample-paper.md`和`my-paper/results.md`,建立问题、证据、结论、边界四列映射。
每个图表只保留一个主问题,标出不能支持的结论,再按核心发现、机制、稳健性和边界排序。
生成`05-evidence-map.md`。下一步交给`06-discussion.md`。
| 06 讨论部分
讨论要回答结果改变了什么认识、为什么出现、是否存在替代解释、结论在哪里成立、政策和下一步研究怎样展开。
样例解释碳排放池把合规目标从单一企业转为联盟平均,中国电车的低排放优势因此转化为出口与收益。文章同时说明双赢区依赖配额、关税和碳价格稳定,并把建议落到碳足迹互认、数据平台、海外产能和全球公共产品。
提示词
读取`05-evidence-map.md`、`source/sample-paper.md`和`my-paper/draft.md`,分别写核心发现、认识修正、机制、替代解释、成立条件、政策建议和下一步研究。
回溯结果的内容删除。
`06-discussion.md`,下一步交给`07-review.md`。
| 07 三轮结构审稿
初稿完成后固定跑三轮:问题一致性、证据对应、审稿人攻击。审稿输出按致命、重要、一般分级,每条给出位置和最小修改动作。
样例论文从2025年3月收稿,经历两轮外审,到2026年3月拟录用,耗时一年多。
即使有着AI工具的使用,想要在顶刊投刊成功,离不开反复审稿、修改、再审稿。第一轮查标题、摘要、引言、结果和结论是否回答同一问题。第二轮核对每个主张对应的图表、数据或文献。第三轮攻击问题重要性、模型设计、基准、稳健性、替代解释和结论范围。
论文不是把实验结果翻译成文字,而是在证据允许的范围内,建立一套可以被检验、被质疑、也能够被复现的论证。
完成上述1-7步后,我们就可以得到一份完整报告,下一步由作者按清单修改即可。
提示词
读取`00-journal-rules.md`至`06-discussion.md`,执行三轮检查。
每条问题包含位置、类型、影响、最小动作和优先级。
生成`07-review.md`。
换期刊时,替换”source/"和"00-journal-rules.md"即可,文件链保持不变。



