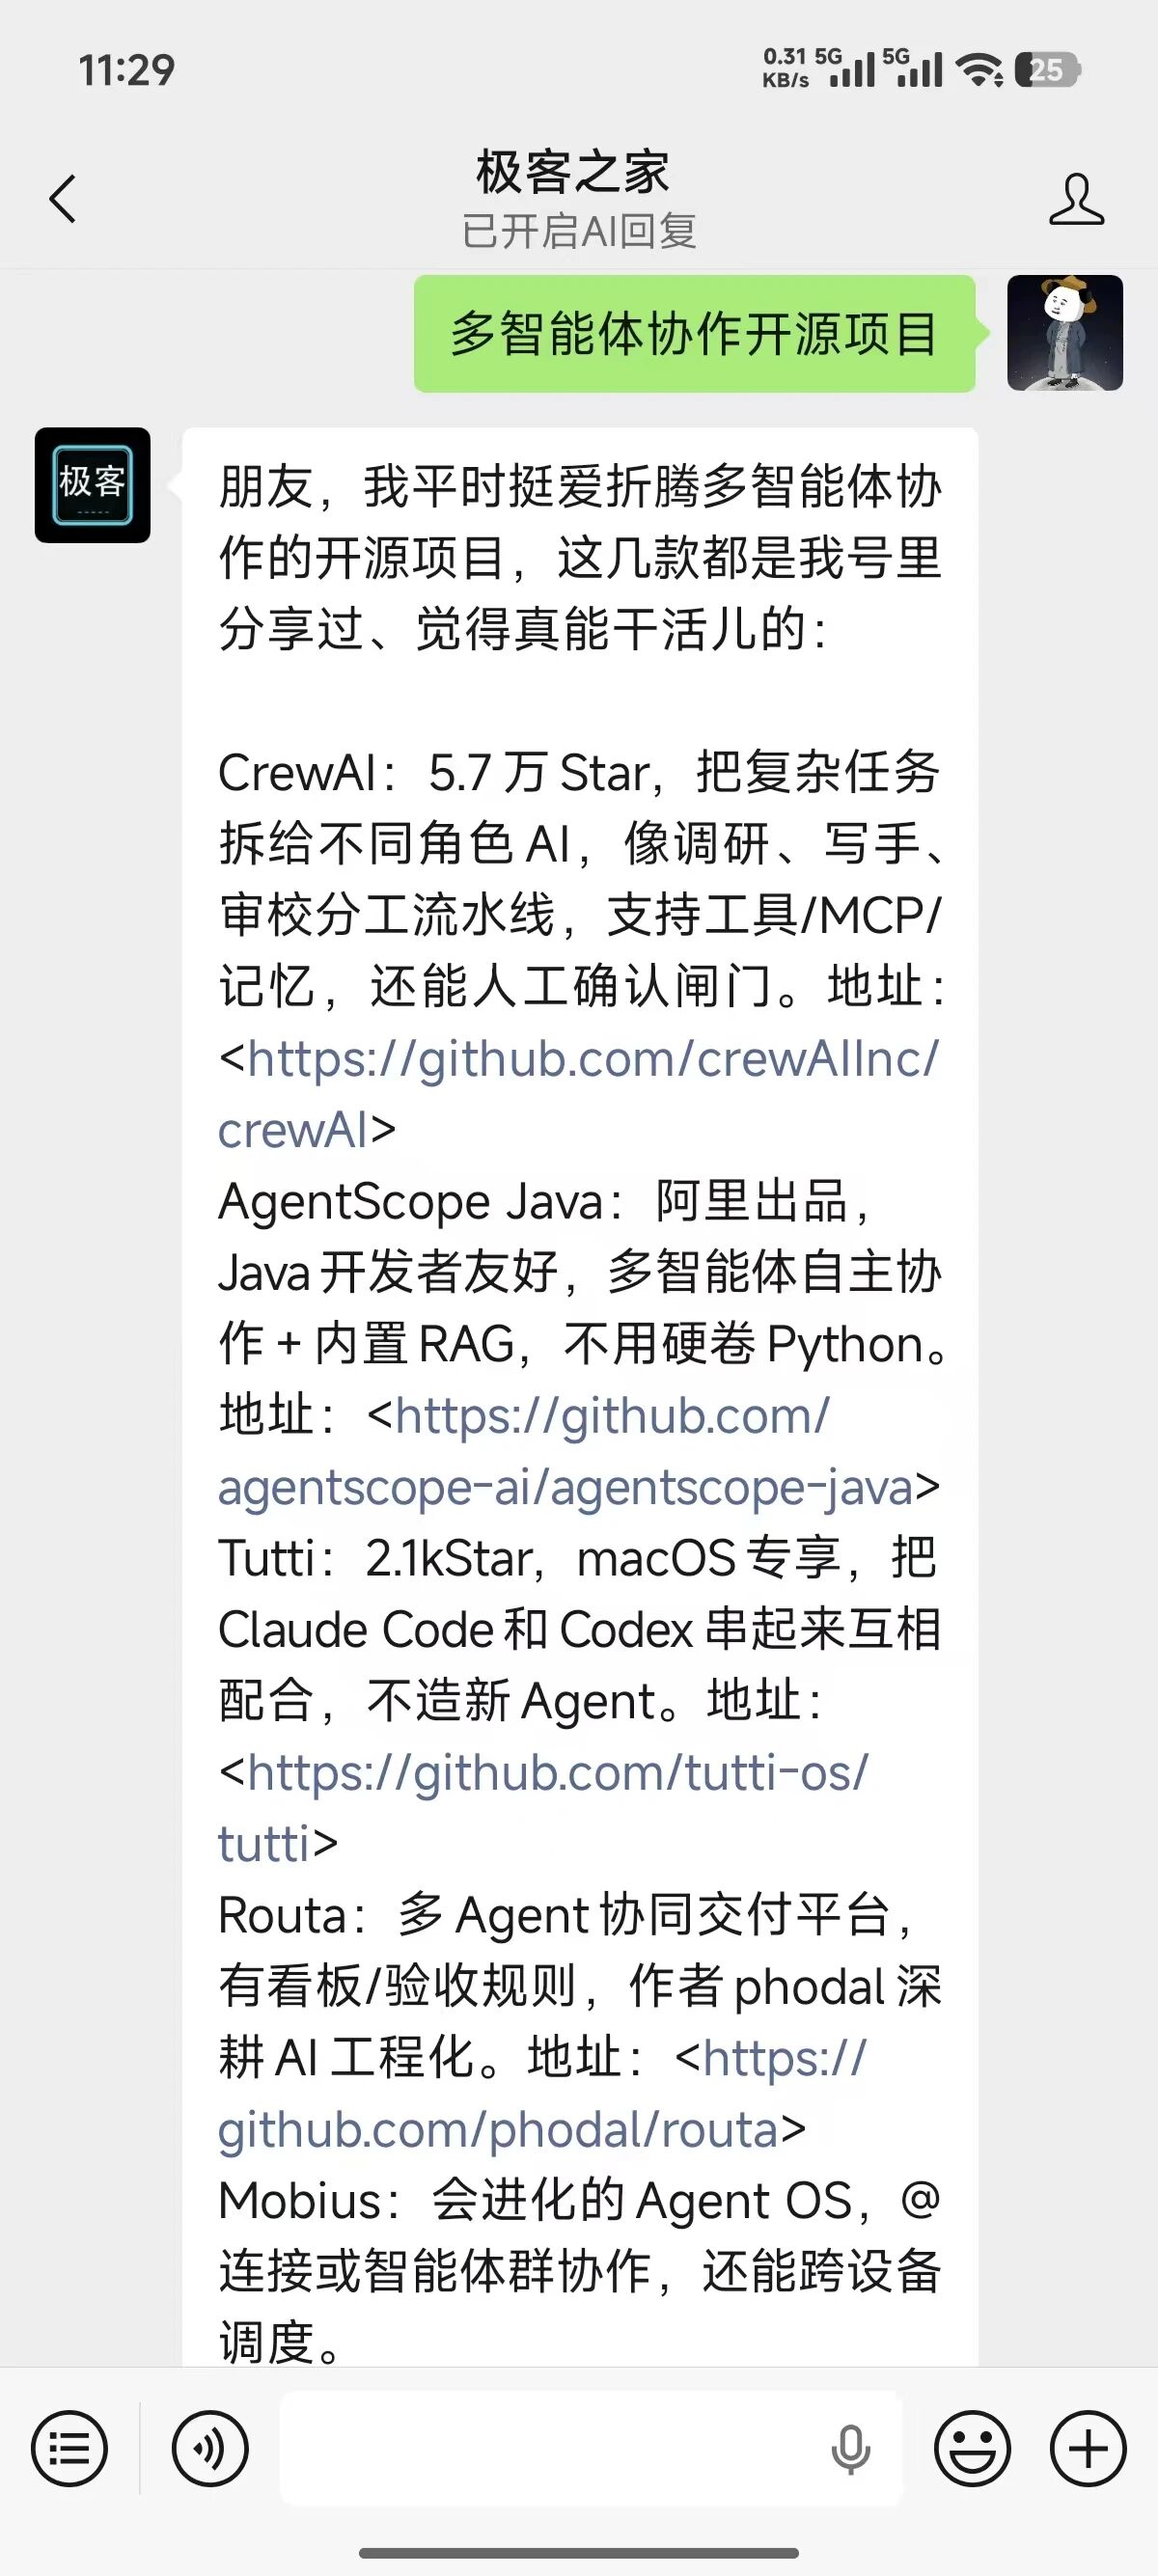
VoiceStudio 是 GitHub 上的一个声音克隆项目,我写这篇时 Star 数是 3.8 万。
它做的事就是把 ElevenLabs 那种按字符收费的云端语音服务搬到本地。声音克隆、视频配音、听写转文字、做有声书,这些都在自己电脑上跑,不用注册账号,也没有 API Key 这一说,用多用少都不收费。
简介
VoiceStudio 的前身叫 OmniVoice-Studio,作者 debpalash 是个人开发者,今年 4 月才开源,基本一个人在维护,到现在提交了两千次上下,更新频率很猛。
它不是单个语音模型,更像一个语音工作台。里面集成了 16 个语音合成引擎和 11 个语音识别引擎,默认引擎是 OmniVoice,出自 k2-fsa 团队,官方语言目录号称覆盖 646 种语言。646 是所有引擎加起来的数字,单个引擎不一定支持全部语言,具体看你装哪个。
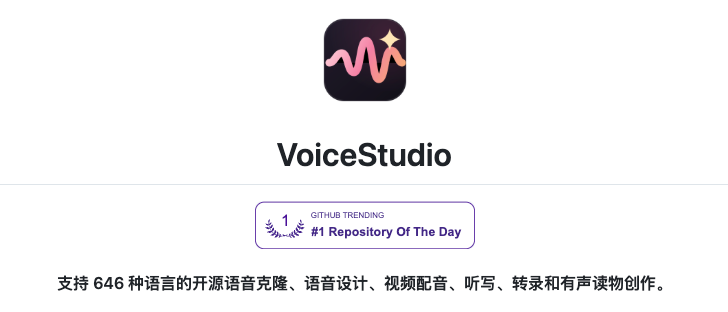
桌面端支持 macOS、Windows、Linux,也有 Docker 镜像。苹果芯片、英伟达显卡、纯 CPU 都能跑,速度不一样。
功能
声音克隆
拖一段 3 秒的录音进去,就能克隆出一个声音来。官方的说法是用 5 到 15 秒的干净单人录音效果更稳,3 秒是下限,能跑,但质量看运气。克隆好的声音可以存成声音档案,以后生成语音、视频配音、做有声书都能直接调用,不用每次重新上传。
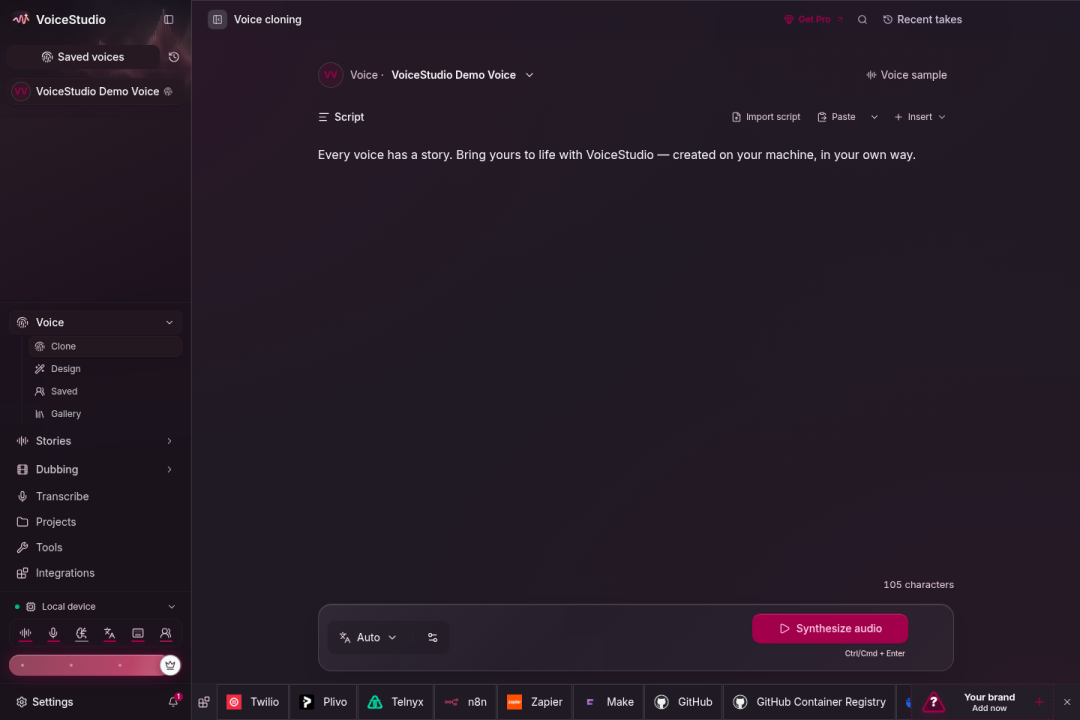 声音克隆工作区
参考录音尽量选单人、无背景音乐、近距离的片段。因为它基本是把参考录音原样复刻,你喂一段带混响带噪音的录音进去,克隆出来的声音也带着混响和噪音。
声音设计
不想用真人录音的话也有办法,直接用文字描述一个新声音。性别、年龄、口音、音高、语速、情绪都能写进描述里,它给你生成一个全新的虚拟音色。做有声书缺配角声音时,可以用它生成。
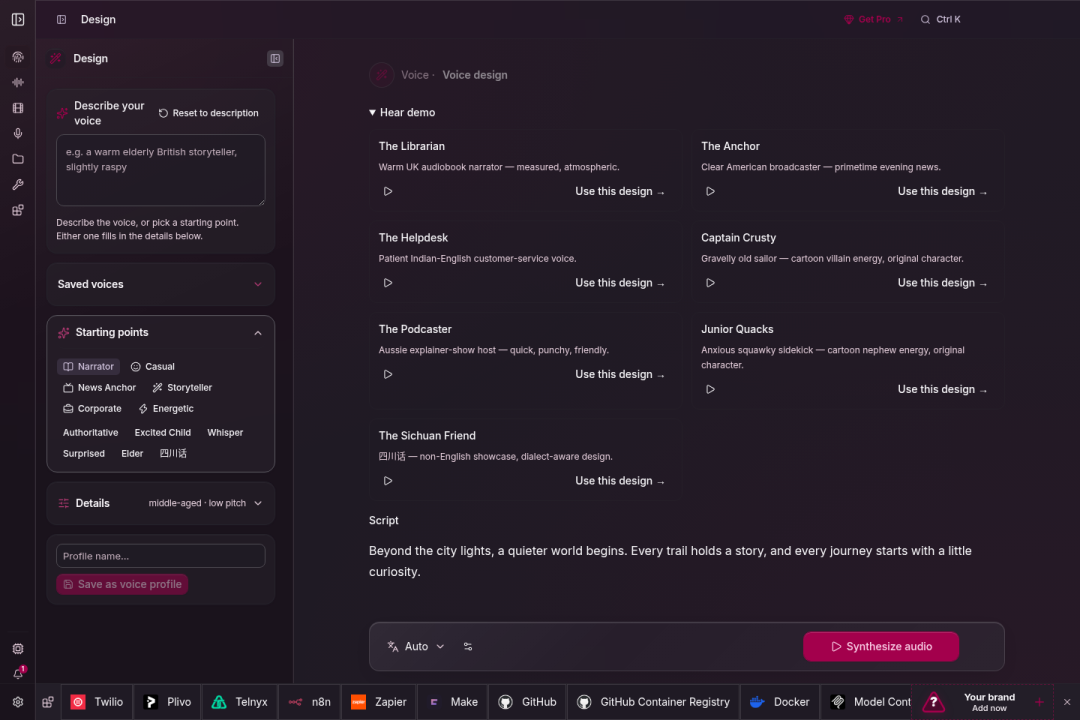 声音设计工作区
视频配音
视频文件丢进去,或者贴个视频链接,它会自动完成转录、翻译、区分说话人,然后重新配音并导出 MP4。多人对话会按说话人分配不同声音,背景音和人声分开处理,原片的环境音能保留下来。视频多的话可以丢进批量队列,排队跑。
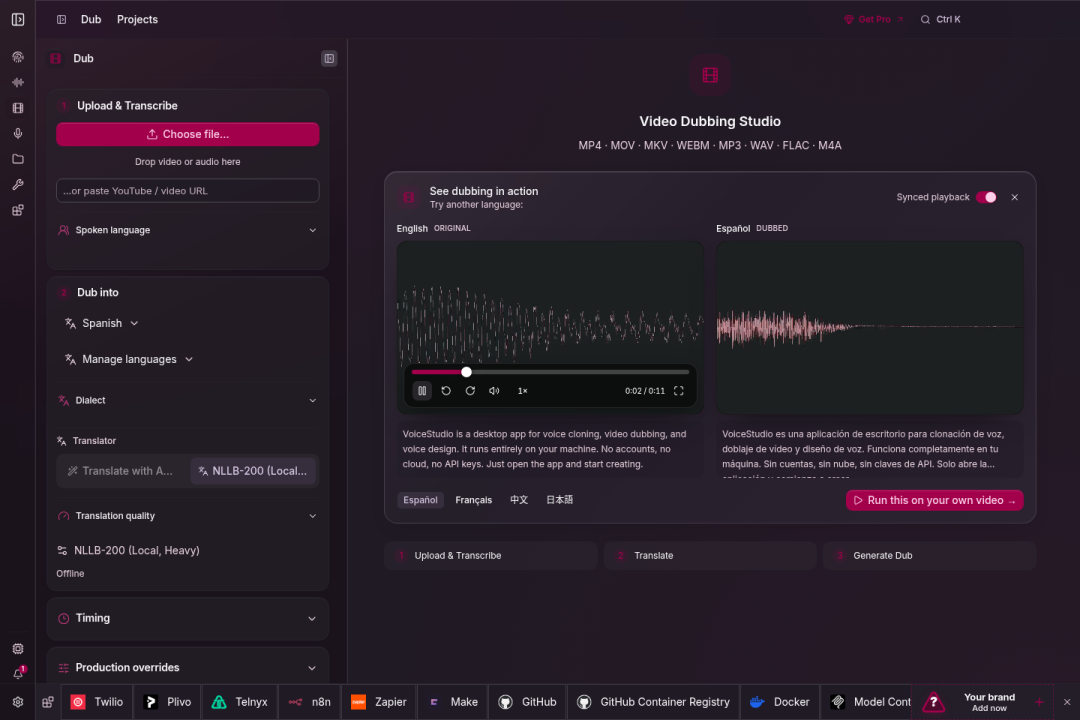 视频配音工作区
听写和转写
听写是全局快捷键触发的,在任何应用里按一下就能开始说话,说完自动转成文字,粘贴到你正在用的输入框里,不用切窗口。另外音频、视频文件也能转成可编辑、可搜索的文字稿,平时整理访谈和会议录音能用上。
有声书和故事
EPUB、PDF 或者长文本都能导进去,它会自动分章节,你可以给不同角色分配不同声音,最后导出带章节标记的 m4b 文件。多角色的故事模式是按剧本来的,一行一行给角色指派声音,最后一并合成。
模型管理
应用里内置了一个模型目录,16 个合成引擎、11 个识别引擎都在里面,可视化安装、卸载、切换,下载支持断点续传。显卡好就装大引擎,机器一般就换个轻量的,反正按需装,不用一次全下。
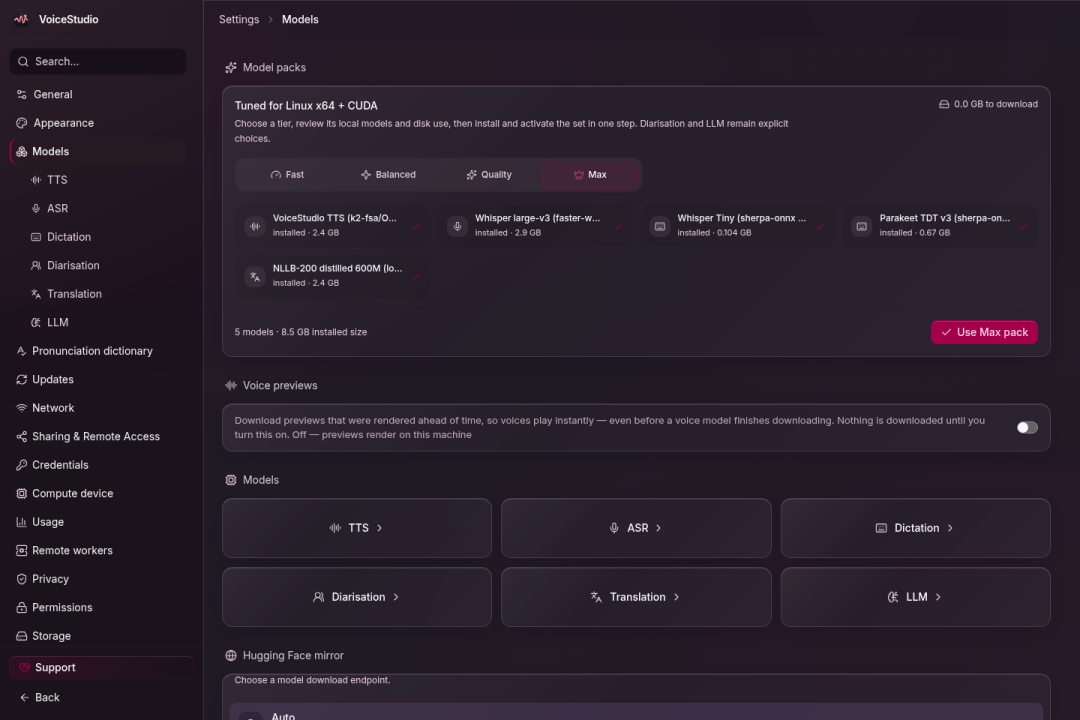 模型目录
开发者接口
本地会起一个 OpenAI 兼容的音频 API,地址是 localhost:3900。原来调 OpenAI 语音接口的脚本,把 base_url 改一行就能用。它还内置了 MCP Server,Claude Code、Cursor 这些支持 MCP 的工具都能直接调它的合成和转写能力,想让 Agent 用语音功能的话,从这里接就行。
快速开始
我装的时候走的是最省事的路线:去 GitHub Releases 页下载对应系统的安装包,Windows 是 MSI,macOS 是 DMG,Linux 有 AppImage。
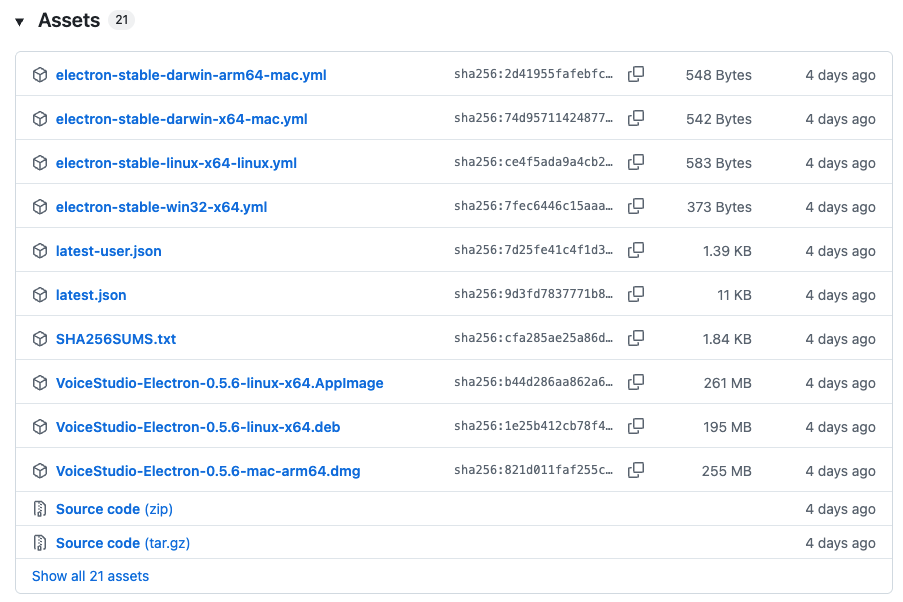
macOS 和 Linux 也有一行命令的安装脚本,复制粘贴就行。
git clone https://github.com/debpalash/VoiceStudio.git
cd VoiceStudio
bun install
cd electron
bun run dev
第一次启动它会自己创建 Python 环境、下载默认模型,这一步要等一阵,具体多久看网速和机器。装完打开声音克隆页面,拖一段录音进去,输入文字,点生成,等它跑完就能听结果了。
硬件方面,最低 8GB 内存、10GB 硬盘能跑起来,但建议 16GB 内存以上。要高保真克隆或者批量配音,8GB 以上显存会稳很多。没有独显也不是不能玩,选面向 CPU 的轻量引擎,接受它慢一点就行。
最后说说
有几个限制要注意。应用本身是 AGPL-3.0 开源,但里面的模型权重各有各的许可,默认引擎 OmniVoice 的预训练权重标的是 CC-BY-NC,也就是不能商用。想商用的话换 CosyVoice 3 这类 Apache-2.0 许可的引擎,不过动手之前最好自己去把条款核对一遍。另外,克隆别人的声音,需要本人同意。
我自己看上 VoiceStudio,主要图的是音频不出本机。采访录音、没公开的样片、客户的素材,这些东西本来就不该传到第三方服务器上。以前想干这些事挺麻烦的,得自己找一堆开源模型拼管线,不想折腾就只能把素材传上云,现在一个桌面应用就能做这些。
项目更新挺勤,感兴趣可以装来试试。
开源地址
https://github.com/debpalash/VoiceStudio
点击下方卡片,关注极客之家
这个公众号长期分享实用开源项目。如果你不想逐篇翻阅历史文章,可以直接关注微信公众号“极客之家”,通过后台留言与我们互动交流。