分享点我的经验,仅供参考。推荐学习路线:先跑懂→再拆代码→找到修改位置→找案例参考→自己动手改。
众所周知,深度学习都是踩前人肩膀上搞科研,很多时候不知道某个模块怎么改、某个结构能不能换,就先看看别人是怎么改的,再回到自己的代码里动手。
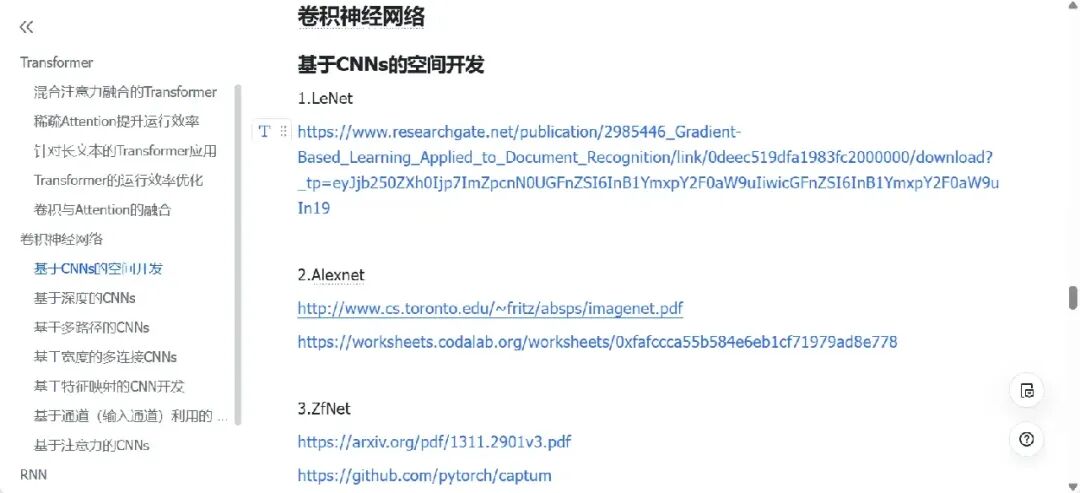
所以我把一批经典神经网络及其变体的论文+代码整理成了一个参考库,共627篇,按照不同技术路线分类。不是让你一下全看完,而是遇到问题时,可以直接来这里找类似案例。
下面说说具体的学习经验:
1.先跑官方最简例子
刚开始不要跑复杂项目。以PyTorch为例,先把MNIST这类最简单的例子跑通。重点盯两个东西:Dataset和Net。Dataset主要看数据是怎么读取、处理和返回的;Net则重点看Linear、Conv、ReLU、Pool这些基础模块到底怎么用。
跑的时候多加几个print,看看数据进入网络前是什么形状,经过不同层之后又变成什么样。
2.注释主流算法,一行一行来
选个自己研究方向的完整开源项目,从train.py训练主模块开始,再detect.py预测,然后loss.py、dataloader.py、model.py。先搞清楚训练流程,再看网络结构、损失函数和数据处理。
看不懂的地方就查,不要想着一次全部理解。这样一个模块一个模块拆下来,慢慢就会形成自己的代码库。以后再遇到类似项目,也会发现很多东西其实是相通的。
3.理解程序结构
很多人不会改代码,并不是完全看不懂,而是不知道从哪里下手。
其实可以先把一个深度学习项目简单拆成几部分:数据→网络→损失→训练→推理。
如果你想改数据处理,就重点看Dataset、数据增强这些地方;想改网络,就重点看model.py以及各层之间的数据流;想改训练策略,再去看优化器、学习率、loss等部分。
4.调网络别老跑主函数
比如你只是想知道某个网络结构能不能正常工作,没必要每次都从头训练几个小时。可以直接构造一个随机tensor作为输入,丢进模型里,看输入输出的shape是否正确。
如果网络结构比较复杂,也可以直接print模型,或者查看各层的参数和size,一层一层确认数据到底是怎么流动的。
尤其是开源项目里经常会把很多网络层封装起来,表面上看只有一个函数,实际里面可能堆了很多东西。
5.不知道怎么改,就先找类似案例
很多网络结构并不是完全从零设计出来的,研究中经常是在已有结构上继续改。所以我建议你先去找几篇相关工作,看别人有没有做过类似修改。
重点看:原来的结构是什么→作者改了哪里→为什么这么改→代码具体怎么实现。
这也是我整理那份神经网络论文合集的原因,重点看别人改了哪里、为什么改、代码怎么落地,这样你遇到问题按技术路线找对应案例,事半功倍。
6.自己一定要动手改
大胆上手,别怕报错。刚开始可以从很小的改动做起,比如换一个激活函数、替换一个模块、调整一个网络分支,先让自己经历完整的过程。熟练之后你就知道自己为什么改、应该改哪里。



