刚开始做深度学习时,我觉得调参就是不断改数字,学习率不行就换,batch size不行再换,epoch不够就继续加。
后来发现,这种调法效率真的很低。调参不是参数改得越多越好,顺序其实更重要。今天就和大家分享点我自己的调参经验。
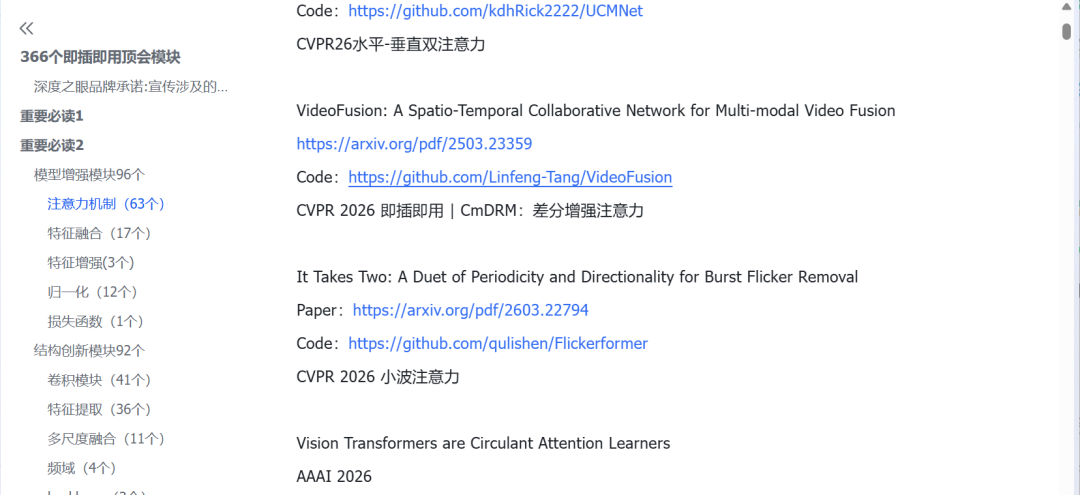
说在前面,调参过程中我非常建议大家看看Google那本深度学习调参手册,很适合拿来做系统化调参参考。另外,除了调参经验,我还补充了后续你改模型必备的即插即用模块(366个)+神经网络论文/代码(627篇),这些现成的模型模块和论文有助于你快速找到思路,今天也都无偿分享给大家。
1. 先别急着调参数
模型选择和数据质量是底线。先检查数据有没有清洗好、预处理是否合理、模型是否适合当前任务。如果数据比较少,可以优先考虑使用预训练模型微调。视觉任务也可以适当做数据增强。
2. 第一优先:学习率
学习率基本是最值得优先调整的参数。太大容易导致loss震荡甚至不收敛,太小又会让训练非常慢。所以可以先观察前几轮loss变化,再逐步调整。
3. 第二个:Batch Size
batch size和学习率会相互影响,同时还关系到显存和训练稳定性。所以比较推荐先确定学习率,再调整batch size,再看训练效果。
4. 模型学不会,就考虑增加容量
如果训练集和验证集表现都不好,可以考虑增加隐藏层单元数,或者适当增加网络层数。
但需要注意不能一味堆模型,复杂度上去后,训练成本和过拟合风险也会增加。
而且很多人真正卡住的地方,其实是Baseline跑通以后不知道还能改什么。
所以我整理的即插即用模块就是用在这一步,这些模块按不同创新方向做了分类,后面需要改模型的时候可以直接拿来找思路。
5. 训练集很好,验证集很差?
这种情况优先考虑过拟合。可以尝试数据增强、正则化、Dropout,或者Early Stopping。
6. Epoch也别无脑加
验证集loss还在下降,可以继续训练;如果长期不下降甚至开始上升,就可以考虑Early Stopping。
还有个我觉得特别重要的经验
一次尽量只改一个关键参数,并做好实验记录!不然最后效果变好了,你都不知道到底是谁起了作用。
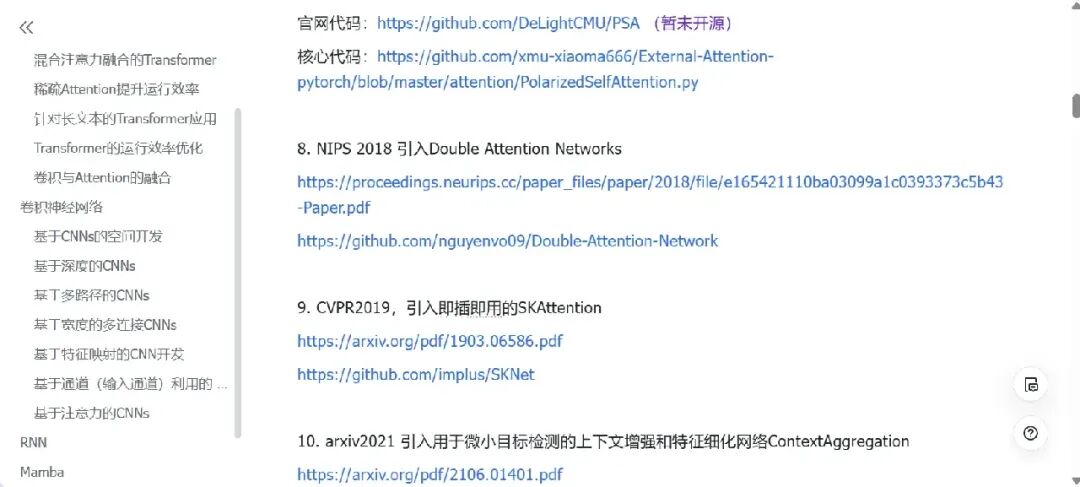
如果后面准备继续往神经网络算法和论文方向深入,就可以直接用我整理的627篇神经网络论文+代码,用来补基础、找模型思路和参考相关工作。
总之,调参整体可以按照学习率→Batch Size→隐层单元数→网络层数→正则化→其他参数这个顺序慢慢调,通常肯定比你凭感觉乱试效率高很多。



