最近在整理因果机器学习相关研究时发现,这一领域的核心问题其实已经逐渐收敛到几个关键技术瓶颈上,比如模型泛化、数据依赖或结构优化等。
因此我们系统整理了15篇论文资料,覆盖近期在该方向中具有代表性的解决方案,其中包含Nature Genetics、IJPR、Applied Energy等顶刊成果,并附带部分开源代码。
如果你正在做相关课题,这份资料可以帮助你快速判断:哪些问题已经被解决,哪些方向仍然存在可突破空间,从而避免重复劳动,提高选题效率。
扫码添加小享,回复“因果机器”
免费获取全部论文+开源代码
Inferring Heterogeneous Treatment Effects of Crashes on Highway Traffic: A Doubly Robust Causal Machine Learning Approach
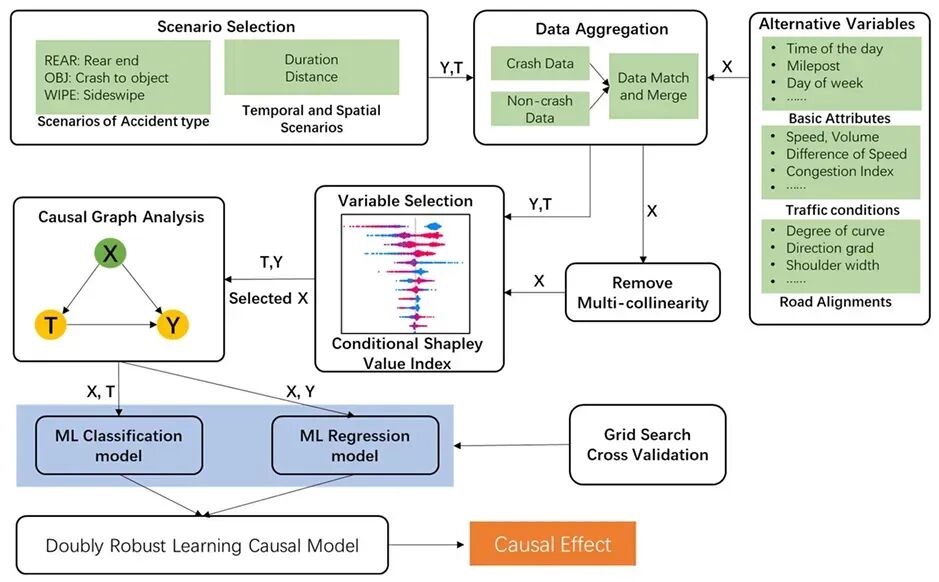
方法:论文提出一种因果机器学习框架,以 Neyman-Rubin 因果模型构建问题,借助条件沙普利值指数筛选变量,结合双稳健学习方法与机器学习模型,估计不同类型高速公路事故对交通速度的异质因果效应。
创新点:
- 融合因果机器学习与双稳健学习,估计不同高速公路事故对交通速度的异质因果效应。
- 提出基于因果图理论的条件沙普利值指数,实现无效变量与处理预测变量的剔除,优化变量选择以提高因果效应估计精度。
- 设计匹配算法筛选“反事实结果”,结合统计假设检验和敏感性分析,解决因果推断中缺乏真实数据验证的问题。
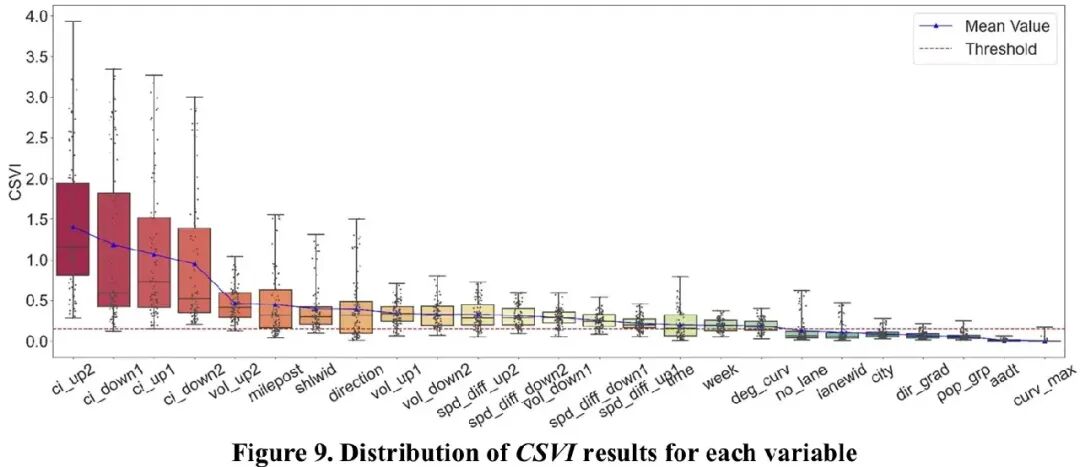
研究价值:该文提出融合条件沙普利值指标变量筛选的双重稳健因果机器学习框架,解决观测数据选择偏倚问题,精准量化追尾、侧擦、撞物三类高速事故随时空变化的异质性车速影响效应,为精细化高速应急管控提供可靠因果量化工具与实证规律支撑。
Machine learning in causal inference for epidemiology
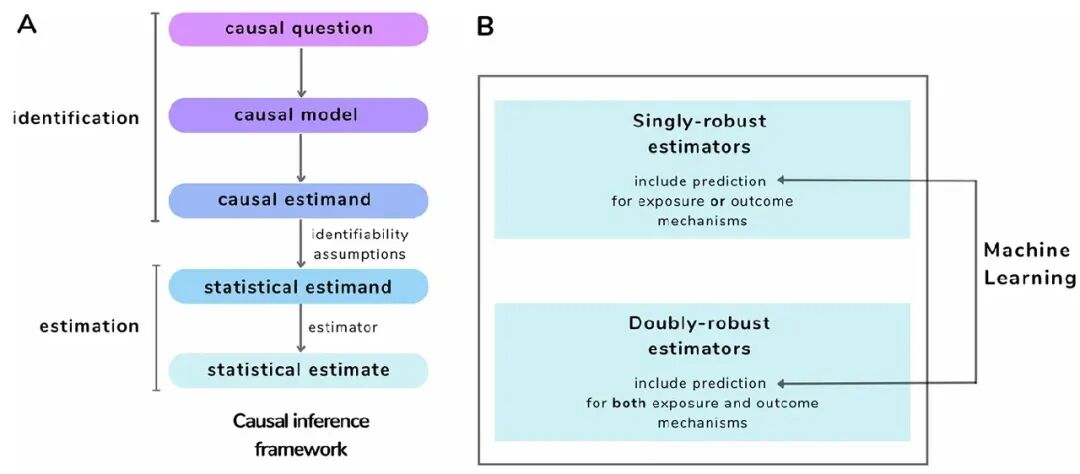
方法:论文针对流行病学因果推断中参数模型易误设的问题,引入因果机器学习方法,重点介绍 TMLE、AIPW、DML 三种双稳健估计量,结合机器学习的预测能力与传统统计的推断优势,解决 “插件偏倚”,实现高维数据下平均治疗效应的稳健估计。
创新点:
- 针对流行病学因果推断中参数模型易误设的问题,引入机器学习,用TMLE、AIPW、DML三种双稳健估计量解决“插件偏倚”。
- 阐明双稳健估计量只需任一机制模型正确即可无偏估计ATE,结合机器学习能处理高维数据复杂关系。
- 用流行病学实例验证双稳健估计量适用性,突出TMLE结合SuperLearner在模型误设时的优势。
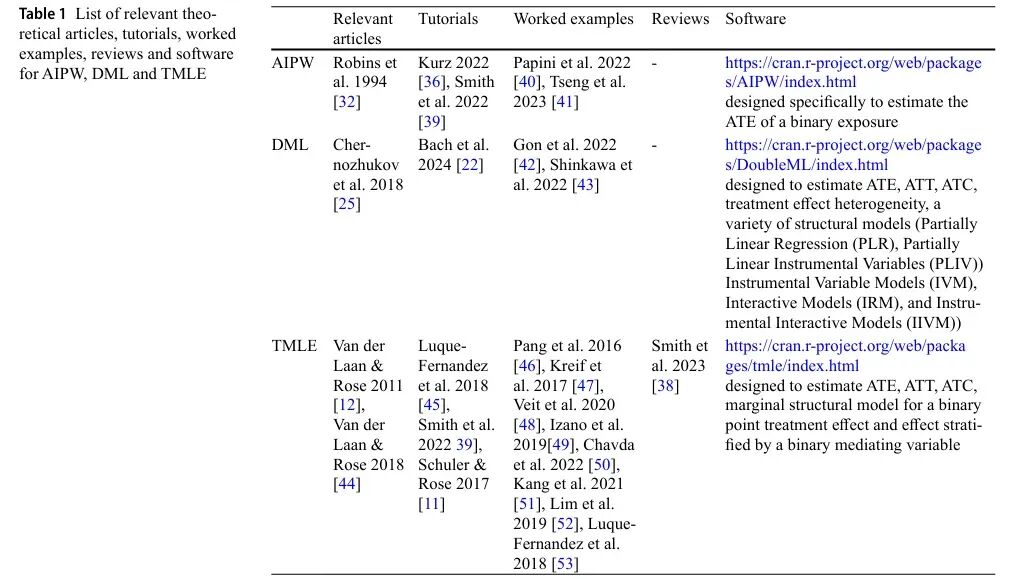
研究价值:综述面向流行病学研究者系统梳理AIPW、DML、TMLE三大融合机器学习的双重稳健因果估计方法,厘清传统参数模型误设与插件偏差难题,对比各方法原理、优劣、软件与流行病学实证场景,为高维观测健康数据开展可靠因果效应分析提供完整实操理论与方法指引。
......
更多论文请扫码添加小享,获取合集~
如果觉得有用,请帮我点个‘推荐❤️’
让更多人看到



