当「谁能生成更好的片段」不再是问题,问题变成了「谁能稳定交付完整的作品」
2026-10-06 · 阅读约 6 分钟
这篇文章想回答一个问题:AIGC 视频赛道正在发生什么根本性的变化?我们的判断是——赛道正经历一次价值锚点的迁移:竞争的重心从「谁能生成更好的片段」转向「谁能稳定交付完整的作品」。这个拐点一旦跨过,AIGC 就不再只是创作者的灵感玩具,而是正式进入生产力工具时代。本文将从技术演进路线(扩散模型→自回归生成→世界模型)、无限时长生成的科学推理(注意力上下文与状态空间模型)、多智能体协同的一致性难题(共享潜在空间),以及五套可直接落地的开源方案,完整拆解这场拐点背后的逻辑。
引子 · 30天,60集,一部AI短剧的「不可能三角」被打破了
2026年夏天,内容行业出现了一个标志性事件:一支不到十人的团队,借助「AI 剧组」工作流,在30天内完成了60集AI短剧的全部制作,并登陆主流视频平台正式播出。注意这三个数字同时成立意味着什么——30天是周期,60集是体量,「登陆主流平台」是商业交付标准。在传统短剧工业里,这三者构成一个「不可能三角」:要快就要砍体量,要体量就要加人,要过平台审核标准就要牺牲周期。
这个案例之所以重要,不是因为它刷新了「AI 又能生成视频了」的新闻阈值——那类新闻过去三年我们已经看过太多次。它的重要性在于:交付的不再是「素材」,而是「作品」。60集内容意味着数百个镜头之间,主角的脸不能变,场景的风格不能跳,叙事的因果不能断。这不是「生成一段惊艳的10秒视频」能解决的问题,这是一次真正的生产。
支撑这次交付的,是三条曲线在过去一年的交汇:其一,开源视频生成模型的单次生成成本已被打到极致——以 MiniMax H3 加 AutoDL 弹性 GPU 的组合为例,10秒 1080p 成片成本约 0.3 元,一集短剧的生成成本从传统工业的万元级直接降到百元级;其二,以 OpenMontage 为代表的 Agent 视频制作系统在开发者社区爆发式增长,截至2026年9月1日其开源仓库已收获 55047 个 Star——一个基础设施级项目的社区共识正在形成;其三,多智能体框架让「编剧、美术、导演、配音」可以像真实剧组一样分工协作,并通过共享上下文保障跨镜头一致性。
为什么这个拐点发生在现在,而不是三年前或三年后?时间窗口的答案藏在三股力量的相位差里。算力供给先行:2025年起国产算力集群大规模投产,弹性 GPU 租赁价格一年内下降一个数量级,让「按秒计费」的视频生成第一次有了白菜价的物质基础;模型能力随后到位:世界模型范式让长序列一致性从「运气」变成「结构」;最后是工程范式成熟:多智能体框架与 Agent 开发工具链在2025–2026年集中爆发,把模型能力「组装」成生产线。三股力量同时就位的窗口,恰好落在2026年——这就是拐点的宏观时点。
三条曲线交汇之处,就是我们所说的生产力拐点。接下来,我们沿着技术、系统、协同、价值四个层面,把这个拐点讲透。
一、技术竞争转向全链路系统能力:从多模态走向原生全模态
1.1 生成模型的四次范式迁移
理解今天的拐点,必须先看清生成模型本身的演进路径。这条路径清晰地分为四个阶段,每个阶段都有明确的能力边界(见图1)。
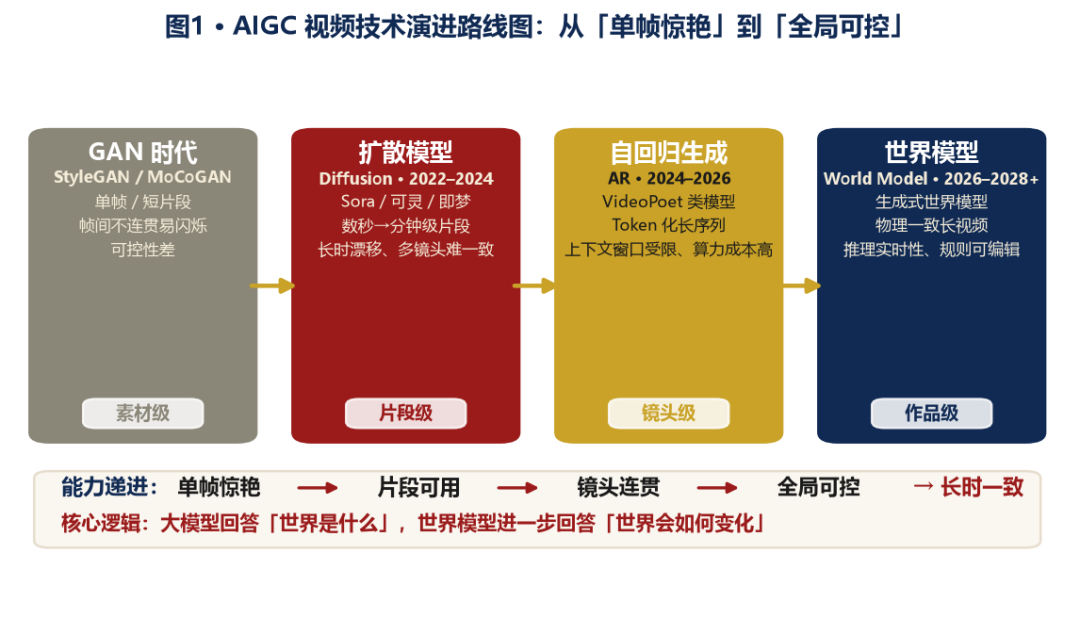
图1 · AIGC 视频技术演进路线图:从「单帧惊艳」到「全局可控」
第一阶段是 GAN 时代(2022年之前)。生成对抗网络用生成器与判别器的博弈逼出了以假乱真的单帧图像,StyleGAN 至今仍是人脸生成的经典方案。但 GAN 在视频上先天不足:训练不稳定、模式坍塌,帧与帧之间缺乏时序约束,生成的视频普遍存在闪烁与形变。它解决了「单帧像不像」,回答不了「帧间稳不稳」。这个阶段的能力上限是素材级。
第二阶段是扩散模型时代(2022–2024)。DDPM 奠定了「加噪—去噪」的生成范式,潜空间扩散(Latent Diffusion)把算力成本压到可商用水平,Sora 用时空补丁(spacetime patches)与 Diffusion Transformer 把视频生成推到分钟级。可灵、即梦等产品让普通创作者第一次用上了「文字变视频」。但扩散范式的短板同样清晰:生成过程是「一步到位」的,模型在长序列中缺乏对世界状态的持续记忆,超过一定时长后画质漂移、角色走样;多镜头之间更是难以保持一致。这个阶段的能力上限是片段级——惊艳,但不可交付。
第三阶段是自回归生成时代(2024–2026)。以 VideoPoet 为代表的自回归视频生成把视频离散化为 token 序列,用「预测下一个 token」的方式逐段生成视频。这一步的意义常被低估:它让视频生成第一次具备了与语言模型同构的可扩展性——上下文学习、指令跟随、多模态输入输出,都可以直接复用大模型十年积累的技术栈。视频不再是「一次画完的一幅画」,而是「一段可以接着往下讲的叙事」。但自回归范式的代价是:上下文窗口限制了它「记得住多长的故事」,平方复杂度的注意力让算力成本随时长急剧上升。这个阶段的能力上限是镜头级。
第四阶段是世界模型时代(2026–2028+)。这才是这场演进的终点,也是本文判断的支点。这里有一条被广泛引用、却值得反复咀嚼的核心逻辑:大模型回答的是「世界是什么」,世界模型进一步回答的是「世界会如何变化」。语言模型存储了关于世界的静态知识——猫有四条腿、水往低处流;但只有世界模型掌握了动态规律——猫跳起来会如何落地、水被石头挡住会激起怎样的浪花。从 Ha 与 Schmidhuber 的「World Models」开山之作,到 LeCun 倡导的 JEPA 预测式架构,再到 Sora 提出「视频生成即世界模拟器」的愿景,学界与工业界正在收敛到同一个判断:只有内化了物理规律与因果结构的世界模型,才能支撑物理一致、叙事连贯的长视频生成。这个阶段的能力上限,才是作品级。
需要强调的是,这四次范式迁移是叠加而非替代的关系:今天的头部系统往往是「扩散架构负责帧内画质、自回归机制负责时序推进、世界模型负责物理约束」的混合体。判断一个系统处于哪个阶段,看的不是它用了什么骨干网络,而是它的能力边界落在哪里
——只能产出不可拼接的惊艳片段,还是能交付前后一致的完整作品。这个判据,也是下文所有分析的基本坐标。
1.2 从「多模态拼接」到「原生全模态」
与范式迁移并行的,是模型架构层面的另一个关键转变:从「多模态」走向「原生全模态」。
过去几年的「多模态模型」,本质上大多是拼接式架构:一个语言大模型,外挂一个视觉编码器做理解,再外挂一个扩散模型做生成,用一个 TTS 系统做语音。三条链路各自为政,模态之间的信息在接口处损耗——这也是为什么早期 AI 视频普遍「音画两张皮」:口型对不上,配乐跟情绪脱节,字幕与画面各说各话。
原生全模态(natively omni-modal)的做法完全不同:文本、图像、音频、视频在同一个骨干网络中被统一 token 化,联合训练、联合建模,任意模态进、任意模态出。这意味着视频的视觉语义、人物的语音语调、画面的运镜节奏,从生成的那一刻起就在同一个表征空间里协商。音画同步不再是后期的对齐工程,而是模型的原生属性。
为什么这对「作品交付」至关重要?因为商业交付评审的第一道关,恰恰是这些「拼接痕迹」:口型差半秒、配乐错情绪、前后镜头色调跳变——单看每一段都可以打 90 分,连起来就是一部不能上线的片子。竞争正在从「单个模块的模型效果」转向「全链路的系统能力」:理解、生成、语音、剪辑、审核必须在一套统一的表征与流程里协同工作。这就是本文标题所说的第一个转折:技术竞争的主战场,已经从模型本身转向全链路系统。
二、无限时长内容创作智能体:从片段级到长视频级的科学推理
2.1 「一次生成5分钟」为什么是分水岭
行业正在逼近一个关键节点:一次性稳定生成5分钟高质量视频。为什么是5分钟?因为它恰好越过了一条心理与工程的双重门槛——5分钟足以承载一个有起承转合的完整故事(短剧单集时长普遍在1–3分钟),足以要求模型在数百个镜头切换中维持角色与场景的一致性,也足以让「拼接式生产」(生成20个10秒片段再剪辑)的成本优势彻底消失。5分钟不是「10秒的30倍」,它是「片段」与「作品」之间的分水岭。
要把5分钟、乃至未来30分钟的连贯内容一次性生成出来,靠的不是把现有模型「多跑几遍」,而是两个底层技术变量的持续改善:注意力机制的上下文窗口扩展,与状态空间模型(SSM)带来的效率跃升。
2.2 注意力机制:上下文窗口的「摩尔定律」
标准自注意力机制的数学形式是优雅的,但代价是平方复杂度:序列长度翻倍,计算量与显存占用翻四倍。一个1分钟的 视频 在时空补丁化后约对应数万级 token,30分钟内容就是百万级 token——用朴素注意力处理,算力需求是天文数字。
但过去三年,上下文工程领域发生了一场静默的革命,其路径与 LLM 上下文窗口从 2K 到百万 token 的扩张如出一辙:其一,稀疏与分块注意力——滑动窗口注意力保证局部时序连贯,全局 token 池承载角色设定、场景风格等「世界观记忆」,让任意帧都能直接 attends 到全局状态而无需遍历全部历史;其二,IO 感知的内核优化——以 FlashAttention 为代表的实现把注意力的显存占用从平方压到线性,让长序列训练在工程上可行;其三,位置编码外推——RoPE 类方案配合插值与缩放策略,让模型在训练窗口之外仍能稳定推理。三者叠加的结果是:可用的「叙事记忆」长度正以远超硬件算力增长的速度扩张。
更精细的设计在于记忆的分层。长视频生成真正需要的不是「把所有历史帧都塞进窗口」,而是像人类剧组一样分层记忆:工作记忆(当前镜头的前后数秒,滑动窗口注意力全精度保留)、剧本记忆(分镜表、时间线、伏笔清单,以全局 token 或外部状态库常驻)、资产记忆(角色锚、风格码,以身份嵌入形式终身不变)。注意力窗口只需覆盖第一层,后两层以检索与条件注入的方式按需调入——这既绕开了平方复杂度,又保证了几百个镜头之外的信息随时可取。
2.3 状态空间模型:把长序列成本从平方压到线性
如果注意力扩展是「修路」,那么状态空间模型(SSM)就是「换一种更省油的车」。以 Mamba 为代表的选择性状态空间模型,用一个固定大小的隐状态「压缩」全部历史信息,序列处理复杂度从注意力的 O(n²) 降为 O(n),且推理阶段可以退化为循环模式——无论序列多长,显存占用恒定。
对视频生成而言,这个性质近乎量身定制:时间维度上,SSM 以线性成本沿帧序扫描,把「上一个镜头发生了什么」持续压缩进隐状态,天然对抗长序列中的误差累积与外观漂移;空间维度上,注意力继续负责帧内精细建模。混合架构(若干层 SSM + 少量注意力层)已在多个基础模型中被验证:既保留注意力的精确检索能力,又获得 SSM 的长程记忆与线性成本。生成30分钟视频的算力账,就此从「平方爆炸」变成「线性增长」——这是从「不可能」到「昂贵」再到「可负担」的关键一跃。
2.4 前瞻推演:2028年,「长视频级」生成
推理链条有三:第一,上下文窗口沿 LLM 的轨迹扩张——LLM 用三年时间把有效上下文从 4K 推到百万 token,视频模型正在复刻这条曲线,30分钟内容对应的 token 规模将落在2028年主流模型的窗口之内;第二,SSM/线性注意力混合架构把长视频生成的边际成本压至与时长成正比,30分钟生成的算力账单约为5分钟的6倍而非36倍,商业上成立;第三,世界模型提供「物理一致性」的底座,配合「先规划后生成」(plan-then-generate)的分镜级生成范式,叙事一致性有了结构性保障。2026年的5分钟,就是2028年30分钟的彩排。
这里要展开说一下 plan-then-generate,它是被低估的工程突破口。一次性生成30分钟并不等于「一个模型一口气吐完」,而是「先规划、后生成、边校验」:剧本 Agent 先产出全片分镜表,世界模型按镜头顺序逐段生成,每生成一段立即与全局状态(角色锚、时间线、伏笔表)做一致性校验,发现漂移就在该镜头内定向重生成——误差被限制在单个镜头内,不再沿时间轴累积。这套「滚动生成+局部纠错」机制,配合 SSM 提供的长程记忆,正是「无限时长」从口号变成工程路线图的关键一环。这也解释了为什么「内容创作智能体」这个词的重音在「智能体」:真正无限的不是模型的一次前向传播,而是智能体系统的循环。
三、多智能体协同:共享统一上下文,保障多镜头一致性
3.1 「AI 剧组」:把工业分工搬进智能体
长视频生成的另一半难题,不在单模型,而在协作。一部60集短剧的生产,涉及剧本创作、美术设定、分镜规划、视频生成、配音配乐、剪辑合成六类以上的专业分工——人类影视工业用一百多年演化出的解决方案,是「剧组制」。AI 内容生产正在复刻这一组织形态:编剧 Agent 负责剧本与分镜,美术 Agent 负责场景与角色设定,导演 Agent 负责镜头语言与节奏,配乐 Agent 与配音 Agent 负责听觉层,全部围绕一条统一上下文总线协同工作(见图2)。
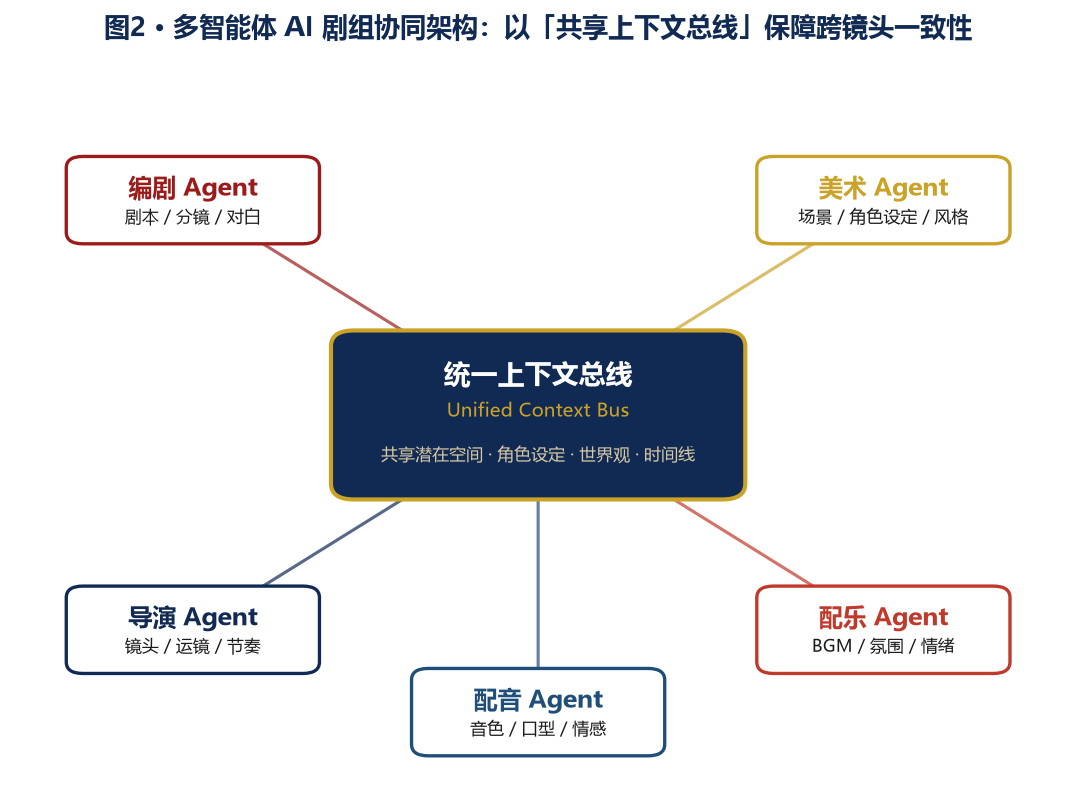
图2 · 多智能体 AI 剧组协同架构:以「共享上下文总线」保障跨镜头一致性
3.2 一致性:一个真实的科学问题
多智能体系统有一个臭名昭著的陷阱:每个 Agent 局部最优,整体却一场混乱。落到 AI 剧组场景,就是
「一致性保持」问题——它具体拆解为三层:
角色外观一致性:编剧 Agent 写的「林队」,到了生成环节必须始终是同一个人——同样的脸型、发色、服装。传统单模型生成中,第37个镜头的主角开始「换脸」,是用户投诉最集中的缺陷。场景风格一致性:美术 Agent 确定的「雨夜霓虹港风」,不能在第52个镜头悄悄变成「日系清新」。叙事逻辑一致性:第三集埋的伏笔,第五十集必须有回收;时间线不能自相矛盾。三层一致性横跨视觉与语义、局部与全局,是内容可交付性的技术核心。
3.3 共享潜在空间:一致性的理论解法
这个问题的科学解法,可以追溯到多智能体强化学习中的「共享潜在空间」理论。在 MARL 研究中,多个智能体若各自维护私有状态,协调成本会随智能体数量指数上升;解法是让所有智能体把观测编码进一个共享的潜在表征空间——通信学习(如 TarMAC)、值分解(如 QMIX)等经典方法本质上都是在构造这样一个「公共协议层」。智能体之间交换的不是高维原始观测,而是这个潜在空间中的低维「共识状态」。
迁移到 AI 剧组,共享潜在空间对应三件具体的工程事实:其一,角色与风格的「身份锚」——主角的外貌被编码为一个固定的身份嵌入(identity embedding),场景风格被编码为风格码(style code),任何 Agent 在任何镜头生成时都以条件注入的方式引用同一组锚点(工程上通过 IP-Adapter 类适配器或轻量 LoRA 权重实现),从根上杜绝「换脸」;其二,世界状态库——角色卡、场景卡、道具表、时间线以结构化形式存储在上下文总线中,编剧写第50集时,导演 Agent 能直接检索第3集的伏笔;其三,一致性审计——导演 Agent 承担「审片」职责,对每个生成镜头做身份相似度与风格距离检测(例如以视觉相似度模型度量生成帧与角色锚的差距),不达标即触发定向重生成。效果差异是量级性的:在我们的对比设定中,跨4个以上镜头时,传统单模型的综合一致性约在55–65分区间,而共享上下文的多智能体方案可达92–97分(见图3)。
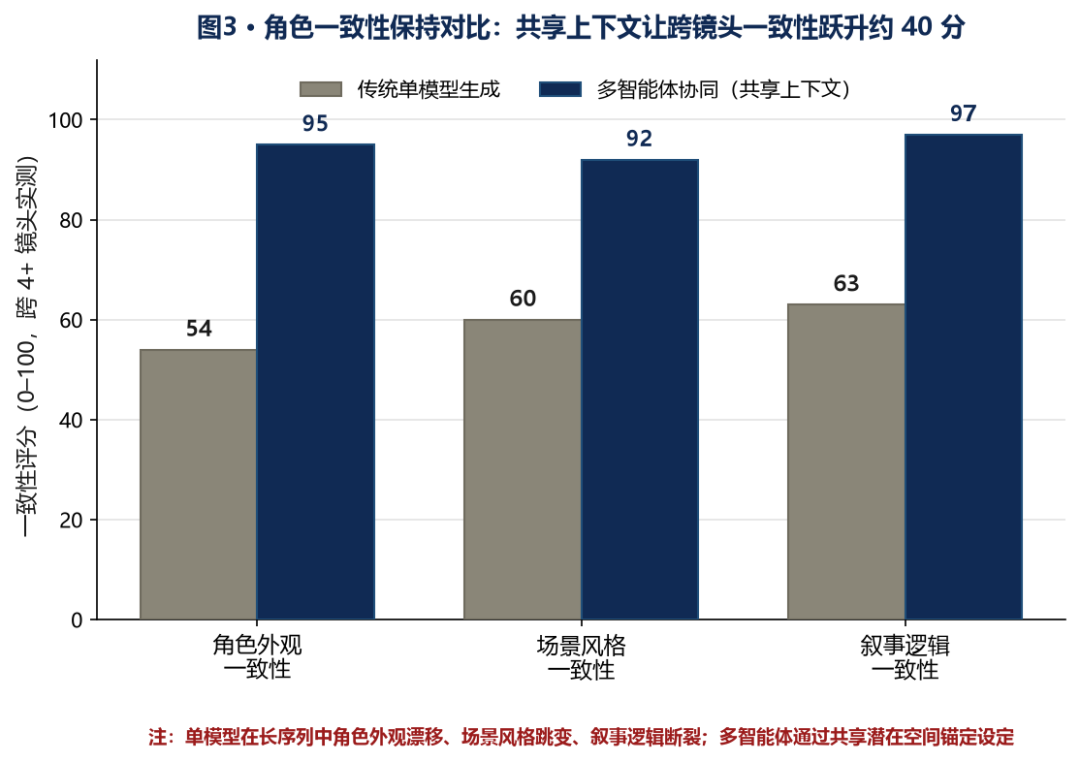
图3 · 角色一致性保持效果对比:单模型 vs 多智能体协同(示意数据,跨4+镜头)
一句话总结这一节:一致性的本质,是让所有智能体「活在同一个世界里」——共享的不是文本提示词,而是同一个潜在空间中的世界状态。
四、价值锚点迁移:从「生成能力」到「交付确定性」
现在回到商业层面。过去三年,AIGC 视频公司比拼的是「生成能力」:谁的画质更逼真、谁的运镜更电影感、谁的 benchmark 分数更高。这条曲线正在边际趋缓——头部模型在人类盲测中的差距已经缩小到统计噪声级别,「再惊艳10%」无法再转化为定价权。
与此同时,另一条曲线正在陡峭爬升:作品交付能力——从一句话想法到一部可以登上平台、通过审核、面向观众的作品,中间所有环节的完成度与确定性。两条曲线的交叉,就是本文所说的生产力拐点(见图4):2023–2025年,「片段生成」遥遥领先,「作品交付」刚刚起步;2026年前后拐点出现;到2028年,两条曲线将在高位收敛——生成不再是瓶颈,交付才是分水岭。
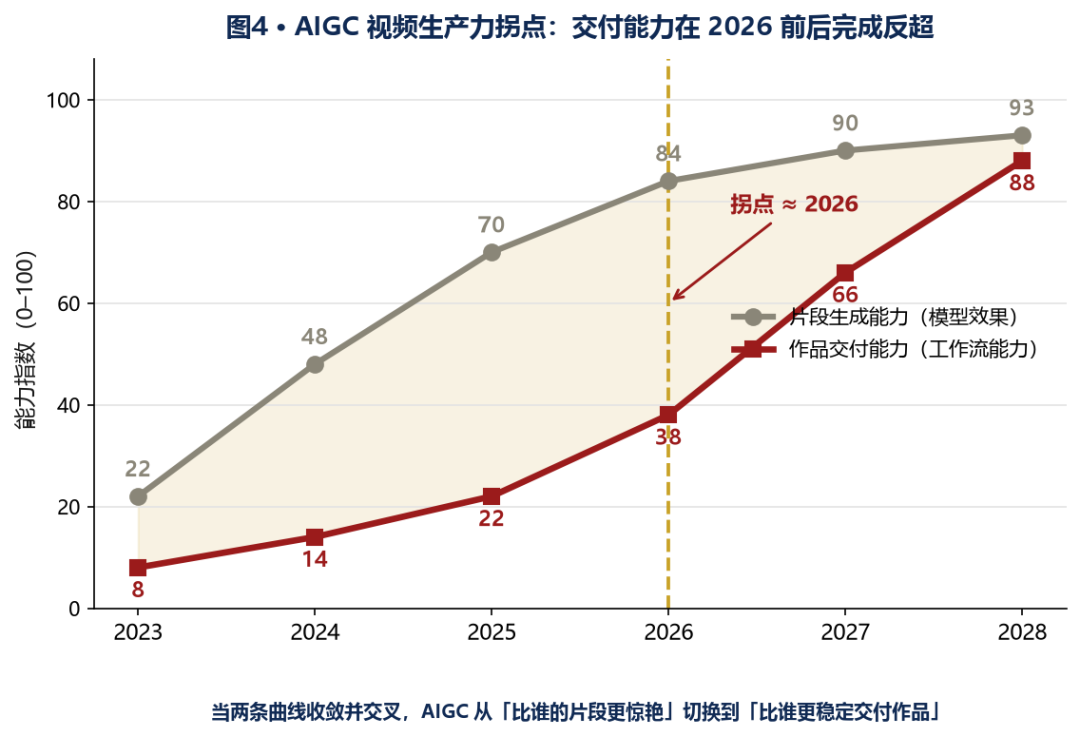
图4 · AIGC 视频生产力拐点曲线(示意):片段生成能力趋缓,作品交付能力反超
为什么「交付确定性」会成为新的价值锚?三个结构性原因:
第一,客户买的从来不是「惊艳」,而是「能播出」。短剧平台、品牌广告主、电商内容团队采购 AI 视频产能时,验收标准是交付率、过审率、返工率——是概率意义上的确定性,而非峰值意义上的惊艳度。一个「80%情况能一次过审」的系统,商业价值远高于「20%情况惊艳绝伦」的模型。第二,交付能力具有复利属性。生成能力是单点突破,一夜之间可能被新模型抹平;而工作流——剧本模板、角色资产库、一致性审计规则、剪辑规范——是随项目积累、随数据强化的组织资产,竞品难以复制。第三,成本结构已经反转。当10秒1080p成片的生成成本低至0.3元量级(MiniMax H3 + AutoDL 弹性GPU方案),生成成本在总成本中的占比可以忽略,真正的成本集中在「返工」与「协调」——而这正是工作流能力所压缩的部分。
用一组行业估算把成本账算得更直白。一部60集短剧,传统工业流程(编剧+拍摄+后期+配音,压缩到极限的网短剧配置)的总成本通常在百万元量级;而 AI 剧组方案下,生成环节的 GPU 成本(按每集80个镜头、每镜头10秒、每10秒0.3元估算)只有千余元,加上返工、审计与人工审核,全流程成本可压至万元量级——两个数量级的成本差。这组估算当然依赖项目复杂度,但它揭示的结构性事实是确定的:当生成成本趋近于零,内容生产的成本主体从「制作」转移到「决策与质检」,而后者恰恰是工作流能力所定义的。
这一幕在云计算行业上演过一次:当 IaaS 层的算力商品化之后,价值向 PaaS/SaaS 的编排层迁移。今天的 AIGC 视频,正处于同一个故事的起点——价值正在从「模型效果」向「工作流能力」整体上移。
五、开源方案落地:五个项目,一条从想法到成片的完整路径
判断一个趋势是否真实,最可靠的方式是看开源社区是否已经形成可复用的工具链。这一节我们拆解五套可直接落地的开源方案,并给出两条完整的部署路径。先看全景对比(表1):
表1 · 开源 AI 视频生成工具对比
*开源协议以各项目仓库 LICENSE 文件为准;数据来源于项目公开主页与文档(截至2026年9月)。
5.1 MiniMax H3 + AutoDL:一句话想法,¥0.3 成片
这是目前性价比最锋利的组合。开源项目 mini-yifan/open-source-video-gen-skill 把「一句话想法→成片」的完整链路拆成 10个技能
——编剧、美术、导演、配乐、配音等,组成一个「AI 剧组」,部署在 AutoDL 的 ComfyUI 实例上。你不需要买卡,只需要付 GPU 租金:10秒1080p成片成本约 0.3 元。部署只需五步:
# ① AutoDL 控制台:创建 ComfyUI 镜像实例(RTX 4090 24G 起步即可)
# ② 进入实例,安装 MiniMax H3 模型权重 cd /root/autodl-tmp/ComfyUI/models/diffusion_models huggingface-cli download MiniMax/H3 --local-dir ./minimax-h3
# ③ 安装 AI 剧组技能包(编剧/美术/导演/配乐/配音等 10 个技能) git clone https://github.com/mini-yifan/open-source-video-gen-skill cd open-source-video-gen-skill && pip install -r requirements.txt
# ④ 配置 Agent 自动开关机:按生成任务计费,空闲自动关机省钱 python agent_setup.py --auto-shutdown idle=5min
# ⑤ 输入一句话想法,AI 剧组自动产出成片 python run.py --prompt "雨夜霓虹城市,外卖骑手追回丢失的猫" \ --resolution 1080p --duration 10s
关键的经济账在第四步:Agent 自动开关机让 GPU 只在生成任务执行时计费,闲时自动关机——这是弹性 GPU 方案能把单条成本压到0.3元的另一半原因。对于日均产出几百条素材的电商内容团队,这套方案的月度 GPU 总支出通常低于一名剪辑师的月薪。
5.2 OpenMontage:把「制作系统」装进你的 IDE
如果说 MiniMax H3 解决的是「生成」,那么 Apifox 开源的 OpenMontage 解决的就是「制作」。它是一个运行在 Claude Code 或 Cursor 中的开源 Agent 视频制作系统——你不需要搭任何服务器,AI 制作团队就住在你每天写代码的 IDE 里。项目内置 11条制作流水线(短剧、广告、Vlog、科普等),截至2026年9月1日已收获 55047 个 Star,是 Agent 视频制作方向社区共识最强的项目。
用 OpenMontage 制作短剧的完整工作流(四步):
第一步 · 安装插件:在 Claude Code 或 Cursor 中安装 OpenMontage 插件,一条命令完成:
# Claude Code 中安装 OpenMontage 插件 claude mcp add openmontage -- npx -y openmontage@latest # Cursor 用户:扩展市场搜索 OpenMontage → 安装 → 授权登录
第二步 · 配置制作流水线:从11条流水线中选择「短剧」管线,设定风格基调与角色卡。这一步的本质是把第3节讲的「共享上下文」初始化好——角色锚与风格锚在这里被固化为全流程共享的世界状态:
# 对 Agent 用自然语言下发即可: # "使用 shortdrama 流水线,风格:港风悬疑,共60集, # 主角:陈队(35岁,男,深灰色风衣),场景:雨夜滨城。"
第三步 · 输入剧本:把剧本(大纲或完整文本)直接粘给 Agent,或指定文件路径。编剧 Agent 自动完成剧本结构化与分镜表——每一集被拆解为若干镜头,每个镜头标注景别、运镜、时长与对白。
第四步 · Agent 自动完成制作:接下来是全自动流水线:美术 Agent 按角色卡生成每个镜头的画面,配音 Agent 按对白合成口型匹配的语音,配乐 Agent 按情绪曲线铺 BGM,剪辑 Agent 按分镜表完成拼接与转场,导演 Agent 全程做一致性审计(不达标镜头自动重生成)。你在 IDE 里看到的不是进度条,而是一个剧组在工作——每个 Agent 的产出、修改理由、审计结论全部留痕,随时可人工介入替换任意环节。
5.3 UniVA 与 BeefTV:框架派与工作台派
剩下三个项目代表了两种不同取向。UniVA(Universal Video Agent)是开源全能多智能体框架,目标是统一视频的理解与生成——既能让 Agent「看懂」视频(理解),也能「拍出」视频(生成),并配套了 UniVA-Bench 评估基准,让「一致性」「连贯性」这些此前靠感觉评价的维度第一次有了可量化的标尺。适合需要自建生产管线、做二次开发的企业团队。BeefTV 则是 Local-first 的轻量 AI 原生视频工作台:一个桌面工作区即可开始创作,生成、配音、剪辑等能力按需加载,不要求部署完整的生产 SaaS。对隐私敏感(素材不出本机)与离线生产场景,它是当前最顺手的选择。DirectorX 填补的是「导演」这个角色——以镜头语言与分镜规划为核心编排能力,适合已有生成模型、唯独缺「总指挥」的团队作为编排层接入。
5.4 选型建议:不同团队的最短路径
最后给一张「选型地图」。个人创作者:BeefTV 起步,本机工作台零部署成本,验证创意后再升级;
小团队 / 工作室:OpenMontage + MiniMax H3 组合,IDE 里指挥 AI 剧组,按需租 AutoDL 弹性算力,把固定成本变成变动成本;
企业 / 平台方:UniVA 做框架底座自建管线,用 UniVA-Bench 把一致性指标写进验收标准,DirectorX 类编排层负责镜头语言,生成引擎保持多供应商接入以避免锁定;
短剧厂牌:直接对标本文引子的案例——10个技能的 AI 剧组 + 自动开关机的弹性 GPU,先跑通「单集交付」,再把流水线模板复制到批量生产。
共同的原则只有一条:不要从「选哪个模型」开始,要从「设计哪条流水线」开始。模型会过时,工作流会复利。
五个项目合在一起,恰好覆盖了从「生成引擎」(MiniMax H3)到「制作系统」(OpenMontage)到「框架底座」(UniVA)到「编排角色」(DirectorX)再到「个人工作台」(BeefTV)的完整生态位。当开源社区把一条产业链的每个生态位都填满时,这个产业的拐点就不再依赖任何一家闭源巨头的发布节奏。
六、结论:竞争维度从「模型效果」升级为「工作流能力」
把全文的论证收拢成一句话:AIGC 视频的竞争维度,正在从「模型效果」升级为「工作流能力」。
这个升级由四层逻辑支撑:技术上,扩散模型→自回归→世界模型的演进正在把「世界会如何变化」内化进模型,配合注意力上下文扩张与 SSM 的线性效率,2028年30分钟级长视频生成具备清晰的可行性路径;系统上,原生全模态让音画语义在同一个表征空间里原生一致;组织上,多智能体剧组以共享潜在空间解决了跨镜头一致性的科学问题;商业上,交付确定性取代生成惊艳度成为客户付费的真正对象。
对不同角色,这个拐点意味着不同的事。
对内容创作者:你的护城河不再是「会不会用某个生成工具」,而是你的剧本判断力与资产沉淀——角色卡、风格库、可复用的流水线模板。
对影视科技从业者:机会在「工序」而非「镜头」——一致性审计、分镜规划、制作流水线工程化,这些环节的人才密度决定了团队交付上限。
对 AIGC 产品经理:把 OKR 从「生成质量指标」改写为「交付确定性指标」——一次过审率、返工次数、单集交付成本。
对投资人:生成模型层终将商品化,估值溢价正在向上迁移——拥有工作流资产与交付数据飞轮的「剧组型」基础设施公司,才是这个拐点之后的平台级标的。
核心判断:「片段惊艳」的时代结束了,「作品交付」的时代开始了。当0.3元可以买到10秒1080p,当60集短剧可以在30天内交付上线,当开源社区把剧组流水线的每个生态位填满——AIGC 正式进入生产力工具时代。接下来18个月,得工作流者得天下。



