对于如何挑选baseline这个问题,我分享点自己的经验,仅供参考。
简单来说,重点在于筛选,看论文值不值得做、代码能不能跑、数据能不能拿、权重有没有、脚本齐不齐。
我自己也整理了几份配套资料:Baseline筛选检查清单、论文复现避坑清单,以及一批涨点论文。前两者可以拿来帮助你筛论文、查代码,而涨点论文很适合你Baseline跑通之后找改进思路,后面都会讲到。
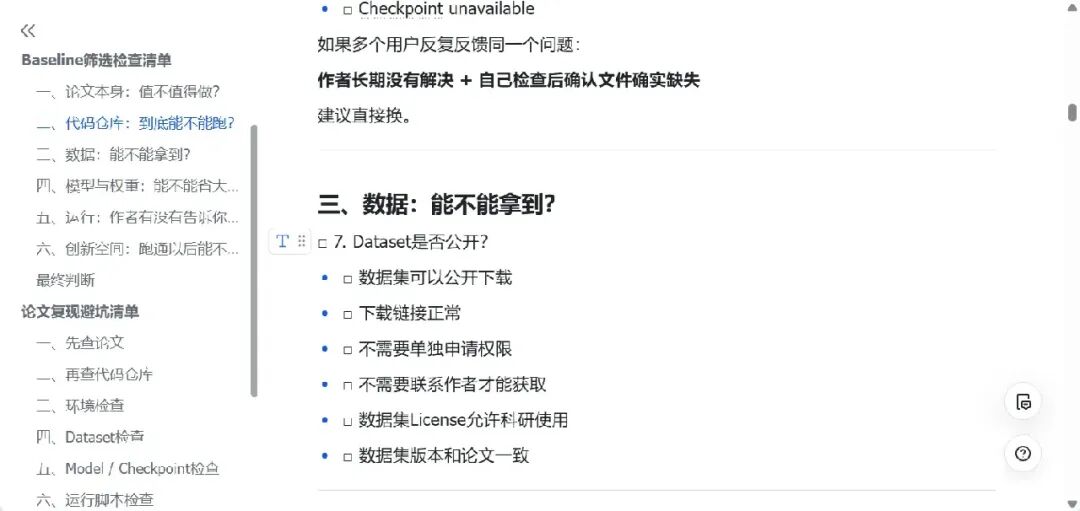 长按添加小享,回复【找baseline攻略】无偿获取
下面进入正题:
一、论文本身怎么选
1.优先近两年CCF A会,不优先A刊。因为期刊周期长,25年发的文章可能是22年的工作,你改它容易像在考古。会议通常更新鲜,baseline也更接近当前SOTA。
2.必须真实开源。不开源的文章,复现成本极高;代码能力一般的话,就别硬刚了。而且更现实的是,没开源的可能只是故事会,你连它到底怎么跑的都不知道。
3.框架尽量简单。如果它本身已经叠了一堆模块,你再去二次创新,网络会复杂到逆天,创新点也容易被淹没。简单框架才好加自己的东西,也才好讲故事。
二、再看能不能跑起来
上面调研完了,也别急着配环境。因为在代码、数据和运行环境里会很容易踩坑。所以我一般会再做一次复现前检查。
这部分我自己也整理了一份论文复现避坑清单,主要就是把代码仓库里最容易漏看的地方列出来。建议正式配环境前先过一遍。
1.看star。过三位数基本稳,两位数看命:可能能跑,也可能坑。虽说star少不一定差,但踩雷概率高。
2.看issue。重点搜“目录缺失”“文件找不到”“数据下载不了”。如果有人提了,作者没修,你点进代码目录也真缺,直接放弃,别当赛博义工。
3.看dataset。一定点进去看所有数据集能不能直接下载,还是要邮件申请许可。下不了的数据集,直接换。
4.看model是否开源且可下载。只有代码没有权重,有时也能跑,但训练成本、复现难度会飙升。权重能下,幸福感翻倍。
5.看训练/验证指令和sh文件。README写得再热闹,不如看有没有完整可执行的脚本。没有sh、命令残缺、参数对不上,基本就是猜谜游戏。
三、最后总结
好baseline=新、开源、简单、能下、能跑。五个里缺太多,就换,别恋战。战略上也不能懒惰,如果找到一个baseline就立刻配环境,等于把命运交给issue区。一定要先花半小时做筛选,避免你后面花三天debug。
当然,Baseline能跑起来只是第一步。真正开始做论文以后,很多人又会卡在另一个问题:跑通了,然后呢?到底从哪里改?
这个时候我自己会去参考一些涨点论文,重点不是照抄具体方法,而是看别人通常从哪里动手:结构、特征、注意力、损失函数、训练策略……
所以我也整理了一批比较适合用来找改进思路的涨点论文,可以在Baseline跑通之后继续拿来参考。



