刚刚,Anthropic 在工程博客上发了一篇长文,讲他们为什么、又是怎么把整个 monorepo 从 git 上迁走的。
原因在于这样的一组数字:今年 5 月,Anthropic 平均每天合并约 2500 次代码变更;到了 9 月,这个数字已经超过了每天 3 万次。
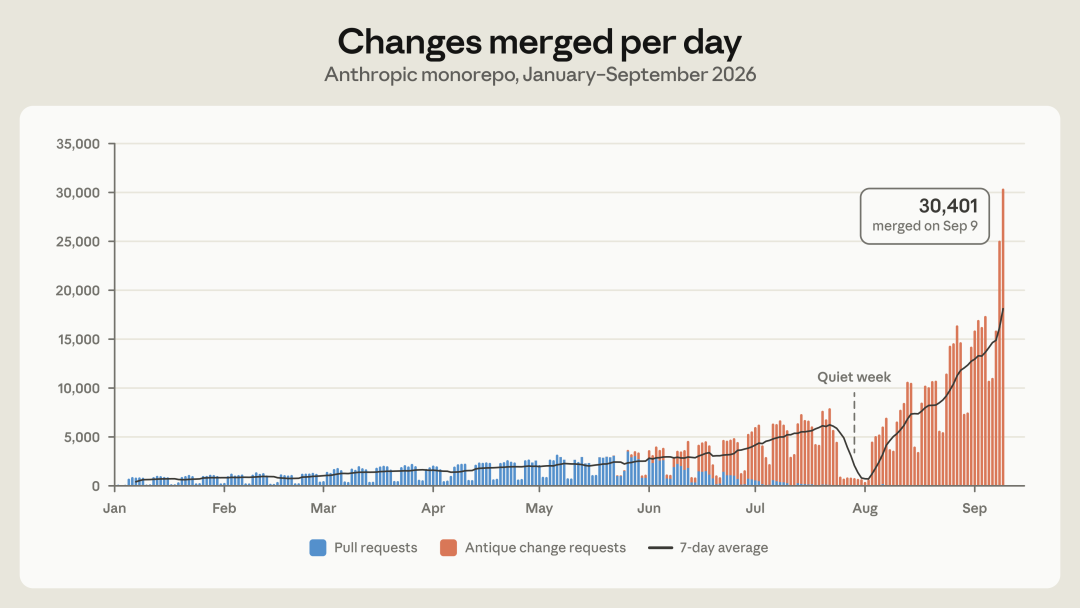 每日合并量
9 月 9 日这一天,单日合并了 30401 次。
按 24 小时平均下来,差不多每 3 秒就有一次代码合进主干……
而这条曲线的推手,正是 Claude。Anthropic 在文章开头写道:
在 Anthropic,写代码已经不再是构建系统和做研究的瓶颈。Claude 能够自主迭代研究循环、对复杂程序做微观优化、从零构建新服务,速度和规模都是我们前所未见的。现在的瓶颈,是所有那些为人类规模构建的开发者基础设施:源码控制、构建和 CI。
其中的源码控制,用的正是 git。
于是 Anthropic 花了五个月,自研了一套版本控制系统 Scion,并把整个 monorepo 从 git 完整迁移了过去。
同一时间段里,他们还做了代码评审工具 Antique、代码搜索、一套细粒度的源码权限系统,以及一批管理和合入大量已评审代码的新办法。
做完这些的,一共只有 7 个人。
回到上面那张图,从 1 月到 4 月,曲线一直在缓慢爬升,从每天几百次涨到了两千来次。
从 6 月开始,图里蓝色的 Pull requests 迅速被橙色的 Antique change requests 取代,到了 7 月几乎全是橙色,说明代码评审那时基本已经整体搬到了自研的 Antique 上。
7 月底、8 月初还有一周明显的低谷,图上标的是「Quiet week」,原文没有多做解释(大概是全员放假了?)。
而低谷过后,曲线几乎是垂直往上冲的。
Anthropic 预计这个增速短期内不会放缓,因为合并代码的潜在需求几乎是无限的,每移除一个瓶颈,代码产量就会立刻再往上涨一截。
他们也承认,这种负载非常特殊。
Anthropic 用 Claude 写代码的程度几乎超过任何一家公司,所以常常是第一个撞上「工具开始吃力」的地方,源码控制只是其中一个例子。
短期内不会有太多组织遇到同样的问题,但他们认为,其他用 AI 写代码的团队用不了多久也会碰上。
git 是一个分布式系统,每一份 clone 都是一个完整、独立的仓库,离线也能算 diff、看历史和 blame、checkout 任意版本。
对绝大多数仓库来说,这个设计是对的,也是 git 能成为行业标准的重要原因。
但 Anthropic 的 monorepo 已经越来越不适合这个设计了。仅 main 分支的历史就接近 100 GB,压缩后的工作副本超过 25 GB。
光 CI 每天就要 checkout 代码约 2500 万次,这还没算开发环境、Agent 沙箱和研究任务。
如果每次都老老实实全量拉取,每天的 git 流量会超过 600 PB。
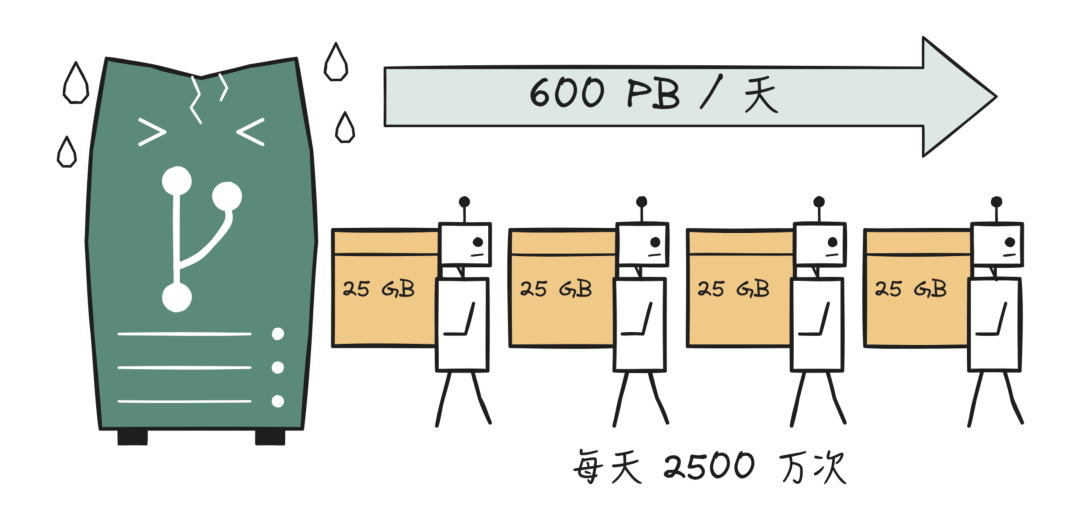 全量拉取的代价
git 本身有 shallow clone、sparse checkout、promisor remote 这些只取仓库一部分的手段,业内对付大型 monorepo 也有成熟的套路,比如内部 git 镜像,以及放在 blob 存储里的仓库快照(seed)。
Anthropic 把这些全都用上了,高峰时运营着几百台内部 git 镜像来扛负载。
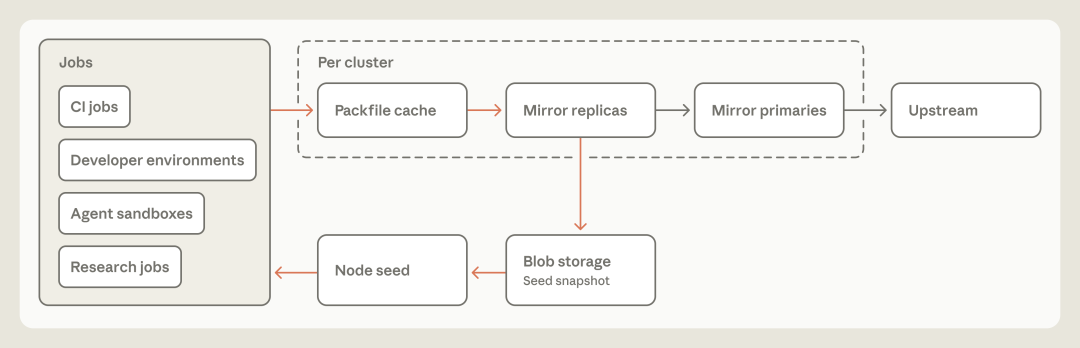 git 扩展方案
这些办法确实争取到了一些时间,但合并速度越涨,维护起来就越难。
两次刷新之间,seed 离 main 的最新提交越来越远;diff、blame 这类依赖历史的操作,要在 partial clone 上保持正常工作,也越来越费劲。
后来他们退一步看,才发现自己和大多数公司一样,其实是把 git 当成「只有一份权威副本」的中心化系统在用,而几乎所有客户端都是 Agent 和各种任务,天然就是在线的。
git 最擅长的分布式、离线工作,在仓库变大之后,反倒成了扩展的阻碍。
那么问题就变成了:如果从一开始就假设 Agent 永远在线,源码控制应该是什么样子呢?
超大 monorepo 的源码控制是有先例的,比较有名的是 Google 的 Piper 和 Meta 的 Sapling,Scion 也借鉴了它们用大量踩坑换来的经验。
在此基础上,Anthropic 定下了几条和 git 截然不同的原则。
这几条原则都从同一个前提出发:客户端永远在线。
git 假设客户端要离线工作,所以每个人手里都得有一份完整的仓库;Scion 则围绕一个始终可达的服务端来设计,需要什么数据,客户端再去取什么。
这也就带来了客户端和服务端的不对称。
在 git 里,每个客户端都有能力当一台完整的服务器;而在 Scion 里,查历史和 blame、创建提交、做 merge 和 rebase,统统由服务端完成。
客户端只维护一个有上限的本地对象缓存,把工作副本的文件放到磁盘上,监听文件系统的变化,再给用户提供一套好用的操作方式。它自己几乎算不了什么,换来的是本地需要的数据少得多。
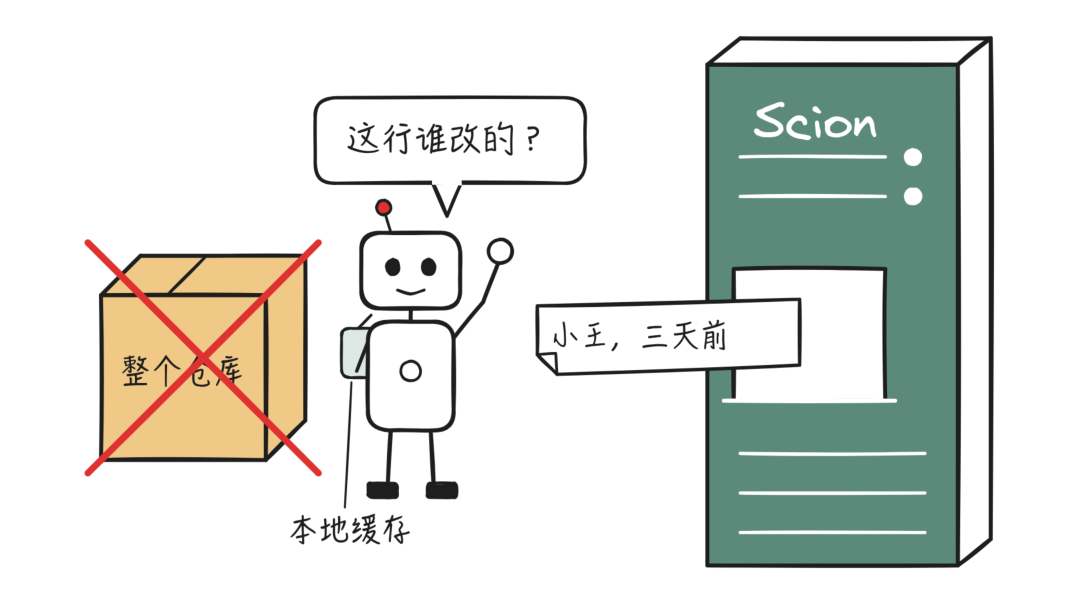 只问不搬
服务端既然什么都能回答,也就可以直接开放成 API。
用 git 的时候,CI 任务或工具想知道「这行代码最后是谁改的」「这两个提交是什么关系」,要么自己维护一份本地仓库,要么指望托管平台刚好提供了对应的 API。
在 Scion 里,客户端用到的所有查询都以 API 形式开放,很多任务根本不需要本地仓库。
Anthropic 内部的自动 bisect 和自动 revert 流水线,没有这种低成本、可编程的访问方式,规模一大就不现实了。
所有组件也都必须能水平扩展。
前面那几百台 git 镜像,一旦仓库大小超过镜像的磁盘或内存上限,就再也扩不动了。
Scion 的仓库数据是分布式存储的,每个组件都能独立扩展,任何地方都不存在一份完整的仓库,服务端上也没有。
Scion 里也没有 packfile 这类东西,所以不需要做仓库维护。
提交则要便宜、增量、无锁。
git 是先在本地 commit 再 push;Scion 的每次 commit、rebase、merge 都发生在服务端,没有什么需要 push 的,但每个操作都必须够快。
创建一个提交、更新它下游数据结构的开销,必须跟改动的大小成正比,而跟整个仓库的大小无关,否则服务端就跟不上。
也因此,Scion 的开发流程不鼓励使用 ref(main 和发布分支除外),因为需要所有服务器达成一致的全局状态,迟早会成为扩展上的隐患。
最后,工作副本是可选的,而且天生稀疏。
每天几千万次 checkout,能省则省:CI 想要某个提交和它 merge base 之间的 diff,直接问服务端就行,很多写操作也可以跳过 checkout,全程走 API。
真需要把文件放到磁盘上时,Scion 的协议以 sparse checkout 和虚拟化 checkout 为核心,前者只包含客户端要的目录,后者在文件被读到时才落盘,客户端只为它真正读到的内容付出成本。
Scion 里的基本单位叫 changeset,是预写日志里的一条记录,存的东西和 git 的 commit 大体相同。
只不过 git commit 存的是指向整棵树的指针,而 changeset 存的则是相对于第一个父提交改了哪些文件,以及指向 blob 存储中压缩文件内容的内容寻址指针。changeset 在服务端创建,创建好之后立刻处处可用。
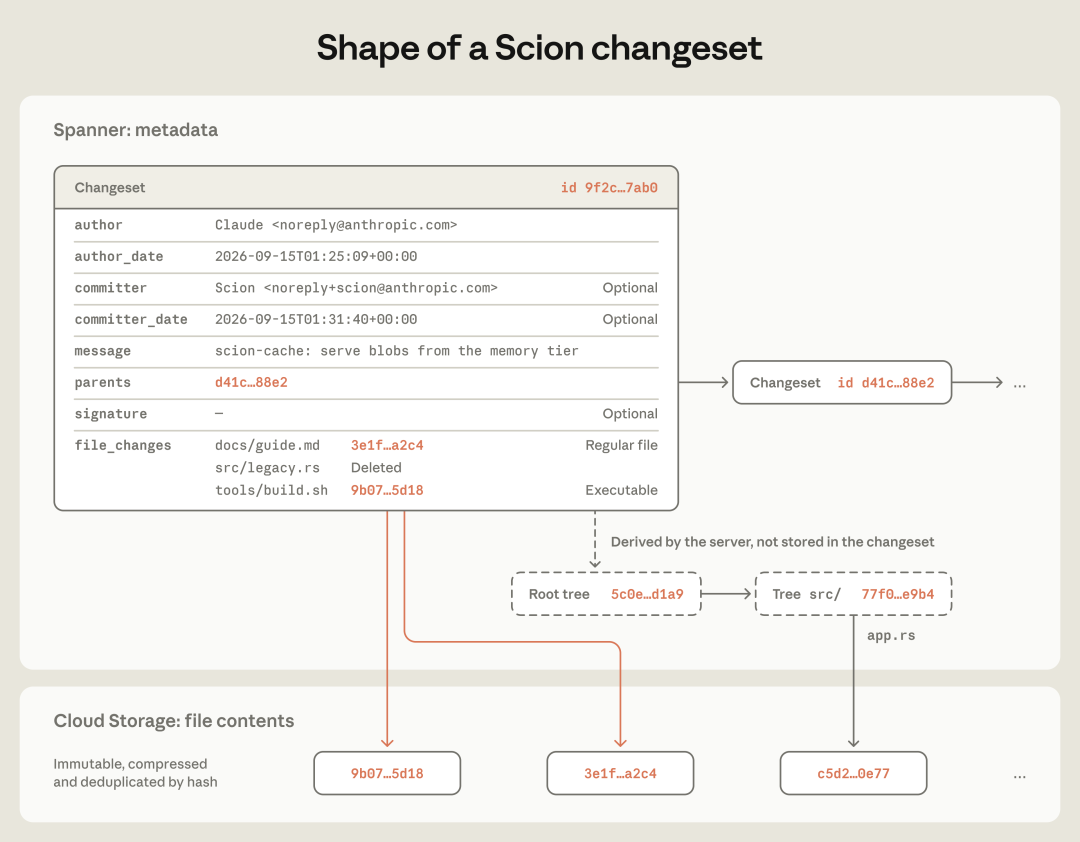 changeset 结构
(示例里这条 changeset 的 author 一栏,写的正是 Claude……)
没有 packfile 要接收,没有锁和跨服务器协调,也没有 ref 要移动,所以 Scion 接收 changeset 的吞吐量可以做得非常高。
Scion 技术上也支持 ref,但创建和获取提交都不涉及 ref。
移动一个 ref,只是对 Spanner 里的单行数据做一次 compare-and-swap,跟创建 changeset 是分开进行的。
只记录改动,也就意味着单靠 changeset 本身,没法快速回答「这一行最后是谁改的」「哪些提交动过这个文件」这类问题。
为此,Scion 会在 changeset 之上再构建一批数据结构,比如专门用于 blame 和路径历史的结构,以及提交图的跳表。
凡是不直接属于 changeset 的,都叫「派生数据」,统一由一套通用机制来计算。
每种派生数据都是递归定义的,某个 changeset 上的值,由它的父提交上的值算出来。
这样做有三个好处。想让某个操作更快,加一种新的派生数据就行;每一种都可以选择立即计算还是推迟计算,不需要的数据就不去物化;而客户端看不到这些数据结构的内部,优化它们也不用改客户端。
随着系统增长,他们已经加过很多次新类型,比如用来做复制检测、按路径搜索文件的新索引。
一小组 Scion 服务器对外提供客户端需要的所有源码控制 API,比如获取 changeset、计算 diff、查找 merge base、获取 blob。
所有数据都是内容寻址的,存进去就不会再变,任何一台服务器都能缓存,不用和其他服务器核对。
所以这些服务器可以水平扩展,几乎不需要协调,
说到底就是一组大缓存,同时还能现场计算派生数据,再写回 Spanner。
迁移早期,在还没有自己的客户端、仓库格式和协议的时候,Scion 只回答提交祖先关系、blame 这类「元数据」查询,这已经帮 CI 和各种工具省掉了自己拉取、维护仓库的大量负担。
而获取文件内容、生成工作副本,数据量要大得多,需要单独设计。
Scion 的客户端叫 scn,它的拉取协议和 git 有几处关键的不同,服务端因此比 git 服务器省下了大量 CPU。
git 协商时,客户端要告诉服务端自己已经有了什么;scn 则只说自己要什么。
它从根树开始,检查本地缺了哪些 tree 并递归请求,再对 blob 重复一遍。
每个请求都对应一个永远不会变的具体对象,任何一层缓存都能应答,整个架构和传统的分层缓存非常相似。
没有动辄几个 GB 的单个 packfile 响应,过程高效,也能断点续传。sparse 乃至虚拟化 checkout 也不需要特殊支持,客户端不请求它不要的树就行了。
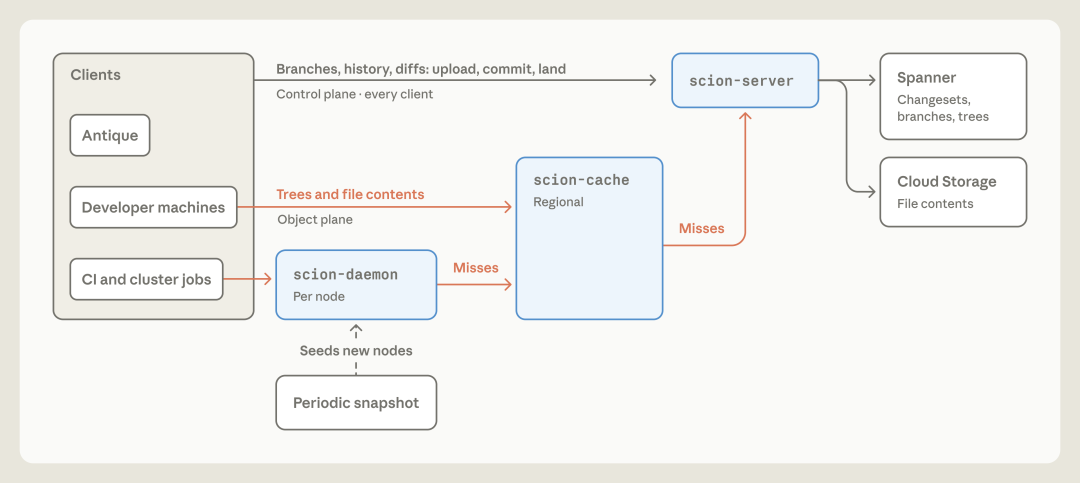 checkout 架构
在集群里,客户端通过 socket 和一个叫 scion-daemon 的守护进程通信,由它为整个节点存储对象,毕竟同一节点上的任务大多会复用相同的对象。
每个 daemon 从一份定期刷新的快照启动,之后只和所在区域的缓存服务器 scion-cache 通信。
scion-cache 直接从内存里以 daemon 可以直接使用的磁盘格式流式发送对象,不用计算客户端缺什么,也不用做 delta 压缩。
缓存里缺了某个对象,才去问权威的 scion-server,后者再按需读取 Spanner 或云存储。
三层都响应同一套 RPC,客户端不需要知道缓存的拓扑结构。
理论上任意两层都能直接通信,但他们严格执行分层,用来隔离故障域,避免某个区域的 scion-cache 出了故障,把上游的 scion-server 冲垮,进而拖垮整个系统。
最终,每一层的缓存命中率都在 99% 以上,而且不需要长期保存状态,扩容很容易。
Scion 基础设施的 CPU 和内存占用,只有之前 git 镜像方案的 1/200。
CI 和研究任务的 checkout 快了两个数量级,从分钟级变成了秒级,整个集群因此空出了一大块算力,光 CI 就拿回了 25% 的 CPU 容量。
客户端和缓存都不需要做仓库维护,任务的生命周期管理也简单了不少。
落到日常命令上,对比是这样的:
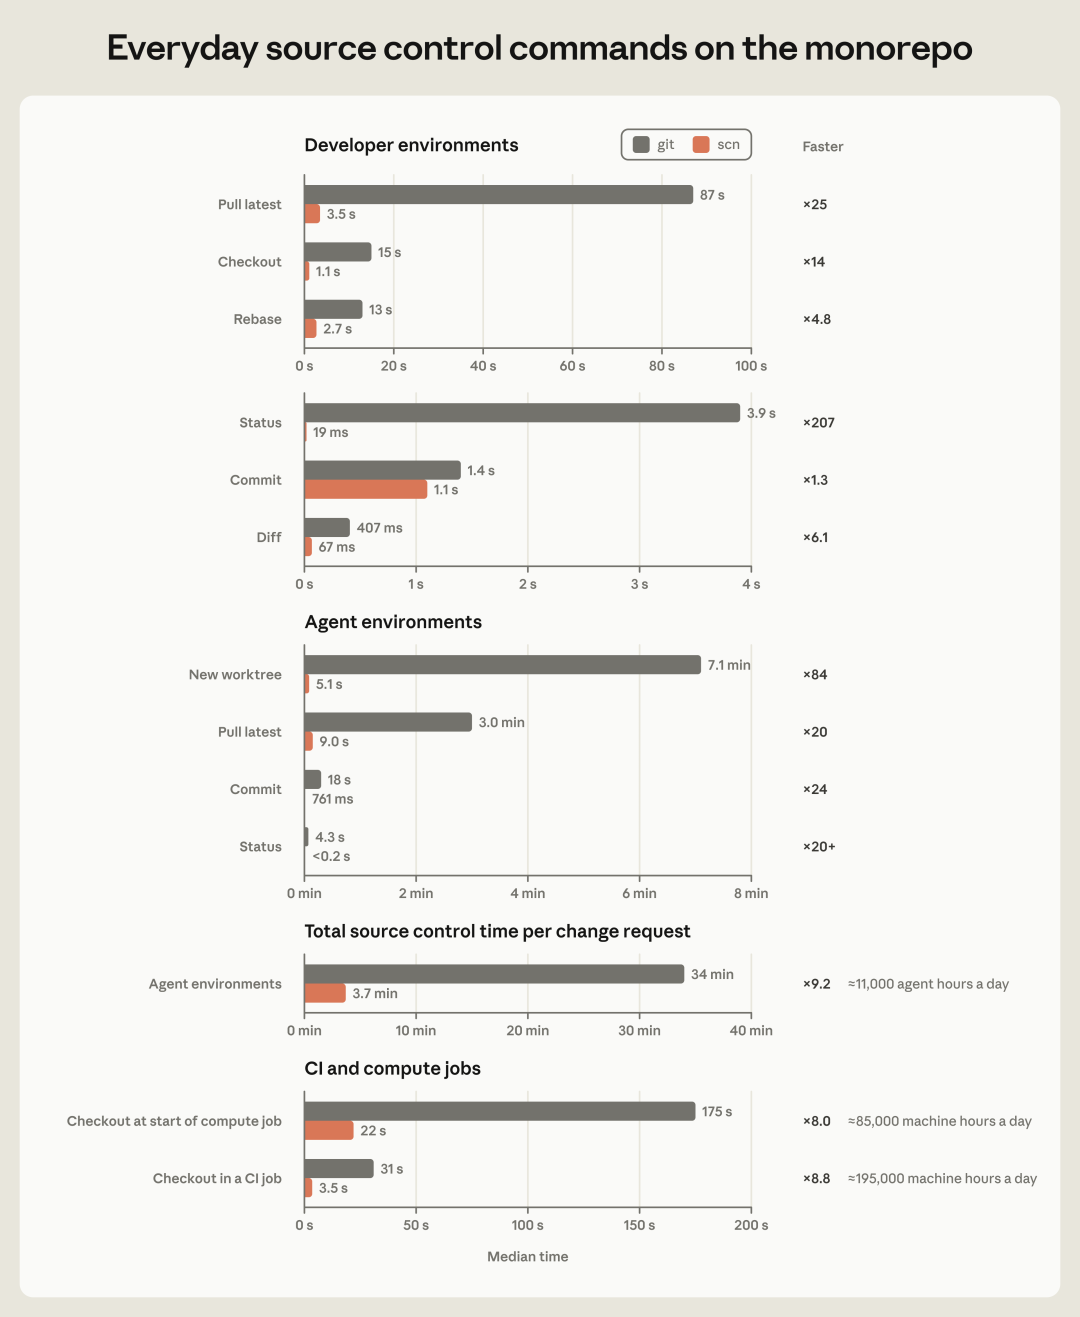 日常命令耗时
开发环境里,status 从 3.9 秒降到 19 毫秒,快了 207 倍,拉取最新代码则从 87 秒降到 3.5 秒(开发机上的 commit 倒是没怎么变,1.4 秒到 1.1 秒……)。
Agent 环境里,新建一个 worktree 从 7.1 分钟降到了 5.1 秒。
算下来,Agent 每提交一个变更请求,花在源码控制上的总时间从 34 分钟降到了 3.7 分钟,相当于每天省下约 1.1 万个 Agent 小时。
计算任务开始时的 checkout 和 CI 任务里的 checkout,也分别快了 8 倍和 8.8 倍,两项加起来,每天省下约 28 万个机器小时。
Scion 开工的时间,差不多正好是 Claude Mythos Preview 和 Claude Tag 在 Anthropic 内部上线的时候。
这两者一边放大了对 Scion 的需求,一边也大大加快了 Scion 的开发速度。
今年早些时候,团队基本是手写了第一版从 git 导入 Scion 的数据管道,作为原型,他们自认为写得还不错……直到拿到了 Claude Mythos Preview 的一个早期内部快照。
他们让它把整个管道重写一遍,没有给任何额外的指示,它交出的版本内存占用只有原来的 1/20,速度快了 4 倍,同时还保住了导入顺序和数据结构上那些没写明的不变量。
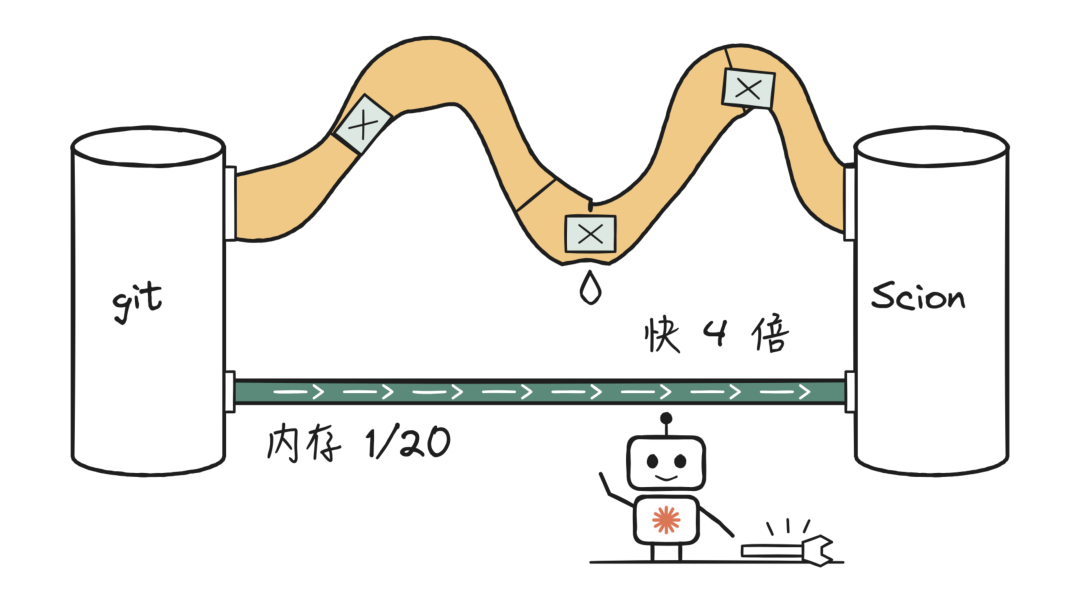 旧管道与新管道
下图是 Scion 和 Antique 两个代码库每周合并的变更数,今年以来累计 12257 次,9 月最多的一周超过了 1500 次。
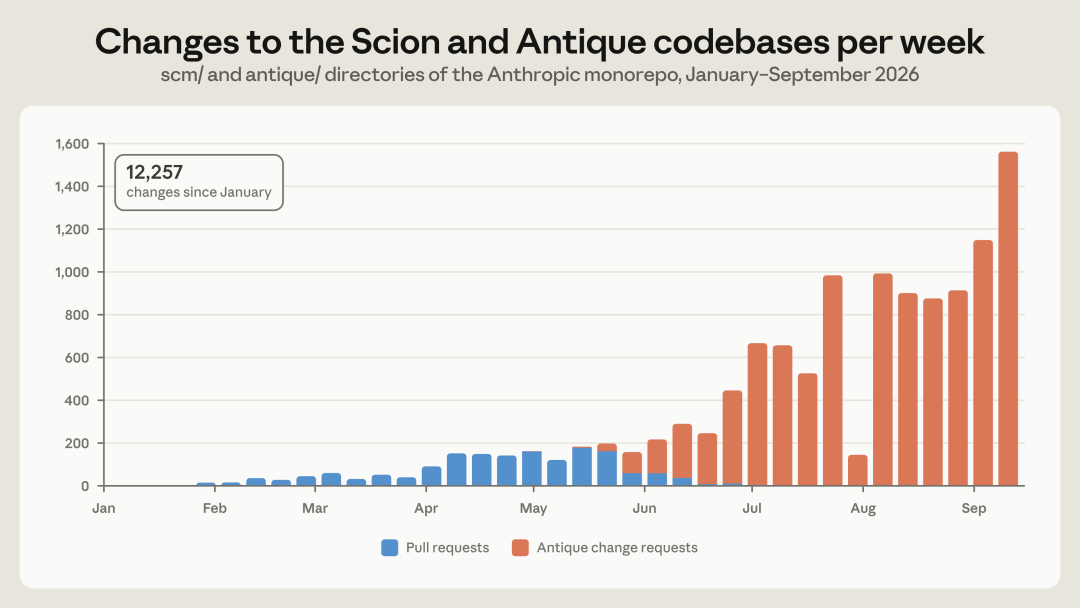 Scion 每周合并量
Scion、Antique,再加上另外六个左右的相关系统,是一个 7 人团队在 5 个月里做完并完成迁移的,而同期每天合并的代码量还涨了 10 倍(原文还特意提了一句,Antique 本身就值得再单独写一篇博客)。
Anthropic 认为,放在过去,开发和部署这样一套源码控制系统,一家公司要投入多得多的工程师,花上好几年做渐进式的迁移。
而这种小团队的快速迁移,以后会越来越常见。
参与这个项目的所有工程师,现在都认为 Claude 写代码比自己强。
但工程师依然不可或缺。他们提供的是对系统之间高层组件的理解,以及设计层面的取舍,判断要解决哪些问题、系统要撑到多大的规模。
而很多时候,工程师的工作,就是对 Claude 说「不」。
Agent 有时会为了满足某种本就不该被允许的模式,去违反系统的核心约束,这在迁移过程中尤其常见。
比如有好几个系统想知道某个变更是什么时候合进 main 的,不去问代码评审工具,而是暴力地把提交日志线性读一遍。
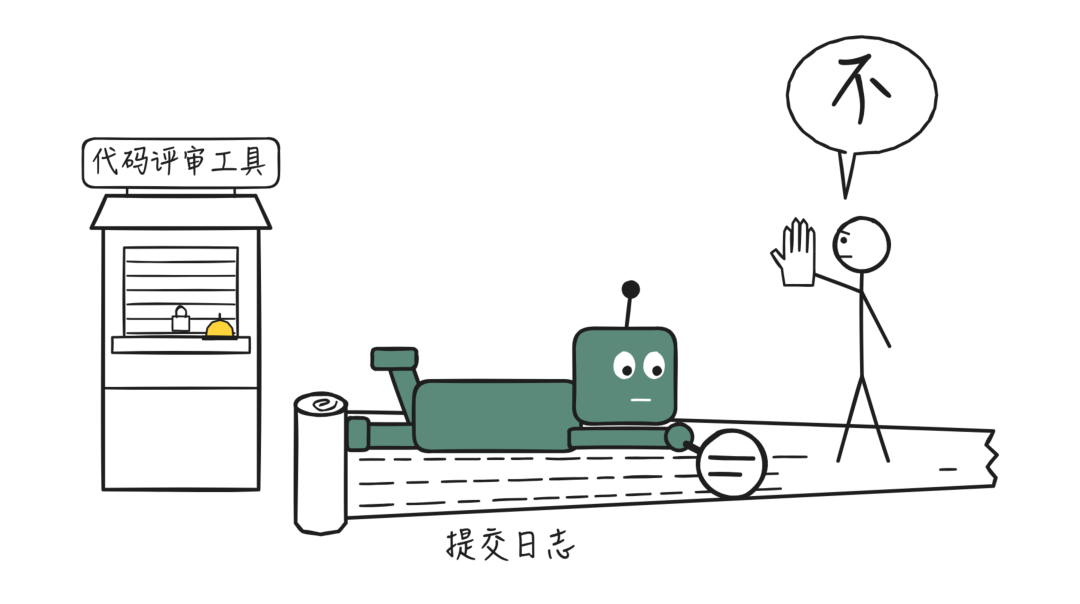 本该去问评审工具
Anthropic 内部还大量使用对抗式评审。这在很多方面非常有效,但也可能目光短浅,需要有经验的工程师把 Claude 拉回来,别为了一些假想的风险过度设计。
有一次评审对另一个内部服务的信任过于保守,结果 Claude 就加了一堆多余的校验和复杂度。
现在团队依然会评审这个系统的每一个变更请求,只是看的是变更的意图,不再逐行读代码。
也正因为 Claude 能以远超人类的速度写出大量代码,Scion 成了他们做过的测试最充分、防护最严密的代码库之一。
即使工期很紧,他们也为遇到过的每一种稍复杂的基础设施和源码控制交互都搭建了封闭式模拟,另外还做了 fuzzing 和精细的限流。
Claude 还会随手找出一些重大优化,比如发现某个祖先查询的算法没用上一个索引,这种问题专家得花几天甚至几周去分析调优……然后第二天,它又这么来了一遍。
安全上,Scion 支持仓库级的细粒度访问控制,还能给单个目录设置权限,把最敏感的代码保护起来,同时不丢掉 monorepo 的好处。
配套的代码评审工具则能对审批设置复杂的语义约束,比如区分只改注释的变更和敏感的逻辑变更,让人类评审者把精力放在最要紧的改动上。
运维上,团队重度使用 Claude Tag。
他们建了一些 Slack 频道,让每个频道里的 Claude 只专注于一个组件的健康状况,并管这些 Claude 叫「superfan」。
scion-daemon 有一个 superfan,scion-cache 有一个,Antique 的合并队列也有一个……它们能访问遥测数据和日志,就像一个除了刷新图表、找异常之外无事可做的资深工程师。
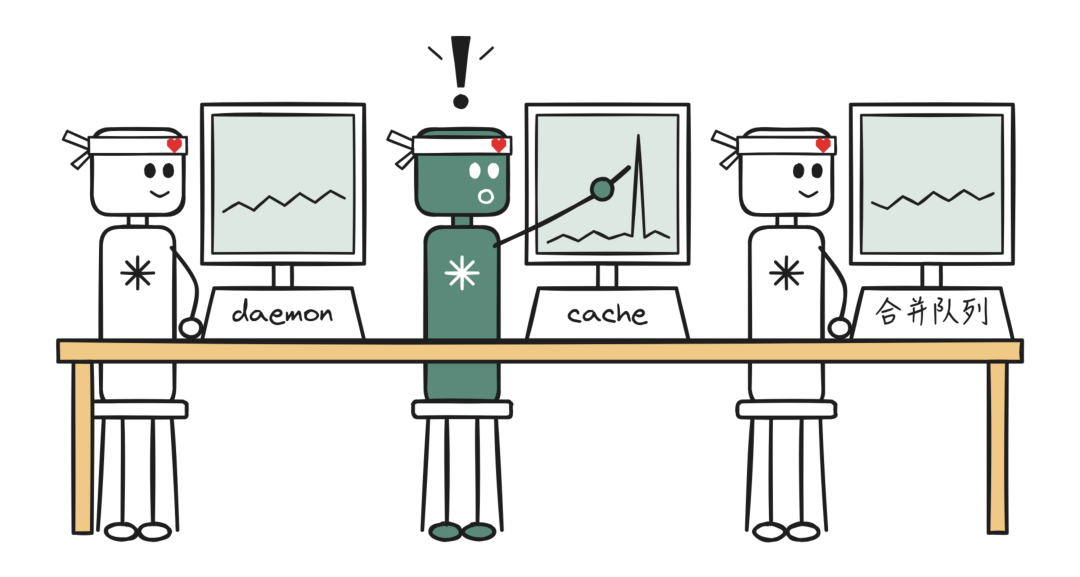 每个组件一个铁粉
传统告警当然也都还在,但 superfan 能发现那些细微而新奇的问题,相比之下,传统告警就显得太单一了。
这个项目也让他们重新审视了其他为人类规模设计的流程,比如合并队列,在 Agent 规模下就没什么意义了。
测试还在跑的时候,可能已经有成百上千个变更合了进去,那 CI 到底还意味着什么呢?
业界的标准做法,是在合并队列上加一把全局仓库锁,而他们没能有效复刻这一套,于是转而把精力投到了合并后、部署前的自动化测试上。
这确实意味着并发的变更可能会冲突,但 Claude 修冲突的速度,通常比人类发现冲突还快。
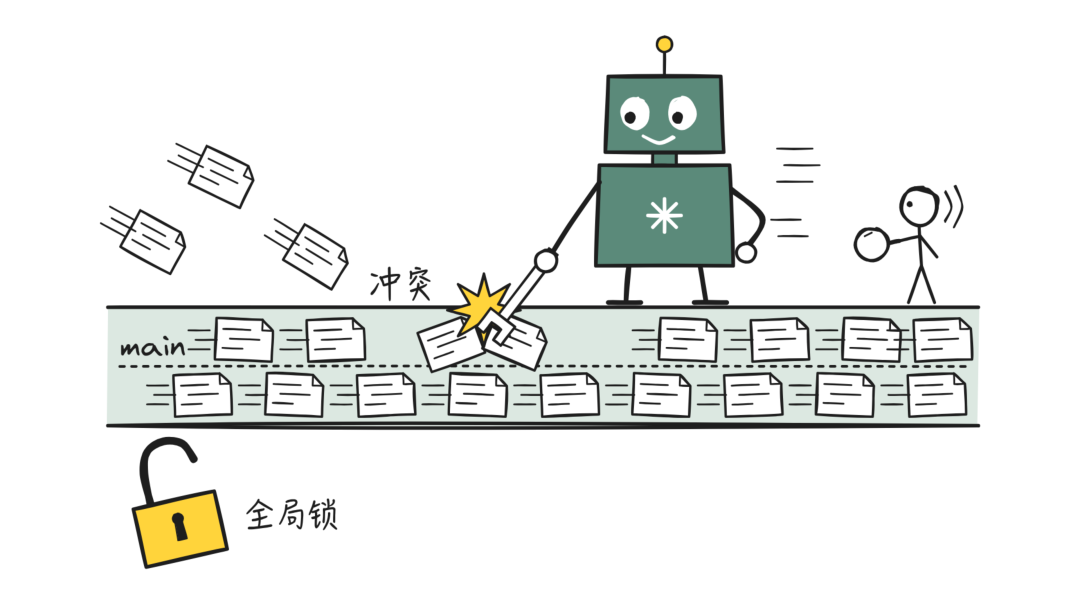 冲突当场修好
Anthropic 在文中明确表示,Scion 绝不是 git 的通用替代品。
这些设计只对真正巨大的 monorepo 有意义,要么有数万名工程师,要么有成群的 Agent 在大量写代码。
而且 Anthropic 本身也很特殊,内部花在 token 上的钱,远超任何一家正常企业愿意花的数目,一来是满足自己的开发需要,二来也是在测试 Claude 的能力。
至于为什么不对外提供,是因为 Scion 和 git 差异太大,别的公司要用,就得把整个开发流程都迁过去,还要配套它自己的代码评审、代码搜索和 CI。
这些内部组件都高度定制,别人很难直接拿来用,而做一个想讨好所有人的公开版本,大概也不会真的好用。
但他们预计,未来 6 到 12 个月里,这类问题会变得越来越普遍,让每家用 git 的公司各自去扛,是对工程资源的浪费。
所以他们选择把思路分享出来,让其他开发者可以把 Scion 最成功的部分用到 git 上,而不必放弃 git 的整体模型。
原文给了这样一些方向:
• git 服务端不必和客户端用同样的方式工作,已经有新的服务端架构能显著提升扩展性
• git 平台可以像 Scion 那样提供全面的服务端 RPC,甚至在各家代码托管平台之间形成标准,让 git 客户端学会去调用
• 协商协议也不必是现在这个样子
• git 里各种 sparse 和 shallow 功能,可以做到更好地组合使用
文末,Anthropic 也表示,git 社区花了近 20 年为数百万开发者扩展这个平台,相比之下,他们的贡献要窄得多。
他们只是分享一些对「Agent 写代码如何冲击这些系统」的早期观察,希望和 GitHub、GitLab 以及开源社区一起,去支持开发者正在变化的需求。
X 上已经有人把这条曲线和 GitHub 最近频繁出故障联系到了一起……
而如果 Anthropic 那个 6 到 12 个月的预判没错,接下来要为这种增长头疼的,大概就不只是 Anthropic 自己了。
◇ ◆ ◇
https://www.anthropic.com/engineering/redesigning-source-control



