论文主体写完了,导师看完评价“工作量有点不够。”所以到底是该补实验、改模型,还是重新找研究方向?
我的建议是,不要盲目加模块、跑实验,你可以尝试从这三个方面排查:研究改动太少、实验验证不充分、已有工作没有充分呈现。每个对应的补充思路完全不同。
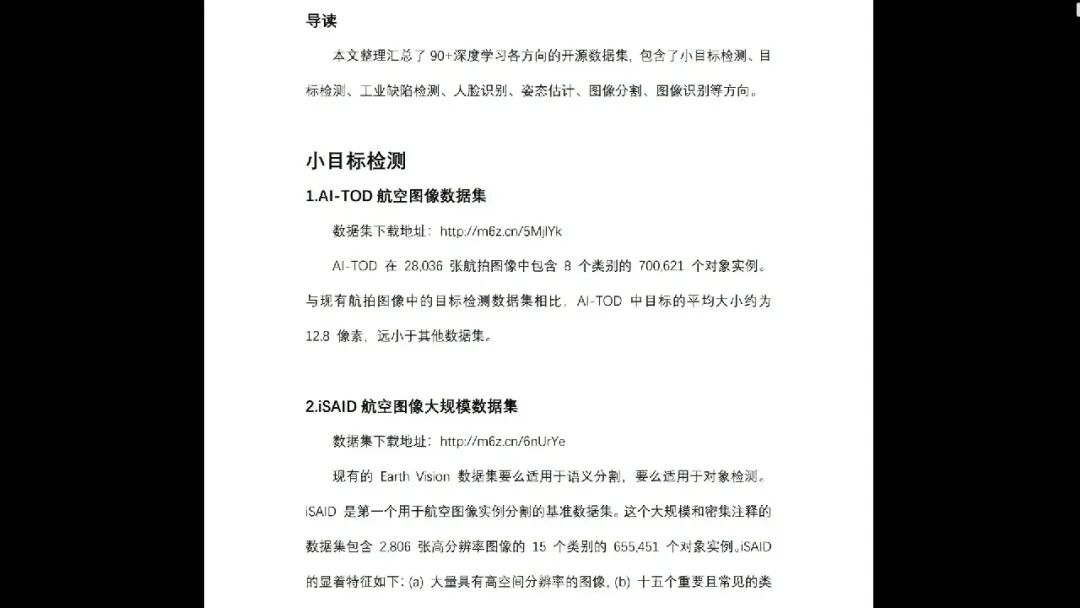
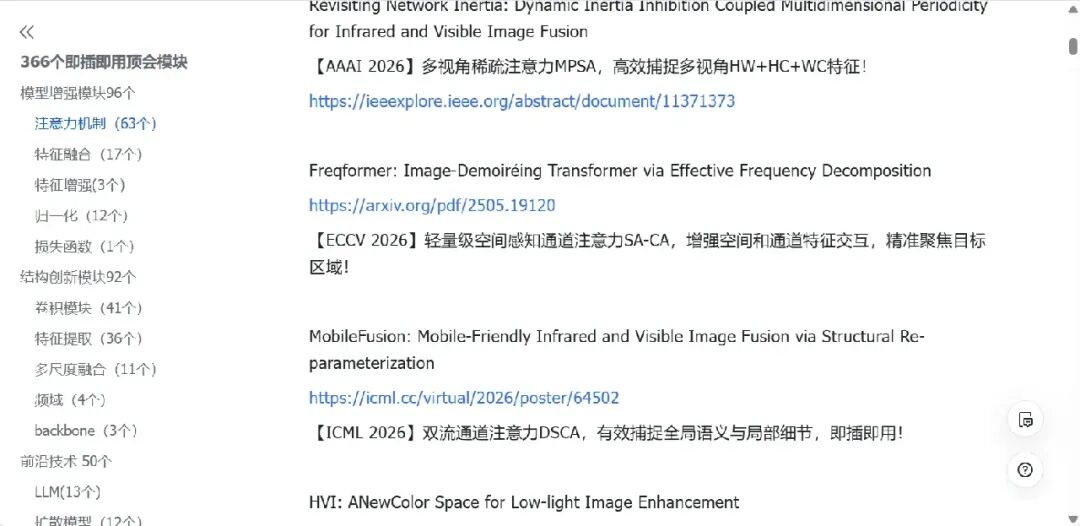
今天就和大家分享一些经验,同时也整理了两类实用资料:90多个深度学习公开数据集,按任务类型分类,方便寻找合适的数据补充实验、验证模型泛化能力;399个即插即用模块,按照改造位置分类,可以参考不同网络结构的设计思路,寻找模型改进方向。
需要的可以先领,后面会讲到具体用途。
第一步:先判断究竟缺在哪里
判断方法不难,翻一下自己的实验章节:
- 只有一个数据集、一套实验设置,缺少消融和对比:实验验证不充分。
- 实验做了不少,但方法基本只是简单拼接已有模块:研究改动不足。
- 实验结果已经比较完整,却缺少特征可视化、案例分析等:已有工作没有充分呈现。
注意,实验数量多不等于工作量足够,关键是每组实验能不能回答一个具体的研究问题。
第二步:实验不充分,就从验证维度扩展
可以考虑增加不同数据集测试、跨域泛化实验、不同Backbone对比、消融实验和典型案例分析。
比如目标检测模型在自然光数据集上效果不错,但换到红外场景就明显掉点,这时候就可以进一步研究模型在不同成像条件下的适应能力。
但前提是任务和数据确实匹配。如果手里缺少合适的数据集,可以参考我整理的90多个公开数据集,按任务类型分好了,多数据集和跨域测试都能直接挑。
第三步:研究改动太少,就重新审视模型结构
一个常见的误区是把“在baseline里拼了两个顶会模块”当成工作量,这种在答辩时很容易被问住,因为本质上是拼接。
更稳的做法是往模块内部改:比如原方法采用串行特征融合,你可以分析它在多尺度信息交互上的不足,再尝试并行融合、残差连接等结构,比较不同设计的效果。重点不是改得多复杂,而是能不能说明原结构存在什么问题,你的改动为什么有必要。
这里可以用到399个即插即用模块,它们按改造位置分了类,你可以在同一个位置上找同类结构做对照,看别人试过哪些变体。
第四步:已有实验没体现出来,就补充分析
如果数据已经有了,不一定非要重新训练。
最省事的两个补法:用t-SNE或者UMAP把中间层特征画出来,说明你的模型把类别分得更开;再挑几个baseline做不好、你的方法做得住的样本,做成case study。
这两个都不是凑数,前提是差别真实存在。只能靠挑样本才看得出优势的话,写进去反而会被追问。
最后,毕业论文工作量不够,最忌讳的就是为了增加工作量而盲目堆实验、拼模块。先找到真正缺失的环节,再利用参考数据集、网络结构和已有论文寻找合适的补充方向,往往比一味增加实验数量更有效。
如果你现在也卡在毕业论文工作量不足,不妨先对照这三个方面检查一下。90多个公开数据集和399个即插即用模块也已经整理好了,需要的可以领取一份,后续找实验数据、参考网络改进思路都能用得上。



