11 月 5 日消息,OpenAI 正式发布新一代图像生成模型 ChatGPT Images 2.6。这次升级不仅让 AI 生图速度进一步提升,还为 ChatGPT 带来了一项新能力:用户只需输入一句提示词,或者上传一张照片,就能直接生成 GIF 动图,并对动画速度和单个画面进行编辑。
按照 OpenAI 公布的数据,Images 2.6 的图像生成速度相比此前提升了 50%。其中,面向开发者推出的 GPT-Image-2.6 Flare,在低画质设置下最快只需 6 秒即可生成图片。另一款 GPT-Image-2.6 Sunburst 则更注重图像质量,以及多轮编辑过程中的一致性。
此次更新同时覆盖 ChatGPT、Codex 和 API。OpenAI 表示,Images 2.6 已于美国当地时间 11 月 4 日面向全球推出,覆盖所有订阅档位,支持网页端、桌面端及移动端。
值得注意的是,OpenAI 还披露了一组最新数据:目前,用户通过 ChatGPT、Codex 和 API 每周生成的图片数量已达到 40 亿张,平均每天超过 5 亿张。而今年 9 月,这一数字还是每周 30 亿张。
两个月不到,OpenAI 的周图像生成量就增加了约 10 亿张。
当 AI 图片生成已经成为高频需求,OpenAI 这次选择继续在生成速度、图像可控性和动态创作上发力。
一句话生成 GIF,ChatGPT 开始让图片“动起来”这次 Images 2.6 最直观的变化,是让 ChatGPT 原生支持 GIF 动图生成。
此前,用户可以通过 AI 生成多张连续画面,再借助其他工具合成为 GIF,但 ChatGPT 缺少从文本指令到可编辑动图的一步式生成流程。
如今,用户可以直接向 ChatGPT 描述想要的动画效果,也可以上传一张已有图片,让其中的人物、动物或者其他物体动起来。
例如,OpenAI 展示了一个非常简单的提示词:“Can you make a gif of a cat dancing?”
也就是“你能生成一个猫咪跳舞的 GIF 吗?”
ChatGPT 不仅能够生成对应的动画,还允许用户调整播放速度、逐帧查看画面,对其中某一帧进行修改,并分享最终生成的 GIF。
在官方发布的案例中,OpenAI 展示了动画表情、品牌角色和创意视觉内容等不同使用场景。
对于社交媒体创作者而言,这意味着表情包、循环动画和短内容素材可以直接通过自然语言生成;对于品牌营销团队而言,也可以尝试将静态产品图转化成动态展示素材,而不必从头制作动画。
OpenAI 还特别提到了动画分镜的应用。例如,在正式制作视频之前,创作者可以利用 GIF 探索角色的动作和表情,让原本静态的设计概念具备一定的动态表现力。
图像创作平台 OpenArt 的联合创始人兼 CEO Coco Mao 对此次升级表示,GIF 是社交媒体的一种原生表达语言,而 GPT-Image-2.6 让创作者只需一条提示词,就能使用这种语言进行创作。
不过,GIF 与完整的视频生成仍存在明显区别。前者更适合短时、循环式动画,后者还需要解决更复杂的时序连贯性、镜头运动与长时间内容生成问题。因此,Images 2.6 增加 GIF 能力,并不意味着它已经具备完整的视频生成能力。
除了 GIF 功能,Images 2.6 的另一项重点升级是生成效率。
OpenAI 宣布,新版本的图像生成速度整体提升 50%,并针对不同需求推出了两款 API 模型:GPT-Image-2.6 Flare 和 GPT-Image-2.6 Sunburst。
其中,Flare 主要面向需要快速生成和反复修改图片的场景。在低画质设置下,该模型最快可在 6 秒内生成图片。
对于海报设计、产品展示和其他专业视觉内容,OpenAI 表示,Flare 还改善了图像布局质量。这意味着,开发者可以尝试通过更短的生成周期完成多次设计迭代,而不必每次修改都经历较长时间的等待。
Sunburst 则更注重高质量图像生成。
按照 OpenAI 的介绍,在中、高画质设置下,Sunburst 能够提供更丰富的画面细节、更高的视觉精度,以及更好的多轮编辑一致性。
所谓编辑一致性,是指在用户反复修改图像的过程中,模型能够尽可能保留原有角色、产品和品牌的关键特征,避免修改局部内容时,其他不相关区域也发生明显变化。
这也是当前 AI 图像生成工具面临的一个实际问题。
例如,一张产品广告图已经确定了品牌标识、产品外观和整体构图,设计师只希望更换背景或调整人物动作。如果 AI 每次修改都重新生成一张视觉细节不同的图片,就很难真正进入专业设计流程。
此次升级中,OpenAI 强调了角色、产品和品牌元素在连续编辑中的稳定性,并将其作为专业视觉生产能力的重要组成部分。
不只是生成图片,OpenAI 还想让 AI 参与设计流程值得关注的是,Images 2.6 还新增了面向开发者的图像编辑与输出能力。
首先,原本已经在 ChatGPT 中提供的图像标注功能,被进一步引入 API。
开发者可以利用图像标注,更明确地指出需要修改的具体区域,而不只是依靠文字描述告诉模型哪里需要调整。
例如,设计师可以在一张产品宣传图中指定局部元素,再要求模型修改颜色、布局或其他细节。
其次,Images 2.6 支持 SVG 导出。SVG 是一种基于矢量图形的格式,能够适应不同尺寸的展示需求,广泛应用于网站、应用程序界面和印刷设计等场景。
相较于只能导出普通位图,增加 SVG 输出意味着 AI 生成的设计内容可以更方便地进入后续制作流程。
另一个值得注意的更新是新增了 complexity 参数。
该参数允许开发者控制模型为完成图像任务投入多少规划工作。对于简单、快速的修改,可以使用较低的复杂度设置;对于元素众多、约束条件复杂的画面,则可以提高复杂度。
OpenAI 建议,大多数普通图像编辑任务可以采用低复杂度设置,并根据实际需求调整图像质量。对于复杂场景,则可以尝试中、高复杂度。
这次更新也意味着,OpenAI 不再只强调生成图片本身的视觉效果,开始尝试让图像生成模型更深入地参与设计工作流。
在官方公布的早期合作案例中,Figma Weave 创意总监 Itay Schiff 表示,GPT-Image-2.6 将生成速度和创作控制结合起来,同时帮助用户保留角色、产品或品牌的关键细节。他还透露,新模型将被引入 Figma Weave。
图片编辑平台 Picsart 也参与了此次模型的早期体验。Picsart 负责市场拓展的 Davit Avoyan 表示,新模型在生成速度、结果准确性和角色一致性方面的改善,可以让创作者把更多时间用于尝试不同方案和完善作品。
随着新模型上线,OpenAI 也公布了开发者 API 的定价。按照官方标准价格,两款模型采用相同的 Token 计费方式:
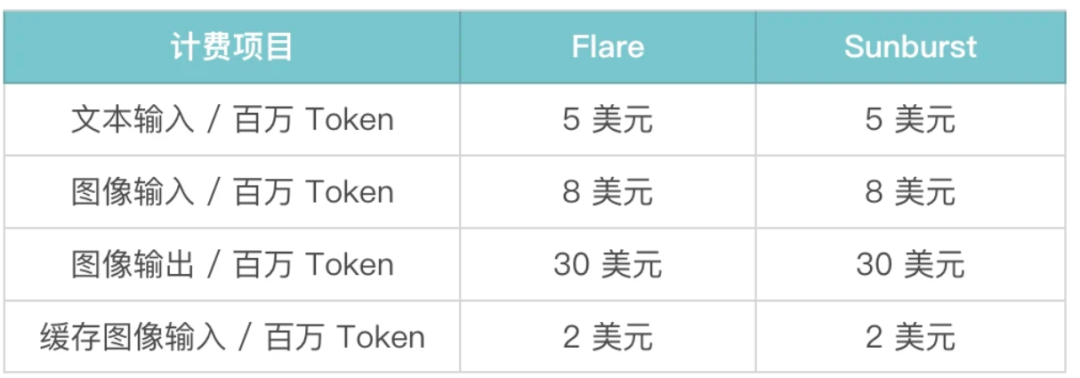
从公布的标准价格来看,Flare 和 Sunburst 并没有通过不同的 Token 单价进行区分,而是分别面向快速迭代和高质量生成场景。
新模型发布后,社交平台上也迅速出现了不少开发者和创作者的实测分享。
从一句提示词生成 GIF 动图,到上传静态图片让人物或物体动起来,再到测试复杂画面生成、多轮编辑和角色一致性,网友们开始用各种脑洞大开的提示词探索 ChatGPT Images 2.6 的能力边界。
一款图像模型究竟有多强,不能只看几张令人惊艳的作品。 尤其是这次 OpenAI 强调的生成速度、编辑一致性和 GIF 动画能力,仍需要通过不同场景下的实际测试来检验。接下来,不妨看看第一批尝鲜的网友,究竟用 ChatGPT Images 2.6 玩出了哪些新花样。
甚至有网友在 ChatGPT Images 2.6 身上看到了 Sora 的影子。
从网友的第一轮实测来看,ChatGPT Images 2.6 确实让 AI 生图变得更快、更有趣,但距离真正好用,仍有一些问题需要解决。
尤其是 GIF 动图功能,单帧画面足够精美,并不意味着连续播放就能自然流畅。人物动作是否连贯、背景是否稳定、不同画面之间能否保持一致,都是比生成一张漂亮图片更复杂的挑战。
这也反映出 AI 图像生成正在进入一个新阶段。当生成一张好看的图片不再稀奇,用户开始期待 AI 能够精准修改、稳定复现,甚至让画面自然地动起来。
对于 OpenAI 而言,Images 2.6 的意义或许不只是让生图速度提升 50%,而是试图让 AI 从一次性的图片生成工具,变成可以反复修改、持续创作的视觉助手。
至于它能否真正胜任专业创作,还得看模型能不能经得起用户一帧一帧地挑毛病。
参考链接:
https://openai.com/index/introducing-images-2-6/
https://x.com/OpenAI/status/2118124944928432327
声明:本文为AI 前线原创,不代表平台观点,也不构成投资建议,未经许可禁止转载。



