
挚文集团是一家专注社交娱乐领域的全球化互联网公司,旗下有陌陌、探探等国内社交产品,以及多款覆盖海外市场的社交产品。本文基于挚文集团资深工程师李想在 TiDB 社区活动北京站的现场演讲,介绍挚文集团从 MySQL 分库分表走向 TiDB 实时统一数据平台的实践。
挚文集团的业务分布在国内和海外两个市场。国内是陌陌和探探,海外有 SoulChill、Amar、MiraiMind 等产品,覆盖中东、欧洲、东南亚等多个地区。社交业务的共性是对实时性要求高——用户发了动态、送了礼物、下了订单,数据需要即时可见。
原来的架构跑在 MySQL 上。不同业务线部署在不同的 MySQL 集群里,数据量大的做分库分表,离线分析走实时数据同步工具同步到 Hive,T+1 出结果。随着海外业务快速增长,架构瓶颈逐个暴露出来。
/ 相关业务几十套集群,跨库查询曾是“奢望” /
李想将原有架构的痛点拆成了几类。
架构复杂度在业务增长中不断推高。MySQL 分库分表、消息队列、中间件、离线数仓——组件越来越多,链路越拉越长,系统间的依赖关系越来越复杂。
实时分析能力跟不上。“MySQL 核心数据通过传输工具导入 Hive,这个是有时间过程的。随着每天数据量增长,传输延迟越来越长。对一些实时业务分析场景就不太能满足了。”
数据孤岛问题突出。不同的 APP、不同的业务线有多套 MySQL 集群,跨库查询一致性难以保障。
MySQL 自身的扩展能力也到了瓶颈。垂直扩展方面,单机 CPU、内存和存储规格有上限,主库压力越来越大却难以扩容。水平扩展方面,“从两分片扩到四分片,前端的 proxy 路由规则也要跟着改造,严重拖慢产品迭代节奏。”大表 DDL 引发主从延迟、运维成本高,也是长期存在的问题。
/一套 TiDB,实现 OLTP 与 OLAP 混合负载/
在数据库选型过程中,挚文集团主要从四方面考量,最终选择 TiDB:
HTAP 融合能力。“一套数据库就能满足部分在线业务和实时分析需求。”
MySQL 兼容性。从 MySQL 迁移到 TiDB,业务层面语法语义基本不需要改动,可能只改一个连接串。“改造成本相比其他方案非常低。”
灵活的水平扩展能力。MySQL 扩展分片或垂直扩展资源需要做主从切换,对核心业务有影响——切换期间主库有段时间写不进去数据。TiDB 想扩计算资源就扩 TiDB 计算引擎,想扩存储就扩 TiKV 行存引擎,不需要切换。
分布式 SQL 处理能力。借助查询优化器和算子下推,能够充分发挥整个集群的计算能力,解决 MySQL 分析查询被单机硬件资源约束的痛点。
/两个真实应用场景/
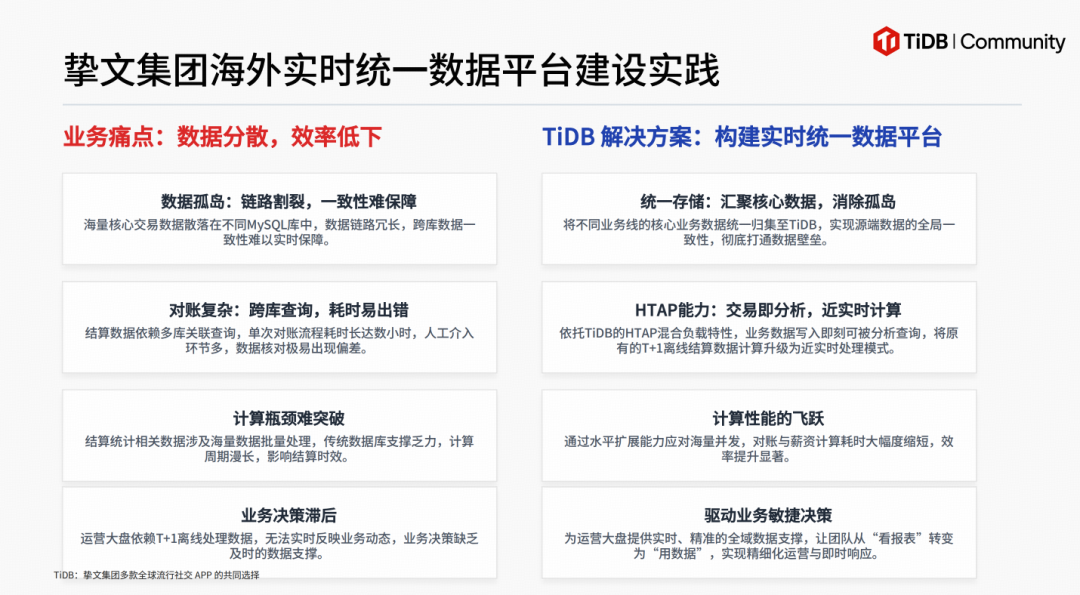
场景一:海外实时统一数据平台
挚文集团的海外业务曾面临数据库部署分散、跨库查询困难等问题。业务想做实时数据分析和运营类查询,但不同业务线部署在不同 MySQL 集群里,跨库查询一致性难以保障。
TiDB 被用于构建海外实时统一数据平台,在多可用区部署,每个可用区有各自的冗余资源。数据同步通过 TiDB DM 完成——小表用全量加增量导出,上 TB 级的大表用 Dumping 导出全量数据再写入 TiDB,增量数据走 DM,数据校验用 sync-diff-inspector。
场景二:SPAM 审核系统
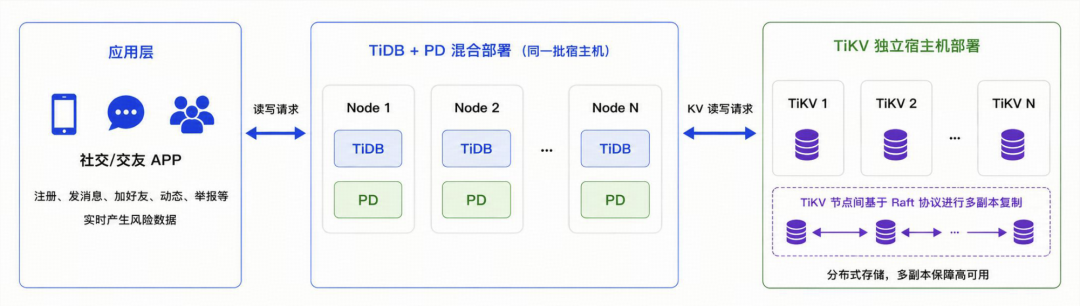
挚文集团该审核系统对实时性和可用性要求很高——数据不可用会影响 SPAM(垃圾内容检测审核系统)和其他用户数据的安全性。
之前用 MySQL 时,主库宕机后通过备份恢复一个节点,周期非常长。而 TiDB 的水平扩展能力让团队只需要扩展 TiKV 就能应对审核订单量的增长。
/迁移中的四道保险/
挚文集团的迁移注重校验闭环,李想分享了四层保障。
第一道,结构校验。对比上下游表结构、字段类型、索引约束。TiDB 和 MySQL 基本完全兼容,但要注意聚簇表和非聚簇表的差异——做数据校验时可以关注主键类型和索引结构的一致性,重点核对关键字段和索引。
第二道,数据校验。采用三层策略:表行数对比、抽样数据对比、全量数据校验。“全量数据校验是最复杂的。存量数据可以用工具对比,但增量数据建议工具加业务双重验证。”
第三道,业务校验。这是特别强调的部分。“增量的数据校验,光靠工具不够。核心业务数据如果不正确,可能造成资损。”具体做法包括核心业务 SQL 结果对比、每天业务对账、关键指标对比。
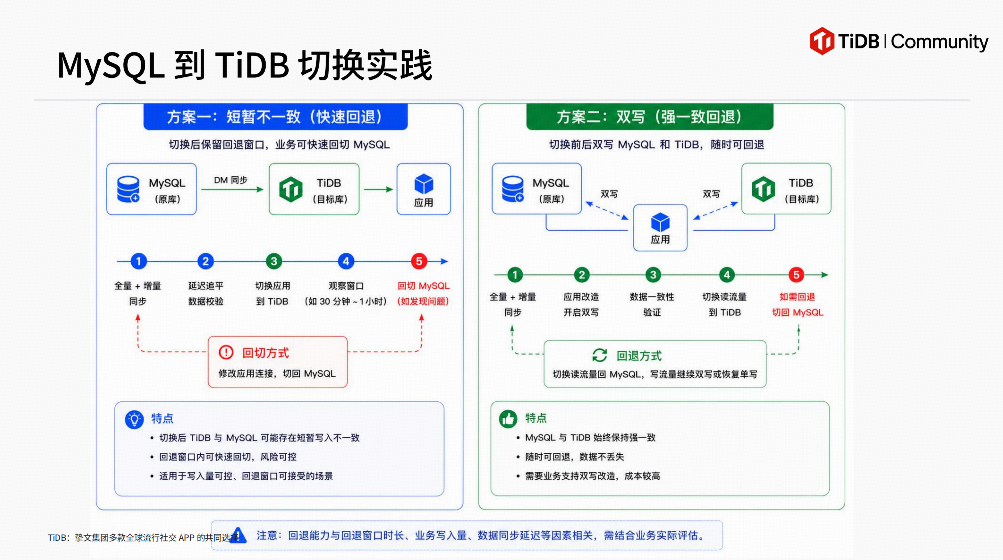
第四道,两种切换方案。非核心业务采用观察窗口模式——全量加增量同步、延迟追平、数据校验、切换、观察 30 分钟到 1 小时,有问题回切。核心业务采用双写模式——开启 MySQL 和 TiDB 双写、数据一致性验证、读流量切 TiDB,有问题回切 MySQL。李想的建议是:“切换窗口是用来切换的,不是用来做迁移的——把迁移和校验提前完成。”
/迁移经验总结/
迁移不仅是数据同步,更重要的是风险控制与切换保障,李想从多次迁移实践中总结了三个需要注意的点。
大表提前评估迁移周期。“迁移周期可能给一周,但有些表几十 TB 上百 TB。一定要评估好迁移周期,避免切换窗口到了数据还没导完。”
迁移期间尽量冻结 DDL。“虽然 DM 支持 Ghost 或 PT 工具改表结构,但强烈建议提前跟业务沟通好,把控 DDL 变更。”
监控延迟不能断。“有些大表同步时间很长,延迟监控一定要做好,避免出现同步链路已经断开但是没有感知到的情况。”
/结语/
当社交业务同时面对国内和海外两个市场、交易和审核两类负载、在线和离线两套链路,挚文集团用 TiDB 替代了传统的复杂架构,缩短的不只是查询时间,还有从数据产生到业务决策的周期。
如果你的业务也在经历类似的变化——分库分表越来越复杂、T+1 数据分析跟不上运营节奏、跨库查询变成常态——不妨尽早从一个场景开启开始验证。
💡 点击【阅读原文】,领平凯数据库(TiDB 企业版)180 天免费试用!



