作者:陈天奇
原文:https://zhuanlan.zhihu.com/p/2101651274798196721
今年是Agent元年,不管对于任何的领域,大家都需要感受到这样的变化。对于机器学习编译和kernel可能更是如此。
传统的机器学习编译尝试利用我们的领域知识从图,tile和SIMT等各个粒度去进行变化和优化,使得我们可以再各个硬件上通过简洁的代码获得很高的效率。
强大agent的出现使得只要我们有足够多的token,基本底层的算子和软件都可以都可以蹬出来了。
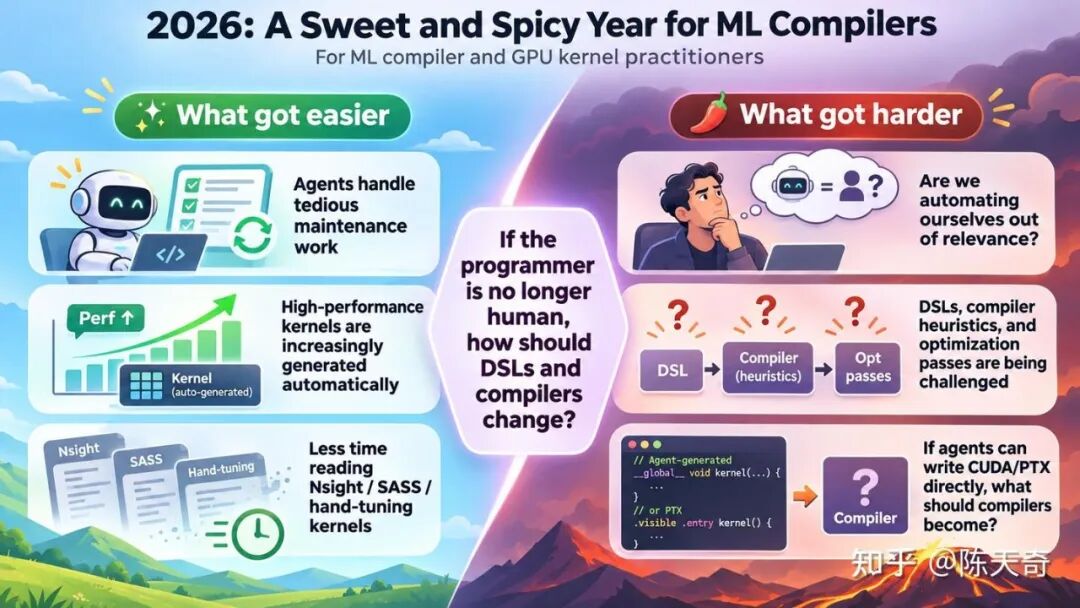
一方面来看,Agent已经可以解决从高性能算子的开发到框架优化的各种问题。我们也终于可以从阅读nsight报告检查汇编和手动微调kernel的循环中解脱出来了。
近期包含 KernelAgent[1]、CUDA Agent[2]、Cursor’s multi-agent system[3]、CAKE[4]、TIRx Harness[5]、KDAgent[6] and EAT[7] 这些工作都在自动化GPU kernel开发中取得了令人瞩目的进展。
另一方面,我们也需要直接面临这样一个问题,我们是否在淘汰我们自己。 像 我不得不把才华埋葬在昨天 描述的一样,Agent 开发kernel的水平超越人类基本是必然,而HazyResearch最近的博客Retire the Abstractions[8]也开始质疑是否我们还需要CUDA DSL。
我们也需要直接面对这样一个问题。当编写程序的主力不再是人类的时候,我们是否还需要编译器。经过探索和实践,我们的答案是编译器本身依然重要,但是必须以不一样的形态出现。
这篇文章介绍了我们对于Agent时代机器学习编译器基础层的思考。比较巧合的是,这篇文章的发布节点也差不多是我们上一篇文章一年之后。
在去年的这篇文章中,我们介绍了TVM FFI,以及展望了一个开放,通用,稳定ABI和FFI标准对于agent时代的作用。在TVM FFI发布之后,我们也一直在努力地去继续模块化tvm核心,经过一年的努力,我们拆分,并且针对agent进行从头开始重新设计打磨,最终完成了一个轻量级独立的TVM-TIRx模块仓库。它包含以下元素:
- • 轻量级的核心IR集合 用于DSL和编译中的常见需求和快速扩展。
- • 稳定的可复用的底层模块 来负责编译过程中比较”老实“和可预测的部分,并且剥离高层需要heuristic的部分。
- • 优先支持动态扩展扩展DSL类型和操作本身可以直接在off tree的包里面直接完成,并且直接动态链接import基础层。
- • Python, Rust, C++ 三语言自由混合驱动 给agent足够多的灵活度根据场景选择语言来开发编译器。
- •
对接稳定的底层编译工具链保持足够的灵活度的前提下和底层编译工具链进行对接。
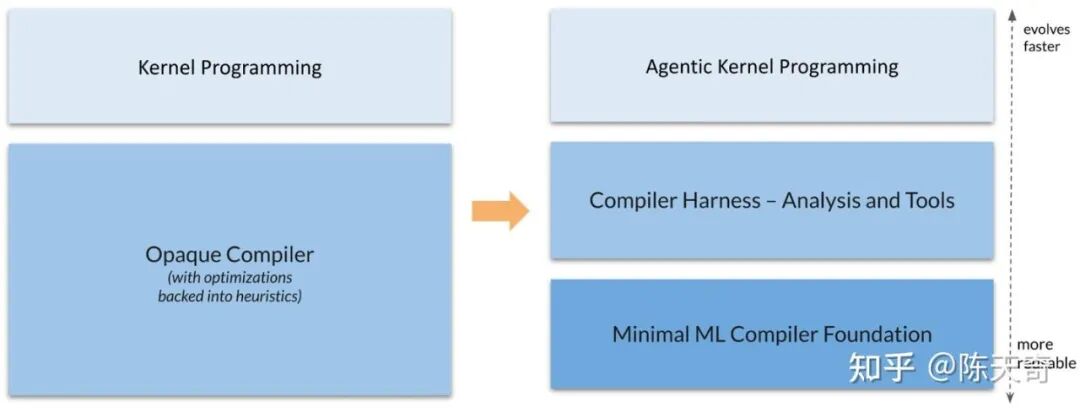
我们认为agent时代机器学习编译器必然会从原来的单一,heuristic和确定性变化混合在黑盒形态变成更加模块化的组合方式,并且给Agent提供直接针对IR数据结构等内部模块的直接访问,方便agent自己开发扩展。
我们把其中底层比较稳定轻量级的模块称之为Agent时代机器学习编译的基础层(ML Compiler Foundation for the Agentic Era)。也是今天这篇文章要介绍的内容。
这篇文章讲述了我们针对Agent时代的机器学习编译系统的思考过程。我们也希望这样第一性原理的思考可以对广大的社区有所帮助。
我们还需要编译器吗?
我们需要问自己的第一个问题是我们是不是还真的需要编译器。传统的DSL引入和很多抽象可以用于帮助人类来编写操作。但是如果agent出CUDA,PTX或者会汇编之后,我们或许不一定需要面向人类的接口了。
当然从另外一方面看,高级DSL本身因为其稳定性和可以快速得到性能依然还是有不少存在的价值,但是我们依然不能低估agent本身的能力,agent直汇编代码在现在这个时间点已经是一个大家普遍可以观察到的现象。
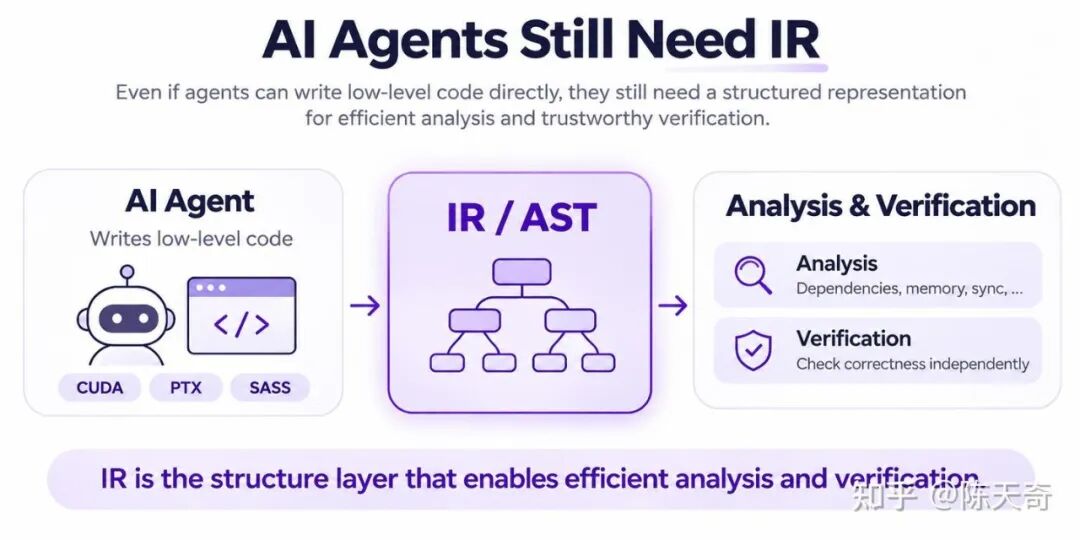
但是我们还是要问这个问题,假设我们直接去掉高层DSL抽象接口和代码生成变换,我们还需要编译器基础模块吗?
假设不久的现在或者未来agent直接出了底层的汇编并且通过不断地迭代获得了优秀的性能,我们还是不能够直接完全相信Agent输出的结果。
我们依然需要通过形式化验证等手段来证明,或者通过人类代码审查和自动化检验结合的手段,不论是哪种手段,我们都需要一个结构化formal的表示来表示这样的程序。
从另外一方面来说,我们也不希望agent花费大量的时间来解决一些低级错误。我们希望可以尽快地帮助agent在演化过程中找到错误,并且构建高效的程序分析[9] 来帮助我们分析内存访问,线程同步,数值等各种特性。
我们会发现即使agent直接完成了代码的直接生成,我们还是有量大重要的需求:
- • 程序分析: 虽然agent可以直接对着语言文本进行分析,就好像人类可以心算算数但是还是会借助计算器一样,程序表示本身也是agent可以借助的工具来进行快速地构建程序分析工具收集迭代反馈。
- • 程序验证: 程序的正确性本身需要通过严格的检查和验证,而某种结构化的程序表示是到达这一步的必要条件。
所以在这一种未来,我们可能不再需要编译器去编译任何东西,但是我们依然需要编译基础架构来帮助我们分析和验证程序本身。一个相对通用的IR可以成为分析,验证和给agent构建额外工具的基础层。
基于这种判断,我们至少需要一个轻量级稳定的核心IR用于DSL和编译中的常见需求和快速扩展。
这样的基础层需要足够的灵活度使得不论agent尝试生成CUDA/PTX或者更加底层的代码的时候,我们都可以通过扩展新op的方式来快速支持,而保留大部分核心工具的稳定。
并且我们还是需要和成熟的工具链进行灵活对接,特别当成熟工具链已经可以很好解决如host代码生成优化等非瓶颈问题的时候,对接成熟的底层编译链可以让我们把token花在该花的地方。
应该如何设计针对agent的编译器基础层
当我们回答完我们是否还需要编译器之后。接下来一个问题就是在agent时代的编译器应该有什么不同。
Agent时代的一个核心特征是迭代会异常快速。而当agent开始介入编译器开发本身之后,编译器的基础层也要随之发生变化。
是否所有的模块都需要用同一种编程语言?
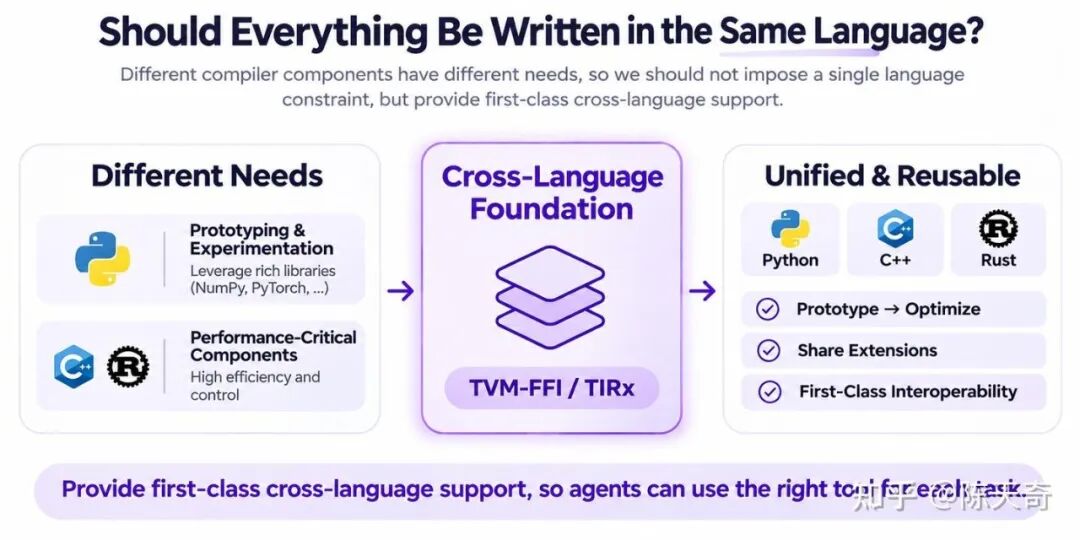
目前比较成熟的编译器解决方案基本是围绕一门核心语言构建,然后扩展出其它语言的wrapper。但是当agent(其实人也有类似的经验)开始开发编译器模块的时候,我们就会根据不同情况来面临不一样的选择
- • 一开始POC阶段或者我们需要进行快速开发的时候往往Python可以直接很快地挫出原型。甚至对于大部分机器学习编译器来说python本身就是很好的选择。
- • 当我们需要效率或者需要更强的类型检查来给agent反馈的时候,Rust和C++就成为更加自然的选择。
虽然现在只要花足够多的token,我们完全可以让agent直接用某一种语言重新构建整个系统,但是这样蹬出来的东西在可维护(虽然可能是人类挽尊的一种说法)和人可以做的掌控上比起模块化迭代来的会差不少。而这样额外的token完全也可以花在其它地方。
所以理想的情况下我们应该让agent在模块级别进行程序语言的自由切换。TIRx以TVM-FFI作为基础的ABI成我们完成了的Python,Rust和C++的三语言自由混合驱动 开发支持。
Agent可以在python里面做原型开发,并且快速地把需要的部分在Rust或者C++中进实现,并且混合调用任意一个语言中间实现的其它变换和分析的模块。
其中对于Rust的支持算是我们一个好玩的尝试,这应该是世界上第一个比较完美支持Rust和C++直接混动开发机器学习编译器的尝试。中间也有不少好玩的技术点,包括如何设计Rust的原生支持已经动态扩展,我们会在后续文章中进行介绍。
如何让聪明的Agent更快地迭代?
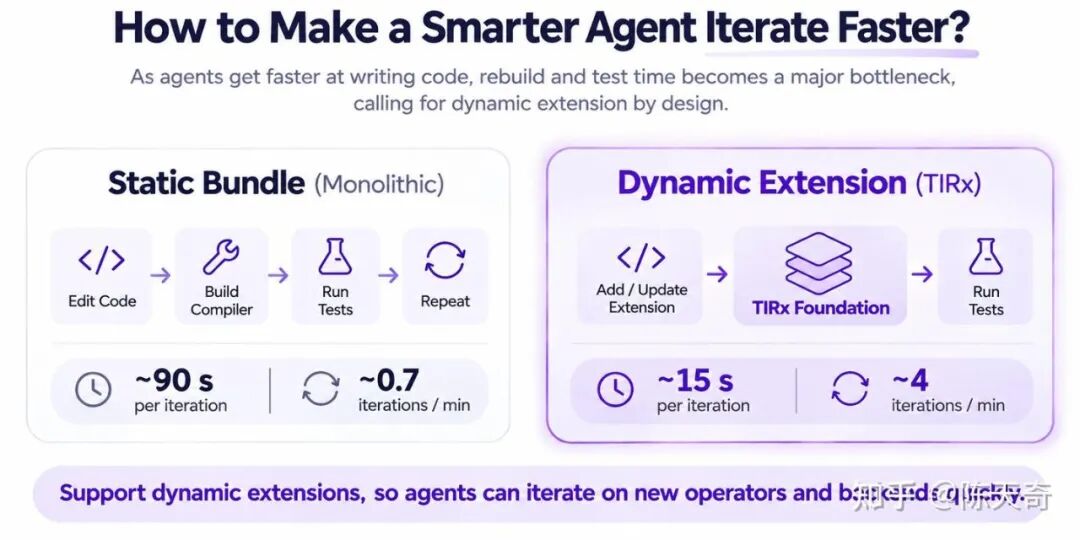
Agent本身可以十分聪明, 但是agent本身的迭代速度是受限于我们要开发的代码对象的。开发编译器的同学相信对于编译器项目本身长久的编译时间不会陌生。
agent或者人在每一次进行实现扩展编译器的时候都需要修改大仓库里面的代码,重新编译整个编译器本身,跑测试,然后跪了之后重复整个过程。其中人本身可以通过训练减少这样的迭代,而agent基本都是习惯性地去走这样的快速迭代流出。
虽然类似于build cache这样的东西可以相对减轻这样的负担,我们依然希望开发可以更加轻量化。
所以我们认为agent对编译器扩展的开发应该是优先支持动态扩展。当我们针对基础层做扩展的时候我们可以在off tree的地方可进行类型和操作等的动态扩展。
其中这些动态扩展可以在以everything as plugin的方式在独立的repo进行迭代。这样直接agent在开发的时候可以pip install基础层,然后快速迭代需要的部分就好了。
为了可以支持这样的设计, 我们需要仔细地设计相对的基础架构。
比如常见的visitor pattern需要我们提前知道所有可能的类型节点(这也是为什么Rust enum和LLVM/MLIR都需要静态编译的原因),而如果我们想要支持可以动态增加类型并且保留常见的如递归访问,改写,和符号表达式约束传递等功能的时候,我们需要一些基于TVM-FFI的结构化API的设计。
有兴趣的同学也可以参考文末附带的文档。在这里需要特别感谢Tilelang社区,其中动态扩展支持,独立模块化和符号表达式Z3约束等都来自TileLang社区对TIRx的反馈和支持。
未来我们应该怎么样进行代码维护?
当软件都是蹬出来的之后,我们应该怎么样进行代码维护呢。
因为有不同的需求和特化,我们相信agent还是需要维护不同的领域相关编译代码。我们也看到如compiler harness的需求,去构建以分析而不是变换为主的工具。
但是不论怎么样,我们都会面临在快速迭代和代码slop化之间的一个矛盾。而且在不同的模块迭代速度和对于slop的可以容忍程度是完全不同的。
当我们在进行 kernel迭代的时候可以每几分钟就出一个kernel,在最后审核之前可能完全没有人的干预。而如果我们真的希望开发可以复用可靠的代码的化,我们依然需要更多的人工审核(或者在优化架构的前提下投入大量token进行polish)。
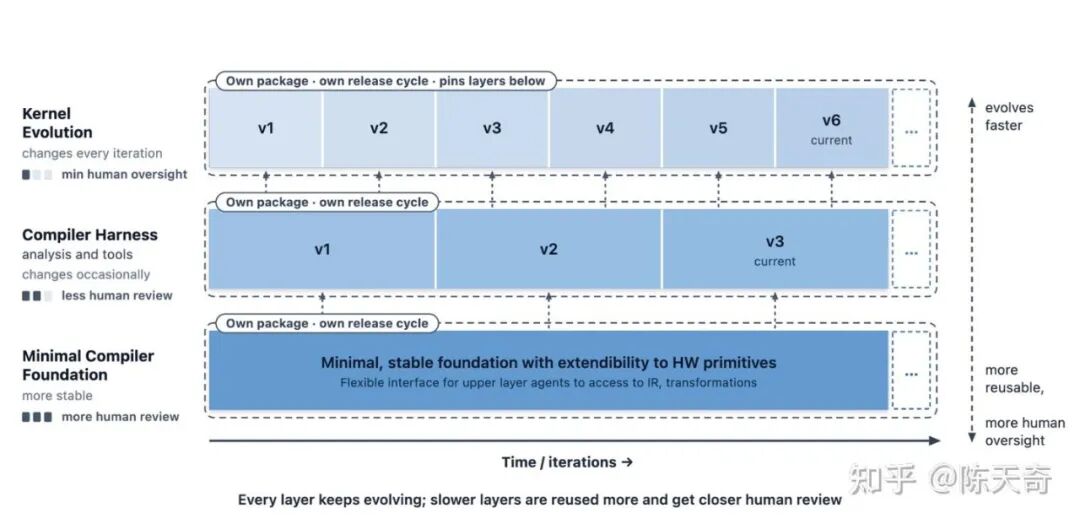
这就意味着传统的项目模块必然会随着稳定性和迭代速度的不同需求进行分层。而机器学习编译基础层需要提供的职责就是负责编译中比较轻量,稳定和“老实”的部分。
也就是一旦需求确定我们不需要特别多针对heuristic的调整。并且基础层需要保持足够多的灵活性给agent来扩展编译抽象。
这样我们可以让agent基于基础层进行高层的编译器扩展和compiler harness快速的迭代。所以TIRx基础层的重点关注在:
- • 轻量级的核心IR集合 用于DSL和编译中的常见需求和快速扩展。
- • 稳定的可复用的底层模块 来负责编译过程中比较”老实“和可预测的部分,并且剥离高层需要heuristic的部分。
- • 对接稳定的底层编译工具链 保持足够的灵活度的前提下和底层编译工具链进行对接。
我们的目标并非直接去掉所有的机器编译器功能,而是把其中相对稳定的核心独立并且仔细设计维护,同时让agent快速地把token用在刀刃上进行上层部分的快速构建。
讨论和展望
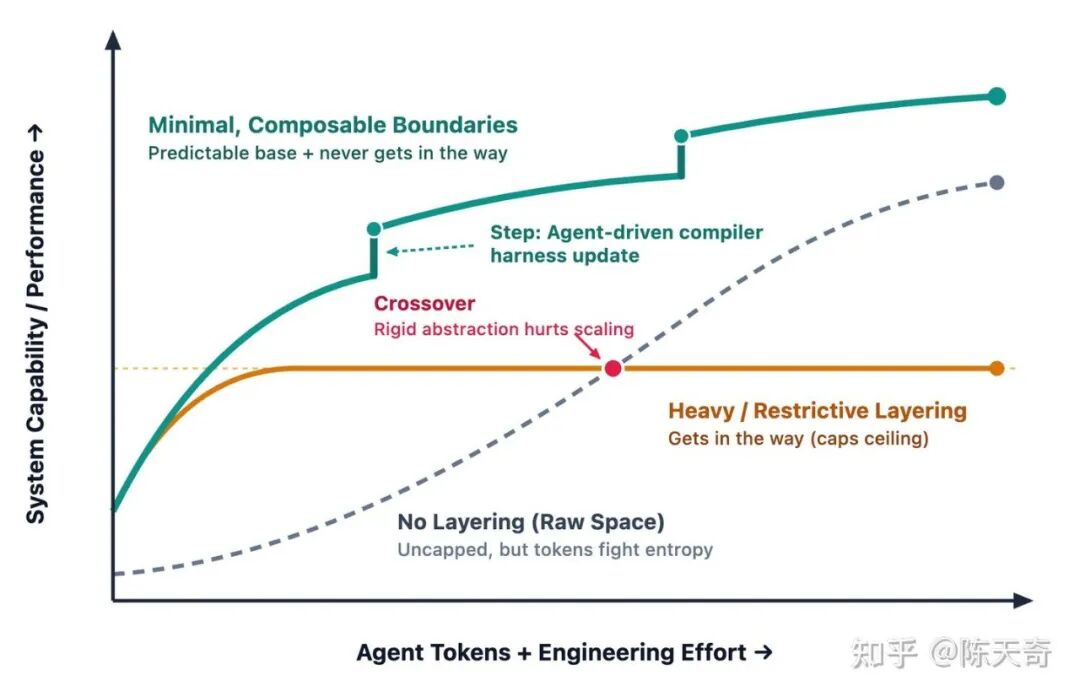
今年相当于技术的十字路口,所以未来很难预测。这篇文章中所讨论的形态应该也不一定是机器学习编译技术在Agent时代唯一可能的形态。但是一点是肯定的, 当我们进入到这个新的时代,原有的抽象和设计都需要被重新审视。
过于限制的抽象会让agent的开发遇到上限瓶颈。我们一定不能限制agent的上限。
而另外一方面,虽然无结构的token投入还是可以达到一定的效果,我们认为有结构并且保留灵活可扩展的组合边界可以让agent进入更快的开发迭代流程,不论是kernel, 编译器,或者是整体框架本身。
我们希望TIRx foundation本身可以提供在这个方向上前进的一个基础设施,并且帮助到机器学习编译和agent开发的社区生态本身。
在文章的末尾,我们还是想讨论一下为什么我们要做这件事情。特别是agent可以让一切解决方案快速入土的时代。虽然这篇文章描述的未来不一定是唯一的未来和解决方案,但是确是我们相信的未来。
一直以来,我们纯粹地觉得机器学习编译器的构建应该更加轻量,快捷和简单,在agent时代更是如此,TVM FFI的模块化是去年我们走出的第一步,而TVM TIRx的模块化是我们向着这个方向的又一步。我们希望和广大社区的同学一起,见证和参与这个新的时代。
致谢
这个项目其实整合了整个机器学习编译开源社区过的经验,我们特别感谢TVM,TileLang还有广大机器学习编译社区的团队对项目的反馈。
相关链接
Github请戳:https://github.com/apache/tvm-tirx
项目文档:https://tvm.apache.org/tirx/
欢迎大家使用和参与社区共建
引用链接
[1] KernelAgent: https://pytorch.org/blog/kernelagent-hardware-guided-gpu-kernel-optimization-via-multi-agent-orchestration/
[2] CUDA Agent: https://arxiv.org/abs/2602.24286
[3] Cursor’s multi-agent system: https://prod.cursor.com/blog/multi-agent-kernels
[4] CAKE: https://arxiv.org/abs/2608.12629
[5] TIRx Harness: https://blog.mlc.ai/2026/09/29/tirx-harness-an-open-compiler-harness-for-agentic-gpu-programming
[6] KDAgent: https://nvlabs.github.io/kda/
[7] EAT: https://arxiv.org/abs/2610.36848
[8] Retire the Abstractions: https://hazyresearch.stanford.edu/blog/2026-08-05-retire-the-abstractions
[9] 高效的程序分析: https://mlc.ai/agentic-gpu-programming-for-mlsys/chapters/analysis.html



