在公众号「python风控模型」里回复关键字:学习资料
QQ学习群:1026993837 领学习资料
金融风控模型和数据分析很难?逻辑回归评分卡/catboost/xgboost/lightgbm/等模型用python一次全部搞定!增加数据分析和数据可视化实战,由易到难,带你从菜鸟轻松晋级kaggle级建模高手。碰到问题有老师答疑
python金融风控评分卡模型和数据分析(加强版)比原版增加了《呆瓜半小时入门python数据分析课程》和《Python实战金融风控回归模型》两个课程,解决诸多学员python数据分析,数据处理和数据可视化痛点,强化python编程基础。对于更高需求用户,加强版增加了模型自动化调参,回归模型应用。
如果大家感兴趣,欢迎关注《python金融风控评分卡模型和数据分析(加强版)》,学习评分卡,集成树,神经网络算法等系统化风控建模内容。扫一扫下面二维码点击收藏,以备之后工作和学习使用。
python金融风控评分卡模型和数据分析(加强版)部分覆盖内容如下
就业方向花旗银行,JP摩根,蚂蚁金服,微粒贷,京东金融,招联金融等等
子课程结构如下
部分实战项目介绍如下
风控模型开发部分细节如下
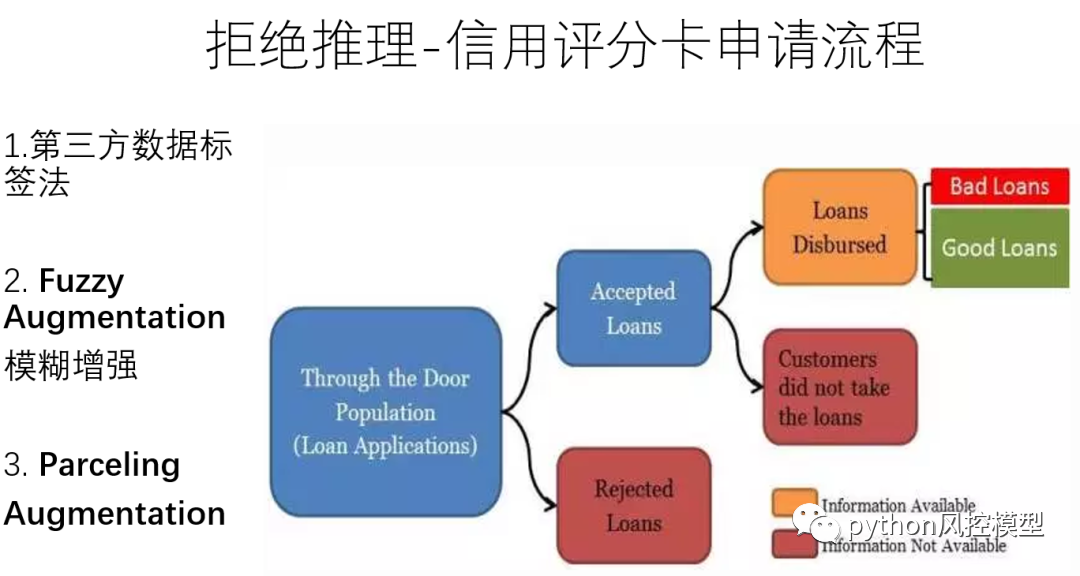
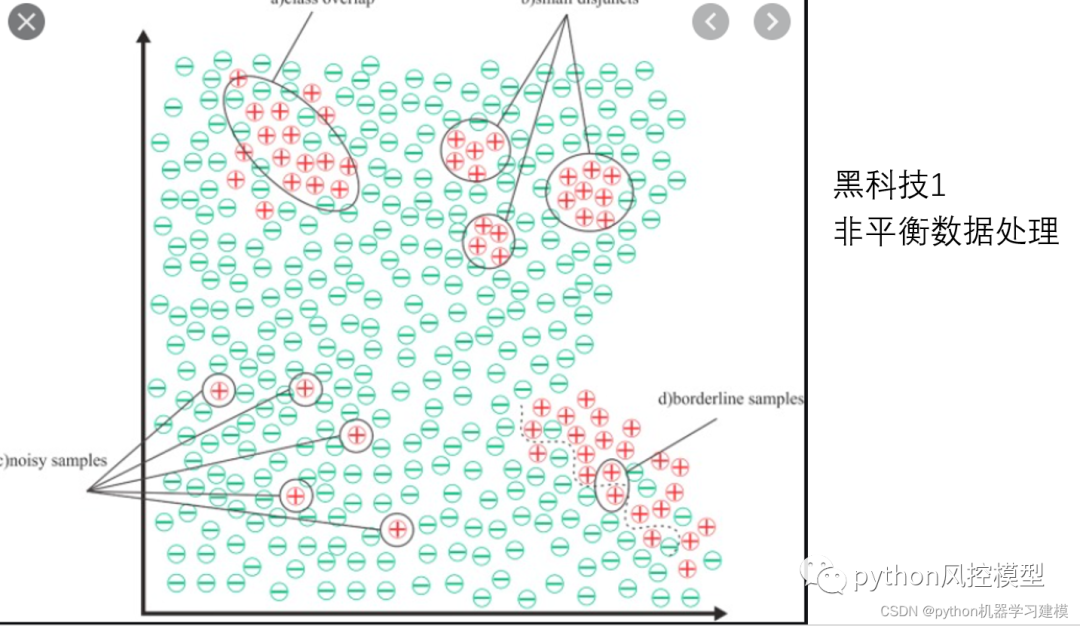
黑科技1:风控建模中,经常遇到坏客户占比过低,模型性能低下情况。《python金融风控评分卡模型和数据分析(加强版)》支持非平衡数据处理,解决此问题。
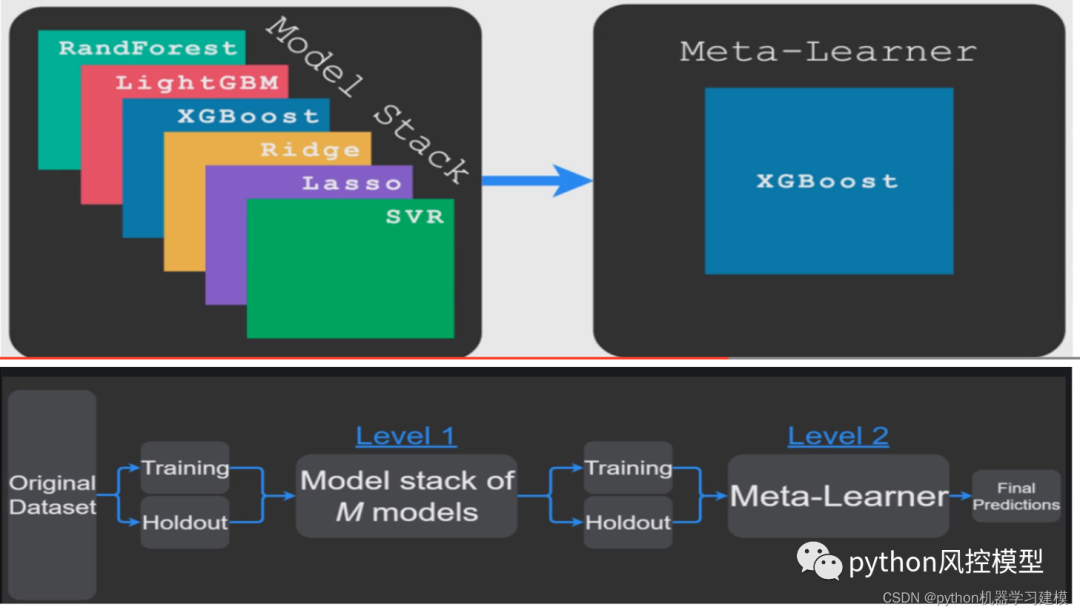
黑科技2:《python金融风控评分卡模型和数据分析(加强版)》体现算法集体智慧,融合模型应用,可能比单一算法模型性能更优
黑科技3:《python金融风控评分卡模型和数据分析(加强版)》支持深度学习Keras模型应用,解决研究生,博士生模型论文痛点
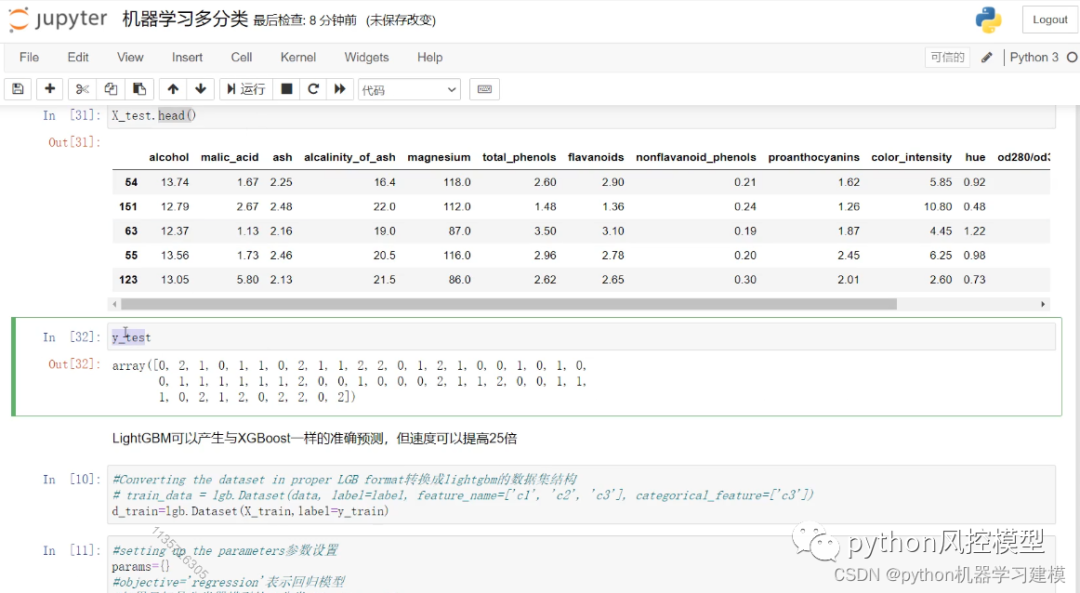
黑科技4:《python金融风控评分卡模型和数据分析(加强版)》支持机器学习多分类模型,金融风控建模中,有时需要对客户三分类:好客户,坏客户,灰度客户。但互联网上相关资料甚少,教程完美解决此难题。
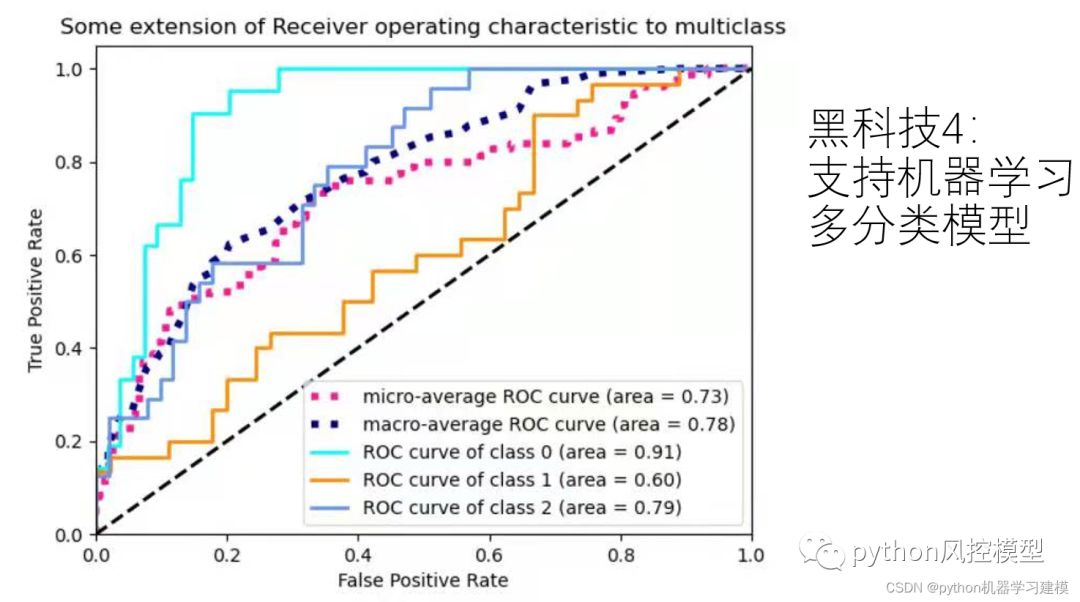
《python金融风控评分卡模型和数据分析(加强版)》支持多分类模型的ROC绘制
黑科技5:逻辑回归解释性一家独大?《python金融风控评分卡模型和数据分析(加强版)》提供独特算法支持机器学习可解释性,打破机器学习不可解释的痛点。
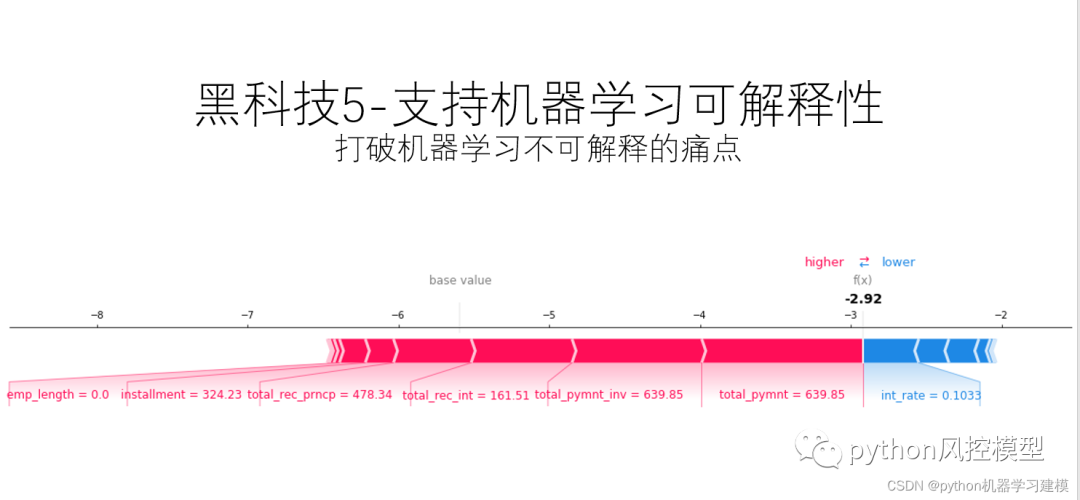
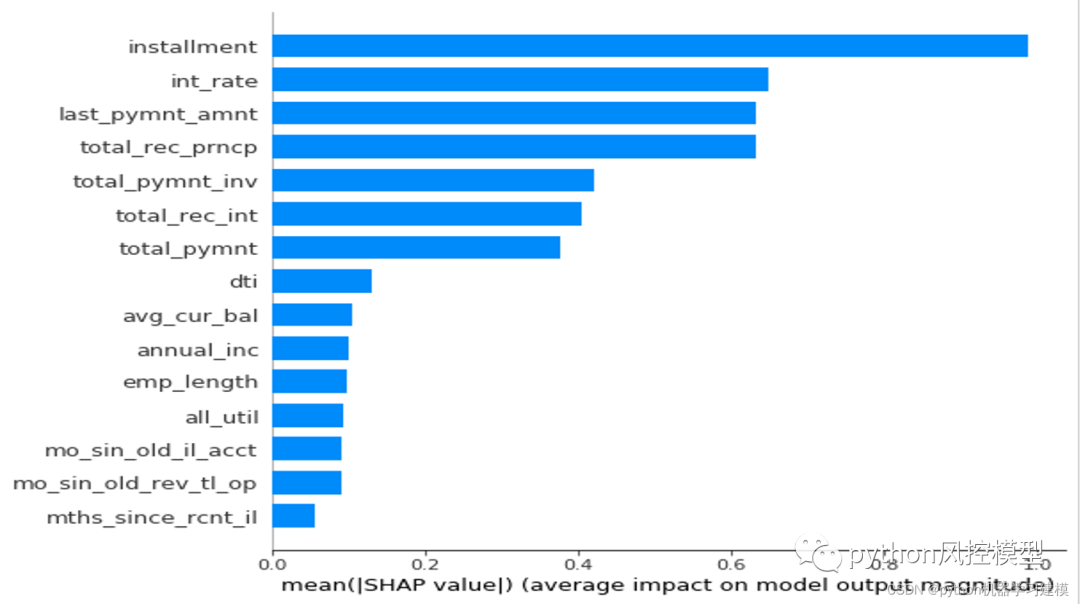
《python金融风控评分卡模型和数据分析(加强版)》引用经典博弈论算法,对变量重要性合理排序。
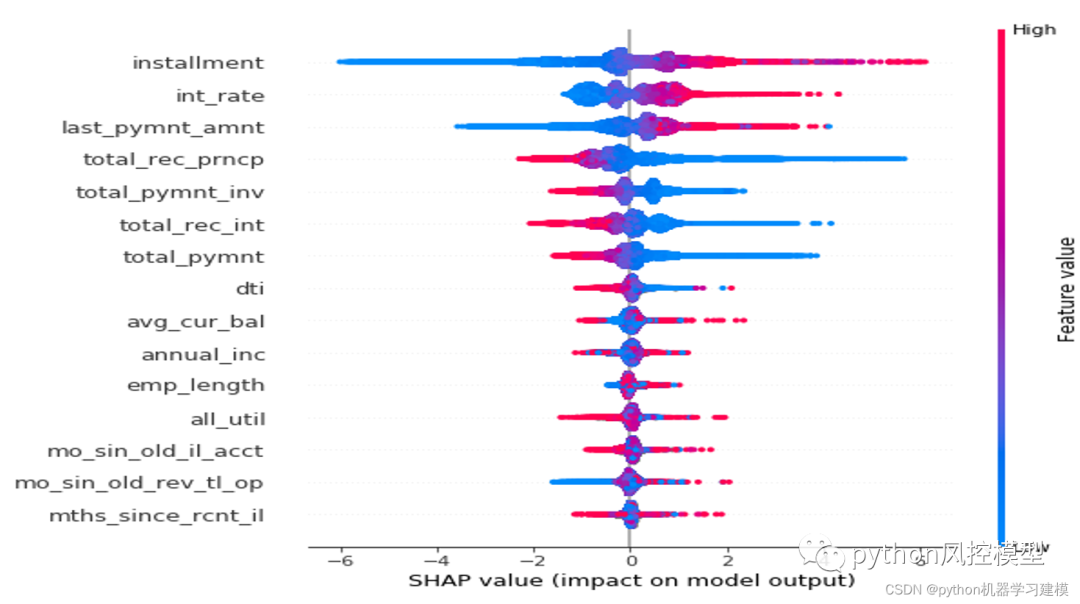
《python金融风控评分卡模型和数据分析(加强版)》支持展示实例(每个用户)与变量重要性的多维度关系。
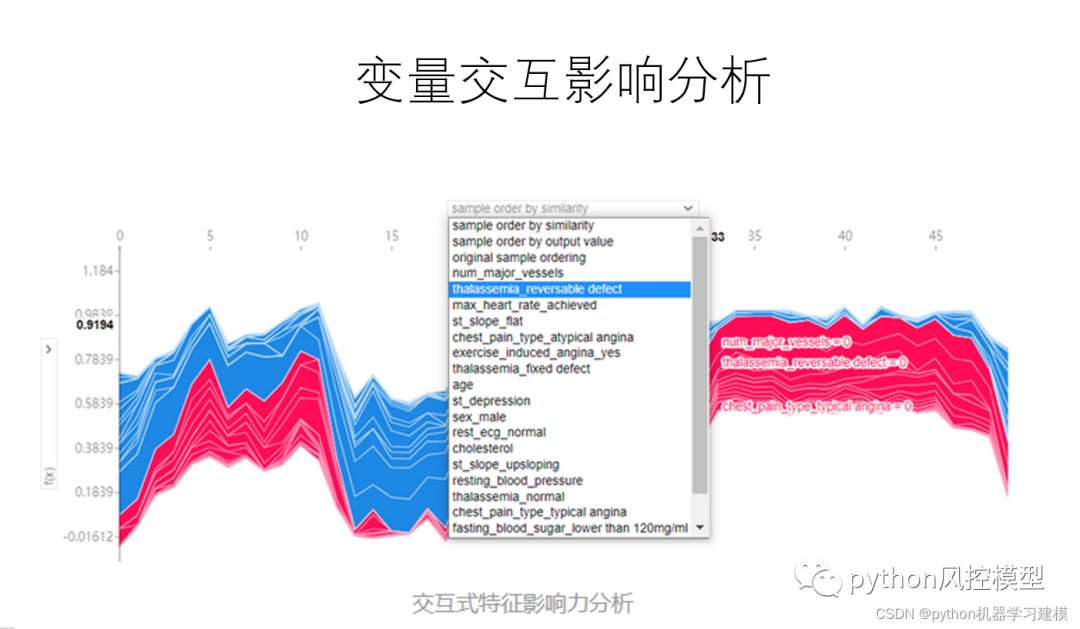
《python金融风控评分卡模型和数据分析(加强版)》支持变量交互影响分析,进行更加深入变量分析。
《python金融风控评分卡模型和数据分析(加强版)》支持独立特征重要度对比。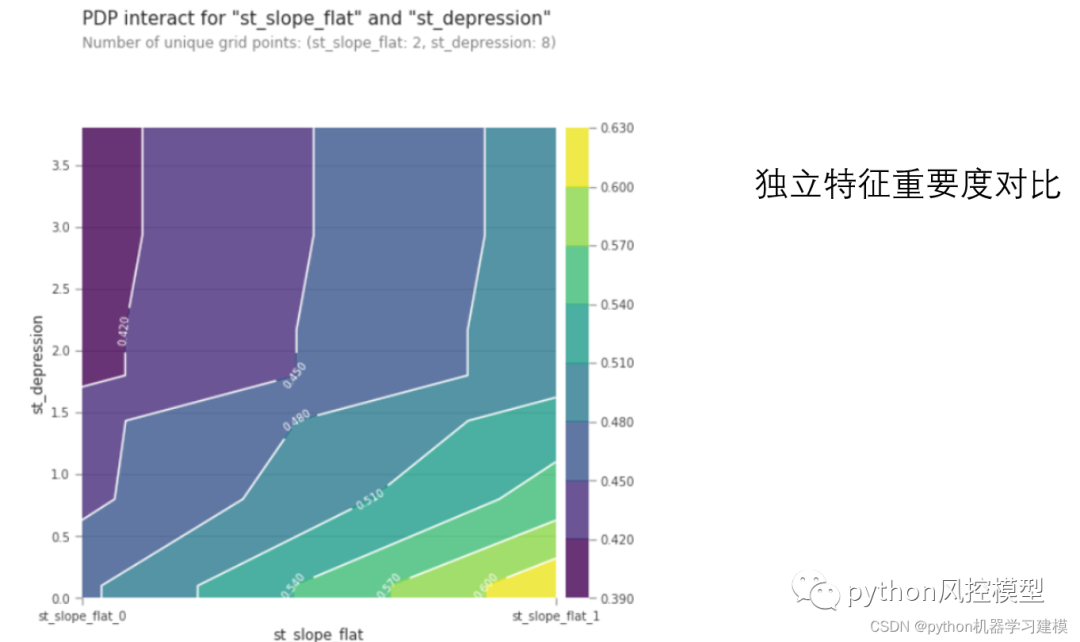
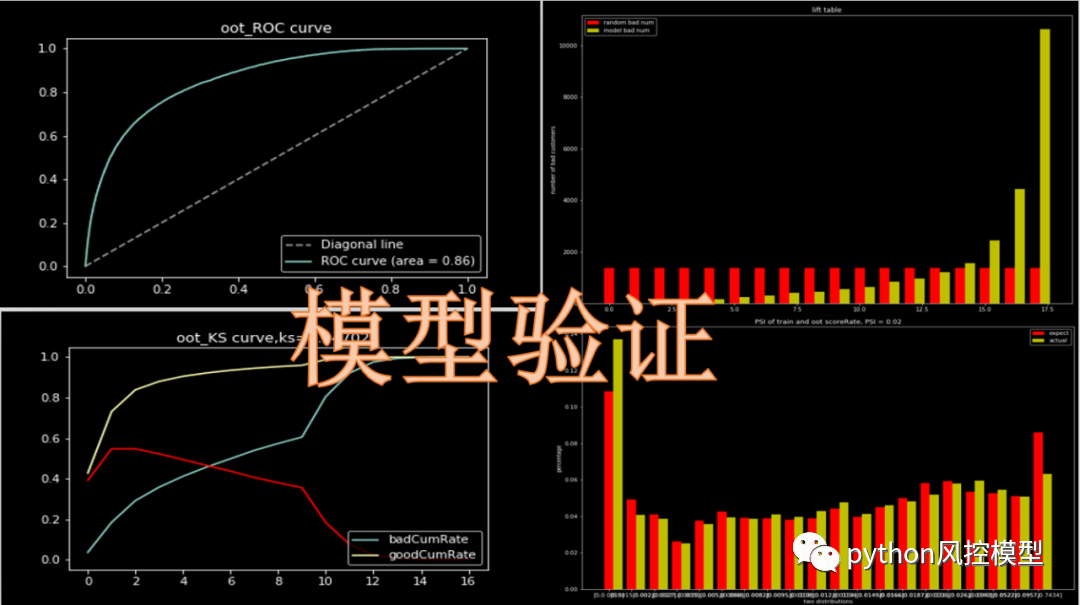
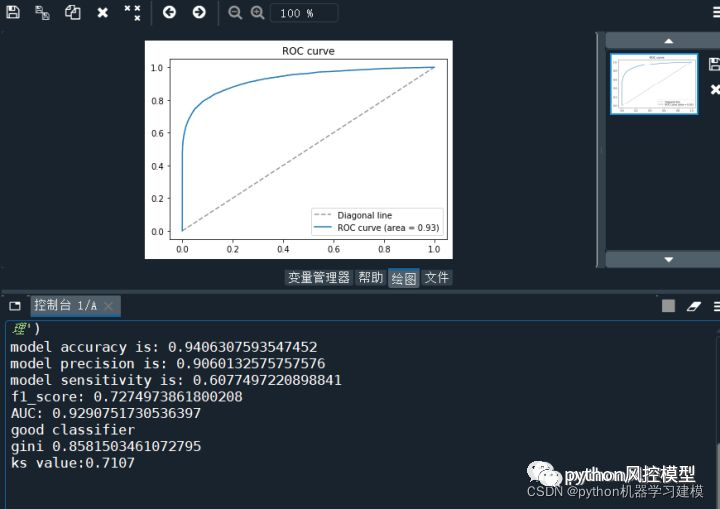
黑科技6:《python金融风控评分卡模型和数据分析(加强版)》教程中模型性能卓越,以give me some credit数据集为例,AUC为0.929,具体模型性能如下:
model accuracy is: 0.9406307593547452
model precision is: 0.9060132575757576
model sensitivity is: 0.6077497220898841
f1_score: 0.7274973861800208
AUC: 0.9290751730536397
good classifier
gini 0.8581503461072795
ks value:0.7107
远超互联网其它相关论文模型性能AUC 0.85。
金融风控建模系列课五年不断迭代更新,累计学员数万,支持售后答疑,支课程更新,支持阿里巴巴,腾讯等大厂简历推荐,帮助诸多学员顺利转岗,完成毕业论文,专利或作业,部分学员评价如下
《python金融风控评分卡模型和数据分析(加强版)》部分脚本展示
随机森林算法模型代码
import pandas as pdimport numpy as npimport matplotlib.pyplot as pltfrom sklearn.ensemble import RandomForestClassifierfrom sklearn.model_selection import train_test_split trees=1000readFileName="German_credit.xlsx"df=pd.read_excel(readFileName)list_columns=list(df.columns[:-1])X=df.ix[:,:-1]y=df.ix[:,-1]names=X.columnsx_train,x_test,y_train,y_test=train_test_split(X,y,random_state=0)forest=RandomForestClassifier(n_estimators=trees,random_state=0)forest.fit(x_train,y_train)print("random forest with %d trees:"%trees) print("accuracy on the training subset:{:.3f}".format(forest.score(x_train,y_train)))print("accuracy on the test subset:{:.3f}".format(forest.score(x_test,y_test)))print('Feature importances:{}'.format(forest.feature_importances_))n_features=X.shape[1]plt.barh(range(n_features),forest.feature_importances_,align='center')plt.yticks(np.arange(n_features),names)plt.title("random forest with %d trees:"%trees)plt.xlabel('Feature Importance')plt.ylabel('Feature')plt.show()
支持向量算法建立模型
from sklearn import preprocessingfrom sklearn.svm import SVCfrom sklearn.model_selection import train_test_splitimport matplotlib.pyplot as pltimport pandas as pd readFileName="German_credit.xlsx"df=pd.read_excel(readFileName)list_columns=list(df.columns[:-1])x=df.ix[:,:-1]y=df.ix[:,-1]names=x.columnsX_train,x_test,y_train,y_test=train_test_split(x,y,stratify=y,random_state=42)svm=SVC()svm.fit(X_train,y_train)print("accuracy on the training subset:{:.3f}".format(svm.score(X_train,y_train)))print("accuracy on the test subset:{:.3f}".format(svm.score(x_test,y_test)))'''accuracy on the training subset:1.000accuracy on the test subset:0.700 '''plt.plot(X_train.min(axis=0),'o',label='Min')plt.plot(X_train.max(axis=0),'v',label='Max')plt.xlabel('Feature Index')plt.ylabel('Feature magnitude in log scale')plt.yscale('log')plt.legend(loc='upper right') X_train_scaled = preprocessing.scale(X_train)x_test_scaled = preprocessing.scale(x_test)svm1=SVC()svm1.fit(X_train_scaled,y_train)print("accuracy on the scaled training subset:{:.3f}".format(svm1.score(X_train_scaled,y_train)))print("accuracy on the scaled test subset:{:.3f}".format(svm1.score(x_test_scaled,y_test)))'''accuracy on the scaled training subset:0.867accuracy on the scaled test subset:0.800'''
svm2=SVC(C=10,gamma="auto",kernel='rbf',probability=True)svm2.fit(X_train_scaled,y_train)print("after c parameter=10,accuracy on the scaled training subset:{:.3f}".format(svm2.score(X_train_scaled,y_train)))print("after c parameter=10,accuracy on the scaled test subset:{:.3f}".format(svm2.score(x_test_scaled,y_test)))
如果有更高需求朋友,例如研究生,博士生论文,企业建模需求,我们公司提供一对一机器学习模型定制服务,提供公司正规发票和合同。
我们公司有供应链金融机器学习模型定制服务(针对企业建模和论文科研),提供公司正规发票,官网www.mlpaper.cn。如果你需要建模项目定制服务,商务联系QQ:231469242,微信:drug666123,或扫描下面二维码加微信咨询。加QQ学习群:1026993837,免费领取200G学习资料。



