上个月,VoiceStudio 单月新增近 5 万 Star,放在 GitHub 月榜里,这个增速已经很扎眼了,关键这还是一个比较窄的赛道。
我这段时间研究了一下,能理解它为什么涨这么快了。以前折腾本地语音,要分别装模型、配环境、敲命令;VoiceStudio 把这些收进了一个桌面应用,大部分操作不用碰命令行,算是把语音模型的门槛按到地板上了,像我这样的小白也能轻松上手。
先简单介绍
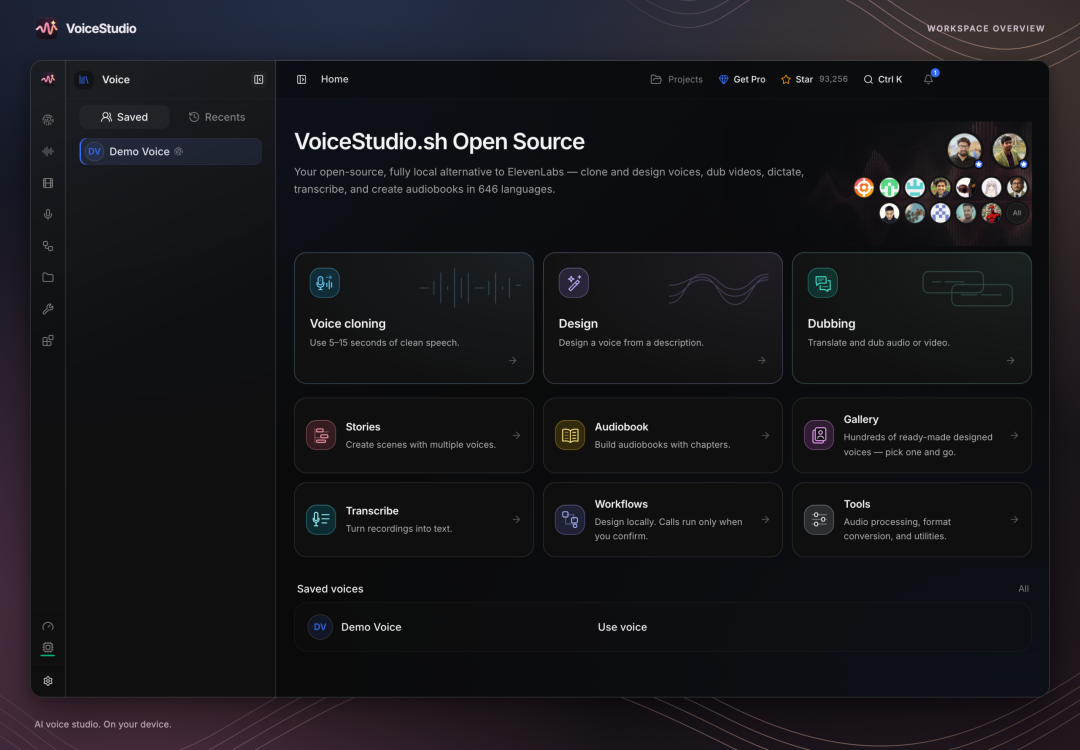
VoiceStudio 是一个开源语音工作台,它能做声音克隆、声音设计、视频配音、听写、转录、有声书和批量生成。官方口径是覆盖 646 种语言,默认引擎是 k2-fsa/OmniVoice。
到现在为止,仓库已经超过 11.1 万 Star。项目 2026 年 4 月才建仓,到 10 月涨到这个量级,在今年的 AI 工具里确实少见。
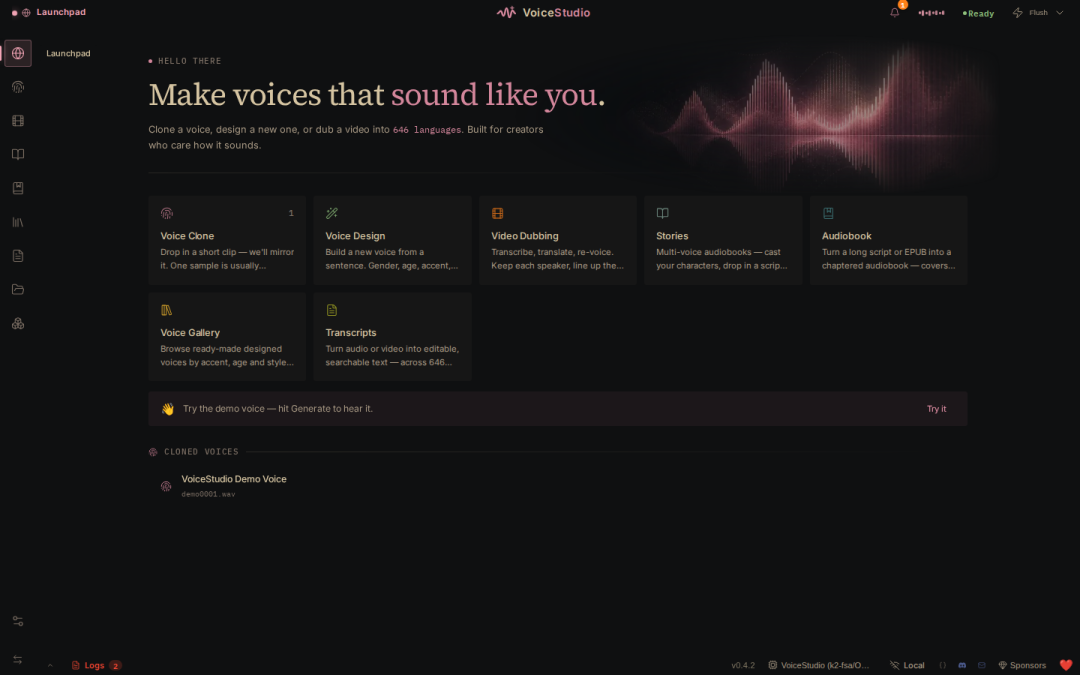 VoiceStudio 首页和模型入口
它没有主推某个新 TTS 模型。语音模型、转录模型、配音流程和本地接口,都放在同一个桌面应用里,不用我们每个模型自己装一遍、再从命令行里一点点调。
我最先看的是声音克隆
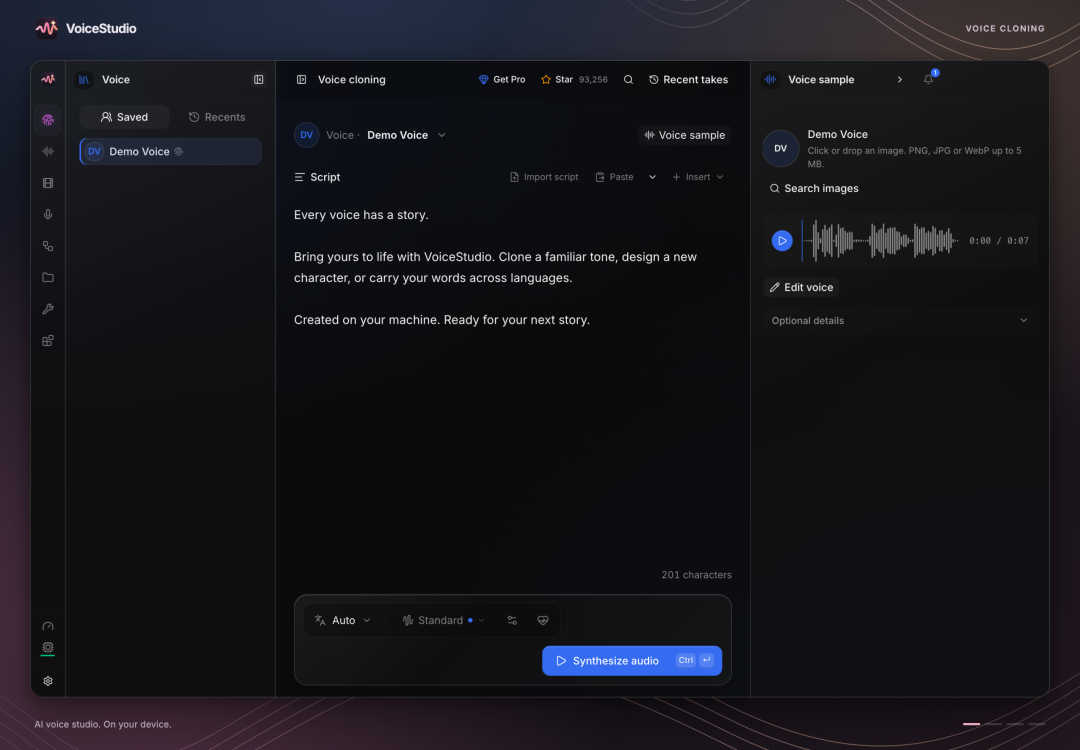
声音克隆的入口很直接:放一段干净的参考录音,输入要生成的文本,然后交给本机模型跑。
参考录音越干净,结果越稳定。背景音乐、多人说话、很重的房间混响,都会给模型添乱。自己接过 Whisper 和 TTS、在命令行里折腾过的人,看到这个入口应该会松一口气。
 声音克隆工作区
生成设置里能看到导出精度、采样步数、速度、时长这些控制项。当前版本默认按引擎的最佳质量跑,跑慢了才会给出更快的选项。这个处理我觉得挺顺手,不需要我们一开始就翻参数表。
注意:声音克隆只能用在有授权的声音上。自己的声音、客户明确授权的声音、团队内部确认过的素材,这些可以。拿别人的公开音频去模仿本人,这个绝对不能碰。发布合成语音时,也要按平台要求标清楚。
视频配音比单条语音更有用
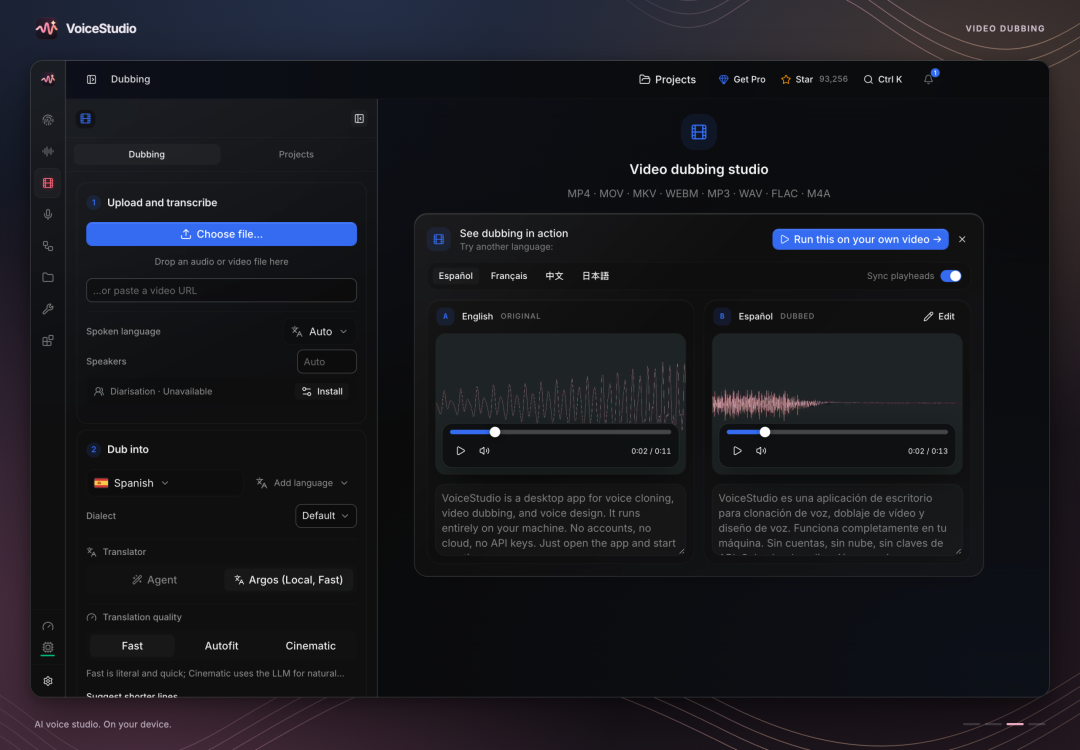
VoiceStudio 把配音做成了连续流程。导入音频或视频后,它会做转录,接着翻译,再按段落生成目标语言的语音,最后处理时间轴和导出。
 视频配音工作区
如果原片里有多个人说话,可以给不同说话人分配不同声音。已经有字幕的话,也能导入 SRT,让程序少走一步。
我平时翻开源仓库,经常碰到只发英文演示视频的项目。那种几分钟的功能演示,用这套流程转成中文解说就挺顺。课程录屏、采访视频、产品演示,也基本对得上。
不过长视频别一上来就整。模型下载、转录、翻译、逐段合成,每一步都吃时间。先试一分钟左右的片段,确认声音和节奏能接受,再跑完整项目,这样不容易浪费时间。
不想用真声,可以试试声音设计
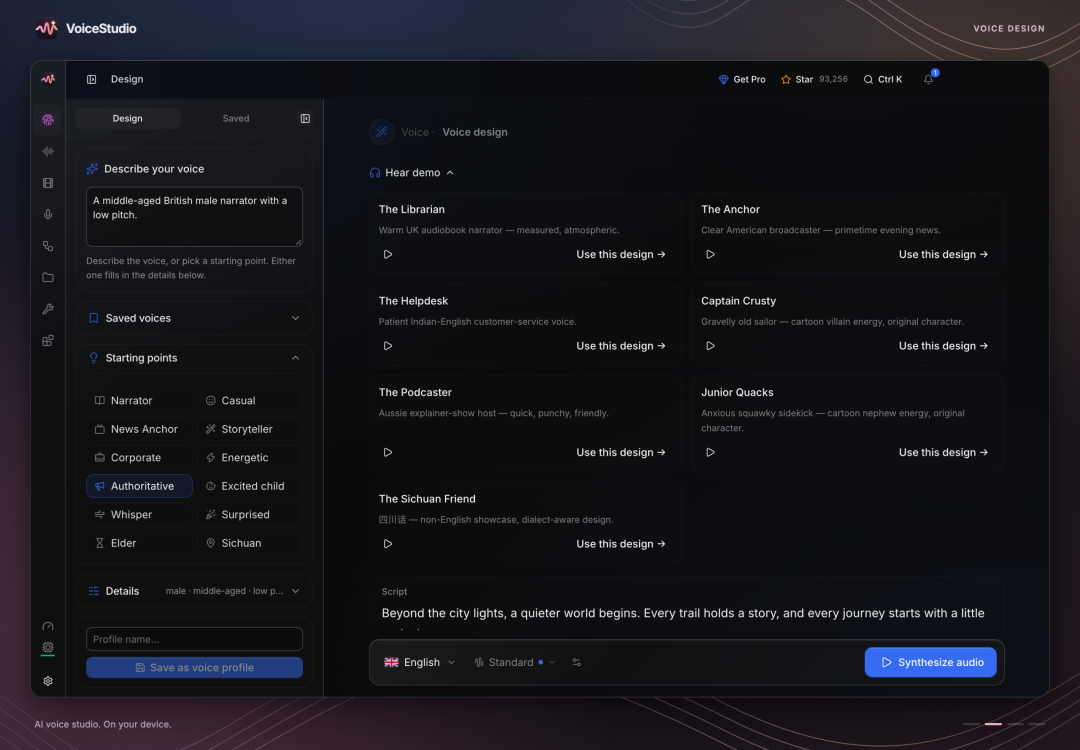 声音设计工作区
声音设计我也觉得挺实用。我们可以用文字描述想要的声音,比如性别、年龄、口音、音高、说话风格,让它捏出一个新音色。
虚构角色的旁白能用,不想绑定真人音色的项目也能用。比如一段产品演示,只需要一个清楚、稳定、不抢戏的旁白,就没必要非得克隆谁。我自己也更愿意用这个方向,新声音不对应现实中的某个人,后面拿去做内容也少一些授权麻烦。
多花一点时间,调一个好听的声音用着,我觉得比声音克隆有意义。
模型和硬件要求
VoiceStudio 的应用本体免费,也不需要账号。Pro 是可选的商业版本,Cloud 还没正式开放,日常本地使用不强制碰这些东西。
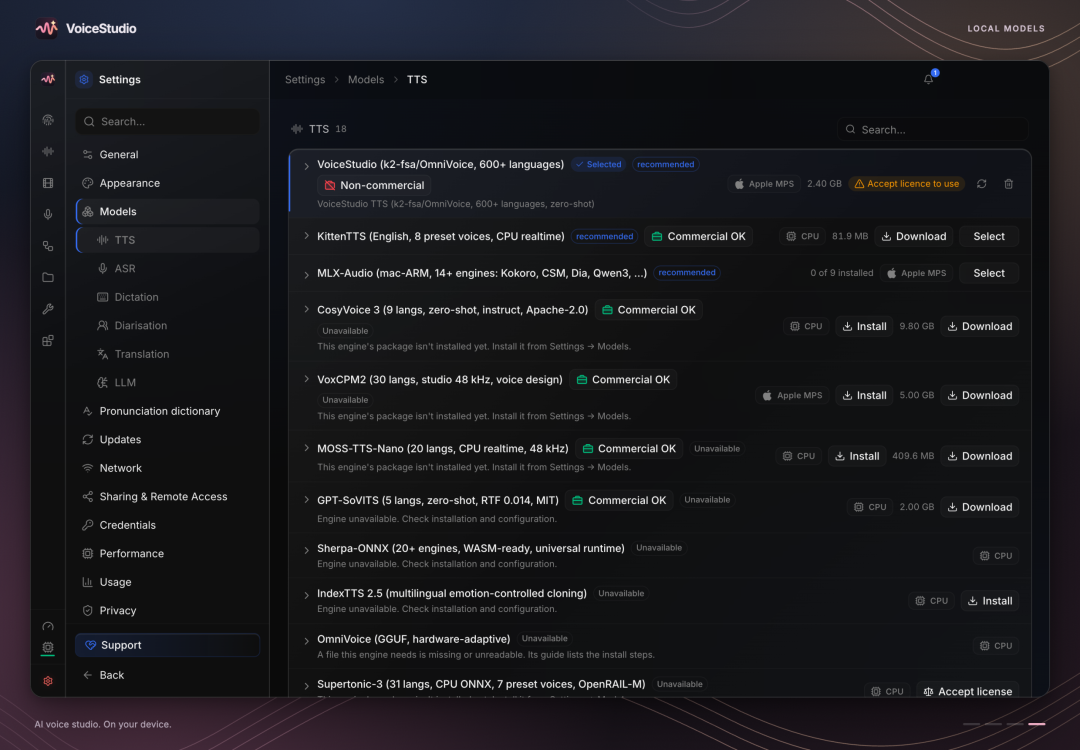 本地模型管理器
它支持 macOS、Windows、Linux,也有 Android 和 iOS 预览版。桌面端对 Apple Silicon 支持比较稳,NVIDIA 显卡可以走 CUDA。
一些 GGUF 引擎还能用 Vulkan 调起 AMD、Intel 和 NVIDIA GPU。没有 GPU 也能跑,只是慢。
Intel Mac 这边只能跑应用界面,需要连接另一台机器上的后端。Windows on ARM 也还是实验状态。部署前,先确认自己的配置能不能跑,别只看宣传里的平台列表。
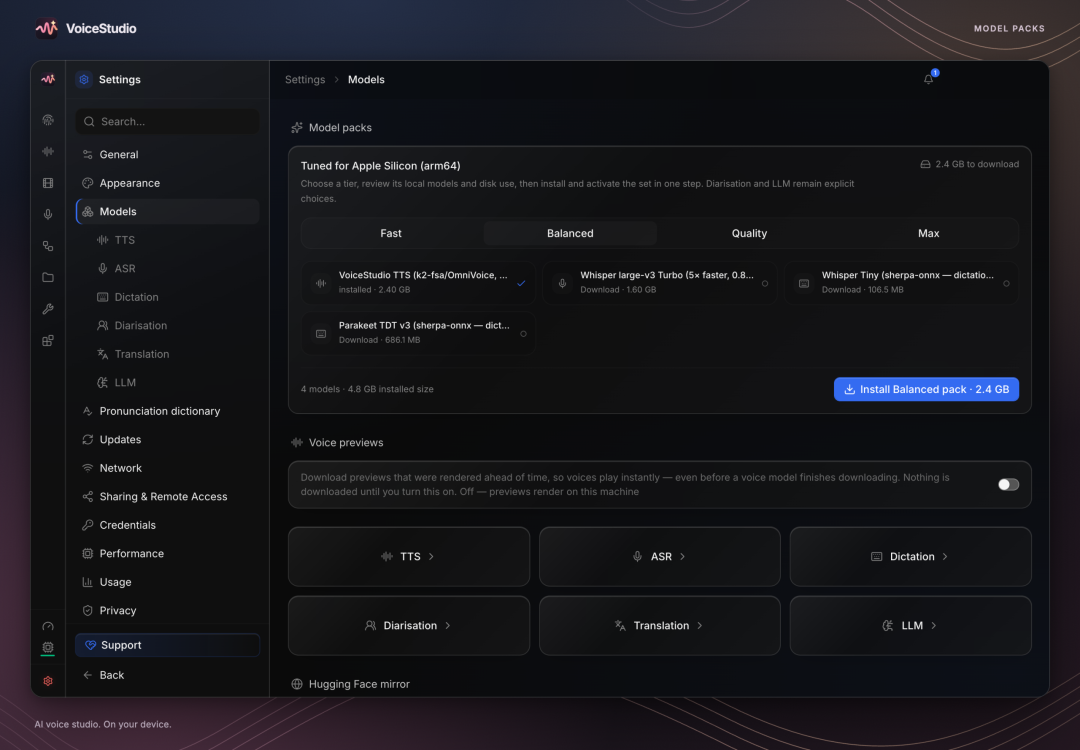 模型包下载管理
模型会占磁盘,生成会占内存和显存。第一次跑之前,应用会先问你要不要下载模型,不会装完就自己在后台拉一堆东西。
手机端能干什么
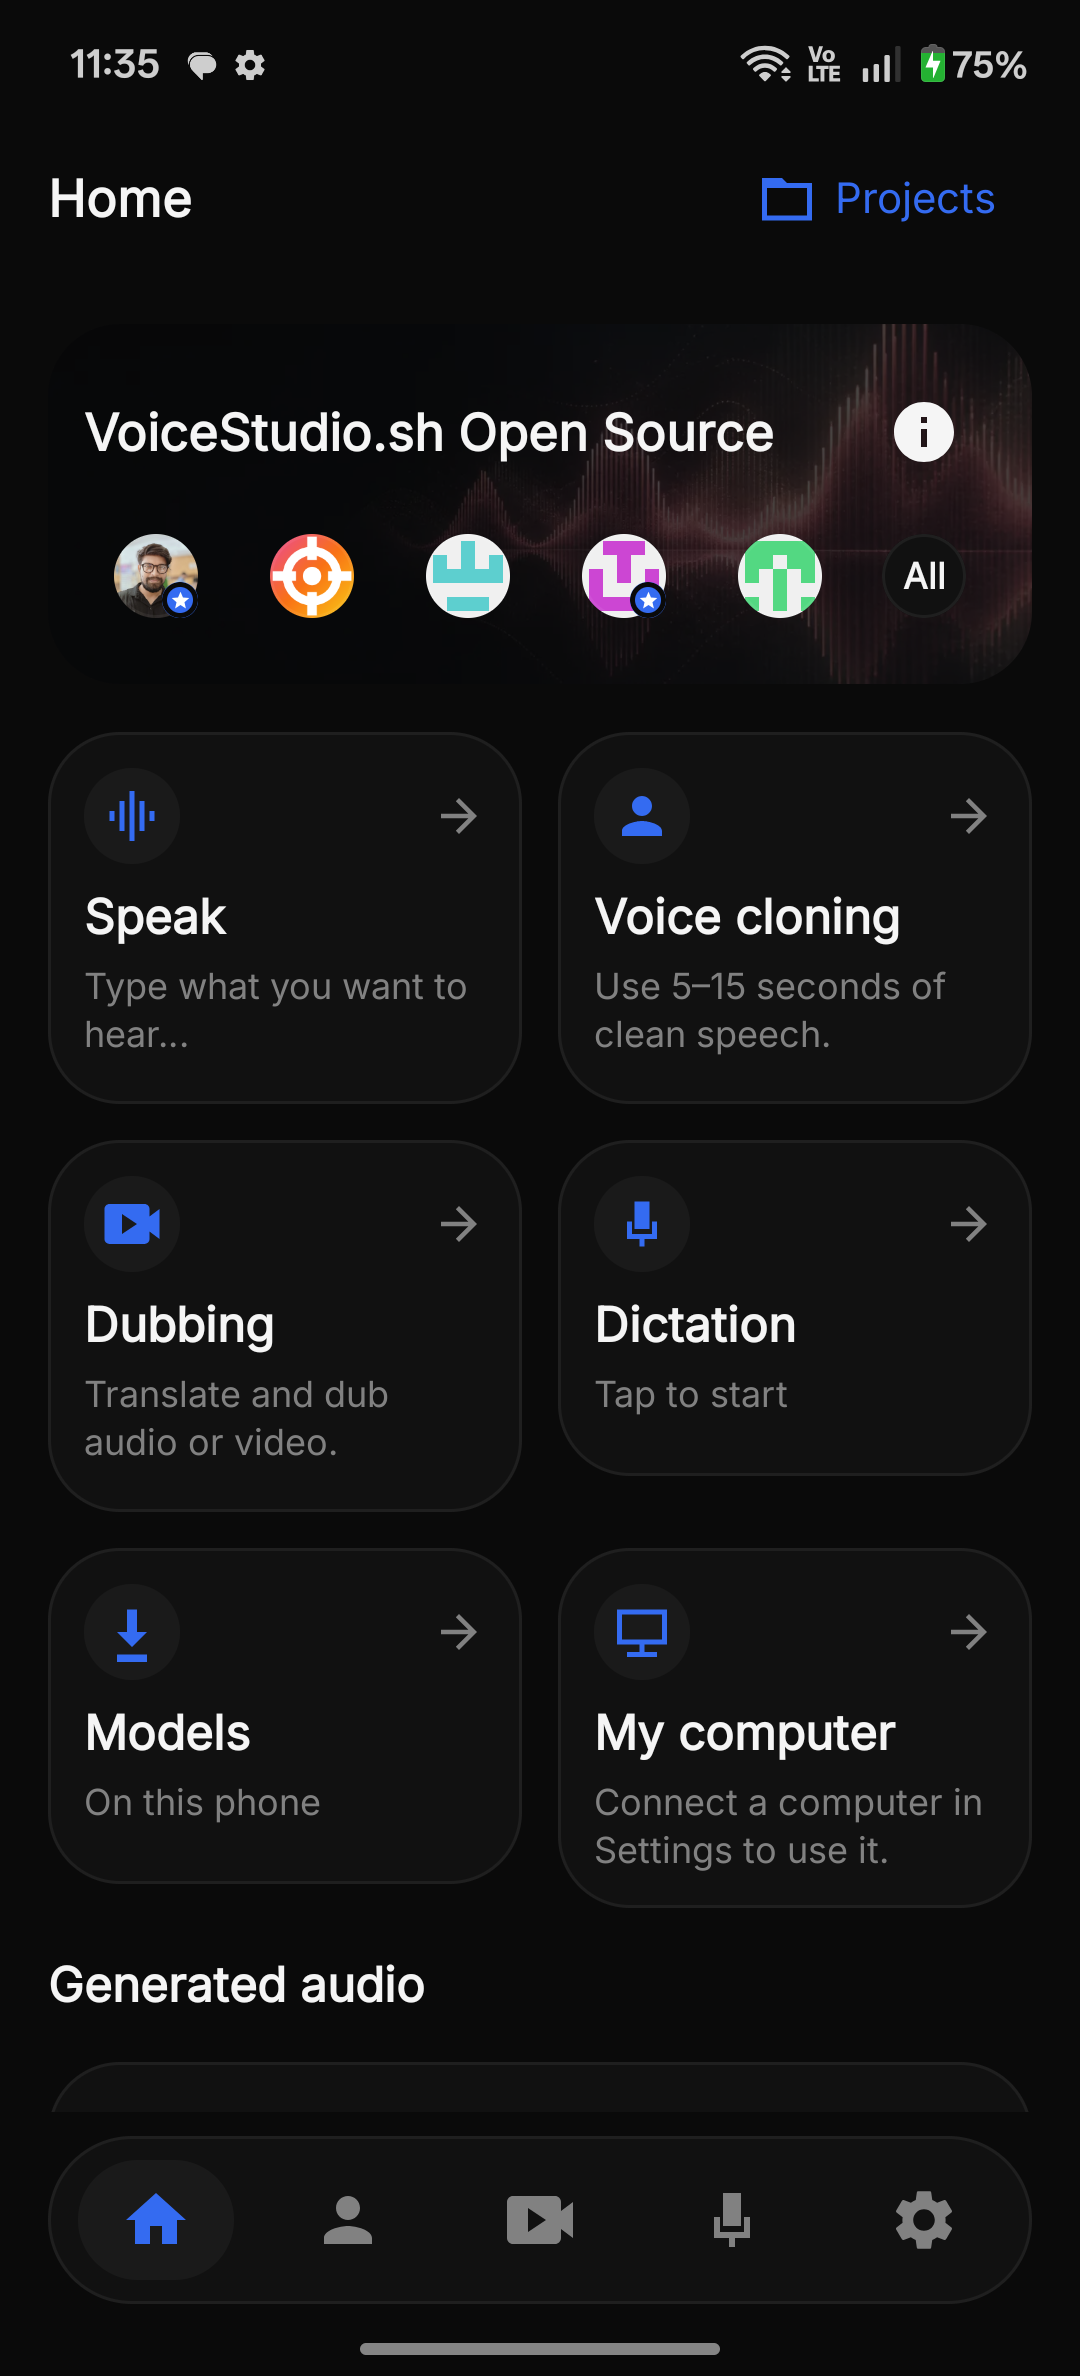 Android 版 VoiceStudio
Android 10 以上可以装 APK,模型下载后能在设备上离线跑。iPhone 和 iPad 目前是预览版,要自己处理签名和侧载。
我觉得手机版看成轻量补充。真正跑长配音、有声书、批量任务,还是桌面端更合适。手机上随手生成一段短语音,或者检查一下项目,这个用法更现实。
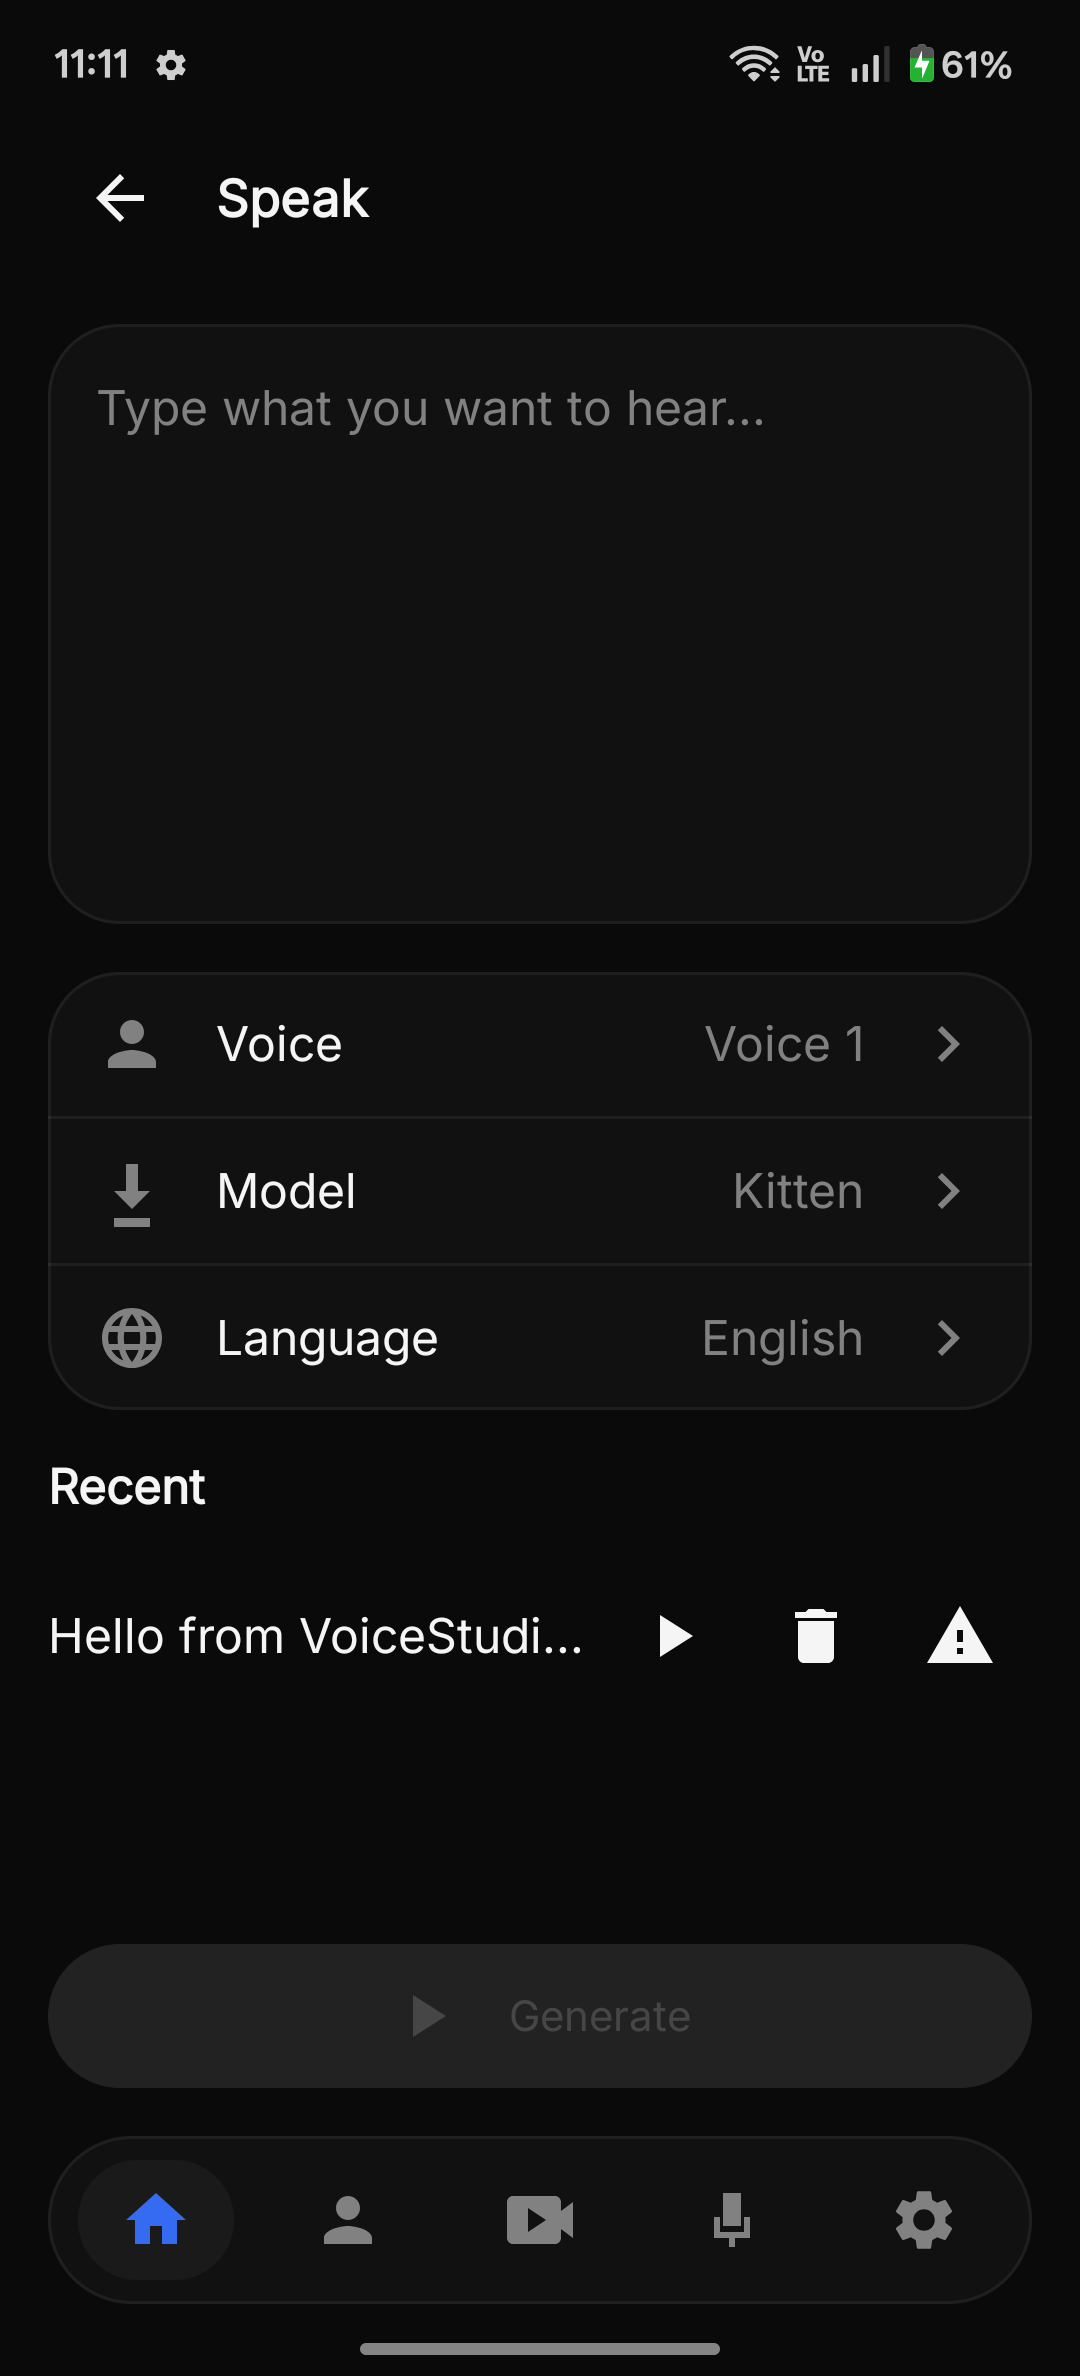 手机端语音生成
支持本地 API 和 MCP
VoiceStudio 后面跑着一个本地服务,默认端口是 3900。它提供 OpenAI 兼容的音频接口、WebSocket 流式转录,也提供 MCP。
Claude Code、Codex、Cursor 这类工具,也能把 VoiceStudio 当成本地语音服务来调。让它转写一段音频,或者用指定声音生成语音,都不用绕到云端 API。
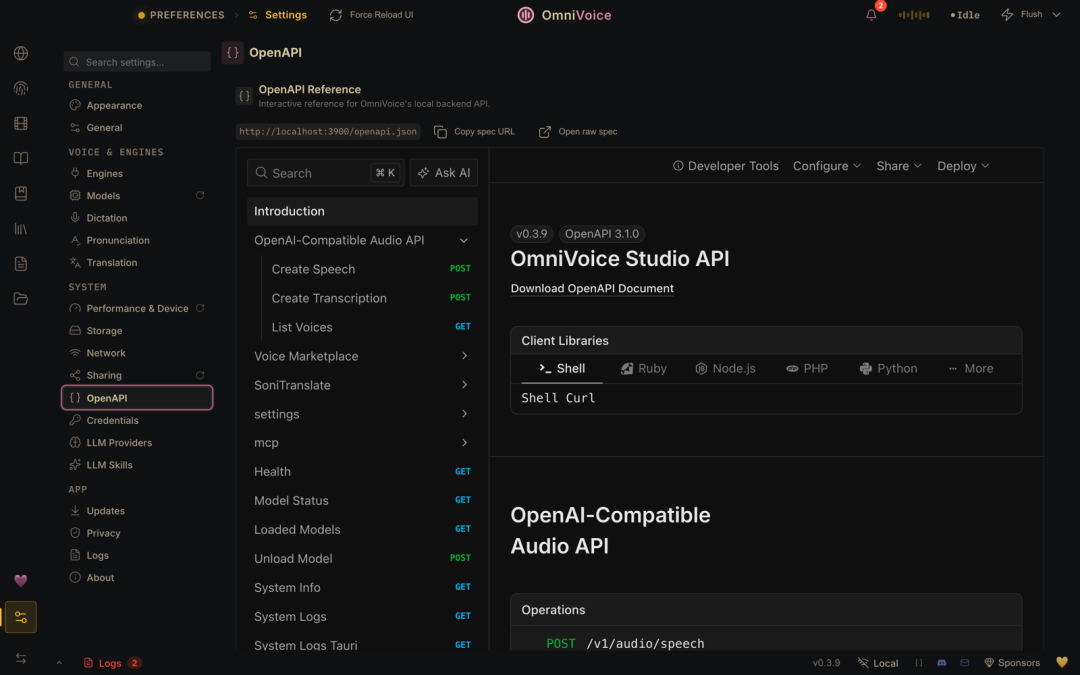 本地 API 文档界面
我觉得开发者愿意点 Star,可能也看重这一点:平时当桌面应用用,写脚本或接代理时又能直接调本地服务。
上手顺序
可以先装桌面稳定版,不折腾源码。第一次只用一段自己录的短音频,生成十几秒中文和英文各一条,听一下音色、停顿和口齿。
确认声音能接受,再丢一个一分钟左右的视频进去跑配音。跑的时候打开设置里的性能和设备信息,看它到底在用 GPU 还是 CPU。很多人以为工具慢,其实是模型悄悄掉到 CPU 上跑了。
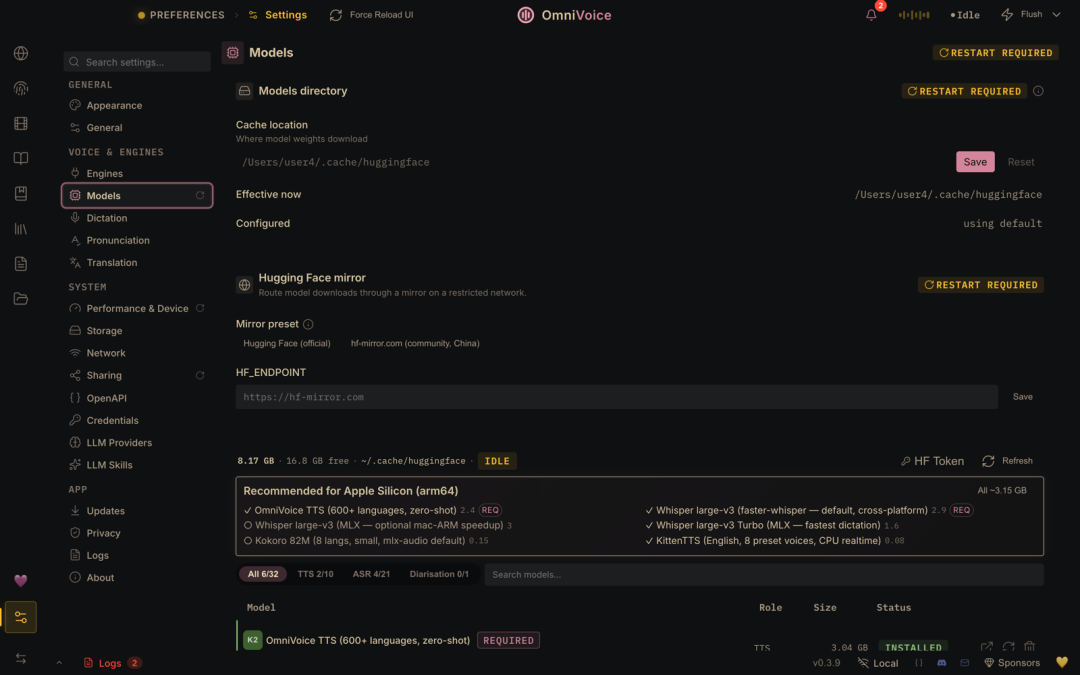 性能和设备状态
如果只是偶尔生成一条配音,云端服务依然省事。要是素材里有客户音频、未公开视频、内部课程,或者生成量大到每次都要算额度,VoiceStudio 默认在本地跑,这类场景就更适合试。
声音克隆、配音这类开源项目其实有很多,但 VoiceStudio 几个月时间干到十几万 Star,连续多次霸榜 GitHub,说明人确实是有东西的,如果你有这方面需求,可以试试这玩意,一般差不了。
开源仓库:debpalash/VoiceStudio



