社区所有版块导航
Python
python开源   Django   Python   DjangoApp   pycharm  
DATA
docker   Elasticsearch  
aigc
aigc   chatgpt  
WEB开发
linux   MongoDB   Redis   DATABASE   NGINX   其他Web框架   web工具   zookeeper   tornado   NoSql   Bootstrap   js   peewee   Git   bottle   IE   MQ   Jquery  
机器学习
机器学习算法  
Python88.com
反馈   公告   社区推广  
产品
短视频  
印度
印度  
Py学习  »  机器学习算法

机器学习系列:深度探秘K线结构新维度

量化投资与机器学习 • 7 年前 • 1641 次点击  

标星★公众号,第一时间获取最新研究

本期作者:光大证券金工团队独家授权

作者:胡骥聪


近期原创文章:

♥ 基于无监督学习的期权定价异常检测(代码+数据)

♥ 5种机器学习算法在预测股价的应用(代码+数据)

♥ 深入研读:利用Twitter情绪去预测股市

♥ Two Sigma用新闻来预测股价走势,带你吊打Kaggle

♥ 利用深度学习最新前沿预测股价走势

♥ 一位数据科学PhD眼中的算法交易

♥ 基于RNN和LSTM的股市预测方法

♥ 人工智能『AI』应用算法交易,7个必踩的坑!

♥ 神经网络在算法交易上的应用系列(一)

♥ 预测股市 | 如何避免p-Hacking,为什么你要看涨?

♥ 如何鉴别那些用深度学习预测股价的花哨模型?

♥ 优化强化学习Q-learning算法进行股市交易

♥ 搭建入门级高频交易系统(架构细节分享)


前言


在金融投资领域下运用机器学习并非易事,许多在看似直观的应用方式下直接套用机器学习算法的做法往往并不能达到预期的效果。在光大金工机器学习系列第一篇报告中我们提出“机器学习能否在金融投资取得成功,更取决于算法之外的细节处理”的理念。本篇报告延续上述思路,探索在运用机器学习算法之前,如何更好地处理交易数据的K线结构。


数据结构特征对机器学习效果有较大影响


数据很重要。这对于研究量化的人几乎是不言自明的。无论是构建模型还是开发因子,研究的进行与验证都需要大量的数据支撑。而机器学习作为一种量化的辅助研究工具(至少目前仅是辅助工具)对于数据的依赖与要求比其它量化工具更高。人脑与机器学习在对数据的处理上各有优劣,人脑的优势在于对数据本身有解释性,例如我们知道应收账款是什么含义、营业收入是什么含义,并能一定程度上理解不同数据间是否有一定的关联逻辑,如果这种关联偏向于线性逻辑,我们往往能通过传统的量化方法逼近它,然而如果这种关联逻辑更偏向于非线性时,用传统量化方法研究的效率就会比较低;而机器学习的优势在于能够更高效地探索不同数据间可能以怎么样的方式关联起来,但它并没有对数据本身的认知。因此它往往需要质量更高数量更大的数据来弥补这一点。

机器学习是通过在训练样本“学习”到数据之间的关联,并外推到新的样本中去。它的外推(或者也称泛化)效果除了受数据本身信噪比大小制约以外,也直接受到新数据与样本数据的特征是否相近的影响。如果数据里不同样本的结构或分布特征有较大差异的话,往往会使得机器学习算法无法有效运作,甚至可能将研究者引向错误的结论。


传统K线结构的统计特征不适合机器学习


交易数据是金融投资领域数据量最大的数据源之一,蕴藏大量的预测信息。为了利用这些非结构化的数据,我们往往会先把这些数据处理成更易处理的K线结构,形成我们常用的量价数据。传统的时间K线使用的是每根K线时间跨度一致的结构化发方式,这种构造方式在传统人工环境、低频环境下有比较直观的好处:人们在处理任何事情时都习惯于以时间为刻度。当我们需要利用机器学习工具在高频数据中探究规律、进行研究时,时间等分切片却未必是一个好的结构化方式。它们往往会面临样本点信息不均,序列自相关性,样本非同方差,收益率非正态分布等问题,这些在低频环境下可能提供一定信息的特质在运用机器学习算法时反而更大概率会影响算法的有效性。

目前基于
高频数据可以构造很多不同的采样切片方式,目前比较主流的方式包括:tick等分K线,成交量等分K线,成交额等分K线,信息量等分K线。其中tick等分K线,成交量等分K线,成交额等分K线的构造方式顾名思义都非常直观。而信息量等分K线的构造方式则依赖于对信息的定义。


不同K线结构的正态性


股票收益率是我们最常使用也最关心的数据之一,在很多研究与模型中(不限于计量经济学、机器学习等)研究者在假定收益率服从正态的基础上作出了许多推导与测试。但简单的测试就能发现传统意义上的股票收益率(时间等分取样下)并不符合正态分布,其密度函数有非常明显的尖峰厚尾的特性。

我们做了较为细致的测试,选取当前上证50成分股中历史较长的四十几只股票在2017年的30分钟等价频率数据作为样本,分别从
偏度、峰度、Jarque-Bera正态测试、Kolmogorov-Smirnov正态测试这4个指标来探讨不同K线结构的正态性。


首先通过K-S检验可以看出无论哪种K线构造,其股票收益率与正态分布的相差甚远,其累计分布函数与正态累计分布函数的最大差值都接近0.5。但比较偏度、峰度与J-B检验的值,可以看出大部分的股票在非时间切片K线上的收益序列要比时间K线上的收益序列更接近正态分布的统计特征。


除了上述股票2017年等价频率30分钟的数据,我们也以2013-1-1到2017-12-31为测试区间,分别统计了股票在5分钟、10分钟、30分钟、1小时这4个等价频率下的正态性数据。结论上:在所有这4种等价频率下,接近正态分布的构造皆为 成交额等分 > 成交量等分 > Tick等分 > 时间等分;而对于所有K线构造,等价频率越低,K线收益率数据就越接近正态分布。对具体数据感兴趣的读者可在深度报告附录中查看详细数据。


不同K线结构的自相关性


除了正态分布假设,还有一些要求偏低的假设也是交易数据很难符合的。其中一个就是非自相关假设。这一条假设大多是隐含在样本点独立这一假设下的。当我们平常说到股票动量或者反转时,实际上已经在利用股票收益的自相关性了。但在使用机器学习工具时,拥有强自相关性这个平常对我们而言有利的状态反而可能制约算法的功能。

探索收益序列的自相关性最直观的方式就是检查其自相关函数各项系数。下图展示了平安银行(000001.SZ)在不同K线构造下的收益序列自相关函数(为方便比较,去除了函数在自变量为0处的值acf(0)=1)。相比与时间K线,非时间K线,尤其是成交量K线与成交额K线,更接近非自相关假设。


我们在测试池里所有股票上验证上述观点,并测试了在不同等价频率下的统计表现。不同K线构造下的收益率自相关性的确有显著的差异,时间K线收益率序列有更为显著的自相关性。


不同K线结构的异方差性


无论是样本同分布假设,还是平稳性假设,都要求样本点符合同方差的要求。这点在许多自然科学的实验样本上相对容易符合,但在金融时间序列上却几乎完全不可能实现。相比于非时间K线,时间K线的异方差现象更为严重。我们可以通过周内波动序列来体现股票收益在不同时期的波动变化。每一周的周内波动是以当周内所有K线的收益率为样本计算方差得到的。我们展示了平安银行(000001.SZ)在2017年内共50周左右的周内波动序列。比较不同K线构造下的周内波动序列曲线,可以看出在接近年末时,时间K线的收益波动远远高于年初的水平,最高时超过年初平均周内波动10倍有余;而其它K线构造下的周内波动序列虽在年末也有明显上升,但整体更为平稳。

为了能较为量化的体现不同K线构造下异方差性的严重程度,我们计算不同K线的方差时间序列自己的方差,若该方差越大,则说明异方差现象越严重。


我们继续在测试池里的股票测试其在2017年的不同K线收益率周内波动方差。除了个别股票以外,其它所有股票在时间K线上的异方差现象都最为严重。大部分股票时间K线收益率的周内波动方差在其余K线构造的3倍以上。同样,在不同等价频率上测试都能等到相似的结论,时间K线上的股票收益率序列异方差现象格外严重。各个股票在不同等价频率K线上的周内波动序列方差详细数据可在深度报告文后附录查看。


在不同K线结构数据上预测波动率变化


在从统计特征角度比较不同K线结构对于机器学习运用上的优劣后,我们通过一个实例来更直观地感受不同K线结构可能带来的影响,仅运用不同K线构造下的量价数据基于一些机器学习算法预测未来股票的波动率变化的方向。

想要预测股票波动率在未来的变化方向,我们需要尽可能地给算法准备有预测能力的解释变量。为了更直观地比较不同K线结构的数据在算法效果上的差异,我们这次只使用与K线相关的数据。最直接的包括以K线收盘价计算的收益率数据,以K线收益率序列标准差计算的历史波动率等。除了以上较为常见的K线数据以外,我们还尝试运用一些需要高频细节构造的K线数据,比如知情交易概率。

在市场交易结构,尤其是市场微观结构这个领域,知情交易概率是业界研究者非常关心的一个议题。在个议题目前最重要的研究成果之一是由Easley,Kiefer,O’Hara和Paperman(EKOP)在1996年论文中提出的PIN指标(Probability ofInformed Trading)。简单来说,如果我们假定一个独立信息出现的概率是 α;出现的消息是好消息与坏消息的概率分别为(1-δ)与 δ;知情交易者进入市场的概率为 μ,并且他们会根据知道的消息是好是坏而作出买入或卖出的交易行为;而非知情交易者作出买入交易行为或作出卖出交易行为的概率皆为 ε。那么知情交易概率PIN有以下计算方式:


传统上 α、δ、μ、ε 这4个参数是由最大似然法来估计得出。由于这种方式在稳定性及敏感性上不够理想,同时在数值计算的过程中也容易碰到各种问题,因此其它估计PIN值的方式也在不断被研究与改进。在这些研究里,Easley,Engle,O’Hara和Wu在2008年的论文中论证了:


其中,V(Bt)指t时段买入的成交量,V(St)指t时段卖出的成交量。在Easley,Prado,O’Hara于2011年发表的论文里将以上结论继续延伸,提出了VPIN指标(Volume-SynchronizedProbability of Informed Trading)。

借鉴前述研究成果,我们尝试利用成交量数据计算知情交易概率数据,对于每一根K线,其PIN值我们 |V_Buy-V_Sell|/(V_Buy+V_Sell) 计算。从比较直观的逻辑出发,如果某个时段内知情交易概率增大,则表明市场内有新的信息进入,市场在接下来一段时期会开始消化这个新信息,从而未来波动率大概率会上升;反之若知情交易概率下降,则市场在未来一段时期波动率大概率会下降。
因此我们分别计算不同K线结构下的知情交易概率,并把其一定长度的序列均值与标准差也作为解释变量输入给机器学习算法。


成交量K线预测波动率变化的效果更好


我们采用几个常见算法分别测试不同K线结构下对未来波动率改变方向的预测,具体设置如下:

  • 测试算法:逻辑回归、支持向量机、随机森林

  • 测试标的:测试池内所有股票逐一测试

  • 训练集区间:2013-1-1 ~ 2016-12-31

  • 测试集区间:2017-1-1 ~ 2017-12-31


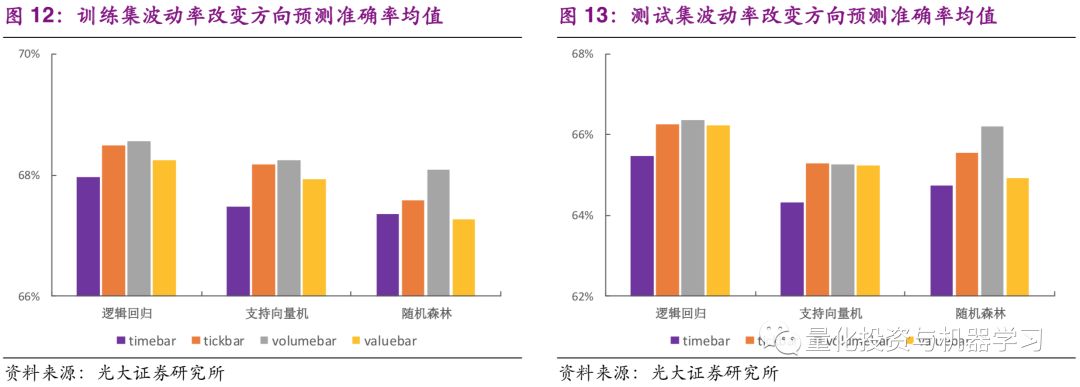
通过观察测试集的准确率,可以发现3种算法都有一定的预测效果,不同股票稍有差异,整体准确率平均在65%左右。比较不同K线结构上的差异,时间K线结构的预测准确率在所有测试的机器学习算法上都是最低的。在逻辑回归与支持向量机模型上,Tick等分K线、成交量K线与成交额K线的预测准确性相差不大;而随机森林算法波动预测模型则明显在成交量K线上有更好的预测结果,但相比与逻辑回归与支持向量机,其Tick等分K线、成交额K线与时间K线的预测效果差异较小。整体来看,波动率改变方向预测在成交量K线上的预测效果最佳。

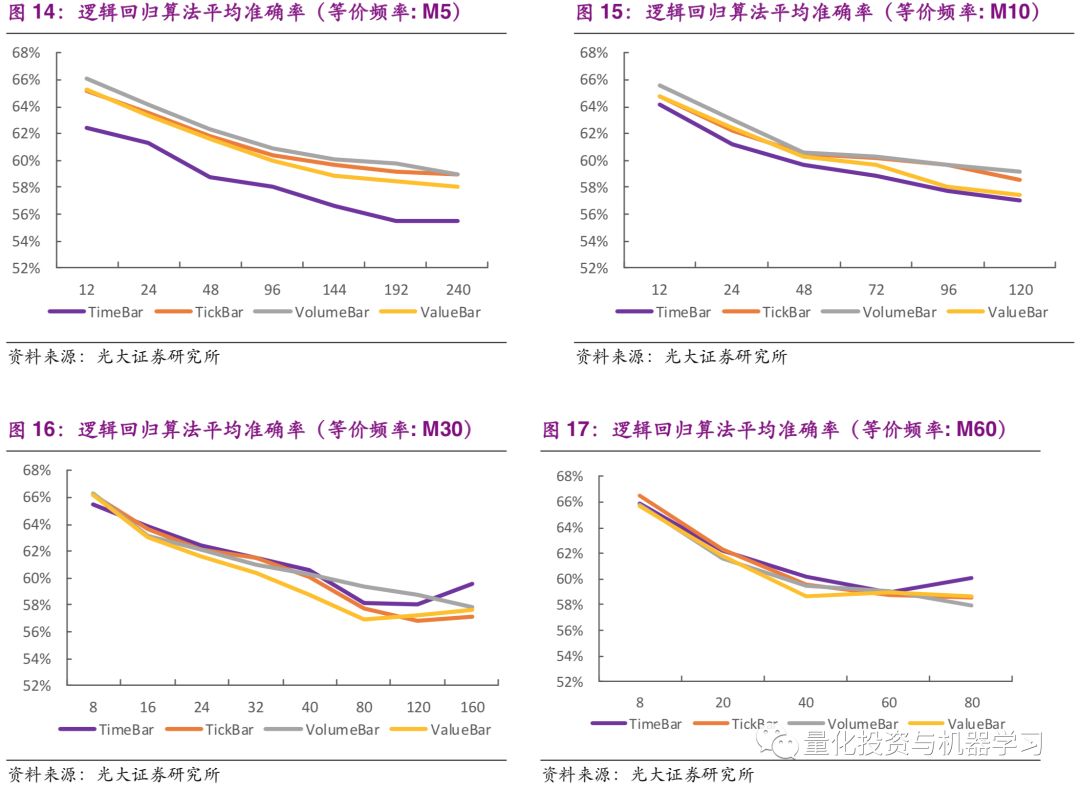
波动率方向预测模型里有两个参数,一个是K线等价频率,一个是波动率(及输入变量)K线窗宽。为了确定其它参数下我们之前观察到的不同K线上效果差异是否还存在,以及差异大小与参数之间是否有联系,我们也测试了其它参数对下的波动预测模型效果。


不同算法模型在参数测试时表现出许多共性特征:


1.    对于所有等价频率与K线结构上,模型的预测准确率基本上都随着窗宽边长而降低。这个可以理解为随着窗宽拉长,所需要预测的未来信息变得更多,其难度也相应增大。


2.    时间K线与非时间K线结构在模型上的表现差异随着等价频率的降低而缩小。在60分钟频率上不同K线结构上的预测效果差异很小。也就是说对于一些机器学习算法,K线结构不同的影响的确更多是在偏高频的领域更为显著,而在偏低频的结构上差异不会很大。


3.    最后,在等价频率较低的30分钟及60分钟频率上,非时间K线模型准确率在窗宽参数上的衰减速率要高于时间K线模型。


不同算法模型的差异则在于:


对数据分布要求更高的逻辑回归与支持向量机算法,高频场景下模型运用在时间K线与非时间K线上,效果有明显差异;而在随机森林算法下这种差异则并不突出。

篇幅原因这里我们在下方展示逻辑回归算法的参数检验,具体的测试数据及其它算法的表现结构可详见深度报告文后附录。


波动率方向预测的应用与启示


上述验证模型预测的标的是波动率,最容易想到的应用场景就在波动率交易策略上。我们在此并不会去构造一个完整的波动率交易策略,我们想要向大家展示与论证的一是该预测可以作为波动率交易的基础信号之一,二是不同K线结构的模型在这种场景下会产生怎样的差异。

要论证上述观点,我们利用股指的历史波动率构造波动率指数,并假设该波动率指数可以被直接交易。之后再根据上一章机器学习算法给出的波动率预测改变方向在每周末相应做多或做空下一周的波动率指数。


预测下一周的波动率,我们选择分别利用等价频率1小时,窗口宽度20的时间K线与成交量K线。用上证50指数2009到2014共6年数据训练SVM模型,并用之于上证50指数2015到2017年的预测上。


从净值图上可以看出波动率方向预测信息一定程度上可以充当波动率交易的信号,而在成交量K线上运用模型的效果相比时间K线更胜一筹。不同K线结构训练出来的模型信号主要在2015年有明显分化。一个重要的原因是由于2015年市场情绪较为亢奋、整体交易更为活跃,此时时间K线的信息结构与之前训练期内的时间K线信息表征有较大差异,因而机器学习在时间K线训练得到的模型在此时失效的概率大增,而成交量K线结构在通过增加交易活跃期间的K线数量,一定程度上使得不同市场环境下的K线信息特征都更为相似。因此,基于成交量K线训练的模型在2015年依然有较稳定的预测效果。而当市场整体环境恢复正常水平时,两种不同K线训练出的模型表现差异不大。


上述测试结论均假设处于较为理想的市场环境中,实际在构建策略的过程中,除了信号本身,还需要处理各种各样的约束条件。随着金融市场不断开放,越来越多金融工具与金融产品被开发,与波动率相关的研究以及合理的机器学习运用也会有更大的舞台。


--End--


扫码关注我们

Python社区是高质量的Python/Django开发社区
本文地址:http://www.python88.com/topic/29241

