来源:VentureBeat
编辑:张佳、大明、向学
【新智元导读】2020年机器学习将如何发展?新年伊始,VentureBeat采访了包括谷歌AI负责人Jeff Dean、PyTorch创始人Soumith Chintala等5位来自顶尖科技公司的负责人,听听他们怎么说。戳右边链接上 新智元小程序 了解更多!
人工智能不再准备有一天改变世界,它正在改变世界。新年伊始,VentureBeat转向了AI领域最敏锐的头脑,重新审视了2019年取得的进步,并展望了机器学习在2020年将如何发展。
受访者包括Google AI负责人Jeff Dean、PyTorch的创始人Soumith Chintala、加州大学教授Celeste Kidd、英伟达机器学习研究总监Anima Anandkumar和IBM研究总监Dario Gil。
每个人对新的一年都有预测,但是这些人正在塑造未来。这些在AI社区中具有权威的人,他们珍视科学追求,他们获得了实至名归的荣誉。尽管一些人预测了半监督学习和神经符号方法等子领域的进展,但几乎所有ML专家都表示同意,2019年,基于Transformer的自然语言模型方面取得了巨大进展,而像面部识别这样的技术继续引起争议。相比看到AI领域准确率的提高,他们更希望看到AI的价值。
先总结一下这次AI专家们预测的一些趋势:
- 随着Transformers推动了巨大的飞跃,自然语言模型的进步是2019年的一件大事。在2020年寻找更多基于BERT和基于Transformer的模型的变体。
- 诸如半监督学习,机器学习的神经符号方法之类的方法以及诸如多任务和多模式学习之类的子领域可能会在未来一年取得进展。
- 与生物统计数据(如语音记录)相关的伦理挑战可能会继续引起争议。
- 诸如量化之类的编译器和方法可能会在PyTorch和TensorFlow这些机器学习框架中作为优化模型性能的方式而流行。
PyTorch创始人Soumith Chintala :机器学习框架走向大融合
PyTorch是当今世界上最受欢迎的机器学习框架。它是2002年问世的Torch开源框架的衍生产品,自2015年发布以来,其扩展工具和库均稳步增长。
今年秋天,Facebook发布了支持量化和TPU的PyTorch 1.3,以及深度学习可解释性工具Captum和面向移动设备的PyTorch Mobile。还有诸如PyRobot和PyTorch Hub等其他产品和工具,可用于共享代码并推进机器学习研究的可重复性。
Chintala在今年秋天在PyTorch开发者大会上曾表示,他认为2019年机器学习领域几乎没有突破性进展。
“实际上,我认为自从Transformer架构问世以来,我们基本上没有什么开创性的新东西……卷积网络在2012年就进入了黄金期,而Transformer则是在2017年左右。当然,这是我的个人看法,”他说。
Chintala表示,DeepMind的AlphaGo在强化学习方面的贡献确实是开创性的,但对于现实世界中的实际任务,很难实现这一结果。Chintala还认为,机器学习框架(如PyTorch和TensorFlow)的发展改变了研究人员的研究思路和方式。
“从某种意义上说,这是一个突破,让研发速度比以前快了一两个数量级。”
今年,谷歌和Facebook的开源框架引入了量化功能,以提高模型训练的速度。在未来的几年内,Chintala认为PyTorch的JIT编译器和Glow等神经网络硬件加速器的重要程度和应用范围都有望实现“爆炸式增长”。
“有了PyTorch和TensorFlow,目前框架的融合过程已经开始。之所以现在框架推出了量化功能,以及其他一系列较低层级的工具,是因为下一场战争是框架的编译器之争。比如XLA,TVM,以及PyTorch的Glow,在接下来的几年中,深度学习框架的焦点将是如何更智能地实现量化,如何更好地促进框架间的融合,如何更有效地使用GPU,如何为新硬件进行自动编译等等。”
Chintala预测,AI社区将在2020年之前将更多精力放在AI模型更广泛意义的性能提升上,不仅仅是精度,也要重视其他因素,比如建立模型所需的能耗、如何解释模型的输出、AI如何更好地反映人们想要建立的社会类型。
“回想过去五六年,我们基本上只是关注准确性,我认为2020年将是我们开始以更复杂的方式思考的一年。”
Jeff Dean领导Google AI已有近两年时间,他已经在Google工作了二十年,是Google许多早期搜索和分布式网络算法的架构师,也是Google Brain的早期成员之一。
Jeff Dean上个月出席NeurIPS 2019,就ASIC半导体设计的机器学习以及AI社区应对气候变化等话题进行了演讲。他预计2020年,多模式学习领域将取得进展,这是一种依靠多种媒体进行训练的AI,而多任务学习则涉及旨在一次完成多个任务的网络。
毫无疑问,2019年机器学习最明显趋势之一是基于Transformer的自然语言模型的持续壮大。Google于2018年开源了基于Transformer的模型BERT。据GLUE排行榜的数据显示,今年发布的许多性能最佳的模型(如Google的XLNet,微软的MT-DNN,Facebook的RoBERTa)都基于Transformer。XLNet 2将于本月晚些时候发布。
他表示:“ 我认为目前的研究路线在生成实用机器学习模型方面非常有成果,现在的机器学习模型比过去能够完成的复杂得多,但未来仍有增长空间。“我们仍然有望创建更多的上下文相关的模型。目前BERT和其他模型可以很好地处理数百个单词,但不能很好处理带上下文的10000个单词。”
Jeff Dean希望今后能够少强调一些最新技术,而倾向于构建更强大的模型。
Celeste Kidd:2020年可能意味着“神经网络不可解释”这一观念的终结
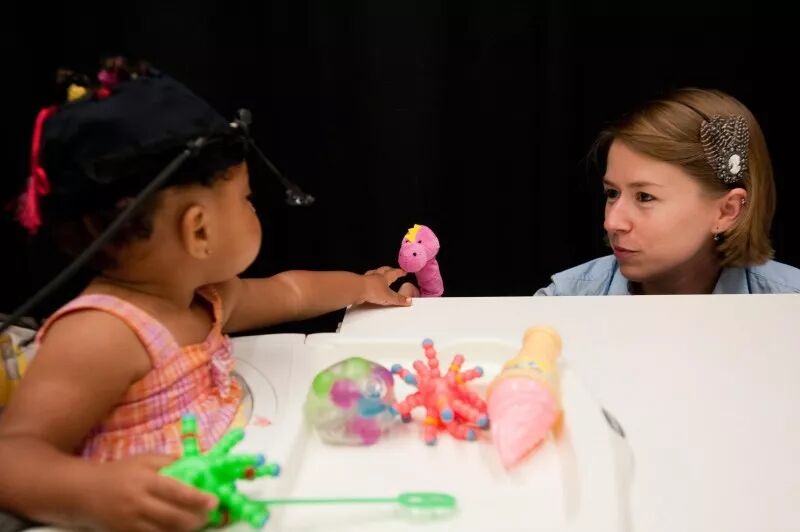
加州大学伯克利分校的发展心理学家,Kidd实验室主管
Celeste Kidd与团队成员在Kidd实验室探索孩子们如何学习。她们的洞察可以帮助神经网络的创造者——正试图用与抚养孩子不太不同的方式来训练模型。
在人工智能领域,“黑盒”一词已经存在多年。它被用来批评神经网络缺乏可解释性,但Kidd认为2020年可能意味着“神经网络不可解释”这一观念的终结。她说:“黑匣子的论点是虚假的……大脑也是黑匣子,我们在理解大脑如何工作的方面取得了很大进步。”
为了解开对神经网络的这种认识,Kidd将目光投向了像MIT-IBM Watson AI Lab的执行主任Aude Oliva这样的人的工作。她说:“我们在讨论这个问题,你可以解剖它们,把它们拆开,看看它们是如何工作的,并对它们进行实验,就像我们理解认知一样。”
在2020年,她希望看到人们更多地意识到技术工具和技术决策在现实生活中的影响,并摒弃工具制造商不对人们使用工具的行为负责任的观点。她说:“我听到很多人试图为自己辩护,说他们自己不是真相的主持人;我认为必须提高人们对这种不诚实态度的认识。我们作为社会人,特别是作为正在开发这些工具的人们,确实需要直接意识到随之而来的责任。”
Dario Gil:神经符号和常识推理是MIT-IBM Watson Lab的一项旗舰计划
IBM研究主管
他预测,在架构的精度降低的情况下使训练更有效率,会取得持续的进展。开发更有效的AI模型是NeurIPS的一个重点,IBM Research在NeurIPS引入了8位精确模型的深度学习技术。
他说:“我们用现有的硬件和GPU架构训练深度神经网络的方式仍然是如此普遍低下。因此,对这此进行真正根本性的反思非常重要。我们必须提高AI的计算效率,这样才能做得更多。”
Gil引用的研究表明,每三个半月对机器学习训练的需求就会翻一番,远远快于摩尔定律预测的增长速度。Gil还对人工智能如何帮助加速科学发现感到兴奋,但IBM的研究将主要集中于机器学习的神经符号方法上。
在2020年,Gil希望人工智能从业者和研究人员把重点放在准确性以外的指标上,以考虑投入生产的模型的价值。
将领域转向构建可信系统,而不是将准确性放在首位,这将是继续采用人工智能的中心支柱。
Gil相信,要想让更多具备数据科学和软件工程技能的人使用人工智能,就必须摆脱这样一种观念——只有少数机器学习的奇才能够做人工智能。他说:“如果我们把人工智能作为一个神话般的领域,只对从事这方面研究的博士开放,那么这并不能真正促进人们对人工智能的使用。”
在未来一年里,Gil对神经符号人工智能特别感兴趣。IBM将寻求神经符号方法来增强概率编程等功能——人工智能在其中学习如何操作程序,以及能够共享决策背后的推理的模型。他认为,通过这些神经符号方法将学习和推理结合起来,其中符号维度嵌入到学习程序中,已经证明可以用所需的一小部分数据来学习。因为学习了一个程序,最终得到了一些可解释的东西;因为有一些可解释的东西,又得到了更可信的东西。
公平性、数据完整性、数据集的选择等问题、“任何与生物识别有关的问题”将继续受到广泛关注,也将继续受到关注。面部识别得到了很多关注,但这只是个开始。语音数据和其他形式的生物识别技术将会越来越敏感。一切与人的身份、生物特征以及人工智能在分析方面取得的进展,都将继续是前沿和中心。
除了神经符号和常识推理(MIT-IBM Watson Lab的一项旗舰计划)外,IBM Research在2020年还将探索AI的量子计算与模拟硬件(超越降低精度的架构)。
Nvidia机器学习研究总监Anima Anandkumar:希望看到更多针对特定行业的文本模型
Anandkumar加入了GPU制造商Nvidia,此前她在AWS担任首席科学家。在英伟达,人工智能研究在多个领域继续进行,从医疗保健的联合学习到自动驾驶、超级计算机和图形学。
英伟达和Anandkumar在2019年的一个重点领域是强化学习的模拟框架,该框架正变得越来越受欢迎和成熟。
在2019年,我们看到了英伟达的自动驾驶平台和Isaac机器人模拟平台的兴起,以及从模拟和生成对抗网络生成合成数据的模型。
去年还迎来了AI的兴起,例如StyleGAN(一种可以使人们质疑自己是看的是计算机生成的人脸还是真实的人的技术)和GauGAN(可以用画笔生成风景)。StyleGAN2 上个月首次亮相。
GAN是可以模糊现实界限的技术,Anandkumar认为,它们可以帮助AI社区解决一些主要的挑战,例如能抓握的机器人手和自动驾驶。
Anandkumar还希望在未来一年内看到迭代算法、自监督和训练模型的自训练方法的进展,这些模型可以通过使用未标记的数据进行自训练来改进。
在2019年8月,英伟达推出了Megatron自然语言模型。Megatron拥有80亿个参数,被誉为全球最大的基于Transformer的AI模型。Anandkumar说,她对人们开始将模型表征为具有个性或字符的方式感到惊讶,并且她希望看到更多针对特定行业的文本模型。
参考链接:
https://venturebeat.com/2020/01/02/top-minds-in-machine-learning-predict-where-ai-is-going-in-2020/
图文直播&在线互动|新智元小程序大咖专访第一期!
1月6日晚,16本Phthon系列教材作者董付国将在新智元小程序揭秘「如何编写有“Python味道”的Python代码?」,当天还有机会与大咖在线互动、答疑解惑,现在扫描下方海报二维码可抢占免费预约名额。