要说贝叶斯和频率学派,那简直太有意思了。为什么这么说呢?因为两个学派的理解对于我来说真的是一场持久战。我是在学习机器学习的时候接触到的这两个学派,此前并不知道,当时就被深深吸引了,于是找了各种资料学习下来,说实话感觉有点懂了,但又感觉没理解透。
后面我一直是带着这种似懂非懂的状态继续肝机器学习。但随着不断深入学习我发现很多理论其实都有出现两个学派的身影,而且在模型算法层面结合两派不断琢磨对我的理解有了很大帮助,经常有茅塞顿开的感觉(那段日子真的进步的飞起)。
虽说我有点笨,但好在经过时间的沉淀和积累,也算让我对两个学派有了更深层次的理解。因此,基于我自己的学习情况,把自己的一些理解也分享出来,供参考。
首先,我先抛出一个总的观点:贝叶斯学派和频率学派需要辩证去看,没有对错。两个学派就像太极一样,所谓你中有我,我中有你,相辅相成,相互成就。
下面分别阐述二者的联系和区别,如果有一点启发就好。
频率学派
1、频率学派的核心思想
频率学派相信概率是一个确定的值,讨论概率的分布没有意义。虽然没有上帝视角,还不知道具体的概率值,但相信概率就是确定的,它就在那里。而数据是由这个确定的概率产生的,因此数据是随机的。
现实中,我们往往可以获取的是随机的数据,而对于产生数据的概率是不知道的。既然相信概率是确定的,也想求概率,那我们该如何做呢?
自然可以想到,要通过观察概率产生的随机数据去反向推导这个概率。举个例子。比如我想知道一种疾病的生还概率,那么通过观察10个人,我发现其中9个都死了,那我现在就说生还概率是10%(简单粗暴)。
上面就是通过频率计算来推出概率的简单过程。但这样的计算结果非常不精准,因为10个人太少了,不具有统计代表性。那我把观察人数增大到100人、1000人...10万人呢?结果又如何?
说到这里,你应该有一些sense了,随着样本容量不断扩大到足够大甚至无穷大时,这个统计结果才有意义。也就是说,频率学派所说的概率表示的是事件发生频率的极限值。当重复试验的次数趋近无穷大时,事件发生的频率会收敛到真实的概率之上。
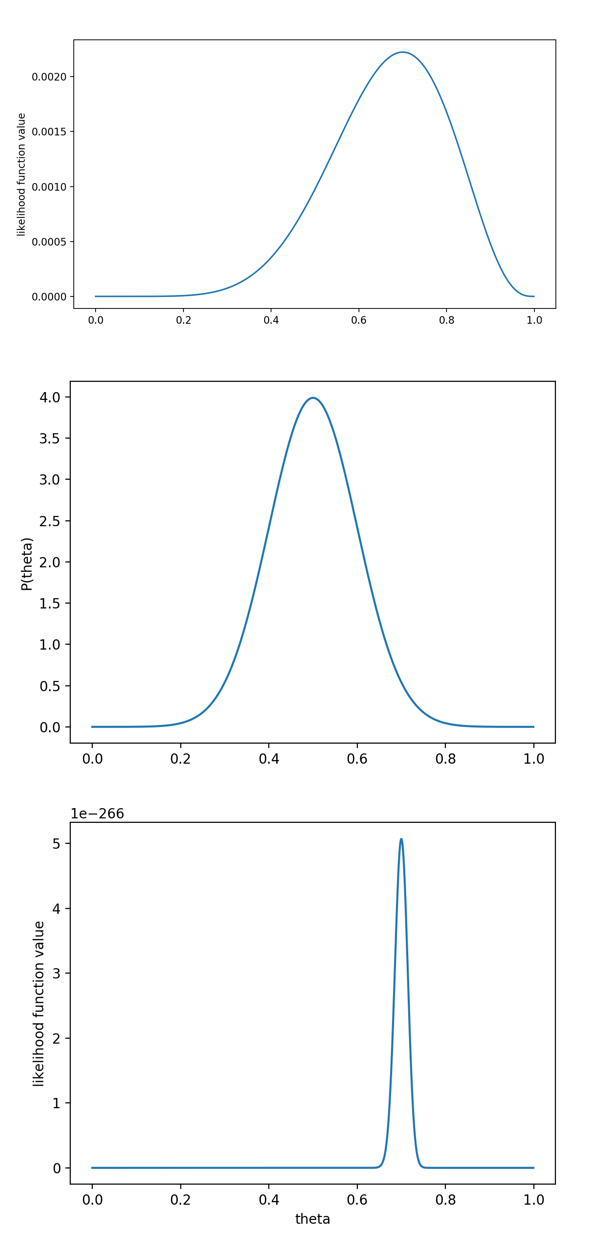
下面可以看到,随着随机事件的次数不断增大,最终待估计值会收敛到真实值上。
看到这里或许你会提问,如果观测样本有限,那真实的概率还会精准吗?
答案是不一定。仍用上面的例子,假如我们安排了100组进行测试,每组100人,那么通过这100组所得到的概率可能都是不一样的,有的或许接近真值,有的或许偏离真值,而这都是随机的,完全取决于这组的数据是什么样的。这里所说概率可能不一样是因为有限的随机数据导致的,这个锅不应该由概率来背,谁让你数据量不够呢,真实的概率还是确定的。
为此,频率学派使用置信区间来度量随机样本的估计值和真实值之间的偏差。就是说100组的置信区间里面有多少个是包括了真实值的。
2、机器学习中的频率学派
上面就是频率学派的一般思想了。为了加深理解,这里我再额外扩展一下机器学习中的频率学派的应用。
假设我们讨论有监督学习的参数模型,那么整个过程就是用训练数据拟合出一组参数来,即形成一个模型,然后再预测未来的数据。因此,这里的核心是求出参数。
机器学习中频率统计的应用也是一样的,只不过不求概率了,而是求参数。这就引出了另外一个概念似然函数。似然和概率意思差不多,区别是这样的。
对于一个函数:
输入有两个: 表示某一个具体的数据; 表示模型的参数。
如果 是已知确定的,求 ,这个函数叫做概率函数(probability function),它描述对于不同的样本点 ,其出现概率是多少。
如果 是已知确定的,求 ,这个函数叫做似然函数(`likelihood function), 它描述对于不同的模型参数 ,出现 这个样本点的概率是多少。
看到上面你就应该知道了,频率学派的思想没有变化,只是调换了一下位置,改为求参数(相信参数是确定的)。
由此,又可以展开最大似然估计,频率统计中最常使用的最优化方法,即让似然概率最大化,也就是固定参数的前提下,数据出现的条件概率最大化。比如,在逻辑回归参数模型中使用。
贝叶斯学派
1、贝叶斯学派的核心思想
相对于频率学派,贝叶斯学派思想恰恰相反。
贝叶斯认为待估计值的概率是随机的变量,而用来估计的数据反过来是确定的常数,讨论观测数据的概率分布才是没有意义的。
仍以机器学习应用为例,把上面的话翻译过来就是,我们并没有什么上帝视角,怎么会知道最后求得的参数就是实际的真实值呢?另外,如果观测的事件不是随机的变量,而是确定的,那么频率学派对概率的解读就是不成立的。
还是拿疾病的生还概率问题举例,假如频率学派通过观察估计概率是10%,但是贝叶斯觉得这10%简直就是bull shit,是不准确的。因为通过自己的常识和认知,这个疾病的生还概率至少也应该在50%以上才对,10%的概率太低了,不太可能。
因此,贝叶斯学派给出了一个更加通用的概率定义:概率表示的是客观上事实的可信程度,也可以说成是主观上主体对事件的信任程度,它是建立在对事件的已有认识基础上的。
下面来看一下贝叶斯定理。公式如下:
上面所说的主观认识其实就是贝叶斯定理中的先验概率,即;是似然概率;是后验概率。
这个公式的解读就是:对于一个事件 ,我先有了一定的主观认识,并将 作为初始的可信程度。我现在得到了与 事件相关的数据 ,我想通过 作为证据进一步去验证我的初始判断,即 。通过验证得到的结果就是后验概率 ,这个结果可能是好,也可能是坏。
所以,贝叶斯定理的意义就是将先验概率和后验概率关联起来,刻画了数据对于知识和信念的影响。
2. 贝叶斯加强理解
为了加强理解,我现在把上面贝叶斯的公式做一个简单的变换:
举个例子。你听到一辆摩托车的警报响了,你的第一反应是什么?
有小偷?撞车了?都不是,你通常什么反应都没有。因为警报响实在是太正常了,每天都要发生好多次。本来,汽车警报设置的功能是,出现了异常情况,需要人关注。然而,由于虚警实在是太多,人们渐渐不相信警报的功能了。就像狼来的故事一样。
假设响警报的目的就是想说汽车被砸了。把 视作汽车被砸了, 视为警报响了。带进贝叶斯公式里,我们要求等式左边发生的 ,意思是说警报响了,汽车也确实被砸了的概率。
结合我们变换的公式来看,汽车被砸引起警报响,即 。但是,也有可能是汽车被小孩子皮球踢了一下、被行人碰了一下等其他原因(统统计作 ),其他原因引起汽车警报响了的概率,记为 。因此,这些所有的原因合起来才是警报响了的总概率,即 。
那,现在我问,如果突然听见警报响了,这时汽车已经被砸了的概率是多少呢?
其实这也就是问,警报响这个证据有了,多大把握能相信它确实是在报警说汽车被砸了?从这个角度理解,贝叶斯公式就是在描述:你有多大把握能相信一件证据。
前面也说了,后验概率的结果可能是好,也可能是坏。为了加强我们的先验概率,所以我们必须提高证据的概率,就像警报的例子中,我们需要让 ,即杜绝了汽车被球踢、被行人碰到等等其他所有情况,那自然,警报响了,只剩下一种可能:汽车被砸了,这就提高了响警报这个证据的说服力。
但如果 很小,即汽车被砸的概率本身就很小,那么 仍然很小, 还是大不起来。也就是说如果 的先验概率很小,就算 较大,可能 的后验概率 还是不会大。因此,贝叶斯的先验分布概率非常重要,要想后验概率大,需要 和 同时大,这就涉及到最大后验概率估计的概念了。
从这个角度思考贝叶斯公式:一个本来就难以发生的事情,就算出现某个证据和他强烈相关,也要谨慎。证据很可能来自别的虽然不是很相关,但发生概率较高的事情。
当然对于贝叶斯的理论还有很多东西可以研究,真的非常强大。如果机器学习从判别式和生成式的角度考虑又是一庞大的分类。在此提供一本书籍:经典书最新版《贝叶斯数据分析(第三版)》
总结
我觉得这是个值得反复琢磨,很有意思的事情。因为本身就没有谁对谁错,只是立场不同,考虑问题的角度不同,我们更应该辩证的去理解和加以应用。
以上就是个人一些粗浅的理解,感谢各位的在看、点赞、分享。
[1] https://blog.csdn.net/u011508640/article/details/72815981
本站qq群851320808,加入微信群请扫码: