最近金融市场辗转波动,年初入场的小伙伴也许还在等待市场的回暖。面对错综复杂的市场环境,如何才能通过技术手段,更快更好判断市场的变化,提前行动,是每一个会编程或想学编程的基民共同追求的目标。
本文利用Python语言及相关库,尝试采集天天基金贴吧50W+帖子数据并分析投资者情绪,让你更快洞察金融市场变化。
我们首先挑选一只白酒基金,看看这只基金贴吧的数据,网址及网页内容如下:
http://guba.eastmoney.com/list,of161725.html
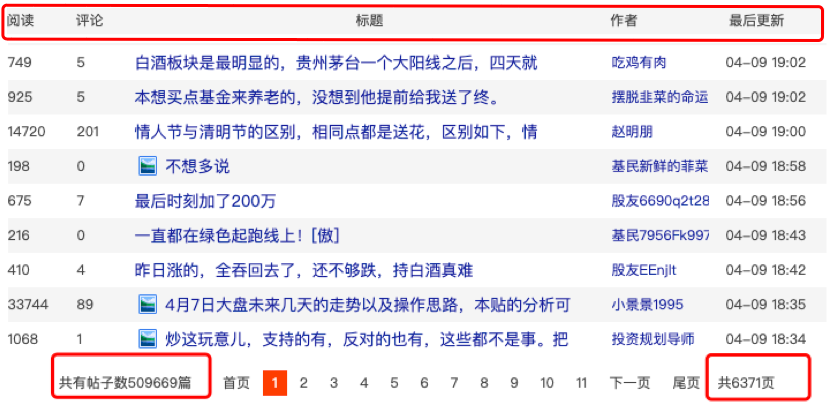
由上图可知,该基金共有6371页合计509669条讨论记录,且还在不断更新。数据字段包括阅读、评论、标题、作者、最后更新(评论时间)。点击下一页,URL变为:
http://guba.eastmoney.com/list,of161725_2.html
这个URL规则比较简单,只需设置基金代码参数和页码参数来拼接URL,即可爬取任意基金贴吧数据。
本文爬虫主要使用的requests库,首先导入爬虫相关包:
import csv
import time
import random
import requests
import traceback
from time import sleep
from fake_useragent import UserAgent
from lxml import etree
尝试请求一页数据,尽量设置随机睡眠时间和使用随机生成的headers,这是爬虫人最基本的道德修养,也是最简单的防反爬措施:
page = 1 #设置爬取的页数
fundcode = 161725 #可替换任意基金代码
sleep(random.uniform(1, 2)) #随机出现1-2之间的数,包含小数
headers = {"User-Agent":UserAgent(verify_ssl=False).random}
url = f'http://guba.eastmoney.com/list,of{fundcode}_{page}.html'
response = requests.get(url, headers=headers, timeout=10)
print(reponse)
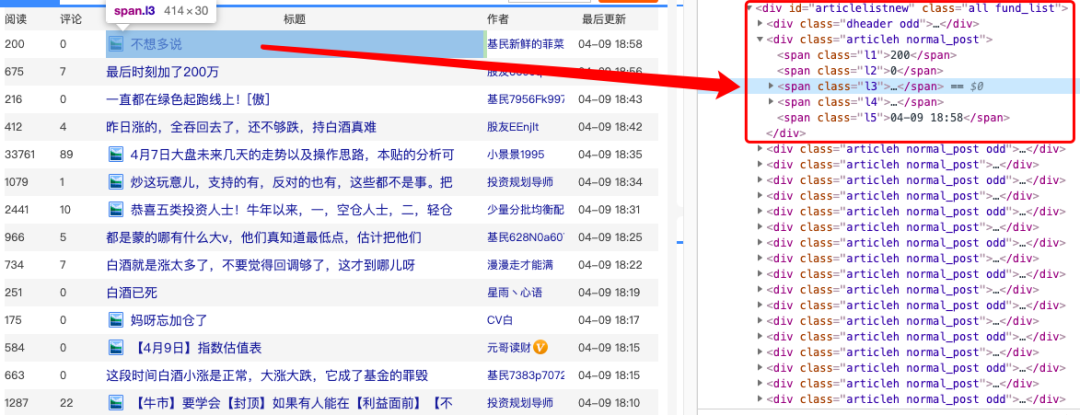
网页结构还是很简单的,数据存放在id为articlelistnew的div下,该div下的第一个div为标题行,因此从第二个div解析数据即可。本文采用xpath解析,其他解析方式也很简单。parse = etree.HTML(response.text) # 解析网页
items = parse.xpath('//*[@id="articlelistnew"]/div')[1:91]
for item in items:
item = {
'阅读': ''.join(item.xpath('./span[1]/text()')).strip(),
'评论': ''.join(item.xpath('./span[2]/text()')).strip(),
'标题': ''.join(item.xpath('./span[3]/a/text()')).strip(),
'作者': ''.join(item.xpath('./span[4]/a/font/text()')).strip(),
'时间': ''.join(item.xpath('./span[5]/text()')).strip()
}
print(item)
with open(f'./{fundcode}.csv', 'a', encoding='utf_8_sig', newline='') as fp:
fieldnames = ['阅读'
, '评论', '标题', '作者', '时间']
writer = csv.DictWriter(fp, fieldnames)
writer.writerow(item)
爬取多页数据并将爬虫代码封装成函数,另外,建议在各代码段加入异常处理,以防程序中途退出:# 主函数
def main(page):
fundcode = 161725 #可替换任意基金代码
url = f'http://guba.eastmoney.com/list,of{fundcode}_{page}.html'
html = get_fund(url)
parse_fund(html,fundcode)
if __name__ == '__main__':
for page in range(1,6372): #爬取多页(共6371页)
main(page)
time.sleep(random.uniform(1, 2))
print(f"第{page}页提取完成")
本文数据处理分析部分主要使用pandas库。数据爬取完成后,我们就可以开始分析数据了,首先导入数据:import pandas as pd
import numpy as np
df = pd.read_csv("/菜J学Python/金融/天天基金/161725.csv",
names=['阅读', '评论', '标题', '作者', '时间'])
#重复和缺失数据
df = df.drop_duplicates()
df = df.dropna()
#数据类型转换
df['阅读'] = df['阅读'].str.replace('万','').astype('float')
df['时间'] = pd.to_datetime(df['时间'],errors='ignore')
#机械压缩去重
def yasuo(st):
for i in range(1,int(len(st)/2)+1):
for j in range(len(st)):
if st[j:j+i] == st[j+i:j+2*i]:
k = j + i
while st[k:k+i] == st[k+i:k+2*i] and k k = k + i
st = st[:j] + st[k:]
return st
yasuo(st="J哥J哥J哥J哥J哥")
df["标题"] = df["标题"].apply(yasuo)
#过滤表情
df['标题'] = df['标题'].str.extract(r"([\u4e00-\u9fa5]+)")
df = df.dropna() #纯表情直接删除
#过滤短句
df = df[df["标题"].apply(len)>=3]
df = df.dropna()
先制作一个词云图,看看大家对于这只基金的看法:
import jieba
import stylecloud
from IPython.display import Image
# 绘制词云图
text1 = get_cut_words(content_series=df['标题'])
stylecloud.gen_stylecloud(text=' '.join(text1), max_words=200,
collocations=False,
font_path='simhei.ttf',
icon_name='fas fa-heart',
size=653,
#palette='matplotlib.Inferno_9',
output_name='./基金.png')
Image(filename='./基金.png')
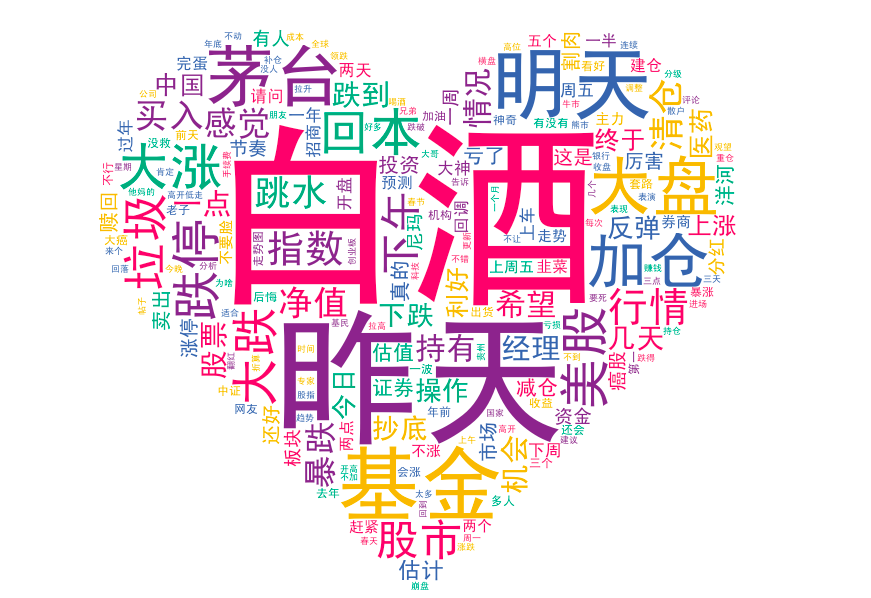
好像很难明显看出基民们的情绪......
于是,继续用更为量化的方法,计算出每个评论的情感评分:
import paddlehub as hub
senta = hub.Module(name="senta_bilstm")
texts = df['标题'].tolist()
input_data = {'text':texts}
res = senta.sentiment_classify(data=input_data)
df['投资者情绪'] = [x['positive_probs'] for x in res]
对数据进行重采样:
#重采样至15分钟
df['时间'] = pd.to_datetime(df['时间'])
df.index = df['时间']
data = df.resample('15min').mean().reset_index()
通过AkShare这一开源API接口获取上证指数分时数据,AkShare是基于Python的财经数据接口库,可以实现对股票、期货、期权、基金、外汇、债券、指数、数字货币等金融产品的基本面数据、历史行情数据的快速采集和清洗。
import akshare as ak
import matplotlib.pyplot as plt
sz_index = ak.stock_zh_a_minute(symbol='sh000001', period='15', adjust="qfq")
sz_index['日期'] = pd.to_datetime(sz_index['day'])
sz_index['收盘价'] = sz_index['close'].astype('float')
data = data.merge(sz_index,left_on='时间',right_on='日期',how='inner')
matplotlib.use('Qt5Agg')
data.index = data['时间']
data[['投资者情绪','收盘价']].plot(secondary_y=['close'])
plt.show()
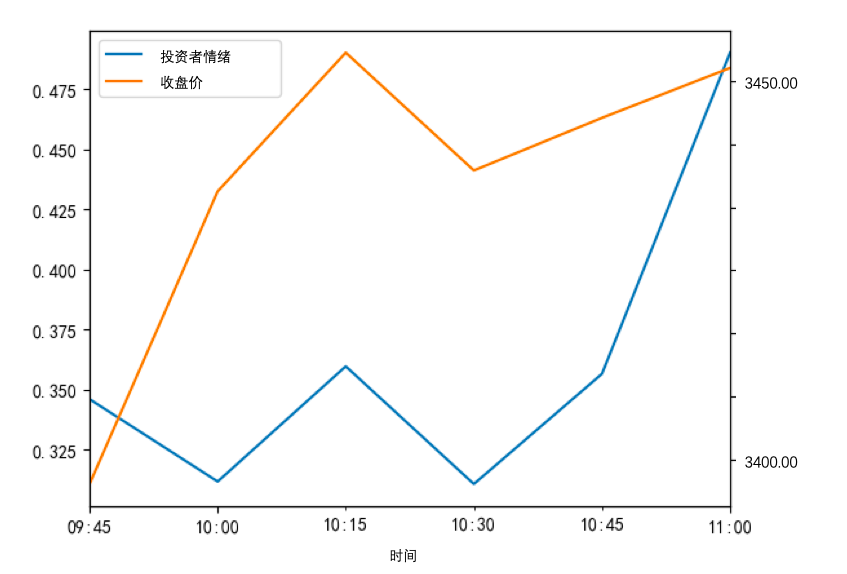
可以看出,投资者情绪相对于上证指数存在一个滞后效应。
以上就是我们对基金贴吧里帖子数据进行处理并进行分析的全过程。
如果文章对你有帮助,欢迎转发/点赞/收藏~
作者:J哥
_往期文章推荐_