第一篇文献:Data augmentation for graph neural networks [5],这篇文章关注的是节点分类的图数据增强,目的是提升节点分类的效果。
在图上做数据增强,和CV,NLP不同的点是无法直接把传统CV数据增强技术直接应用到图上。比如CV中的图片可以通过旋转获得新图片,但图数据的旋转并没有改变图。另一个主要的问题是对于节点分类的任务,数据是通过节点和节点连接的。图片分类中的图片之间是没有关系的,改变其中一个不会影响其他的,只会影响改变的图片。但对于图数据,节点的改变会影响该节点以及它的邻域,甚至它邻域的邻域。因此对于这种互相依赖的数据,不能直接应用CV或NLP数据增强。在这个工作中,我们提出通过加减边来进行图数据增强,也就是加一些图里没有的边,并从现有的边里面删除一些的操作。
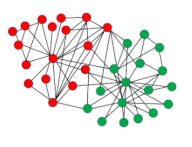
以扎克的跆拳道俱乐部这个社交网络为例。这个数据中节点的不同颜色代表了二分类的标签。图中有30多个节点,对每个节点随机生成二维属性,将其可视化如右图。
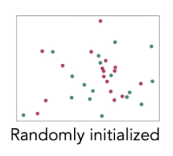
属性是随机初始化的,将上述两幅图过一个随机GCN层,可得到:
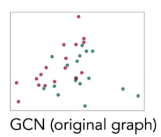
这里的GCN层没有经过训练,GCN层中的参数是随机初始化的。将随机初始化的特征过一个随机初始化的GCN,可以看出,在上图中的节点在二维平面上的分布已经有一些分离,左上角大部分是红色点,右下角大部分是绿色点。这因为图本身有非常强的同秩性(homophily):原图中红色节点的大部分邻域是红色节点,绿色节点的大部分邻域是绿色节点。同秩性导致不需训练GCN就能对节点有一定的分离程度。
如果随机挑6个类内的边加上去,再随机挑6个类间的边拿掉:
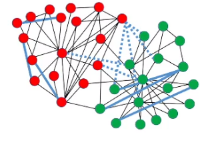
上图中较粗的蓝线是新加的边,蓝色虚线表示去掉的边。将改动过的图还是用一样的随机属性过随机初始化的GCN:
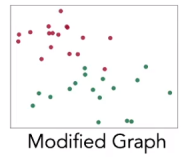
可以发现它已经可以很不错地分离了,所有的红色点都在一边,所有的绿色点都在另一边。这是因为改动后的图有了更强的的同秩性导致的。如果极端一点把所有相同类的节点都连在一起,将所有类间的边全部删掉:
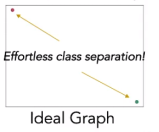
所有的红色点都会聚到一个点,所有的绿色点也会聚到另一个点。这个在论文中有证明。
但是这种加减边要知道节点的标签,它们是否属于同一类,才能知道增加或删除哪条边。但在真正的学习过程中模型是不知道应该加哪条边,删哪条边的。但好在图机器学习可以帮助我们做的比随机加减边更好。
因此,我们提出了GAug-M模型:先改动图,然后在此基础上学习。在原图上先训练一个链路预测的模型,链路预测模型对所有的点对都可以得到两个点之间存在边的概率。对概率特别高但是现在图中没有边的点对,加边将它们连接起来;对概率特别低但现在图中有边的点对,删掉这个边。然后加边的数量和删边的数量我们利用两个超参控制改动程度的大小。这种简单的操作就可以得到很好的节点分类效果,如下图:
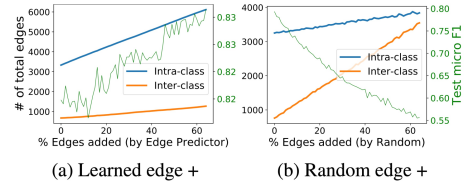
蓝色的线代表类内的边的数量,橙色的线代表类间的边的数量,绿色的线代表它的节点分类的效果。可以看到,我们通过链路预测模型在加边的情况下,主要加的是类内的边。因为这个模型不是完美的,可能会有失误加一些类间的边,但蓝色的线走的更快说明加了更多类内的边,绿色的线随着图的同秩性越来越强也在不断地增长。与之对比的是,如果随机的加边会怎样?我们发现随机加边的话,更多的边会是类间的边,会损害图的同秩性,将得到一个更差的节点分类结果。
通过GAug-M模型改图得到一个更好或更容易训练的图,但它存在一个问题就是图神经网络很注重的inductive learning。当数据发生改变后,GAug-M需要重新训练一个链路预测模型,然后利用这个模型修改图数据,改完后重新训练图神经网络。如果数据一直在变动,这个操作会非常昂贵,我们不希望这样。所以虽然GAug-M在静态数据中效果很好,针对这个问题,我们提出了GAug-O模型。
GAug-O是端到端的模型,当它训练好以后,只要输入一个图,就能得到这个图的节点分类预测结果。因此,它对于新加入的数据不需要去重新做一个完成的训练。GAug-O的设计思路和之前模型的设计思路是一样的,但它会稍微复杂一些。输入的图会先过一个链路预测模型,得到一个密集的边存在概率矩阵,把它和原来的邻接矩阵加在一起采样,得到一个改过的邻接矩阵,然后把改动过的邻接矩阵输入到图神经网络中得到节点分类。这个过程如下图:
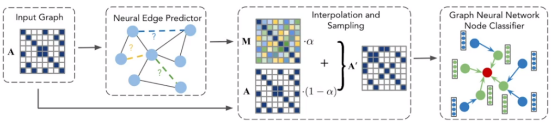
在GAug-M中,改动图的方法是把概率最高的边加上,概率最低的边去掉,但是这个操作离散且不可导。在端到端的模型中这种操作会使得链路预测模型无法得到训练。所以只能把确定性的加减边变成取样操作,然后把概率和原来的邻接矩阵加起来,保证采样结果不会太偏。得到加权重的概率后,在每一个点对的概率上进行伯努利取样。由于伯努利取样也是离散的,在实际设计方法时用的是Gumbel-softmax加straight-through的设计。通过这样的技术手段实现整个模型端到端的训练。
由于训练中有两个模型,即链路预测模型和节点分类模型,都是有参数需要训练的。所以文章中使用两个损失函数,包括节点分类的损失函数和链路预测的损失函数,通过同时训练可以得到相互增强。
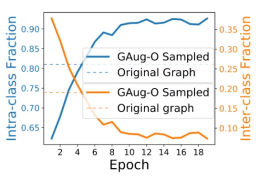
GAug-O和GAug-M一样,训练过程以及取样的图会有更多的类内的边和更少的类间的边。下图的蓝线是类内的边在所有图中所占的比例,可以发现随着GAug-O训练的进行,类内的边数有一个非常快速的上涨,最终稳定在一个比较大的值,这意味着我们确实做到了增强图的同秩性。
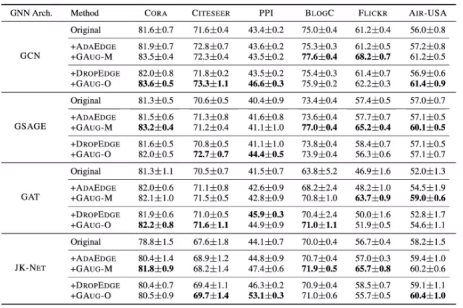
分析实验结果时使用6个常见的公开数据集,数据增强的模型对使用哪种图神经网络没有严格要求。使用4个常见的图神经网络,包括GCN,GSAGE,GAT和JK-NET,在6个数据集上都能得到很好的效果。
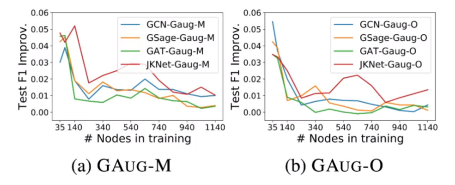
在数据稀疏时经常会面临训练数据或训练用的标注数据减少的问题。所以,我们测试了在训练数据更少的情况下模型的性能。可以看出训练数据非常少的时候,模型有更明显的提升。