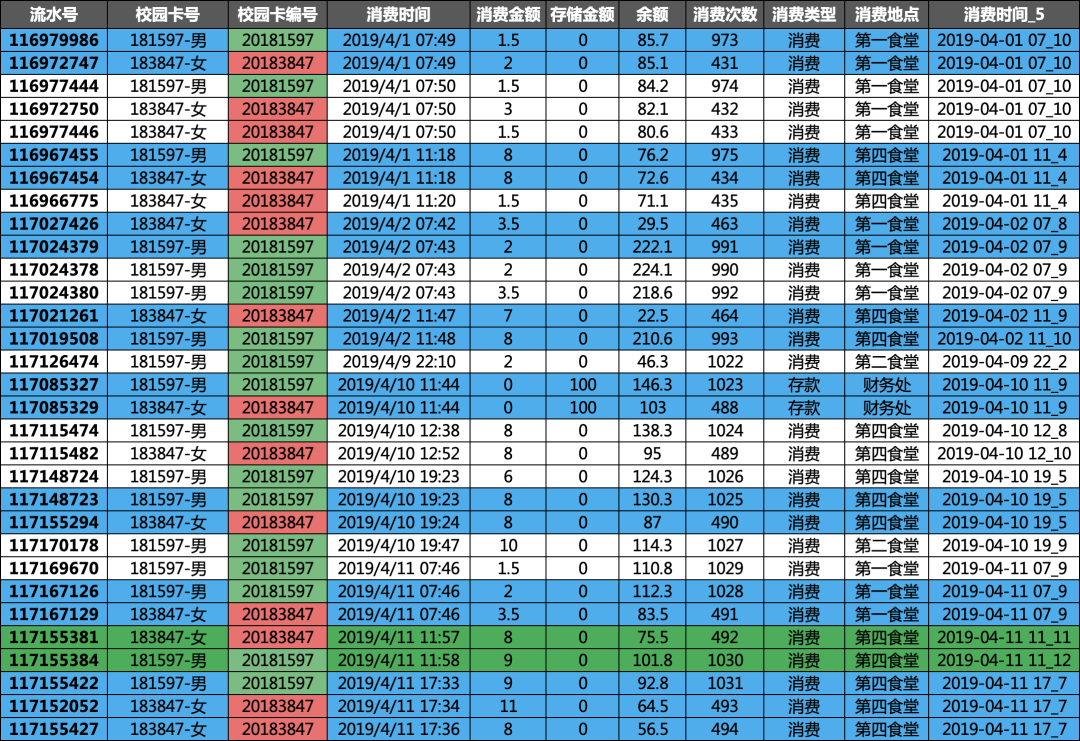
故事从校园一卡通开始,校园一卡通是集身份认证、金融消费、数据共享等多项功能于一体的信息集成系统,也就是学生卡。积累了大量的历史记录,其中蕴含着学生的消费行为和财务状况等信息。是一个数据分析比赛的数据,很多报告都是从消费金额、消费地点、消费时间等角度分析,比较常规。但是数据,其实还可以更有趣。
本次使用南京理工一卡通的消费明细,我会从一个全新的角度出发,挖掘其中的情侣、基友、渣男、单身狗,大家可以把类似的方法扩展到风控领域使用,这种挖掘思路可以用到反欺诈、反舞弊等场景,思路比较新颖,具有较大的研究价值。
那我们开始,看看时序数据怎么利用关联规则进行挖掘,使用的数据集地址如下:https://github.com/Nicole456/Analysis-of-students-consumption-behavior-on-campus
如果没时间看看全文,直接跳到第五数据解读的环节。
一、数据集介绍
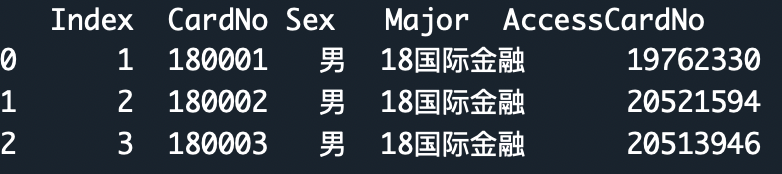
附件是某学校 2019年 4月 1 日至 4月 30日一共30天的一卡通数据,一共3个文件,数据字段和含义分别如下
data1.csv:校园卡基本信息
包含的字段有:['序号', '校园卡号', '性别', '专业名称', '门禁卡号']
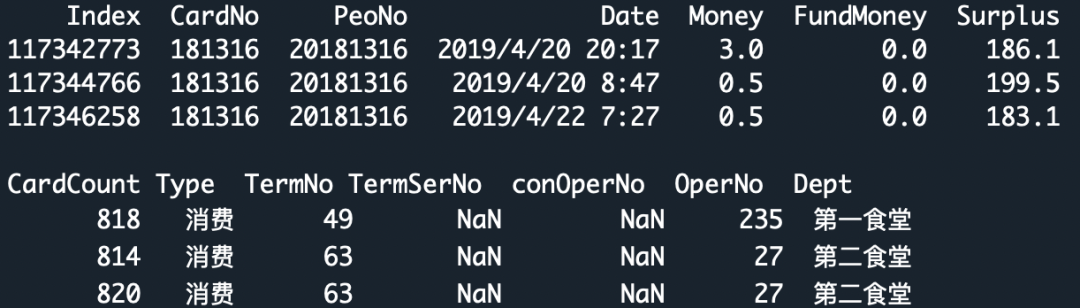
data2.csv:校园卡消费明细
['流水号', '校园卡号', '校园卡编号', '消费时间', '消费金额', '存储金额', '余额', '消费次数', '消费类型', '消费项目编码', '消费项目序列号', '消费操作编码', '操作编码', '消费地点']
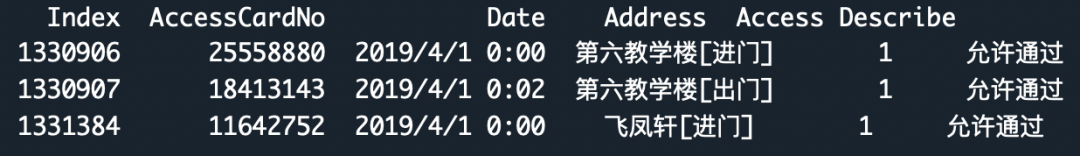
data3.csv:进出门禁详情
['序号', '门禁卡号', '进出时间', '进出地点', '是否通过', '描述']
二、数据读取
# 数据读取import numpy as npimport pandas as pdimport os
pd.set_option('display.max_columns', None)os.chdir('/Users/wuzhengxiang/Documents/DataSets/students')data1 = pd.read_csv("data1.csv", encoding="gbk")data2 = pd.read_csv("data2.csv", encoding="gbk")data3 = pd.read_csv("data3.csv", encoding="gbk")
data1.columns = ['序号', '校园卡号', '性别', '专业名称', '门禁卡号']data2.columns = ['流水号', '校园卡号', '校园卡编号', '消费时间', '消费金额', '存储金额', '余额', '消费次数', '消费类型', '消费项目编码', '消费项目序列号', '消费操作编码', '操作编码', '消费地点']data3.columns = ['序号', '门禁卡号', '进出时间', '进出地点', '是否通过', '描述']
print(data1.head(3))序号    校园卡号 性别    专业名称      门禁卡号0   1  180001  男  18国际金融  197623301   2  180002  男  18国际金融  205215942   3  180003  男  18国际金融  20513946
print(data2.head(3))流水号      校园卡号     校园卡编号             消费时间  消费金额  存储金额     余额  消费次数  \0  117342773  181316-女  20181316  2019/4/20 20:17   3.0   0.0  186.1   818   1  117344766  181316-女  20181316   2019/4/20 8:47   0.5   0.0  199.5   814   2  117346258  181316-女  20181316   2019/4/22 7:27   0.5   0.0  183.1   820
  消费类型  消费项目编码 消费项目序列号  消费操作编码  操作编码  消费地点 性别  0   消费      49     NaN     NaN   235  第一食堂  女  1   消费      63     NaN     NaN    27  第二食堂  女  2   消费      63     NaN     NaN    27  第二食堂  女
print(data3.head(3)) 序号      门禁卡号           进出时间       进出地点  是否通过    描述0  1330906  25558880  2019/4/1 0:00  第六教学楼[进门]     1  允许通过1  1330907  18413143  2019/4/1 0:02  第六教学楼[出门]     1  允许通过2  1331384  11642752  2019/4/1 0:00    飞凤轩[进门]     1  允许通过
三、数据处理
我们首先需要把数据处理成关联规则能识别的格式,每5分钟分割成一个数据片段,里面是去重后的用户明细,大家可以类比,这里的用户ID就是商品ID,每5分钟就是一个订单,这样就能和常规的关联规则算法联系起来了,把时空数据转换成关联规则的应用方式,初学者还是比较难理解的,如果看不懂,大家可以看看我之前介绍原理的文章。
data2 = data2.merge(data1[['校园卡号','性别']],on='校园卡号')
data2['校园卡号'] = data2['校园卡号'
].apply(lambda x: str(x))+'-'+data2['性别']
import datetimedef st_pt(x): return str(datetime.datetime.strptime(x, "%Y/%m/%d %H:%M"))
def time_5(s): a = str(round(int(s.split(':')[1])/5)) return s.split(':')[0]+'_'+a
df = data2df = df.sort_values(by='消费时间',ascending=True) df['消费时间_F'] = df['消费时间'].apply(st_pt)df['消费时间_5'] = df['消费时间_F'].apply(time_5)all_list = []for v in df['消费时间_5'].unique(): one = df[df['消费时间_5']==v]['校园卡号'].unique().tolist() all_list.append(one)
print(len(all_list))6176
all_list [['181735-女','180015-女'],['181058-男', '181374-男', '182044-女', '182581-女', '180052-女', '182729-男'],['181405-男','180078-男'],···]
df.to_csv('df.csv',header=True,index=False)
四、关联规则挖掘
有了上面构造的数据,我们就可以进行关联规则的挖掘
from efficient_apriori import apriori
itemsets, rules = apriori(all_list, min_support=0.005, min_confidence=1)
itemsets[2] ('183305-女', '183317-女'): 38, ('183308-女', '183317-女'): 42, ('183310-女', '183314-女'): 31, ('183315-女', '183324-女'): 32, ('183338-男', '183345-男'): 40, ('183343-男', '183980-女'): 44, ('183385-女', '183401-女'): 40, ('183386-女', '183409-女'): 34, ('183408-女', '183415-女'): 42, ('183414-女', '183418-女'): 41, ('183419-女', '183420-女'): 56, ('183419-女', '183422-女'): 59, ···len(itemsets[2]) 378
我们可以看到,挖掘出来的关联规则,2元的组合一共有378条,数据是2019-04月一个月的,就是30天的。前面是用户对,后面是30天内出现的次数,30多次到50多次,基本上每天出险一次以上,都是比较强关联的。数据对我们都加上了性别,基本可以推断,男女一般都是情侣,男男基本就是好基友,女女都是好闺蜜,而被我们排除的数据,里面很多就是单身狗了。五、结果解读
上面挖掘的,都是汇总数据,为了更加具体,我们挑一对男女的消费明细来看看,这一对同学,一个月内出现了44次的关联,基本上每天都一起出入了,并且是男女组合。
('181597-男','183847-女'):44
2019/4/1 07:49 男生女生一起去吃早餐,男生吃了3块钱的,女生吃了6.5的,在第一食堂,多年后可能还能记起这一顿早餐
2019/4/1 11:18 男生女生一起去吃午饭,男生吃了8块钱的,女生也吃了8的,估计吃的饺子,或者是麻辣烫,这次在第四食堂,可能是上课的教室就在这附近
2019/4/2 07:42男生女生一起去吃早餐,男生吃了7.5块钱的,女生吃了3.5的,估计昨天点多了,没吃完,今天少吃点
2019/4/17 20:43 估计刚刚约会好了,在红太阳超市,女生估计买了个酸奶,男生饿了,买个个老坛酸菜牛肉面,买完,操场上一个大大的拥抱,各自回宿舍了,带着满满的甜蜜和力量,大学的美好,不过如此了·····
·······

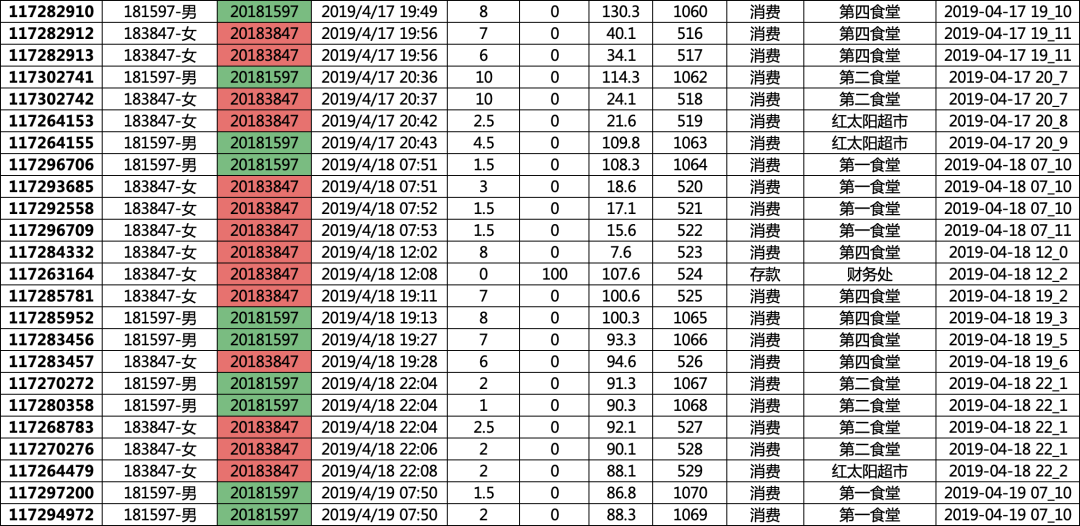
数据挖掘,我们不应该机械冰冷,应该通过数据,洞察后面的细节与故事,有时候,数据挖掘,是多么美妙的故事呢。
除了这一对,还有很多对的情侣,也是类似的生活轨迹。
通过分析,我们也发现两个渣男,啊呸,打死算了,细节我就不看了,你们去看
('180624-男', '181013-女'): 36('180624-男', '181042-女'): 37
('180780-女', '181461-男'): 38('180856-女', '181461-男'): 34
还有我们挖掘的数据,剔除部分,有大量的单身狗的含量,没有人和他一起吃饭
更多的是,基友和闺蜜,可以看看下面的
itemsets[2] ('183247-女', '183254-女'): 32, ('183302-女', '183306-女'): 31, ('183303-女', '183307-女'): 48, ('183303-女', '183314-女'): 31, ('183305-女', '183308-女'): 38, ('183305-女', '183317-女'): 38, ('183308-女', '183317-女'): 42, ('183310-女', '183314-女'): 31, ('183315-女', '183324-女'): 32, ('183338-男', '183345-男'): 40, ('183343-男', '183980-女'): 44, ('183385-女', '183401-女'): 40, ('183386-女', '183409-女'): 34, ('183408-女', '183415-女'): 42, ('183414-女', '183418-女'): 41, ('183419-女', '183420-女'): 56,
3元的数据
itemsets[3]
{('180363-女', '181876-女', '183979-女'): 40, ('180711-女', '180732-女', '180738-女'): 35,
('180792-女', '180822-女', '180849-女'): 35, ('181338-男', '181343-男', '181344-男'): 40, ('181503-男', '181507-男', '181508-男'): 33, ('181552-男', '181571-男', '181582-男'): 39, ('181556-男', '181559-男', '181568-男'): 35, ('181848-女', '181865-女', '181871-女'): 35, ('182304-女', '182329-女', '182340-女'): 36, ('182304-女', '182329-女', '182403-女'): 32, ('183305-女', '183308-女', '183317-女'): 32, ('183419-女', '183420-女', '183422-女'): 49, ('183419-女', '183420-女', '183424-女'): 45, ('183419-女', '183422-女', '183424-女'): 48, ('183420-女', '183422-女', '183424-女'): 51, ('183641-女', '183688-女', '183690-女'): 32, ('183671-女', '183701-女', '183742-女'): 35, ('183713-女', '183726-女', '183737-女'): 36}
4元的数据,一般都是一个宿舍的,关系非常好的宿舍
itemsets[4]{('183419-女', '183420-女', '183422-女', '183424-女'): 42}
六、风控应用
我们分析用的是校园刷卡数据,这样的时序数据,随处可见
订单下单数据
领券明细数据
信用卡刷卡数据
····
非常多的这种数据,我们可以通过时序关联的方法挖掘出来其中的时空关系,从而确定多个有一致行动的用户,达到一起打击的目的。
当然,这种方法也是有缺陷的,有些相隔时间近但是不再同一个5min中内的,不会产生关联,其实有更先进的算法去解决,我们后面慢慢介绍,因为比较抽象。
-
- 机器学习交流qq群955171419,加入微信群请扫码:



