量化投资与机器学习微信公众号,是业内垂直于量化投资、对冲基金、Fintech、人工智能、大数据等领域的主流自媒体。公众号拥有来自公募、私募、券商、期货、银行、保险、高校等行业30W+关注者,荣获2021年度AMMA优秀品牌力、优秀洞察力大奖,连续2年被腾讯云+社区评选为“年度最佳作者”。
作者:Ignacio Oguiza 编译:1+1=6
前言
深度学习在时间序列预测中的重要性不断增强。神经网络第一次在Kaggle时间序列竞赛中位列前3名是在2015年(Rossmann store sales)。从那时起,神经网络就越来越常见地出现在排行榜的头部。而且这种趋势还在继续。事实上,在最近的Ventilator Pressure Prediction时间序列比赛中,前15名的队伍使用了神经网络。
两年前,作者创建了tsai深度学习库,以便于使用最先进的深度学习模型和方法对时间序列数据进行建模与预测。
当上次Kaggle时间序列比赛结束时,我很想知道顶级队伍是如何取得如此优异的成绩的。因此,作者查阅了15个金牌获得者团队发布的所有解决方案。这里有一些关键的发现。
比赛简介
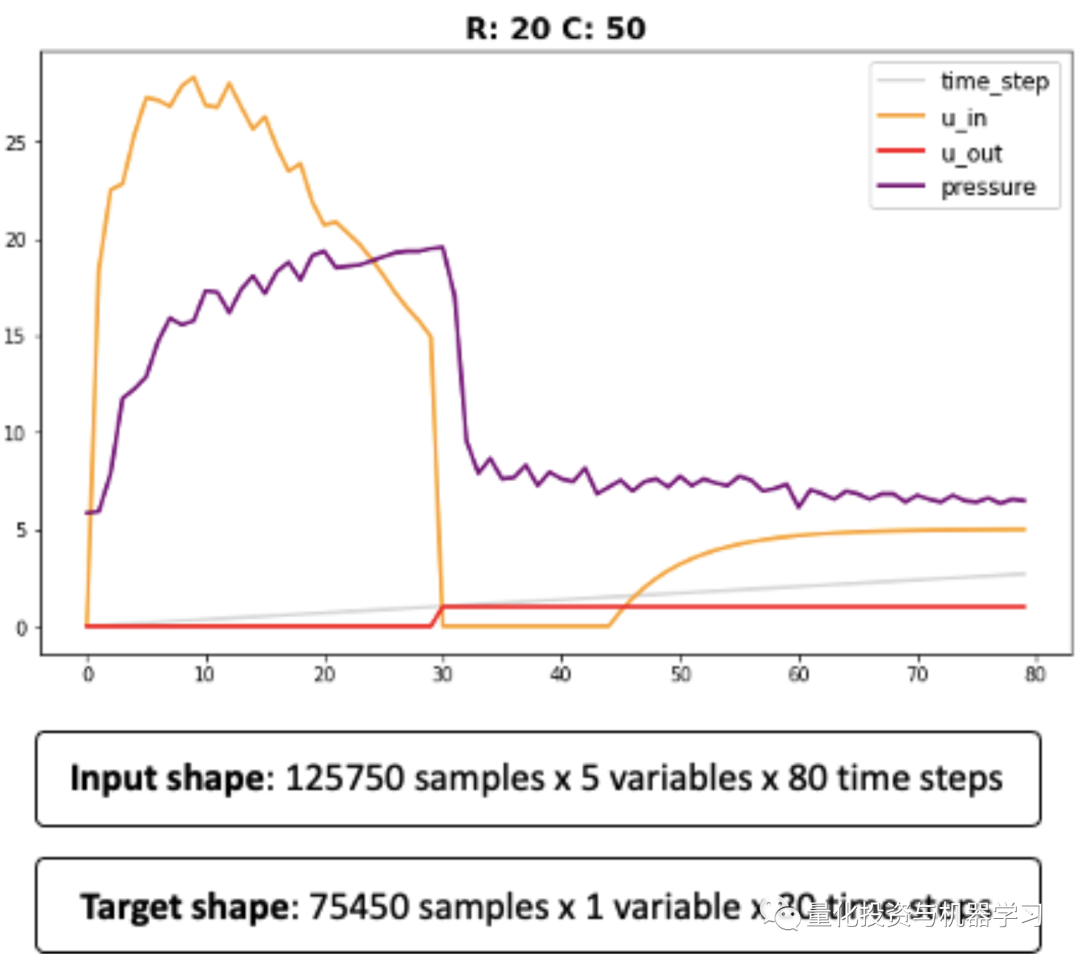
在过去的两个月里,Kaggle举办了谷歌脑呼吸机压力预测比赛。目的是模拟一个连接到镇静剂患者肺部的呼吸机。更具体地说,参与者必须预测在每次呼吸的吸气阶段肺部的压力。
数据集由大约125k次模拟呼吸组成,其中60%被标记(训练数据)。每次呼吸有80个不规则采样的时间步,每个时间步有5个特征。训练集中的每一次呼吸都有一个80步的序列目标(压力)。我们的目标是在测试数据中预测每次呼吸的序列。关键指标为平均绝对误差(MAE)。
重要发现
▌明确任务
是一个序列到序列的任务,两个序列并行发生。有趣的是,目标并不是完全连续的。每个目标步骤都是float类型,只有950个可能的值。正如预期的那样,大多数顶级团队将这个问题作为回归任务来处理。然而,一些金牌得主成功地将比赛作为一个分类任务处理。他们预测了950种类型的概率。我很惊讶地发现分类方法如此有效。你可以用你自己的数据集试试!(如果你的数据是连续的,你总是可以创建离散目标箱)。
▌特征
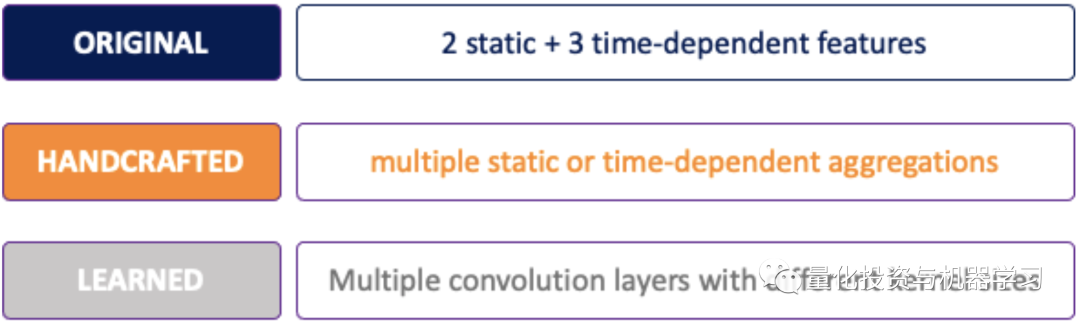
Top团队使用了三种不同的方法:
只用原始特征。只有获胜的团队在他们的一个模型中成功地使用了这种方法。为了弥补特征的少量,他们使用了大量的epoch (2.5k)。
原始特征加上人为定义的特征。大多数团队都遵循这条路线,通常会增加几十个特征。精心设计的、人工定义的特征可以帮助模型更快地聚合,因此需要的时代更少。人工设计的特征提供了利用专家领域知识提高性能的机会。
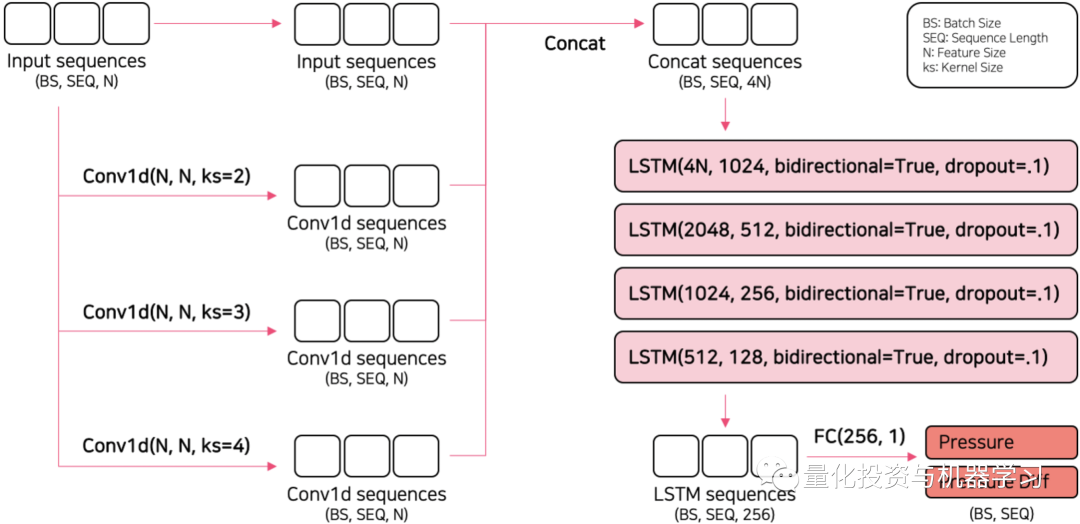
原始特征+人工定义的特征+机器学习出来的特征。一些团队将输入信息通过一个具有多个卷积层的特征提取器来学习新特征。每个卷积层使用不同的核大小。
▌模型
LSTM和Transformer霸占了排行榜,而CNN和增强树模型没有竞争力。
所有Top团队都使用了神经网络(深度学习)。与其他领域不同,增强树没有竞争力。没有一个最好的解决方案包括增强树。
主要使用的模型包括:
1、Stacked bidirectional LSTMs(一种递归神经网络)主导了这场竞赛。几乎所有的金牌得主都使用了LSTM模型的预测作为他们最终组合的一部分。如前所述,一些团队通过在LSTM层之前添加特征提取器来构建混合模型。
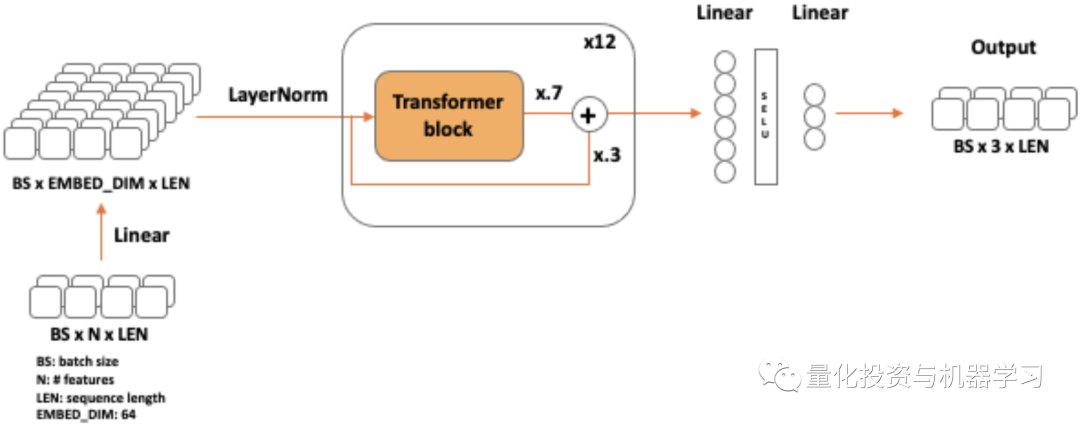
2、有些团队使用了Transformer,但有些团队说Transformer的效果不如LSTM。在使用Transformer达到理想效果的方案中,Transformer模型只使用了编码器部分,而没有位置编码,因为时间已经是特征之一。另外两个定制化的步骤是在Transformer之前添加卷积层和跳跃层。
▌自定义损失函数
自定义损失函数是Top团队胜利的重要因素!
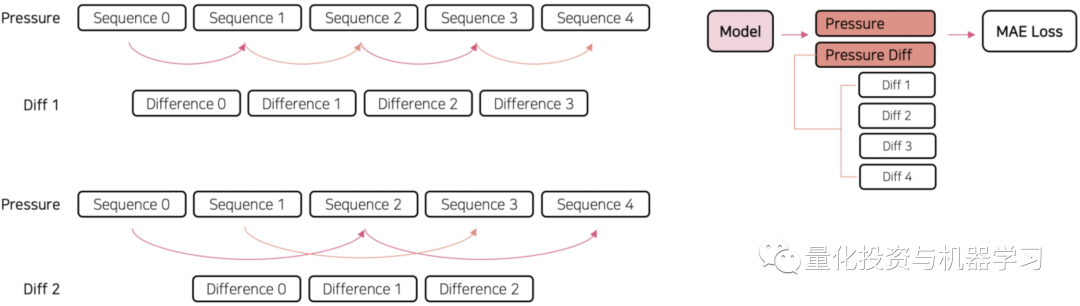
比赛使用MAE(平均绝对误差)作为评估标准。因此,大多数参与者使用L1Loss或相关的loss(HuberLoss、SmoothL1Loss等)。然而,几乎所有Top团队都使用了带有辅助损失的多任务学习。他们在原有目标的基础上增加了新的目标,以减少过拟合,提高泛化效果。
如前所述,这里的目标是具有80个时间步的压力序列。然而,顶级团队修改了它来预测次要目标,比如:
压力差和累积压力的加入,迫使模型学习目标及其导数和积分,提高了模型的性能。
▌框架和硬件
当然大部分团队建模选用的框架是TensorFlow或Pytorch,Scikit-learn主要用在数据预处理和交叉验证的环节。TPU和GPU也非常重要,因为一个fold的训练经常要花费数小时。
▌数据增广
数据增广是减少过拟合最好的方法。
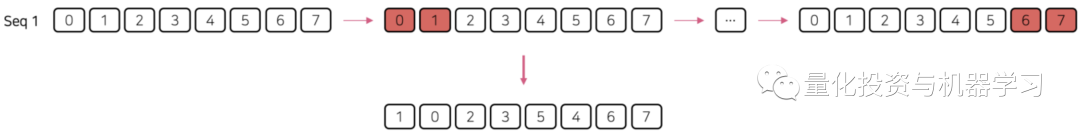
很少有团队能够使用数据增广的方法。但那些使用了数据增广的团队都显著提高了模型的效果。主要的数据增广的方法有:


▌模型训练
Top团队使用大量的epoch来训练他们的模型(通常在150到300之间,尽管有些人使用了高达2.5k!),它们都使用了一些学习速率调度器。Cosine Annealing和ReduceLROnPlateau 是最常用的两种方法。至少有一个团队声称使用Cosine Annealing With Warm Restarts.可以显著提高性能。
▌复合模型
复合模型经常出现在Kaggle比赛中。这在这里非常重要。原因是,当你使用平均绝对误差(MAE)来评估一个预测时,通常使用中值比平均值更好。中值只有在有很多值的时候才准确。
所有Top团队都创建了一个或多个强大的模型,并运行:
▌Pseudo-labels
一些最好的解决方案还利用未标记的数据集来生成额外的标签。与上面描述的其他技术相比,这种技术的改进并不大。
结论
时间序列领域与计算机视觉和NLP的一样,神经网络逐渐的占据了主导地位。
神经网络加上领域专家知识可以显著提高时间序列任务的性能。近年来,深度学习在时间序列中的应用发展迅速。它已经成熟,所以现在是开始使用它来解决时间序列问题的好时机。



