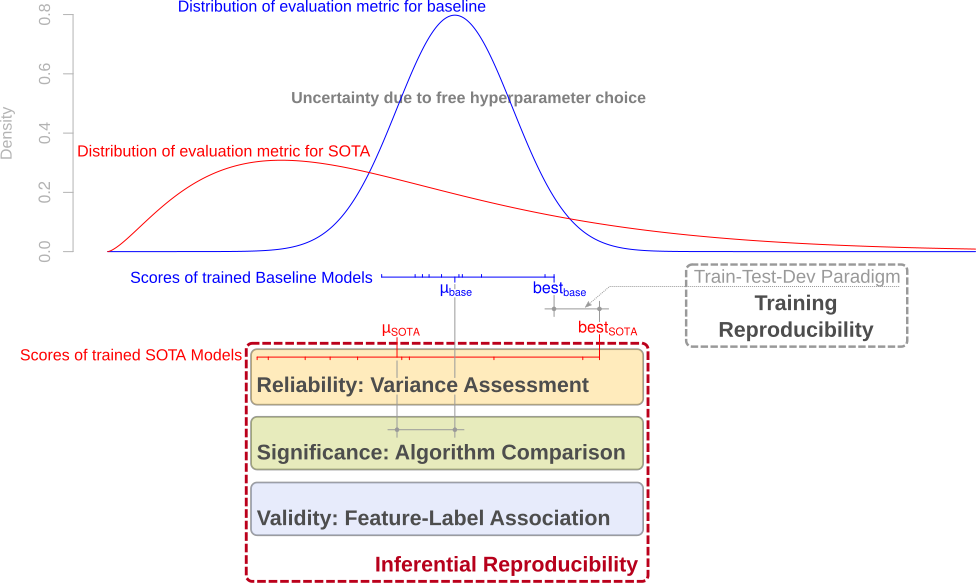
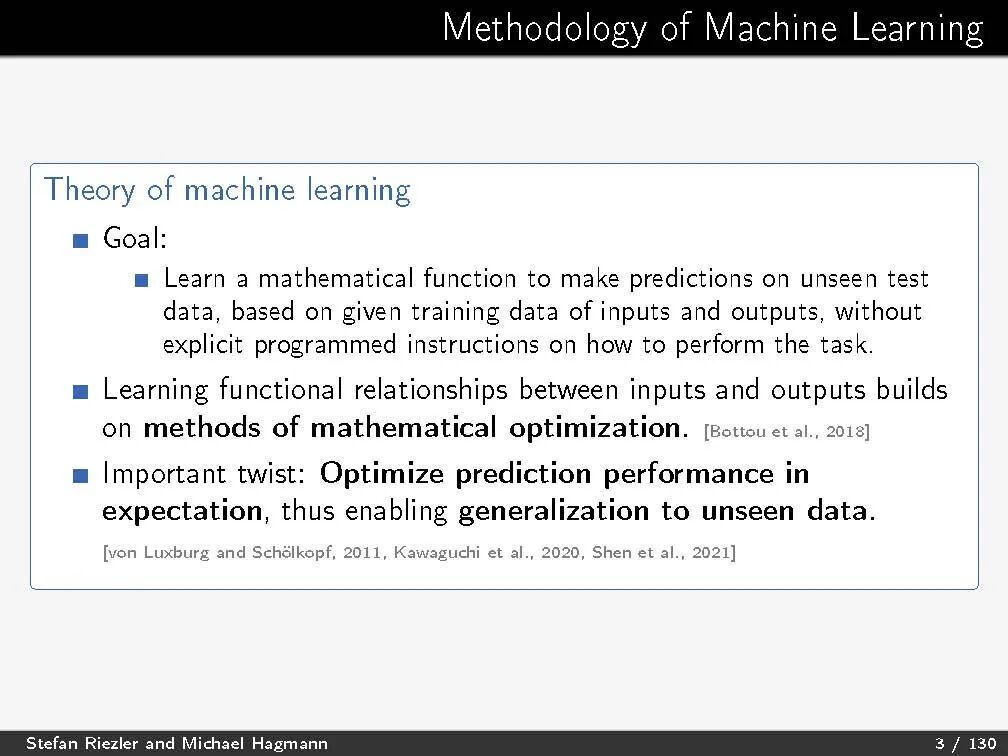
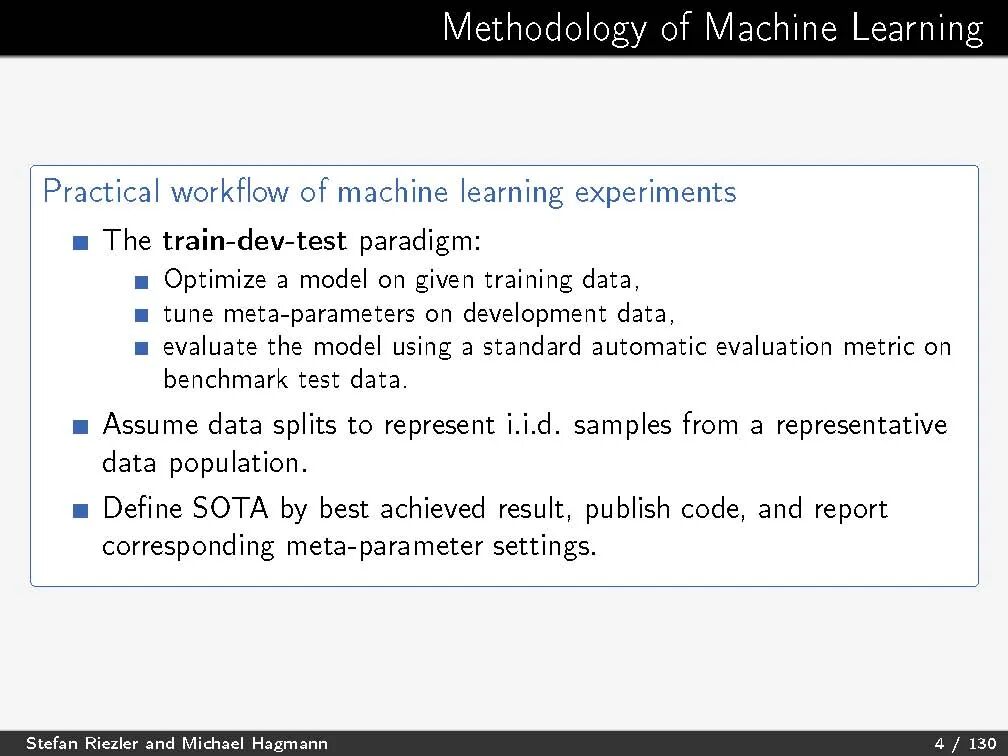
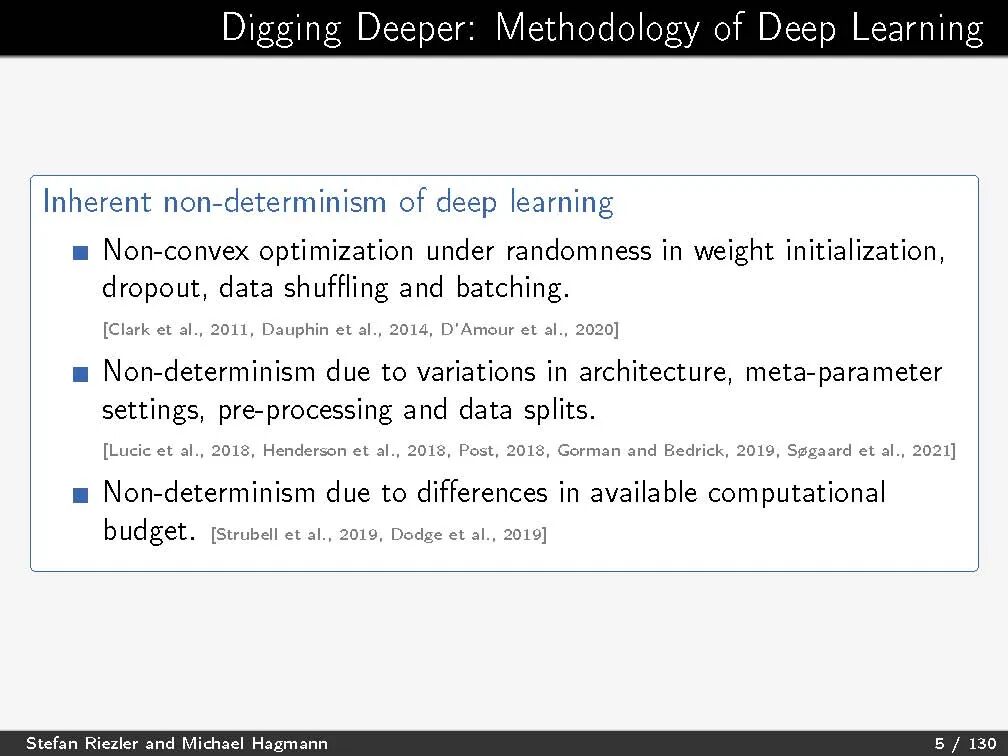
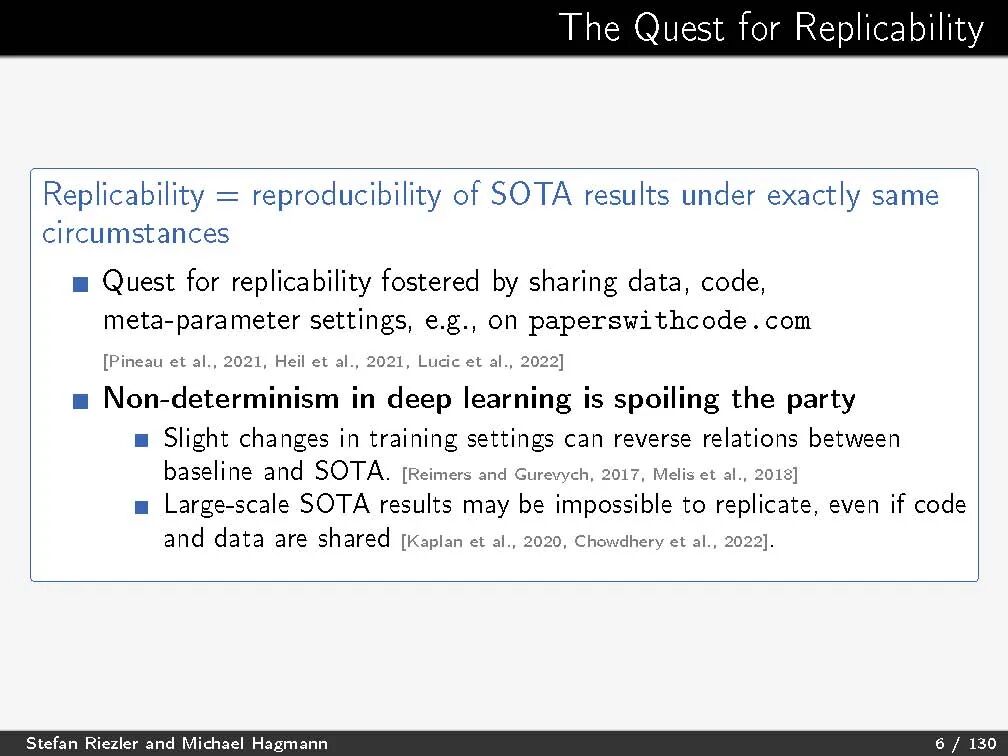
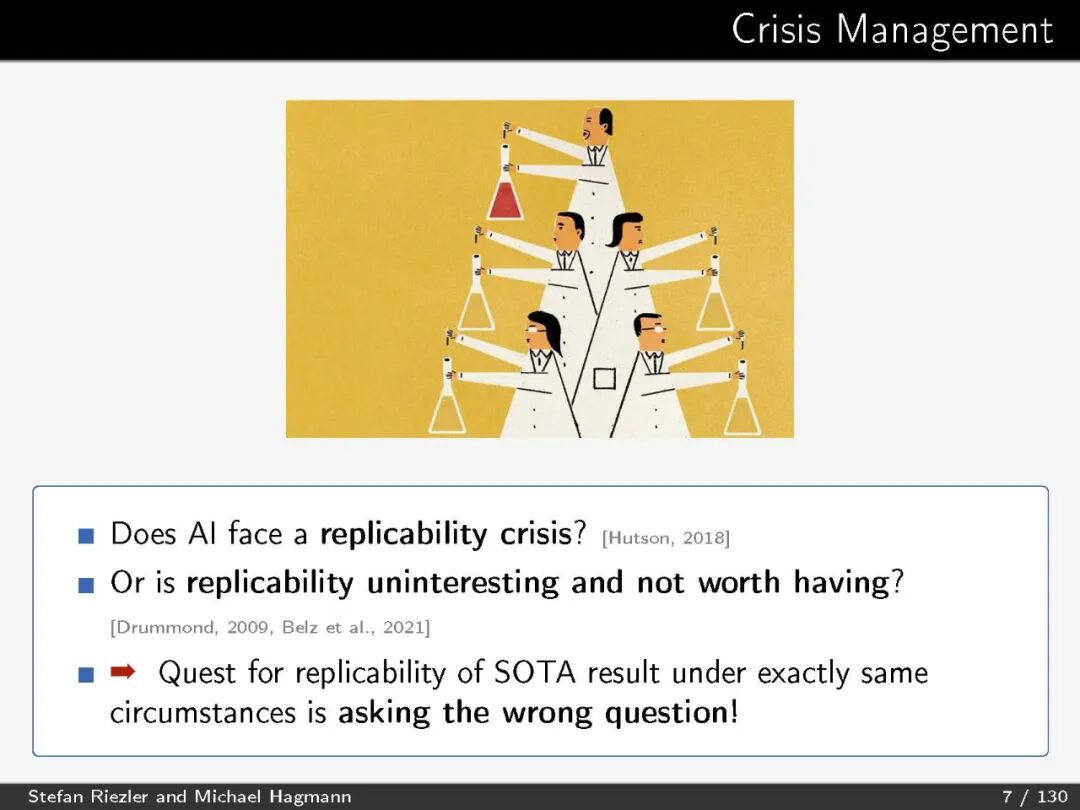
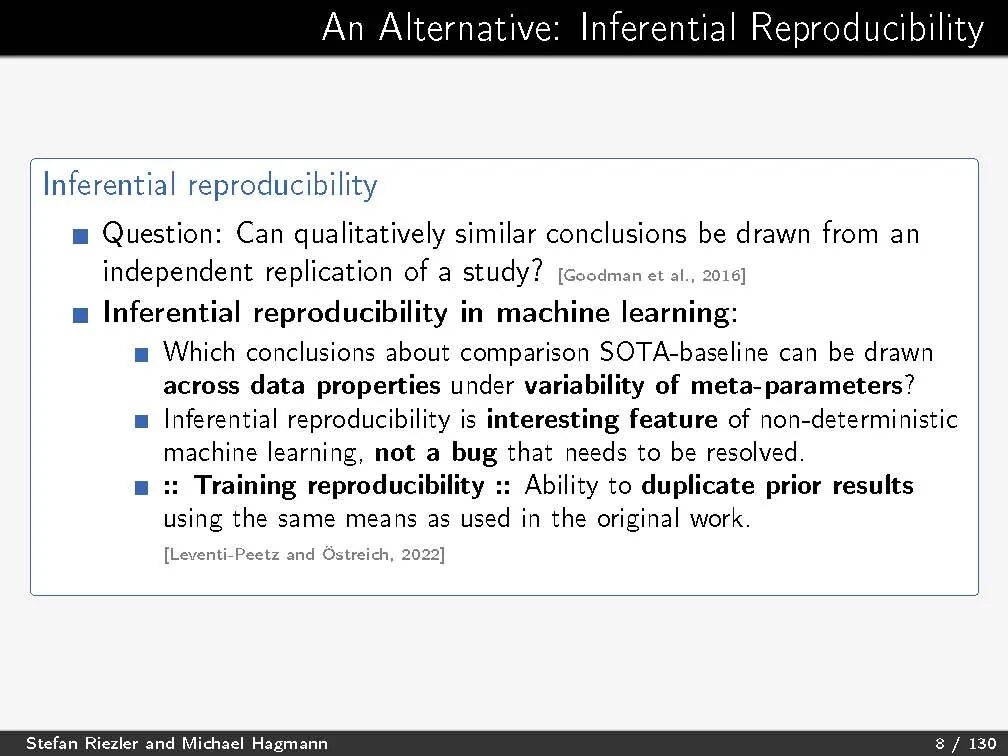
机器学习的科学进步是由评估模型相对质量的实证研究推动的。这种评估的目标是比较机器学习方法本身,而不是对训练模型的特定优化实例进行单一测试集评估。由于深度学习模型的性能依赖于各种随机性来源,仅报告单个最佳模型的性能评分的做法尤其不适用于深度学习。这样的评估实践提出了方法论上的问题:一个模型是否预测了它声称预测的东西(有效性),一个模型的表现在训练过程的重复中是否一致(可靠性),以及两个模型之间的表现差异是否由于机会(显著性)。本教程的目标是通过具体的统计测试来回答这些问题。该教程是实践性的,并配有教科书(Riezler和Hagmann, 2021年)和一个包含R和Python代码的网页。
讲者:
专知便捷查看
便捷下载,请关注专知公众号(点击上方蓝色专知关注)
专知,专业可信的人工智能知识分发,让认知协作更快更好!欢迎注册登录专知www.zhuanzhi.ai,获取100000+AI(AI与军事、医药、公安等)主题干货知识资料!
欢迎微信扫一扫加入专知人工智能知识星球群,获取最新AI专业干货知识教程资料和与专家交流咨询!点击“阅读原文”,了解使用专知,查看获取100000+AI主题知识资料



