反向传播算法的例子
假设我们的神经网络中有层,第层有个神经元,第层与层之间的权重矩阵为,偏置向量为
。对于一个具有个样本的数据集,我们定义输入为,输出为。
在前向传播中,我们使用以下公式计算每一层的值:
其中是激活函数,
表示层数,表示输入层。
在反向传播中,我们需要计算每一层的误差并更新权重。计算输出层的误差时,可以使用以下公式:
其中表示输出层。
然后,我们可以通过反向传播输出误差来计算隐藏层的误差:
其中,
是激活函数的导数。我们可以使用计算出的误差来更新权重矩阵:
最后我们更新权重矩阵和偏置向量:
其中是学习率。我们可以通过多次迭代该过程来训练模型,直到模型达到预定的性能。
代码示例
- 以下是实现反向传播算法的Python代码,使用向量化计算来提高效率:
import numpy as np
def initialize_parameters(n_x, layers, n_y):
"""
用于初始化多层神经网络的参数
参数:
n_x -- 输入层的大小
layers -- 包含每一层大小的数组
n_y -- 输出层的大小
返回值:
paramters -- 包含W和b的Python字典
"""
np.random.seed(1)
L = len(layers) # 网络层数
parameters = {}
# 初始化第1层
parameters['W1'] = np.random.randn(layers[0], n_x) * 0.01
parameters['b1'
] = np.zeros((layers[0], 1))
# 初始化其他层
for i in range(1, L):
parameters['W' + str(i + 1)] = np.random.randn(layers[i], layers[i - 1]) * 0.01
parameters['b' + str(i + 1)] = np.zeros((layers[i], 1))
# 初始化输出层
parameters['W' + str(L + 1)] = np.random.randn(n_y, layers[L - 1]) * 0.01
parameters['b' + str(L + 1)] = np.zeros((n_y, 1))
return parameters
def sigmoid(Z):
"""
sigmoid激活函数的向量化实现
参数:
Z -- 线性求和的结果
返回值:
A -- 激活后的结果
"""
A = 1 / (1 + np.exp(-Z))
return A
def sigmoid_derivative(Z):
"""
sigmoid激活函数的导数
参数:
Z -- 线性求和的结果
返回值:
dZ -- sigmoid函数的导数
"""
A = sigmoid(Z)
dZ = A * (1 - A)
return dZ
def tanh_derivative(Z):
"""
tanh激活函数的导数
参数:
Z -- 线性求和的结果
返回值:
dZ -- tanh函数的导数
"""
A = np.tanh(Z)
dZ = 1 - np.power(A, 2)
return dZ
def forward_propagation(X, parameters):
"""
实现前向传播算法
参数:
X -- 输入数据,shape为(n_x, m)
parameters -- 包含W和b的Python字典的网络参数
返回值:
AL -- 最后一层的激活值
caches -- 包含每层中的(A, Z)的列表
"""
caches = []
A_prev = X
L = len(parameters) // 2 # 网络层数
# 前L-1层使用tanh激活函数
for i in range(1, L):
# 线性求和
Z = np.dot(parameters['W' + str(i)], A_prev) + parameters['b' + str(i)]
# 缓存A和Z
cache = (A_prev, Z)
caches.append(cache)
# 应用tanh激活函数
A = np.tanh(Z)
A_prev = A
# 最后一层使用sigmoid激活函数
Z = np.dot(parameters['W' + str(L)], A_prev) + parameters['b' + str(L)]
cache = (A_prev, Z)
caches.append(cache)
AL = sigmoid(Z)
return AL, caches
def compute_cost(AL, Y):
"""
计算代价函数
参数:
AL -- 模型的输出
Y -- 真实值
返回值:
cost -- 代价函数
"""
m = Y.shape[1]
cost = -1 / m * np.sum(Y * np.log(AL) + (1 - Y) * np.log(1 - AL))
return cost
def backward_propagation(AL, Y, caches):
"""
实现反向传播算法
参数:
AL -- 模型的输出
Y -- 真实值
caches -- 包含每层中的(A, Z)的列表
返回值:
grads -- 包含每个参数的梯度的Python字典
"""
m = Y.shape[1]
L = len(caches)
grads = {}
# 对最后一层使用sigmoid的反向传播
dAL = - (np.divide(Y, AL) - np.divide(1 - Y, 1 - AL))
current_cache = caches[L - 1]
A_prev, Z = current_cache
dZ = dAL * sigmoid_derivative(Z)
grads["dW" + str(L)] = 1. / m * np.dot(dZ, A_prev.T)
grads["db" + str(L)] = 1. / m * np.sum(dZ, axis=1, keepdims=True)
# 对前L-1层使用tanh的反向传播
for l in reversed(range(L - 1)):
current_cache = caches[l]
A_prev, Z = current_cache
dA = np.dot(parameters["W" + str(l + 2)].T, dZ)
dZ = dA * tanh_derivative(Z)
grads["dW" + str(l + 1)] = 1. / m * np.dot(dZ, A_prev.T)
grads["db" + str(l + 1)] = 1. / m * np.sum(dZ, axis=1, keepdims=True)
return grads
def update_parameters(parameters, grads, learning_rate):
"""
使用梯度下降算法更新参数
参数:
parameters -- 包含W和b的Python字典
grads -- 包含对应W和b的梯度的Python字典
learning_rate -- 学习率
返回值:
parameters -- 更新后的包含W和b的Python字典
"""
L = len(parameters) // 2 # 网络层数
for l in range(L):
parameters["W" + str(l + 1)] = parameters["W" + str(l + 1)] - learning_rate * grads["dW" + str(l + 1)]
parameters["b" + str(l + 1)] = parameters["b" + str(l + 1)] - learning_rate * grads["db" + str(l + 1)]
return parameters
def L_layer_model(X, Y, layers_dims, learning_rate=0.01, num_iterations=3000, print_cost=False):
"""
实现一个L层神经网络
参数:
X -- 输入数据,shape为(n_x,数量)
Y -- 真实值,shape为(1,数量)
layers_dims -- 包含每一层大小的数组
learning_rate -- 学习率
num_iterations -- 迭代次数
print_cost -- 每100次迭代后是否打印代价函数值
返回值:
parameters -- 训练后的模型参数
"""
np.random.seed(1)
costs = []
parameters = initialize_parameters(X.shape[0], layers_dims, Y.shape[0])
for i in range(0, num_iterations):
AL, caches = forward_propagation(X, parameters)
cost = compute_cost(AL, Y)
grads = backward_propagation(AL, Y, caches)
parameters = update_parameters(parameters, grads, learning_rate)
# 打印代价函数值
if print_cost and i % 100 == 0:
print("迭代次数: %i,代价函数值: %f" % (i, cost))
if print_cost and i % 100 == 0:
costs.append(cost)
# 打印代价函数图像
if print_cost:
plt.plot(np.squeeze(costs))
plt.ylabel('cost')
plt.xlabel('iterations (per tens)')
plt.title("Learning rate =" + str(learning_rate))
plt.show()
return parameters
import matplotlib.pyplot as plt

np.random.seed(1)
X = np.random.randn(3, 5) # 随机生成三个特征,五个样本的输入矩阵
Y = np.array([[1, 0, 1, 1, 0]]) # 随机生成一个真实的输出结果矩阵
parameters = initialize_parameters(3, [4], 1) # 随机初始化参数矩阵
AL, caches = forward_propagation(X, parameters) # 前向传播
cost = compute_cost(AL, Y) # 计算代价函数
grads = backward_propagation(AL, Y, caches) # 反向传播
parameters = update_parameters(parameters, grads, 0.1) # 参数更新

print("AL = " + str(AL))
print("Cost = " + str(cost))
print("grads = " + str(grads))
print("Updated parameters = " + str(parameters))

# 绘制代价函数变化曲线
costs = []
for i in range(1000):
    AL, caches = forward_propagation(X, parameters)
    cost = compute_cost(AL, Y)
    grads = backward_propagation(AL, Y, caches)
    parameters = update_parameters(parameters, grads, 0.1)
    costs.append(cost)
    if i % 100 == 0:
        print("迭代次数: %i,代价函数值: %f" % (i, cost))
plt.plot(np.squeeze(costs))
plt.ylabel('cost')
plt.xlabel('iterations (per tens)')
plt.title("Learning rate =" + str(0.1))
plt.show()
AL = [[0.50037097 0.49966438 0.49999165 0.49988645 0.50016688]]
Cost = 0.6929801704859408
grads = {'dW2': array([[-0.00132582,  0.00726017, -0.00334984,  0.00957421]]), 'db2': array([[-0.09998393]]), 'dW1': array([[-7.54439262e-05, -1.36498952e-03,  5.40864706e-04],
       [-9.28841089e-05, -1.61946803e-03,  6.38971061e-04],
       [ 2.68016294e-04,  4.79458799e-03, -1.89805307e-03],
       [-2.66171334e-04, -4.63875616e-03,  1.82969020e-03]]), 'db1': array([[ 0.00032198],
       [ 0.00038421],
       [-0.00113165],
       [ 0.00110063]])}
Updated parameters = {'W1': array([[ 0.016251  , -0.00598107, -0.0053358 ],
       [-0.0107204 ,  0.00881602, -0.02307928],
       [ 0.01742132, -0.00809153,  0.0033802 ],
       [-0.00246709,  0.01508495, -0.02078438]]), 'b1': array([[-3.21981777e-05],
       [-3.84209780e-05],
       [ 1.13164711e-04],
       [-1.10063132e-04]]), 'W2': array([[-0.00309159, -0.00456656,  0.01167268, -0.01195633]]), 'b2': array([[0.00999839]])}
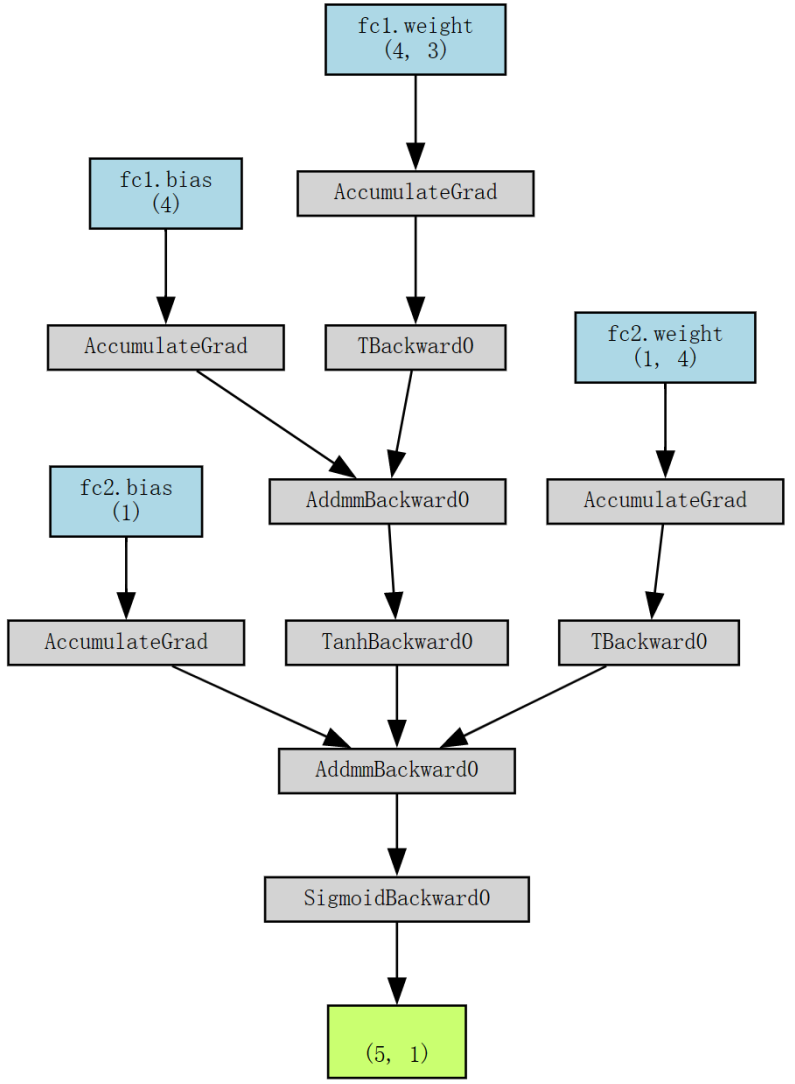
迭代次数: 0,代价函数值: 0.691971
迭代次数: 100,代价函数值: 0.510630
迭代次数: 200,代价函数值: 0.097315
迭代次数: 300,代价函数值: 0.036653
迭代次数: 400,代价函数值: 0.021111
迭代次数: 500,代价函数值: 0.014502
迭代次数: 600,代价函数值: 0.010934
迭代次数: 700,代价函数值: 0.008725
迭代次数: 800,代价函数值: 0.007234
迭代次数: 900,代价函数值: 0.006164
使用PyTorch实现
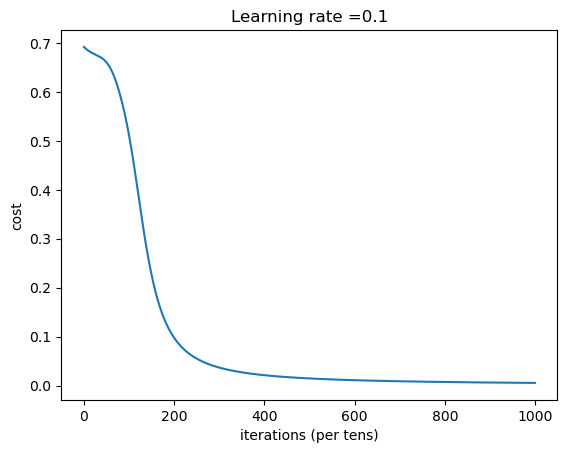
这段代码定义了一个简单的神经网络,并通过随机生成的样本进行了训练。步骤如下:
首先引入了PyTorch库,这是一个深度学习框架库,包括各种深度学习模块和功能。
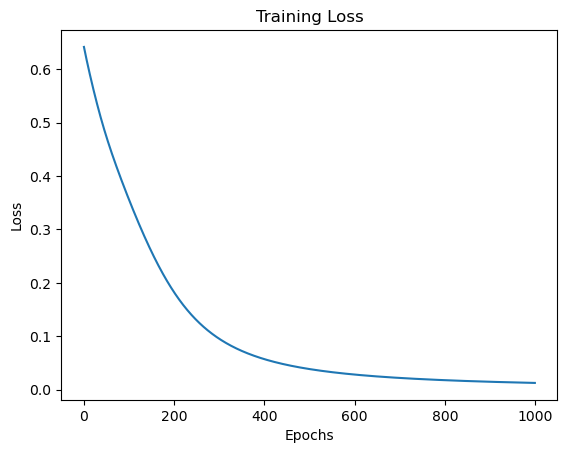
定义了一个名为Net的神经网络模型,它继承了PyTorch的nn.Module类,其中n_input、n_hidden和n_output分别表示输入、隐藏和输出层的节点数。
在Net中,我们通过nn.Linear()定义了两个全连接层,同时又定义了Sigmoid和Tanh激活函数。
然后定义了一个train()函数,在该函数中,我们通过nn.BCELoss()定义了二元交叉熵损失函数,并通过optim.SGD()定义了Stochastic Gradient Descent(随机梯度下降)优化器。在每次迭代训练中,我们都将梯度归零optimizer.zero_grad(),计算输出outputs = model(X),计算损失loss = criterion(outputs, Y),通过反向传播计算梯度loss.backward(),更新模型中的参数optimizer.step(),最后打印代价函数loss的值。
最后我们随机生成5个样本,每个样本包括三个特征,并随机指定一个真实的输出结果矩阵Y。然后初始化一个有一个隐藏层、三个特征和一个输出的神经网络模型Net,并利用train()函数在随机生成的样本上进行了训练。
import torch
import torch.nn as nn
import torch.optim as optim
import matplotlib.pyplot as plt
#定义绘图函数
def plot_loss(loss_values):
    plt.plot(loss_values)
    plt.xlabel("Epochs")
    plt.ylabel("Loss")
    plt.title("Training Loss")
    plt.show()
# 定义神经网络模型
class Net(nn.Module):
    def __init__(self, n_input, n_hidden, n_output):
        super(Net, self).__init__()
        # 定义两个全连接层
        self.fc1 = nn.Linear(n_input, n_hidden)
        self.fc2 = nn.Linear(n_hidden, n_output)
        # 定义激活函数
        self.sigmoid = nn.Sigmoid()
        self.tanh = nn.Tanh()

    def forward(self, x):
        x = self.tanh(self.fc1(x))   # 使用Tanh激活函数
        x = self.sigmoid(self.fc2(x))    # 使用sigmoid激活函数
        return x

def train(X, Y, model, learning_rate=0.01, num_epochs=3000, print_cost=False):
    # 定义损失函数
    criterion = nn.BCELoss()
    # 定义优化器
    optimizer = optim.SGD(model.parameters(), lr=learning_rate)
    loss_values = []
    for epoch in range(num_epochs):
        optimizer.zero_grad()   # 梯度清零
        outputs = model(X)  # 前向传播得到输出y_hat
        loss = criterion(outputs, Y)    # 计算损失
        loss.backward() # 反向传播求导
        optimizer.step()    # 更新参数
        loss_values.append(loss.item()) # 将损失值加入列表中
        # 打印训练过程中的损失值
        if print_cost and epoch % 100 == 0:
            print("迭代次数: %i,代价函数值: %f" % (epoch, loss.item()))
    plot_loss(loss_values)

# 测试代码
torch.manual_seed(1)    # 设置随机种子,保证结果可以重现
X = torch.randn(5, 3)   # 随机生成三个特征,五个样本的输入矩阵
Y = torch.tensor([[1], [0], [1], [1], [0]], dtype=torch.float32)    # 随机生成一个真实的输出结果矩阵
model = Net(3, 4, 1)    # 初始化模型,三个特征,一个输出,一个隐藏层
train(X, Y, model, learning_rate=0.1, num_epochs=1000, print_cost=True)   # 利用训练数据进行模型训练,将输出代价函数值
迭代次数: 0,代价函数值: 0.641908
迭代次数: 100,代价函数值: 0.355435
迭代次数: 200,代价函数值: 0.181952
迭代次数: 300,代价函数值: 0.094983
迭代次数: 400,代价函数值: 0.056912
迭代次数: 500,代价函数值: 0.038369
迭代次数: 600,代价函数值: 0.028081
迭代次数: 700,代价函数值: 0.021755
迭代次数: 800,代价函数值: 0.017556
迭代次数: 900,代价函数值: 0.014603
绘制网络图
from torchviz import make_dot
X = torch.randn(5, 3) # 随机生成三个特征,五个样本的输入矩阵
model = Net(3, 4, 1) # 初始化模型

# 可视化计算图

make_dot(model(X), params=dict(model.named_parameters()))