Machine Learning in Python: Essential Techniues for Predictive Analysis. by Michael Bowles
本书主要讨论 supervised learning有监督学习 的 function approximation函数逼近问题
https://onlinelibrary.wiley.com/doi/book/10.1002/9781119183600
惩罚线性回归 vs 集成方法
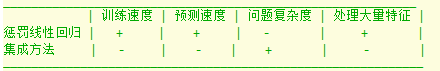
因变量的不同,决定了问题的类型。
类别变量:分类问题
数值变量:回归问题
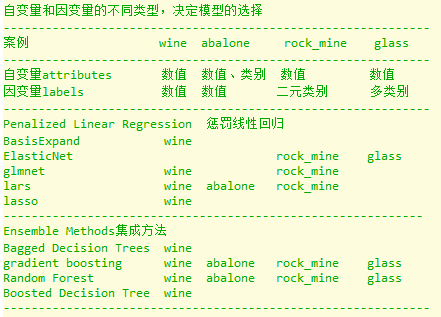
自变量和因变量的不同类型,决定模型的选择
##############
Part 1. Penalized Linear Regression 惩罚线性回归:对least squares regression的改善和提高。
最小二乘法Ordinary Least Squares,OLS的一个问题:有时候它会过拟合。
两种方法来解决OLS的过拟合问题:
forward Step Regression前向逐步回归:
ridge岭回归算法
Logistic Regression逻辑回归
Lasso算法
penalized linear regression可以减少自由度使之与数据规模、问题的复杂度相匹配。
对于具有大量自由度的问题,penalized linear regression获得了广泛的应用。
惩罚线性回归的使用场景:当数据规模(行数)<
例如,人类基因中大概有2e4个基因,在很多情况下,数据规模到不了这么多个。
##############
Part 2.Ensemble Methods 集成方法
集成方法的基本思想是构建多个不同的预测模型,然后将其输出做某种组合作为最终的输出。
计算学习理论(computation learning theory)的研究结果证明:
只要基学习器比随机猜测稍微好一些,那么集成方法可以达到相当好的效果。
集成方法是由两层算法组成的。
1.底层算法(单个预测模型):基学习器 base learners
2.上层算法:对这些基学习器做巧妙的处理,使其模型近似相对独立。主要有:
Boosted Decision Trees 提升决策树
Bagged Decision Trees 投票决策树
Random Forest 随机森林
gradient boosting梯度提升算法
自举集成:bootstrap aggregation, Bagging算法
梯度提升算法和随机森林采用不同的方法进行集成,这两种方法优于Bagging.
决定使用哪种属性进行预测被称作特征工程。Determining what attributes to use for making predictions is called feature engineering.



