Py学习  »  机器学习算法

PyTorch深度学习实战(16)——面部关键点检测-add

GIS研发 • 4 月前 • 166 次点击  

3.2D和3D面部关键点检测

在上一小节中,我们从零开始构建了面部关键点检测器模型。在本节中,我们将学习如何利用专门为2D和3D关键点检测而构建的预训练模型来获取面部的2D和3D关键点。为了完成此任务,我们将使用face-alignment 库.

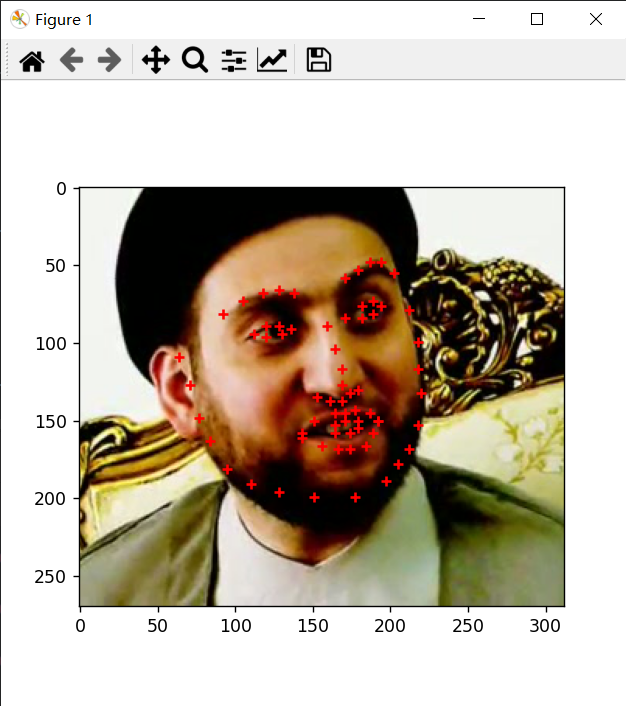
1 2D关键点检测

# 导入面部关键点检测库 face_alignmentimport face_alignment# 导入 OpenCV,用于读取和预处理图像import cv2# 导入 PyTorch 的动态图优化模块(此处用于避免某些错误)import torch._dynamo# 设置 torch._dynamo 遇到错误时直接跳过(避免因优化失败而中断程序)torch._dynamo.config.suppress_errors = True
# 定义要处理的图像文件名(示例图片,请确保该文件存在于当前目录)file = 'Abdel_Aziz_Al-Hakim_00.jpg'
# 使用 OpenCV 读取图像,返回一个 NumPy 数组(BGR 颜色通道顺序)im = cv2.imread(file)
# 将图像从 BGR 颜色空间转换为 RGB,因为 face_alignment 库期望 RGB 输入input = cv2.cvtColor(im, cv2.COLOR_BGR2RGB)
# 初始化 FaceAlignment 对象,用于检测面部关键点# LandmarksType.TWO_D 表示检测 2D 关键点(68 个标准点)# flip_input=False 表示不翻转输入图像(保持原方向)# device='cpu' 表示使用 CPU 进行计算(如果没有 GPU 可以设为 'cuda')fa = face_alignment.FaceAlignment(face_alignment.LandmarksType.TWO_D, flip_input=False, device='cpu')
# 调用 get_landmarks 方法获取面部关键点坐标# 参数 input 是 RGB 图像(NumPy 数组)# 返回值是一个列表,每个元素对应一张脸的关键点(这里假设图像中只有一张脸)preds = fa.get_landmarks(input)[0]  # 取第一张脸的关键点
# 打印关键点数组的形状,应为 (68, 2) —— 68 个点,每个点有 x, y 坐标print(preds.shape)  # 输出 (68, 2)
# 导入 matplotlib 的 pyplot 模块,用于显示图像和关键点import matplotlib.pyplot as plt
# 创建一个图形窗口,设置大小为 5x5 英寸fig, ax = plt.subplots(figsize=(5, 5))
# 显示 RGB 图像(matplotlib 默认显示 RGB)plt.imshow(input)
# 在图像上绘制关键点:使用红色 '+' 标记,位置为 preds 中的 x, y 坐标ax.scatter(preds[:, 0], preds[:, 1], marker='+', c='r')
# 显示最终的图像和关键点plt.show()

2 3D关键点检测

# 导入人脸关键点检测库 face_alignmentimport face_alignment# 导入 OpenCV,用于读取和处理图像import cv2# 导入 PyTorch 的动态编译模块(torch.compile 相关)import torch._dynamo
# 设置:当 torch.compile 编译失败时,不要抛出异常,而是静默回退到普通模式torch._dynamo.config.suppress_errors = True# 设置:完全禁用 PyTorch 的动态编译功能(避免因缺少 C++ 编译器而产生警告)torch._dynamo.config.disable = True
# 指定要处理的图片文件名(图片需放在当前代码文件同一目录下)file = 'Abdel_Aziz_Al-Hakim_00.jpg'
# 使用 OpenCV 读取图片,返回一个 NumPy 数组(BGR 颜色格式)im = cv2.imread(file)# 将图片从 BGR 格式转换为 RGB 格式(因为 face_alignment 库通常需要 RGB 输入)input = cv2.cvtColor(im, cv2.COLOR_BGR2RGB)
# 创建人脸关键点检测器对象# LandmarksType.THREE_D 表示要提取 3D 关键点(包含深度信息 z)# flip_input=False:不对输入图像做水平翻转# device='cpu':使用 CPU 进行计算(若电脑有 NVIDIA GPU 可改为 'cuda' 加速)fa = face_alignment.FaceAlignment(face_alignment.LandmarksType.THREE_D,                                   flip_input=False,                                  device='cpu')
# 再次读取同一张图片(上一段已经读过一次,这里重复了,可以省略)im = cv2.imread(file)# 再次转换颜色格式input = cv2.cvtColor(im, cv2.COLOR_BGR2RGB)
# 调用检测器获取人脸关键点# get_landmarks 返回一个列表,列表中的每个元素是一张人脸的 68 个关键点(x,y,z)# 这里假设图片中只有一张脸,所以用 [0] 取第一张脸的关键点preds = fa.get_landmarks(input)[0]
# 导入 pandas,用于将数据整理成表格形式import pandas as pd# 将关键点数据(形状为 68×3)转换为 pandas 的 DataFrame 对象df = pd.DataFrame(preds)# 给三列数据分别命名为 x, y, z(代表三维空间坐标)df.columns = ['x', 'y', 'z']
# 导入 plotly.express,这是一个用于绘制交互式图表的库import plotly.express as px# 创建一个 3D 散点图:x 轴为 'x',y 轴为 'y',z 轴为 'z'fig = px.scatter_3d(df, x='x', y='y', z='z')# 显示图表(会在默认浏览器中打开一个交互式网页)fig.show()

PyTorch深度学习实战(16)——面部关键点检测

Python社区是高质量的Python/Django开发社区
本文地址:http://www.python88.com/topic/196477