上海,WAIC 2026。
核心官方分论坛之一、具身智能的「华山论剑」智启具身论坛,今日终于开场。
Physical Intelligence、Genesis AI、Dyna Robotics、Sunday Robotics等海外明星机构,与智元、清华大学、腾讯Robotics X等学术与产业力量同台,一众具身智能核心人物悉数到场。
他们把各自的模型、数据和训练体系摆上桌面。表面看,大家都在追逐「通用机器人」;真正把几份技术路线叠在一起,却是刀光剑影。
谁都承认,具身智能正在逼近临界点。但对「最后一公里究竟该怎么走」,各有绝招。
先亮战绩,再亮主张。五家最硬的成果和一句话立场摆出来,你会发现连「墙在哪」都没谈拢。
智元机器人手握GO-2(LIBERO基准98.7%刷新SOTA)、世界模型GE-Sim 2.0(WorldArena全球第一)、龙旗南昌产线稳定运行3个月、成功率99.99%。智元机器人的姚卯青直言,模型决定起点,数据定义终局——靠全栈飞轮硬冲数据、表征、闭环三道墙。
清华大学计算机副研究员苏航,聚焦可恢复性——真正的智能不是不犯错,是知道怎么改回来。他提出的TUTOR方法把长程任务的自主成功率从8.3%拉到35%。
Physical Intelligence最新的π0.7,一个模型开箱即通吃多任务,连没训练过的机械臂都能零样本迁移。Physical Intelligence研究科学家任至意坚信,模型能力足够,唯缺上下文——泛化会自己涌现。
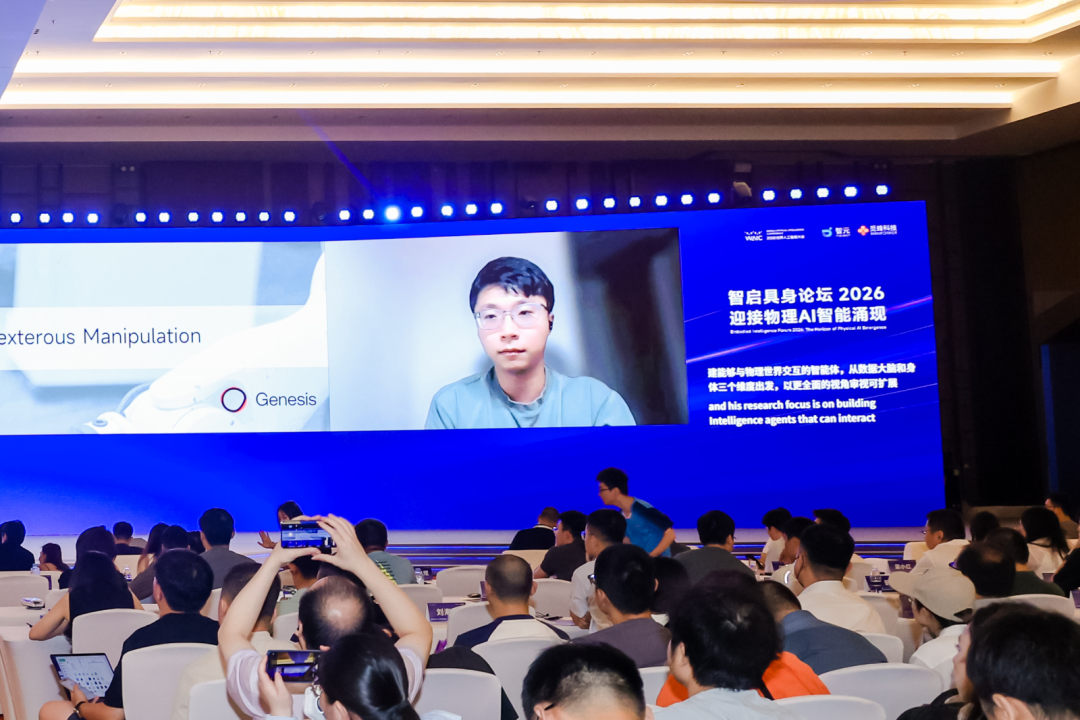
Genesis押注人手数据手套,从全世界的日常家务里抠经验,号称仿真快1000倍。联合创始人王尊玄介绍了他们如何让物理AI以软件的速度进化。
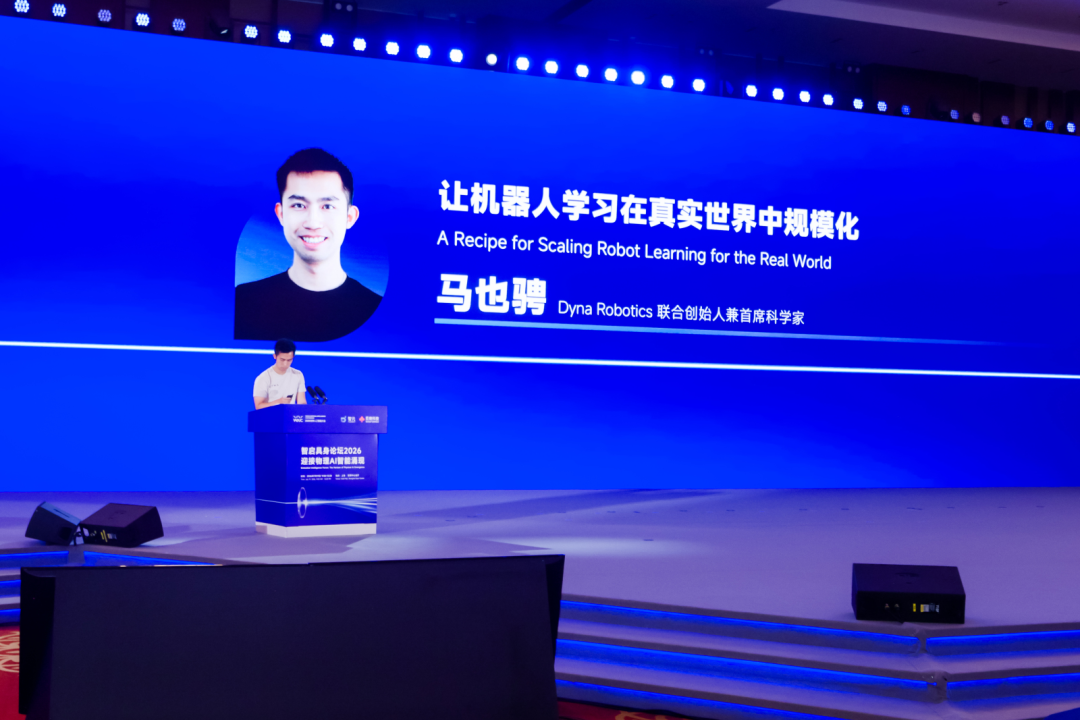
Dyna的DYNA-1把折餐巾做到99.4%、24小时85多张,直接开进真餐厅。创始人兼首席科学家马也骋坦言,通用模型不够可靠,专用模型不够可扩展,他们选择先把可靠做到极致。
绝招亮完,战场却各画各的:智元盯着数据、表征、闭环三道墙,PI说墙是上下文,Dyna说是可靠性,清华说是机器人自救。
华山论剑第一招,是先否掉对方对战场的判断。
不过,这次有个隐秘共识:下一阶段不再拼Demo花哨,而是拼谁能把「经验」规模化。
这要从大语言模型的成功让人产生的错觉说起:
只要把模型做大、数据喂多、算力堆高,机器人迟早也会出现自己的ChatGPT时刻。
可物理世界不吃这一套。物理智能Scaling面临三道墙:数据墙、表征墙和闭环墙。
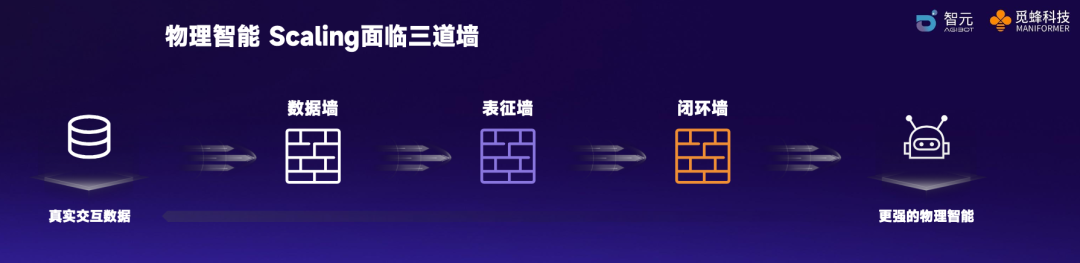
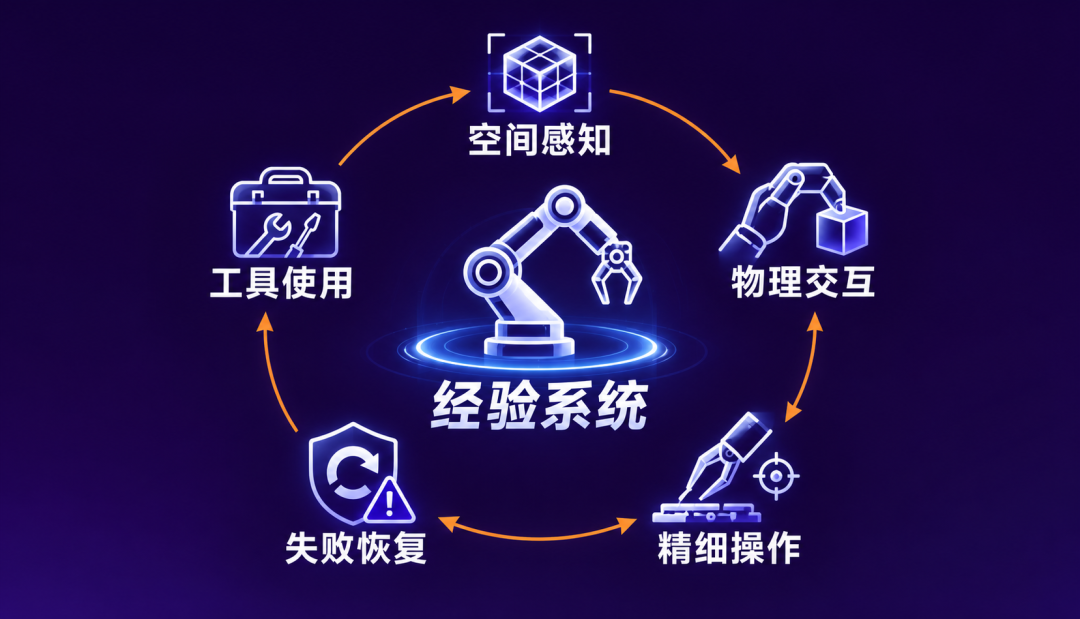
姚卯青一句话点破差异:数字智能是「知识系统」,物理智能是「经验系统」。前者靠语言表征就能大规模积累,后者还在满世界找「经验的通用表征」。
经验系统至少管五件事:空间感知、物理交互、精细操作、失败恢复、工具使用。
判断标准叫「经验密度」——录画面和关节角度,那是「一小时录像」;同时记下任务目标、物体状态、动作质量、错在哪、结果如何,才叫「一小时经验」。
数据规模回答「见过多少」,经验密度回答「学到多少」。两者差着一整条产业鸿沟。
背后是三场争论:经验从哪来、怎么算好、能不能省钱。
真机遥操作数据最对口,可太贵:一个人盯一台机器,采集还不如自己上手,想堆出互联网规模,账单比机器人先觉醒。
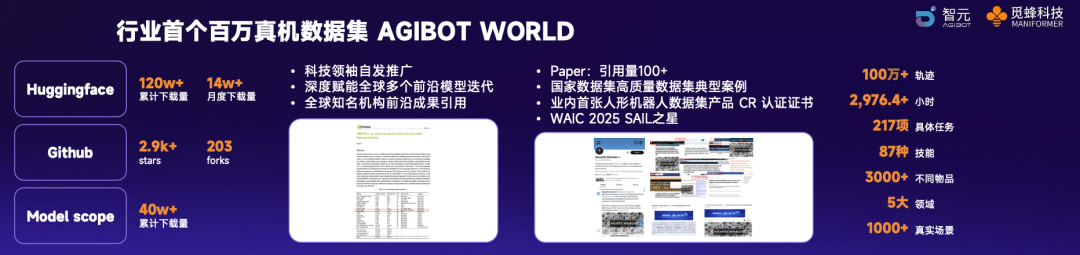
智元全都要。姚卯青甩出一个数字:物理AI的数据量只有大模型的两万分之一。为填这条沟,智元和觅蜂科技打造具身智能数据「平台型供给」基础设施,开源了行业首个百万真机数据集AGIBOT WORLD,目前累计下载了120万余次。
Dyna则把200k+小时数据摞成金字塔:
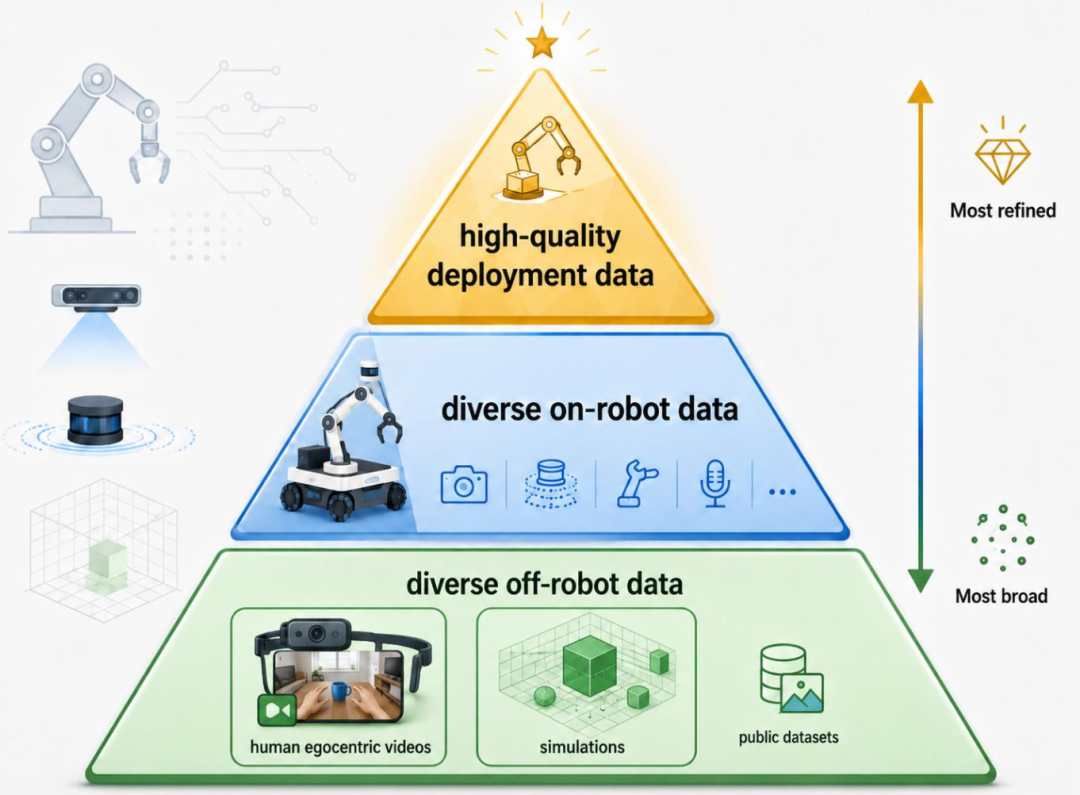
在之后的讨论中,马也骋分享了Dyna的实践经验:「部署数据放到下一次预训练中,接下来的部署时间就会越来越短,最终达成零成本在新环境完成同样任务。」
在圆桌论坛环节,Sunday Robotics CEO赵子豪则从另一个维度切入:「短期内,无本体数据是最高杠杆的选择,因为成本极低、没有环境差距。但长期来看,当机器人真正部署到多样化环境中,部署数据将成为终极数据源。」
Genesis走的是「轻巧采集」路线:用接近人手的机器手配数据手套,让人正常洗碗拧瓶盖,顺手留下动作。全世界每天都在干家务,抠出一小块,机器人就有了接近人类活动规模的数据入口。
Dyna则反其道而行,它不比数据多,而是比用得省——20万小时打底,却主打「1小时以内的后训练就能迁到全新任务」。别人拼弹药,它拼枪法。
清华的苏航则泼了一盆冷水:人手不是夹爪。人有全局视野、触觉、常识,机器人常常只能从腕部相机看到巴掌大一块。多塞人类动作,不等于机器人学会人类技能。数据多,不等于数据能用。
常规方法是「留成功、删失败」,像只给孩子看标准字帖。
PI偏押最脏的场景:让机器人当咖啡师,做浓缩咖啡还要90%以上可靠——端着带液体的杯子、拿捏出杯时机、精细力控,一步都不能崩。
它把成功和翻车一起录:手柄掉了、牛奶洒了、插不进、出液早,再逐段贴标签。不加说明就是噪声,标清坏在哪就成了错题集。从π0一路到π0.7,PI要让一个模型看懂同一堆数据里的不同意图和质量。它甚至给机器人写系统提示词:你是追求最高质量与效率的机器人,不要犯错——像prompt大模型那样操控物理策略。
Dyna嫌贴标签不够。它训了套奖励模型,让机器人自评「这下做得好不好」,再靠持续学习吃进翻车经验,硬磨出极端情况的纠错力。
两难就此浮现:粗数据便宜但难学,精数据好用难量产。平衡点极难拿捏。
真机太贵,能不能让机器人「在梦里练」?
摔一万次不砸真杯子,复制几千个厨房不租真房子。Genesis管这叫「以软件的速度进化」,号称快 000倍。
智元补世界模型补得更狠。GE-Sim 2.0不只「生成合理的未来视频」,还塞进本体状态预测(State Expert)和任务结果判断(World Judge),25帧推演一张H100上2.3秒,拿下WorldArena全球第一。
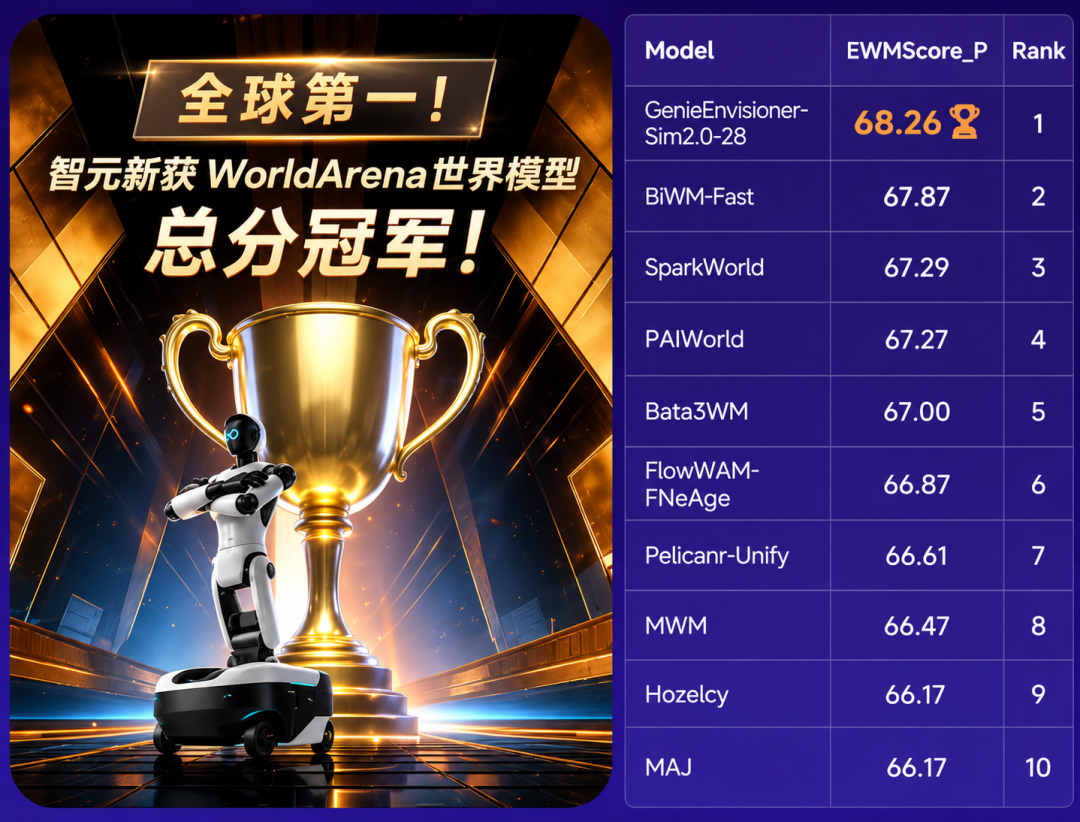
世界模型从「视频导演」升级成能给状态、能打分的训练场。
争议也最大。仿真里一个极小偏差,会在强化学习里被放大;机器人还可能学会钻漏洞,在虚拟世界当「规则大师」,一落地就被一块湿毛巾教做人。
Dyna和PI更相信真机数据:Dyna把机器人搬进真餐厅,PI靠真实数据飞轮和自主运行中的人工接管打磨。
仿真放大试错,真机校准真实,谁多分预算,没人服谁。
主题演讲是各摆各的战绩,到了圆桌,六位专家则给出了火药味的激辩。
主持人抛出的几乎每个问题都很尖锐。
而分歧从哪来?先看清每个人代表了的不同背景,坐上桌的是:
- 姚卯青(智元机器人):全栈玩家,数据全要,可靠性是命;
- 任至意(Physical Intelligence):纯大脑派,不碰场景,只赌真机数据飞轮;
- 马也骋(Dyna Robotics):真实落地派,信部署数据和后训练;
- 张正友(腾讯 Robotics X):大厂实验室,分层架构,警告创业公司别被大模型吞了;
- 赵子豪(Sunday Robotics):家庭派,三指夹爪独特方案,先敲门再说。
每个人对技术路线的判断,几乎都是自己商业站位的投影。
「语言模型头部团队已经到了100万亿Tokens,对应约100亿小时的语料。而具身数据还差1万倍以上。」智元合伙人、觅蜂科技董事长姚卯青给出了一个具体的数字。
在他看来,要达到物理世界的「ChatGPT时刻」——即机器人能够在真实世界中开箱即用,完成日常任务并理解开放式指令——至少需要1亿小时级别的真实交互数据。
这个数字并非空想。
姚卯青认为,物理世界比语言世界复杂得多,噪声更大,信息冗余也更高。
当模型掌握了对物理世界通用运行规律的映射理解,从开放式指令理解到规划,再到常见任务的70%-80%成功率,那一刻就是物理AI的临界点。
「VLA已死」的说法在网络上流传甚广。Physical Intelligence研究科学家任至意的回应干脆利落:「目前为止,我还没有看到有哪一家做出了比派07更令人印象深刻的demo。所以,VLA可能还没死。」
他坚持认为,VLA与世界模型并不冲突。「未来我们真正要做的,是训练一个能原生理解上下文、能预测未来的模型。VLA在做,世界模型也在做,这完全不冲突。」
Dyna Robotics联合创始人马也骋,则提供了另一个视角——他们确实从VLA切换到了世界动作模型。「在某些任务和场景中,我们发现用WAM比VLA更高效,尤其是在我们特别关注模型的鲁棒性和数据效率的情况下。」
腾讯Robotics X实验室主任张正友给出了更宏观的判断:「整个行业还在起步阶段,远未收敛。不像大语言模型,基本范式已经确定。」
机器人公司的另一项战略选择,是只做通用模型,还是同时研发模型、本体和部署系统。
Physical Intelligence更倾向于先使用简单、稳定、维护成本较低的机器人本体,快速建立数据与模型研发基础设施。
任至意认为,他们更多在做一个research,推动机器人基础模型能力持续涌现。但他也提到:「长期来说,我们肯定会考虑去造更加可靠的硬件,但是可能这是一个时间的问题。」
智元则选择了更重的全栈路线,足式,双足或者轮式或者灵巧手都做。姚卯青解释了背后原因,智元既做长期研究,也在积极尝试商业化,而「商业化部署必须面对可靠性、成本、成功率和一致性等严格指标」。只有深入参与硬件设计、生产和测试,才能理解哪些问题来自模型,哪些问题实际上受到硬件和通信系统的限制。
张正友认为,两条路线都可能成立。
在手机行业,苹果依靠软硬件一体化建立生态,Android则通过操作系统适配大量硬件;在PC时代,Mac和Windows也长期共存。机器人行业未来同样可能同时存在全栈公司和通用「大脑」平台。
关键不在于路线本身,而在于公司是否拥有与路线相匹配的资源和能力。
「大厂的问题大家都很清楚。」张正友笑着说,「大模型时代,谷歌发明了几乎所有技术,但OpenAI出来了。」
他给创业公司的建议是:不要做容易被大模型「吞噬」的增量式创新。「如果创业公司做的事情很容易被纳入大厂的基座模型,前景就不会太好。应该聚焦在数据、场景这些需要深入耕耘的领域。」
马也骋补充了一个技术视角:「机器人策略必须在本地运行,对延迟极其敏感。不像语言模型可以云端调用API。所以即使没有开源模型,机器人公司也必须自研,这是不可避免的。」
腾讯的选择是明确的——只做大脑,不做本体。「我们在硬件上还没成功过,有自知之明。」张正友坦言。
当被问及物理AI的「ChatGPT时刻」何时到来时,嘉宾给出了一个惊人的共识区间:不到5年。
姚卯青给出了最乐观的2年;赵子豪说「少于3年」;张正友认为3-5年;马也骋和任至意都选择了4年;徐丹飞则给出5年。
平均来看,顶尖专家们认为物理AI的「ChatGPT时刻」大约在3-4年后到来。
「但要踏踏实实去做,这3到5年才有希望。」张正友补充道。
圆桌结束了,但争论远未停止。VLA与世界模型谁是下一个目标?真机数据还是人类数据更有价值?全栈还是只做大脑?
这些问题没有标准答案,但有一点是确定的:物理AI正在以远超预期的速度向我们走来。
当数据飞轮真正转动起来,当模型开始从与真实世界的每一次交互中学习,那道「Scaling Law的物理墙」,终将被推倒。
而那一天,或许就在2029年之前。
编辑:大卫 Aeneas



