之前 Anthropic 发了一篇工程博客,把 Claude 深度研究功能背后的实现公开了。这个功能不少人用过,提一个问题,它自己去搜一堆资料,过几分钟返回一份带引用的调研报告。博客里写得很明白,实际干活的是一个主 Agent 带几个子 Agent:主 Agent 先把问题拆开,再拉起几个子 Agent 分头去查,每个子 Agent 用自己独立的上下文窗口,查完把压缩过的结论交回来,主 Agent 最后汇总成报告。
他们自己测过,同样的任务,这种多个 Agent 协作的做法,效果比单个 Agent 做高出 90.2%。
多智能体这块今年的变化其实挺大的,AutoGen 进维护模式了,微软和谷歌都亲自下场做了官方框架,国产的 MetaGPT 连仓库都搬了家,网上不少选型文章已经过时了,另外很多人对多智能体协作的优势只理解到可以把任务并行加快但更多消耗token这一步。
今天这篇先用大白话把多智能体协作讲清楚,再挑几个现在还在活跃维护的开源框架,说说各自适合什么人,抛砖引玉。
先说为什么一个 AI 不够用
很多人觉得多智能体是把事情搞复杂了,其实单个 Agent 的上限是客观存在的,跟模型聪不聪明关系不大。
1.上下文窗口装不下。 一个复杂任务做下来,搜到的资料、中间的分析、写出来的代码,全塞在同一个对话里,很容易就把窗口撑满了。窗口满了之后,模型就开始丢三落四,前面刚查到的东西,写到后面就忘了。多智能体的处理方式很直接,每个子 Agent 自己用一个窗口,各干各的,互不干扰。Anthropic 那套调研系统能处理远超单个窗口的信息量,靠的就是这个。
2.分工之后每个环节能做得更好。 让一个 Agent 又查资料又写代码又做校对,就像公司里让一个人同时当产品、开发和测试,不是干不了,是每个环节都只能做到差不多。拆成专门的 Agent,每个角色配上自己的提示词和工具,单个环节的质量就上去了。
3.可以同时干活。 子任务之间如果没有依赖关系,几个 Agent 并行跑,整体花的时间会短不少,相当于是多线程嘛,这个不用多说,大家都懂。
4.某一步出错了不至于全完。 流程是拆开跑的,中间一环出了问题,把那一环重跑就行,不用整个任务从头再来。
当然这样做是有代价的,而且代价不小,这个放到后面说。
多智能体之间是怎么分工的
市面上的框架看着很多,底层的协作方式其实就五种,各种框架基本都是这五种方式的组合。
流水线: 前一个干完传给后一个。查资料的查完交给写稿的,写稿的写完交给校对的,校对完发布。逻辑最简单,出了问题也好排查,任务步骤比较明确的场景用它就可以。
并行: 几个 Agent 同时处理互不相关的子任务,最后汇总到一起。比如让三个 Agent 分别读三份文档,读完再合并结论。好处是快,需要提前想好的是,几个 Agent 的结论互相矛盾的时候怎么办。
主管带团队: 一个主管 Agent 负责拆任务、派活、收结果,下面挂几个干活的 Agent。这是生产环境里用得最多的结构,因为责任清楚,出问题知道是哪一环的事。Anthropic 的调研系统就是这个结构。代价是主管每一步都要想过再派活,整体会慢一点。
交接: 没有主管,Agent 自己判断这个活该给谁,就把任务连同上下文一起转过去。客服系统里最常见,负责分流的 Agent 判断这是账单问题,就把对话整个转给管账单的 Agent。这种方式同一时刻其实只有一个 Agent 在干活,属于接力,跟并行是两回事,用之前容易想当然。
共享黑板: Agent 之间不直接说话,大家都往一块公共的地方读写信息。好处是互相之间没有依赖,坏处是这块公共的地方本身最难管,里面的状态一乱,整个系统就跟着乱。
实际项目里一般是混着用的,比如让主管负责规划,具体执行走流水线。
另外提一句协议的事,这两年这块变化比较大。MCP 协议管的是 Agent 怎么调用外部工具,A2A 协议管的是不同框架做出来的 Agent 怎么互相通话。现在一个正经的多智能体系统,基本两个都会用到。A2A 要是真能普及开,以后各家框架做出来的东西就能互相配合了,不用像现在这样各玩各的。
GitHub 上热门的几个开源框架
背景说完了,GitHub 上做多 Agent 协作的优质开源项目不少,但真正还在活跃维护、用的人也多的,挑出来其实就这么五个,今天挨个给大家介绍一下。这几个框架都是模型中立的,DeepSeek、通义这些国产模型都能接,不存在必须绑哪家模型的问题。(当然,这是一家之言,可能还有很优秀的多 Agent 协作框架,笔者没用过~~)
MetaGPT:按软件公司的流程跑
开源地址:https://github.com/FoundationAgents/MetaGPT
Star 数 70k,是这篇里最高的,国产项目,DeepWisdom 团队做的。
MetaGPT 的想法是这样的:大模型直接写代码,写着写着就容易乱,那就干脆别让它一个人写,把软件公司那套流程整个搬过来。你丢给它一句话的需求,比如写一个命令行贪吃蛇,它内部先由产品经理 Agent 写一份需求文档,架构师 Agent 拿着文档出系统设计,工程师 Agent 照着设计写代码,最后测试 Agent 跑用例。角色和角色之间靠文档交接,跟我们公司里开发的流程差不多。整套流程走完,交到你手上的是一个能直接跑起来的项目。
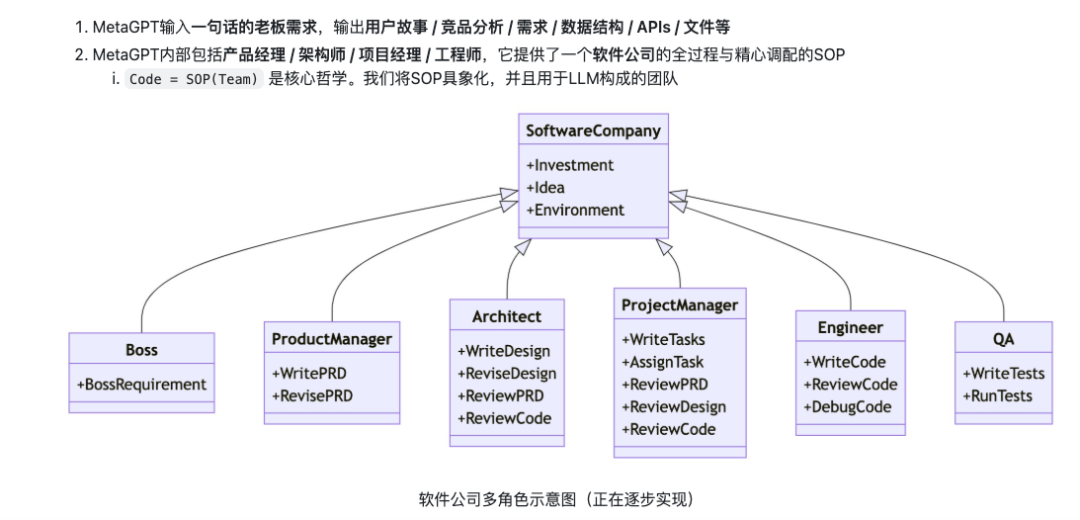
从结果看,人类公司那套分工协作的办法放到 AI 身上是有效的,比让一个模型从头写到尾效果要好不少。
开源地址搬了一次家,从作者个人号迁到了 FoundationAgents 这个组织下面,以前收藏过老链接的记得更新。另外从提交记录看,主仓库最近一次代码更新停在年初,大半年没有动了。同一个组织下面还有个 OpenManus,58k star,是当初 Manus 火起来之后快速复刻出来的通用 Agent,目前还在正常更新,对这类"一句话干完一件事"的东西感兴趣的话,两个可以一起看看。
CrewAI:上手最快
开源地址:https://github.com/crewAIInc/crewAI
Star 数 57.6k,MIT 协议。
CrewAI 用起来是另一种感觉,它让你把 Agent 当成团队成员来定义。每写一个 Agent,要写清楚它的角色是什么、目标是什么,还可以给它配一段背景故事,比如"你是一位有十年经验的行业分析师"。定义好三五个这样的 Agent,把任务派下去,它们就自己分工协作了。我自己装的时候,从安装到跑通一个"调研加写稿加审核"的内容团队,大概花了半小时,中间基本没卡壳。第一次接触多智能体的话,用它起步最省事。
CrewAI 的 star 比 LangGraph 高不少,但 PyPI 的月下载量只有对方的四分之一左右,我感觉可能是顺手点星的人多,但真的装到生产环境里天天跑的人没那么多。它做演示和内容类的任务很舒服,流程一旦需要复杂的分支和状态控制,就有点跟不上了。
LangGraph:生产环境用得最多
开源地址:https://github.com/langchain-ai/langgraph
Star 数 40.4k,MIT 协议,LangChain 团队出品。
LangGraph 和 CrewAI 是两种相反的思路,CrewAI 是描述清楚团队里有什么人,剩下的事框架帮你安排。LangGraph 是什么都不帮你安排,整个流程要你自己一步一步画出来,哪一步干什么、干完去哪一步、什么情况下再绕回来,全是自己写的代码,框架在中间不做任何隐藏的决定。
这么写当然累一些,概念也多,刚上手要花点时间。但写出来的东西有几个好处是别的框架给不了的:
- 1. 断点续跑,流程跑到一半崩了,能从上一个存档点接着跑,不用从头再来一遍,token 也不用重烧一遍;
- 2. 人工审批,关键节点可以停下来,等人确认了再继续走,涉及付款、发邮件这类操作的时候,这个能力基本是必须的;
- 3. 配套的 LangSmith 能看到每个 Agent 每一步具体做了什么,线上出问题的时候查得到原因。
Uber、Replit、LinkedIn 这些公司在生产环境用的都是它。前面提到的下载量差距,原因基本也在这,star 反映的是关注度,下载量反映的是有多少人在真用。学习成本确实高一点,但等线上流程出问题需要排查的时候,就能体会到流程可控的价值了。
LangGraph 是有点东西的,值得研究一下,有门槛才有学的必要。
Google ADK:谷歌官方出的
开源地址:https://github.com/google/adk-python
Star 数 21.3k,Apache 2.0 协议,一年多涨到2万 Star,是这几个里面涨得最快的。
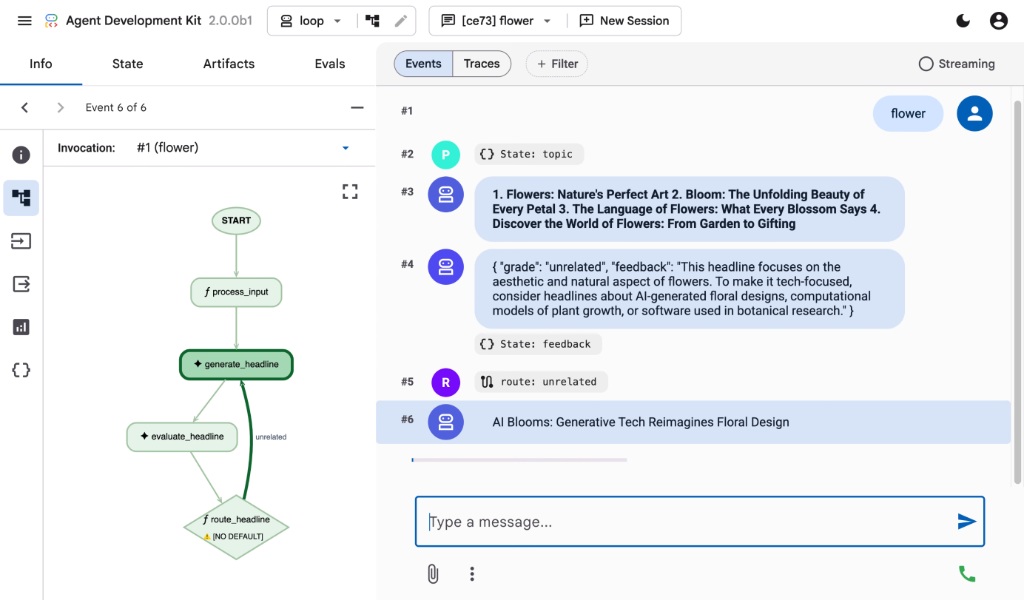
ADK 是谷歌官方的 Agent 开发套件,代码优先的路子,所有东西都在代码里定义。用下来有几个地方我觉得做得不错:
- • 自带一个网页版调试界面,Agent 每一步的决策过程都能实时看到,多个 Agent 协作的时候,中间哪一步卡住了、哪个输出有问题,都能直接查
- • 力推前面提到的 A2A 协议,想让不同框架做出来的 Agent 能互相通话
- • 除了 Python,还有 Java、Go、TypeScript 的 SDK,用 Java 技术栈的团队可以省不少事(看重点)
- • 虽然是谷歌出的,但不绑死 Gemini,通过 LiteLLM 可以接别家模型,国产模型也能用
不足的地方就是出来的时间短,社区里能参考的踩坑经验没有前面几个多。
Microsoft Agent Framework:接替 AutoGen 的
开源地址:https://github.com/microsoft/agent-framework
Star 数 13.1k,MIT 协议。
前面说到 AutoGen 进了维护模式,微软的精力就挪到这个新框架上了。它是把 AutoGen 的多智能体编排能力和 Semantic Kernel 的企业级功能合并到一起做的,今年上半年发了正式版,状态持久化、可观测性这些生产环境要用的东西都是内置的,不用自己再拼。
Star数现在还不多,但更新很勤,我看提交记录基本每天都有。如果团队本来就是微软技术栈,或者手里有 AutoGen 的老代码要维护,建议直接看这个,新功能别再指望 AutoGen 了。老项目继续跑着没问题,短期内不会有什么影响。
放一起看一下
上手建议
周末想玩玩,感受一下多智能体是怎么回事,用 CrewAI,半小时能出东西,成就感直接给你拉满。
正经业务要上线,建议你用 LangGraph,前期学起来是慢一点,但流程可控、能断点续跑、能看清楚每一步,这些在生产环境都是实打实要用的。
谷歌云的团队看 ADK,微软系的看 Agent Framework,跟着自己已经在用的生态走,一般不会错。
MetaGPT 的话,大家可以玩一玩,主要是看看"一群 Agent 按软件公司的流程协作"实际跑出来是什么样。看完之后对多智能体的理解会具体很多,比看十篇概念文章有用。
最后说说实际用起来的坑
多智能体难的地方,我的体会是下面这三件事,比选框架重要,也基本都会遇到。
1.token消耗量: Anthropic 公开的数据是,单个 Agent 的 token 消耗大概是普通对话的 4 倍,多智能体系统是 15 倍。前面那个 90.2% 的效果提升,很大程度是花 15 倍的钱换来的。 所以这套东西只在复杂任务上划算,简单问答用多智能体就是浪费。他们还提到一个数据,token 用量解释了 80% 的性能差异,也就是说与其纠结换哪个更强的模型,不如先想清楚怎么把算力合理地分给各个 Agent。
2.交接的时候丢信息: Agent 之间传任务,如果只传一句结论,比如"查完了,没问题",细节就全丢了,拿到任务的 Agent 只能照着这句结论往下做,错了也查不出来是哪里错的。所以交接的时候要把依据和过程一起传过去。很多人图省事只传结论,线上出问题不少就出在这。
3.错误会顺着流程往下传: 流水线前面一环出了错,后面每一环都会在这个错误的基础上继续干,最后出来的报告看着像模像样,内容全是错的。所以环节之间要加检查,不合格就打回去重做,不能指望模型自己发现问题。
至于选框架,我的建议是别只看 star 数,先想清楚自己手里的活更像哪一种,是一个团队分角色一起干,还是一条流水线按步骤流转,想明白这个,对照上面的表格,基本就知道该装哪个了。



