面试考察点
分布式检索原理:面试官想考的不只是你知不知道这个报错,还有你有没有想过多分片架构下,一次分页查询到底是怎么执行的、每个环节的数据量有多大。这道题答好了,能证明你理解 ES 的分布式查询模型。
方案选型能力:scroll、search_after、PIT 这几个方案各自的原理和适用场景,能不能根据业务特点(实时性、能否跳页、数据量)选对方案。只会背 API 名字是不够的。
生产踩坑经验:这题特别能区分 “用过 ES” 和 “在生产环境被 ES 毒打过”。实际项目中深度分页的需求是怎么规避的、有没有改过 max_result_window,这些细节面试官一听就知道真假。
核心答案
一句话:深度分页问题指的是用 from + size 分页时,翻页越深,各分片和协调节点需要加载、排序的数据量越大,内存和 CPU 开销暴涨,甚至把集群打挂。所以 ES 默认限制 from + size 不能超过 10000(由 index.max_result_window 参数控制)。
解决方案一共四个,先上对比表:
| | | | |
|---|
from + size | 各分片取 from + size 条,协调节点汇总排序 |
| | |
scroll | 首查生成数据快照,用 scroll_id 游标遍历 | | | |
search_after | | | | |
PIT + search_after |
| | | |
浅分页老老实实用 from + size;全量导出用 scroll;实时的深度翻页用 search_after,讲究一致性就上 PIT + search_after。
深度解析
一、为什么 from + size 翻深了会出事
要搞懂这个问题,得先明白 ES 的查询是分两阶段的。
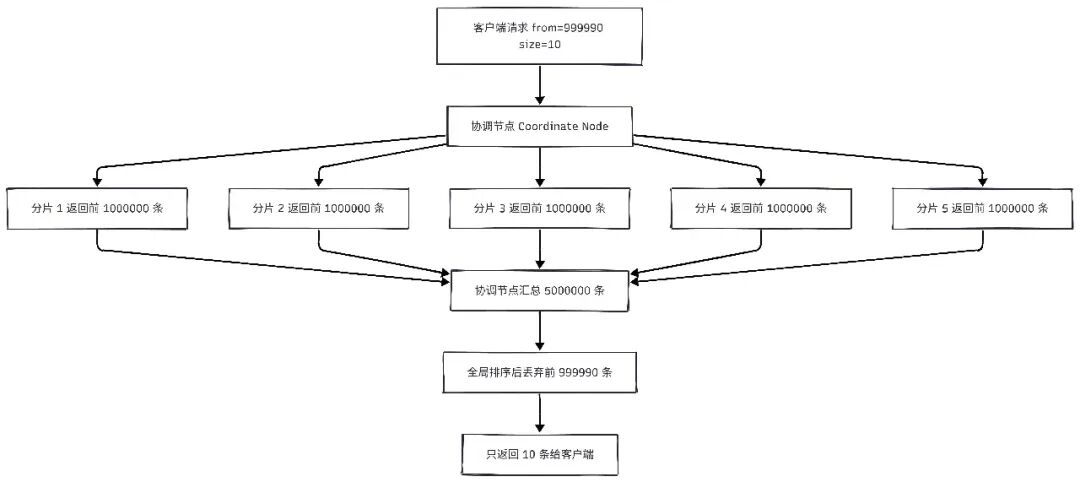 Elasticsearch 深度分页
上图就是翻页翻到第 10 万页时的真实场景,拆开来看:
- 阶段一:query 阶段。客户端请求到协调节点,协调节点把请求广播给索引的每个分片。注意,每个分片返回的不是你想要的那 10 条,而是
from + size 条——本例中就是 100 万条文档的元数据(_id 和排序值)。 - 阶段二:fetch 阶段。协调节点把 5 个分片返回的 500 万条数据做归并排序,找到全局排名 999991 ~ 1000000 的那 10 条,再回各分片取完整文档,最后把前面 999990 条全部丢弃。
看出问题了吧?用户只要 10 条数据,ES 却要在每个分片上查 100 万条、协调节点还要对 500 万条数据排序,堆内存和 CPU 全花在了 “最终要被丢弃的数据” 上。翻页越深,这个浪费越夸张,一次并发请求就能把节点内存打爆。
所以 ES 干脆设了道闸门:index.max_result_window 默认 10000,
from + size 超过这个值直接拒绝查询,报错信息里还会提示你用 search_after。
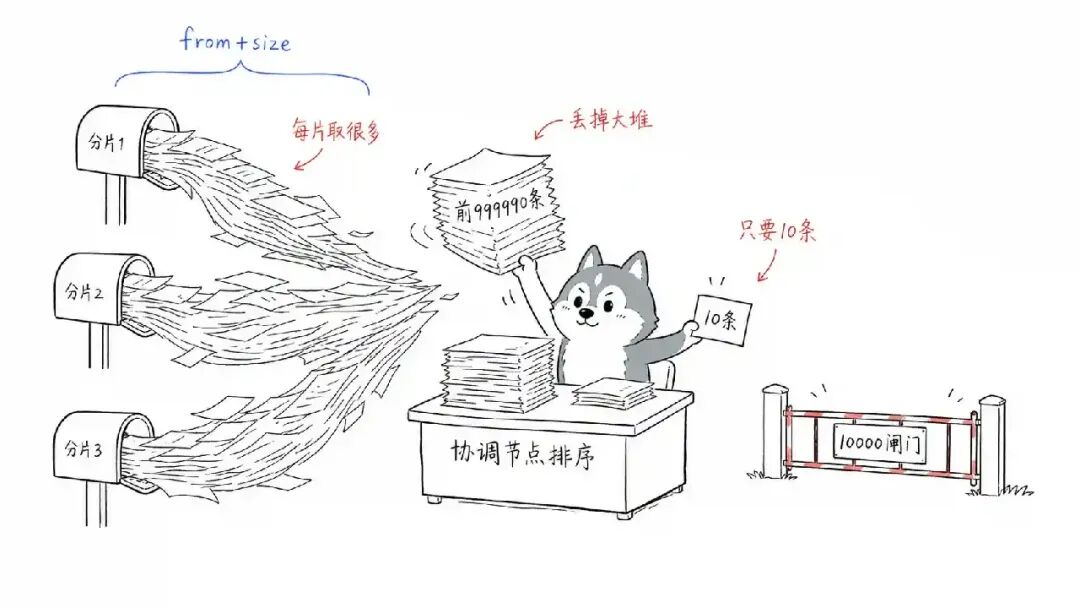 Elasticsearch 深度分页问题
二、方案一:scroll —— 快照式全量遍历
scroll 的思路是 “第一次查询时把结果集固化成快照,后面拿着游标接着取”,省去了每次重算的过程。
第一步,发起 scroll 查询:
// scroll=1m 表示快照保留 1 分钟
POST /order/_search?scroll=1m
{
  "size": 1000,
  "query": { "match_all": {} }
}
第二步,拿着返回的 scroll_id 继续拉:
POST /_search/scroll
{
  "scroll": "1m",
  "scroll_id": "FGluY2x1ZGVfY29udGV4dF91dWlk..."
}
每批拿 1000 条,循环到没有数据为止。它的原理是首次查询时在集群里创建一个
search context(搜索上下文),之后每次翻页都基于这个上下文继续,不用再从 from 0 开始算。
但坑也不少,我挨个说:
- 非实时:快照生成后,这段时间里的新增、修改、删除对它是不可见的。所以它压根不适合做用户侧分页。
- 吃资源:每个 scroll 会话都要在节点上维护一个搜索上下文,开着不关就是白白消耗堆内存。用完必须调
DELETE /_search/scroll 主动清理。 - 不能跳页:只能顺序往后拉,想直接翻到第 500 页?没门。
另外多说一句,从 ES 7.10 起,官方已经把 scroll 标记为不推荐(deprecated)用于常规分页了,现在只建议在从 7.10 之前的旧集群 reindex 数据这类场景用,面试里把这个版本演进讲出来是个加分项。
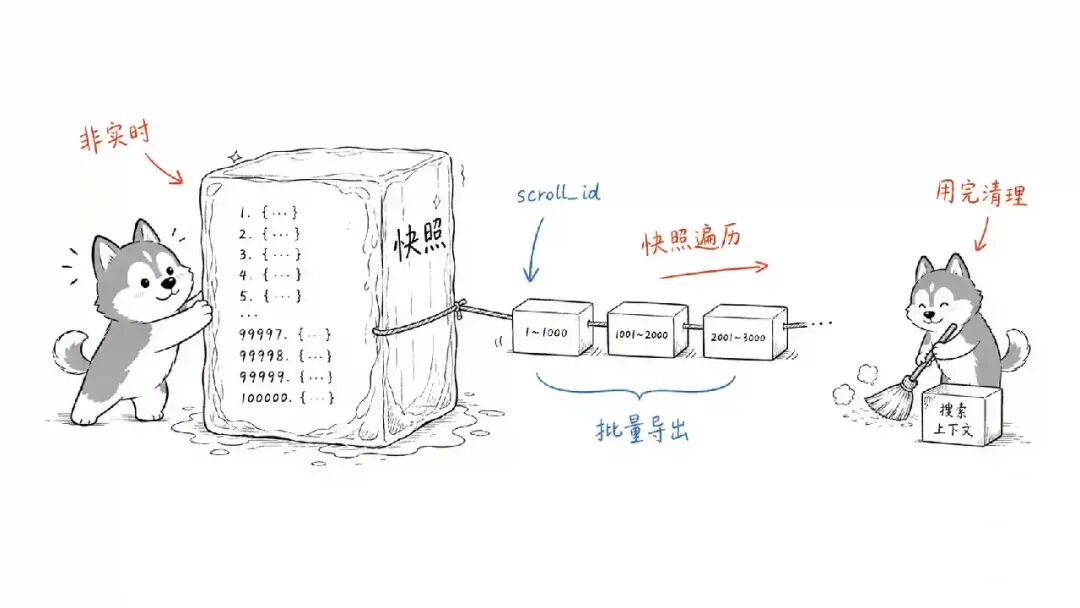 Elasticsearch scroll 快照遍历
三、方案二:search_after —— 游标式实时翻页
这是目前实时深分页的主力方案。思路很直白:既然跳过前 100 万条开销大,那我就记住上一页最后一条的排序位置,下一页直接从那个位置往后取。
第一页正常查,不用
from:
POST /order/_search
{
  "size": 10,
  "sort": [
    { "create_time": "desc" },
    { "_id": "asc" }
  ]
}
假设返回的最后一条文档排序值是 [1699999999999, "order_10086"],下一页就把这组值塞进 search_after:
POST /order/_search
{
  "size": 10,
  "search_after": [1699999999999, "order_10086"],
  "sort": [
    { "create_time": "desc" },
    { "_id": "asc" }
  ]
}
每个分片直接定位到这个排序值之后,各取 10 条回来,协调节点只需要处理几十条数据。不管你翻到第 10 页还是第 10 万页,单次查询的开销基本恒定。
有个细节得注意:排序字段组合起来必须能唯一确定一条文档。比如只按 create_time 排,同一秒可能有几百条订单,分片边界上就没法判断该从哪条开始,会漏数据或者返回重复。所以标准做法是再加一个唯一字段(比如
_id)兜底,这也是面试官爱追问的点。
它的短板也明显:只能一页一页往后翻,没法跳页。不过你想想 Google 也只让你翻几十页,绝大多数业务根本不需要真·跳到 10 万页,产品层面限制一下就绕过去了。
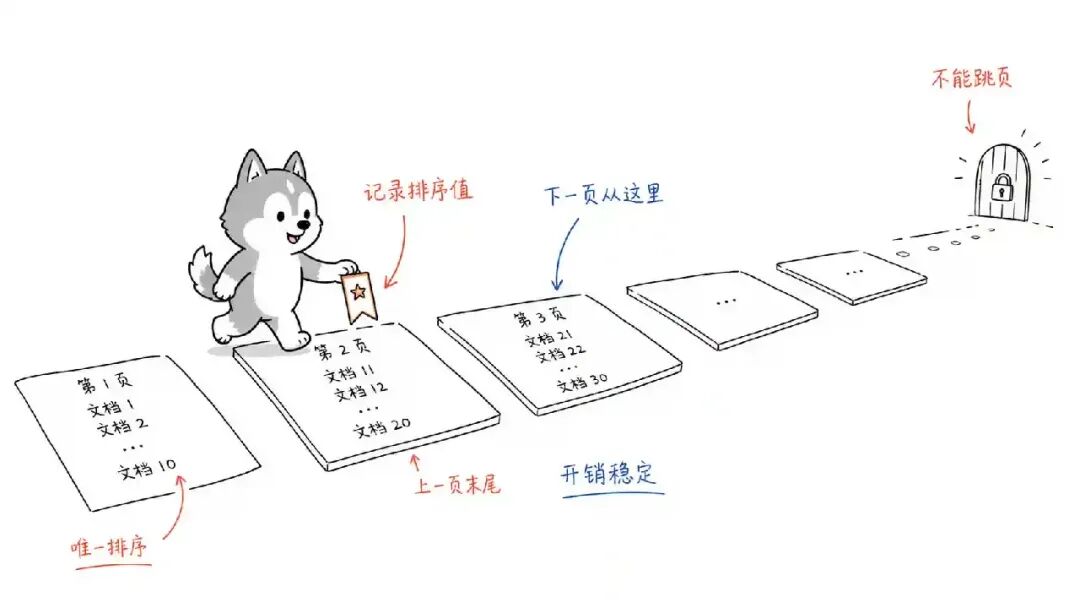 Elasticsearch search_after 翻页
四、方案三:PIT + search_after —— 官方当前推荐
search_after 有个小隐患:翻页过程中数据变了怎么办?比如你翻到第 3 页时有人删了第 2 页的几条数据,第 4 页就可能漏数据。
ES 7.10 引入了 PIT(Point in Time,时间点快照) 来解决这个问题,先创建一个轻量级视图:
// keep_alive 表示这个视图保留 1 分钟
POST /order/_pit?keep_alive=1m
返回一个 pit id,后续查询带上它:
POST /_search
{
"size": 10,
"pit": {
"id": "46ToAwMDaWR5ZHVja2VyWc2VjX2g...",
"keep_alive": "1m"
},
"sort": [
{ "create_time": "desc"
},
{ "_id": "asc" }
]
}
之后的使用方式和 search_after 完全一样,把每页最后一条的排序值传给下一页的 search_after。它比 scroll 轻量得多(不固化完整快照,只记录当前点的段状态),又能保证整个翻页过程数据视图一致。官方文档现在推荐的深分页组合拳就是 PIT + search_after,面试说到这一层,基本稳了。
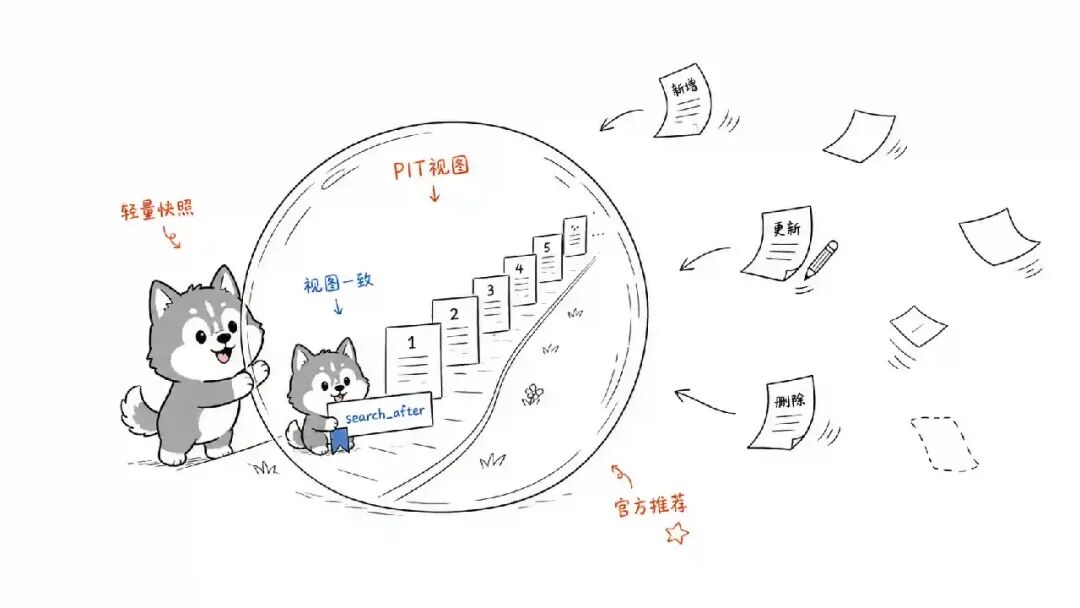 Elasticsearch PIT 深分页
五、方案四:调大 max_result_window —— 不推荐
把限制调大确实能让查询不报错:
PUT /order/_settings
{
  "index.max_result_window": 1000000
}
但本质只是拆了闸门,每个分片和协调节点的内存开销一点没少,OOM 风险原封不动地等着你。除非集群资源特别充裕、跳页需求是硬性的(比如财务对账页面必须能跳到任意页),否则别动这个参数。真有硬性跳页需求,更稳妥的路子是让数据源兜底,比如走离线任务预排序、走 secondary 查询,或者干脆限制产品只能连续翻页。
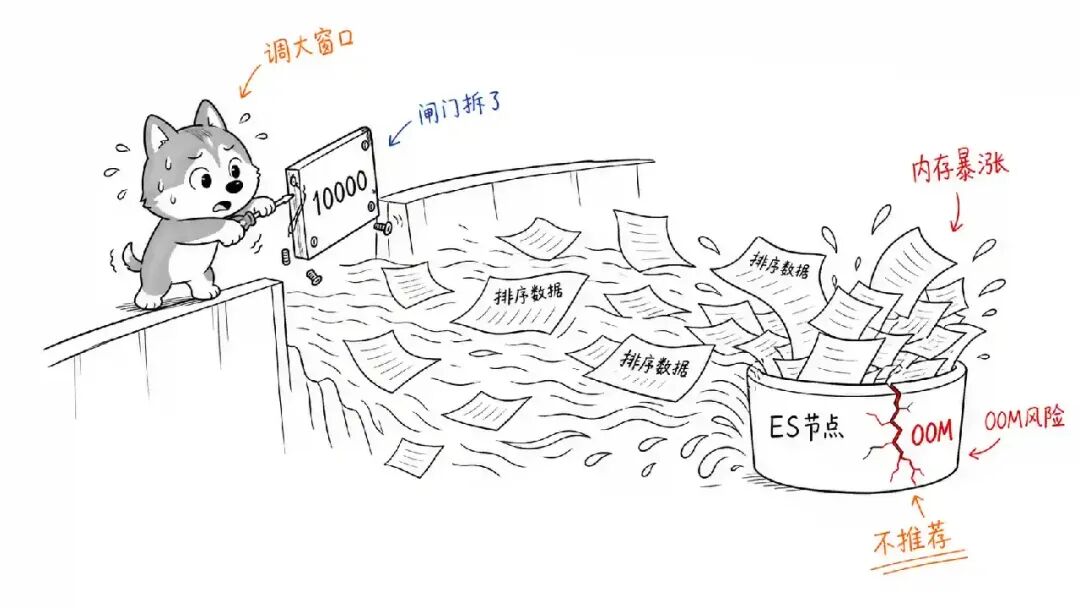 Elasticsearch 分页窗口风险
面试高频追问
追问一:search_after 为什么必须搭配唯一排序字段?
因为分片需要根据排序值精确定位 “上一页结束的位置”。如果排序值不唯一,同一值对应多条文档时,边界处的文档可能被跳过或重复返回。所以通常在业务排序字段后面补一个 _id 做第二排序键。
追问二:scroll 和 search_after 的核心区别是什么?
scroll 是快照模型,上下文里固化了结果集,非实时但分页过程数据一致,适合离线导出;
search_after 是无状态的游标模型,每次都查最新数据,实时但不保证翻页过程数据一致。要兼得一致性和深分页,用 PIT + search_after。
追问三:为什么 ES 默认上限是 10000,而不是 100 万?
因为协调节点的开销 = from + size × 分片数,这个值要控制在堆内存能轻松扛住的范围。10000 是官方在 “常见分页需求” 和 “集群安全” 之间取的保守经验值。
追问四:业务上让你设计一个支持千万级数据浏览的列表页,你怎么做?
产品层面限制跳页,只提供上一页/下一页和条件筛选缩小范围;技术上用 search_after 或 PIT + search_after 连续翻页。这样既满足浏览需求,又不给集群埋雷。
常见面试变体
- 变体一:ES 的
from + size、scroll、search_after 三者有什么区别? - 变体二:为什么 ES 查询超过 10000 条就报错?怎么处理?
- 变体四:什么是 PIT?它解决了 search_after 的什么问题?
记忆口诀
浅翻 from + size,导出用 scroll,实时深翻 search_after,要一致性加 PIT,调大窗口是自欺。
总结
深度分页的根子在分布式架构:翻页越深,各分片和协调节点要处理的数据量越大,所以 ES 用 10000 的默认上限拦住了
from + size。应对方案按场景选:浅分页用 from + size,离线导出用 scroll,实时深翻页用 search_after,讲究数据一致就用 PIT + search_after。把每个方案 “为什么快、缺什么” 讲清楚,这道题就答到位了。



