第一时间收到文章更新
在线 Java 面试刷题(已更新334题,图文并茂):
https://www.quanxiaoha.com/java-interview
面试考察点
问题本质的理解:面试官想看你是否意识到这是个分布式双写一致性问题:两个存储系统没法用一个本地事务罩住,先别说方案,得先把问题定性。
方案演进与权衡意识:从同步双写到 MQ 异步再到监听 binlog,每种方案解决了什么、又引入了什么新问题,能不能讲出这条演进线,是区分 “背答案” 和 “真做过” 的关键。
生产实践深度:消息乱序、消息丢失、对账兜底、全量重建,这些坑踩过没有。能主动聊到这些细节,面试官眼睛会亮。
核心答案
先给结论:ES 和数据库之间追求的是最终一致性,而不是强一致性。ES 本身是近实时(NRT)引擎,写入后默认要等 1 秒左右的 refresh 才可见,从根上就没法强一致。
主流方案有 4 种,生产上一般是组合拳:
| | | | | |
|---|
| | | | | |
| | | | | |
| 监听 binlog(Canal/Debezium) | | | | | |
|
| | | | |
一句话方案:binlog 订阅做主链路,版本号防乱序,定时对账做兜底,接受秒级延迟的最终一致。
深度解析
一、问题是怎么来的:双写困境
假设商品数据在 MySQL,搜索走 ES。任何一次商品变更,都得同时改两个地方:
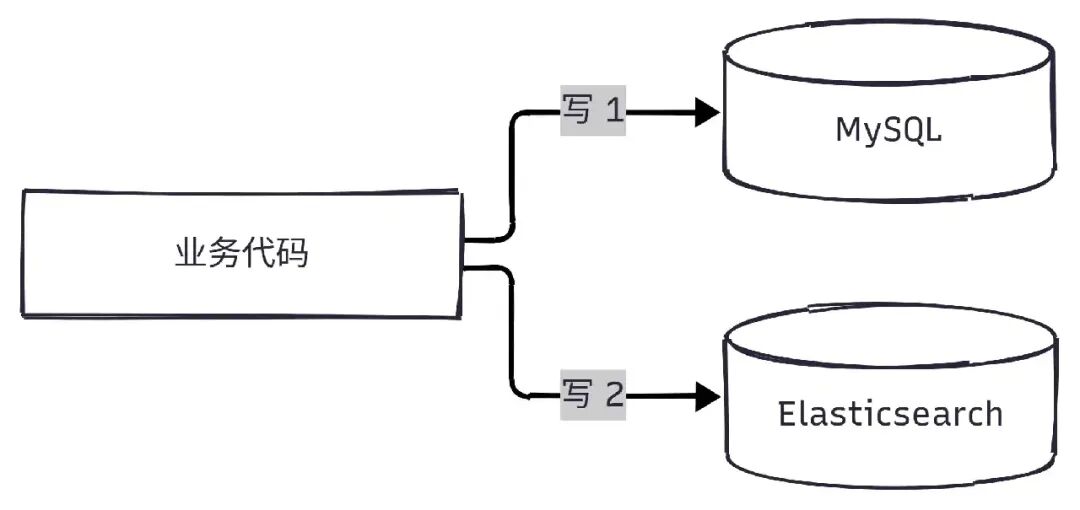 业务分别写入 MySQL 与 ES 的双写流程
看着挺简单?坑就坑在这两步没法原子化。先写 MySQL 再写 ES:
- MySQL 写成功了,ES 写挂了 → 数据库有新数据,搜索还是旧的
-
ES 写成功了,MySQL 回滚了 → 搜得到,点进去 404
反过来顺序也一样有问题。这就是典型的分布式双写困境:本地事务管不了两个系统,而引入强一致的分布式事务(如 Seata 的 XA 模式)代价太大,搜索这种场景根本不值得。
所以先定基调:接受最终一致性,把不一致窗口压到秒级,并且保证最终能对上。
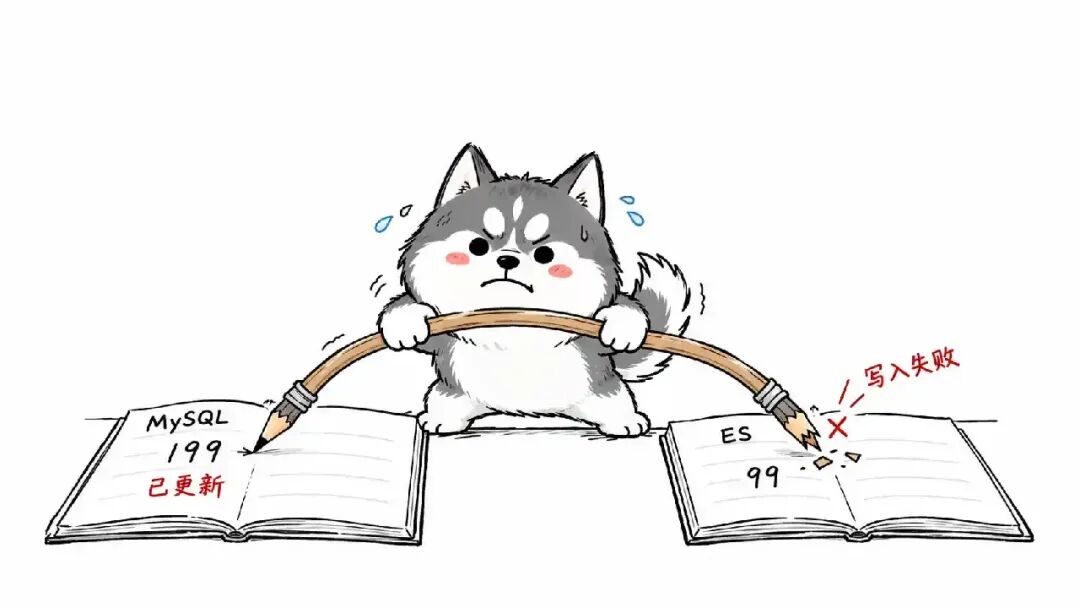 MySQL 更新成功但 ES 写入失败
二、同步双写:最先被想到,也最先被放弃
在业务代码里写完 MySQL 接着写 ES,就是同步双写。它的问题一箩筐:
- 耦合高:业务代码里混着搜索逻辑,索引结构一改,所有写入的地方都得跟着改
- 性能差:接口响应时间被 ES 的写入拖长,ES 抖一下,你的下单接口跟着抖
唯一的好处是实现简单。小系统、对一致性不敏感的场景凑合能用,生产环境基本不考虑。
三、MQ 异步:解耦了,但有新坑
演进到第二步,大家会把 ES 的同步改成异步:
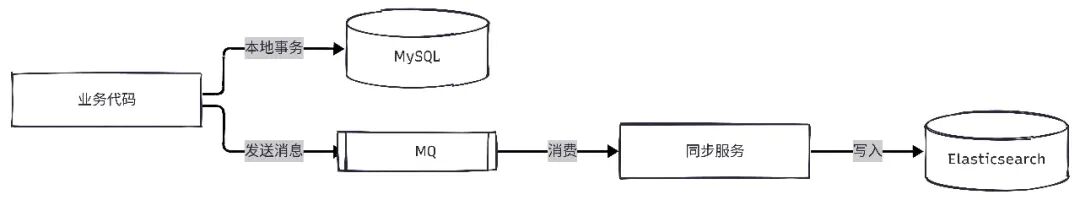 MySQL 数据通过 MQ 异步同步 ES
流程拆开讲:
- 写入侧:业务代码在本地事务里更新 MySQL,事务提交后发一条变更消息到 MQ
- 好处:业务和搜索彻底解耦,接口性能不受 ES 影响,MQ 还自带失败重试
但新坑跟着来了,面试官追问基本就围着这两个坑转:
坑一:消息发丢了。MySQL 更新成功,还没来得及发 MQ,应用挂了,这条变更就永久丢了。解法有两条路:
- 本地消息表:事务里顺手往一张
sync_message 表插一条记录,同一个事务保证不丢;再用定时任务扫表把没发出去的消息补发 -
事务消息:像 RocketMQ 提供的事务消息(半消息 + 回查机制),也能保证本地事务和发消息的原子性
坑二:消息乱序。商品先改价 99 再改成 199,两条消息如果被并发消费,199 先写入、99 后写入,ES 里就停留在一个错误的价格。解法也有两层:
- 顺序消息:按商品 ID 做路由键,同一个商品的消息落到同一个队列,天然有序
四、Canal 监听 binlog:生产主流方案
MQ 方案还有个残留问题:发消息这事还是嵌在业务代码里,新表忘了发消息、多数据源绕过了统一入口,都会漏。于是就有了更彻底的方案——直接订阅 MySQL 的 binlog:
 Canal 订阅 binlog 同步 ES 并对账
这条链路的关键点:
-
Canal 是阿里开源的组件,原理是伪装成 MySQL 的从库(slave),向主库发送 dump 协议请求,把自己当成一个 replica 来接收 binlog 增量数据,MySQL 还以为自己在给从库做主从复制(前提是 MySQL 开启 ROW 格式的 binlog)
- 业务零侵入:业务代码只管写 MySQL,同步逻辑完全在外面,加表、改字段都不用动业务代码
- 不丢数据:binlog 是 MySQL 事务提交才写的,只要事务提交了,变更就一定在 binlog 里;Canal 自己还有位点(position)管理,消费到哪了断点续传
- 中间再接一层 MQ 做缓冲和削峰,同步服务消费后写 ES,整条链路稳得很
代价也明摆着:链路长了,运维成本上来了(Canal 集群、MQ、同步服务都要维护),延迟也从毫秒级变成秒级。不过对搜索场景来说,秒级延迟完全能接受。
国外用得多的是 Debezium,也是同类 CDC 工具,一般接 Kafka,思路完全一样。
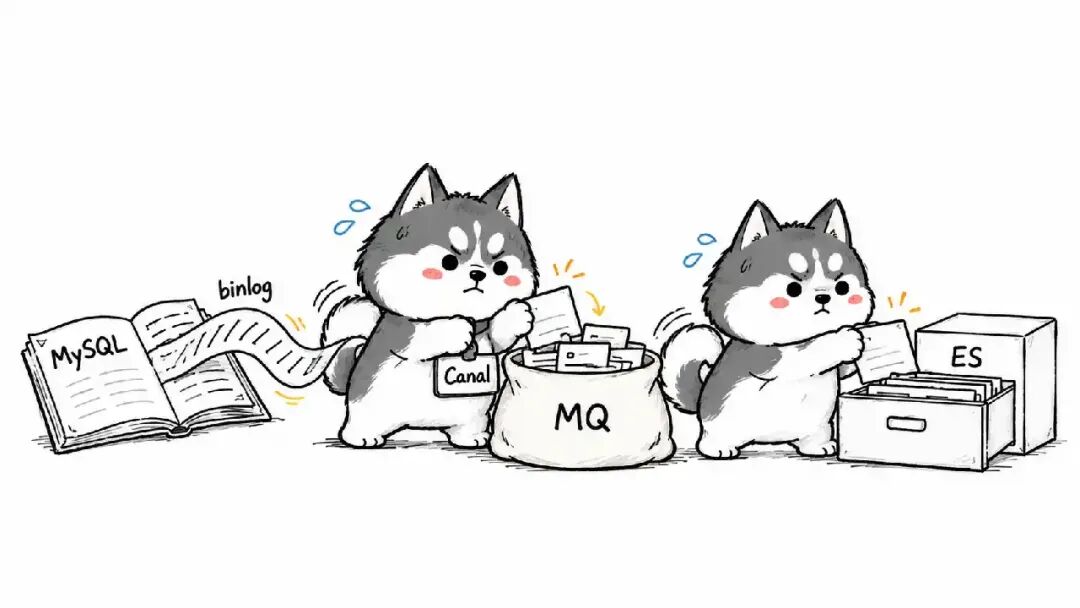 Canal 经 MQ 向 ES 同步数据变更
五、版本号防乱序:最值得讲的一手
不管用哪种方案,乱序都绕不开,而解法里最漂亮的一手,就是利用 ES 的外部版本控制。
思路:每条数据带一个单调递增的版本号(可以用 MySQL 的更新时间戳,或者单独维护一个 version 字段随事务自增),写入 ES 时带上:
IndexRequest request = new IndexRequest("product")
.id(event.getProductId())
// 外部版本控制:ES 只接受不小于当前版本的写入
.version(event.getVersion())
.versionType(VersionType.EXTERNAL_GTE)
.source(event.getDataJson(), XContentType.JSON);
try {
client.index(request, RequestOptions.DEFAULT);
} catch (EsRejectedExecutionException e) {
// 版本冲突 = 这条是旧数据迟到了,直接跳过,属于预期内的正常情况
log.warn("旧版本消息到达,跳过: {}", event);
}
这段代码妙就妙在:就算 199 的消息先到、99 的消息后到,ES 一比对版本号发现 99 是旧版本,直接拒绝写入,错误数据根本没有机会覆盖新数据。乱序问题从 “预防” 变成了 “免疫”,这个思路和 CAS、乐观锁是一脉相承的。
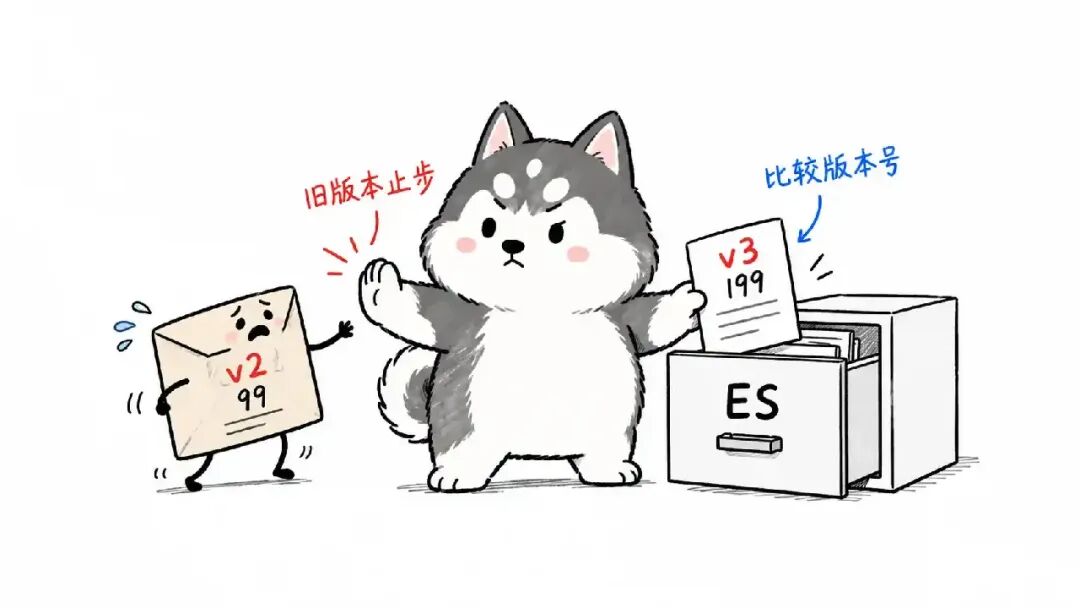 ES 版本号拦截迟到的旧消息
六、兜底:对账与重建
上面所有方案加起来,也只能把不一致概率压到极低,压不到零。所以生产上一定还要有兜底:
- 定时对账:低峰期跑定时任务,抽一批数据比对 MySQL 和 ES(可以比对更新时间或关键字段摘要),发现不一致就按数据库为准修复 ES
- 全量重建:索引结构大改、或者脏数据太多修不过来,直接从 MySQL 全量刷一遍新索引,再用别名切换,这也是应对 “已经烂了” 的终极手段
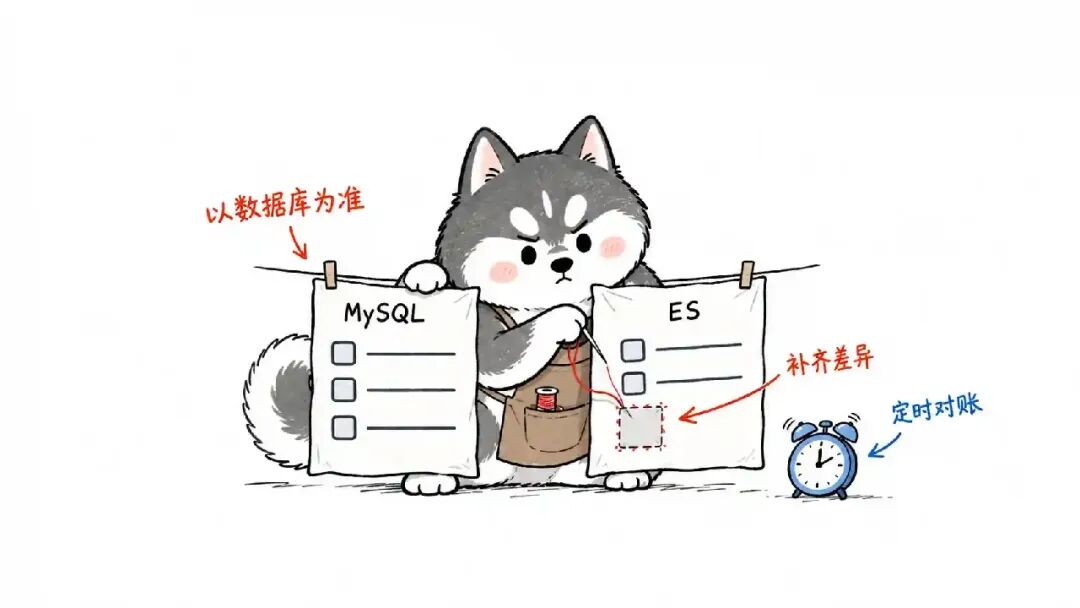 以 MySQL 为准对账修复 ES 数据
面试高频追问
追问一:MySQL 写成功了但 MQ 发送失败,怎么办?
本地消息表(事务内插记录 + 定时任务补发)或 RocketMQ 事务消息(半消息 + 回查)。答的时候点到 “核心是把发消息这件事也纳入事务保证” 就到位了。
追问二:消息乱序导致旧数据覆盖新数据,怎么解决?
两层:按业务 ID 路由的顺序消息(减少乱序发生),加上 ES 外部版本控制(乱序发生了也不怕)。
追问三:为什么不上强一致方案,比如分布式事务?
ES 近实时的机制决定了它做不到强一致(写入默认 1 秒后才可搜到);而搜索场景容忍秒级延迟,为它付出强一致的性能代价不划算。一致性级别要跟业务价值匹配。
追问四:线上已经发现一批脏数据了,怎么修?
小范围:对账脚本按库修复;大面积:全量重建索引 + 别名切换。
常见面试变体
- “双写不一致你是怎么处理的?”(同款题,换个马甲)
- “Canal 的工作原理是什么?”(考伪装 slave 收 binlog 这个机制)
- “如何保证缓存和数据库的一致性?”(同款思路:先更新数据库再删缓存 + 延迟双删 + 兜底,可以对比着答)
- “ES 的写入流程是什么?为什么是近实时的?”(往 refresh 机制上聊)
记忆口诀
双写不可靠,异步入 MQ;binlog 最稳,版本防乱序;对账做兜底,最终一致就好。
总结
这道题答的核心逻辑链是:先定性(分布式双写问题,只能最终一致)→ 再给演进(同步双写 → MQ 异步 → Canal 监听 binlog)→ 补细节(本地消息表防丢失、版本号防乱序、对账兜底)。把这条线讲顺,再主动提一嘴 “我们线上是 Canal + MQ + 版本控制 + 对账这套组合”,基本就是加分收尾了。
好书推荐
操作入门+核心设计+实战演练+进阶展望,从人设定义到记忆系统,从知识库到工作流编排,图解优先化繁为简,实践驱动即学即练,从零上手Coze智能体开发。
华为USG AI防火墙实战指南:全实验驱动上手+核心功能全覆盖+紧跟技术前沿+所学即可落地,人工智能时代企业网络安全实战一本通!
加入小哈的星球,你将获得: 专属的项目实战(4个项目) / 1v1 提问 / 简历修改 / Java 学习路线 / 社群讨论 / 学习打卡 / 每月赠书
- 《前后端分离博客项目(全栈开发)》 已完结,演示链接:http://116.62.199.48/
- 项目阅读地址:https://quanxiaoha.com/column
截止目前,累计输出 150w+ 字,讲解图 4013+ 张,还在持续爆肝中..
戳我加入学习,解锁全部项目,已有4900+小伙伴加入
最近面试BAT,整理一份面试资料《Java面试BATJ通关手册》,覆盖了Java核心技术、JVM、Java并发、SSM、微服务、数据库、数据结构等等。
获取方式:点“在看”,关注公众号并回复 Java 领取,更多内容陆续奉上。
PS:因公众号平台更改了推送规则,如果不想错过内容,记得读完点一下“在看”,加个
“星标”,这样每次新文章推送才会第一时间出现在你的订阅列表里。
点“在看”支持小哈呀,谢谢



