做深度学习,代码肯定是躲不掉的。但这不是让你先把代码学到精通再开始做深度学习。
我的建议是:先跑起来→再看懂→再修改→最后自己做。相对更容易坚持。
1. 搭环境,跑通第一个demo
刚开始不要折腾太复杂的环境,如果不会装Ubuntu、配PyTorch,就找教程,或者租台云服务器。花点钱省时间不丢人。咱们的目标只有一个:跑通一个MNIST或ResNet demo。看到loss下降,你才有正反馈。
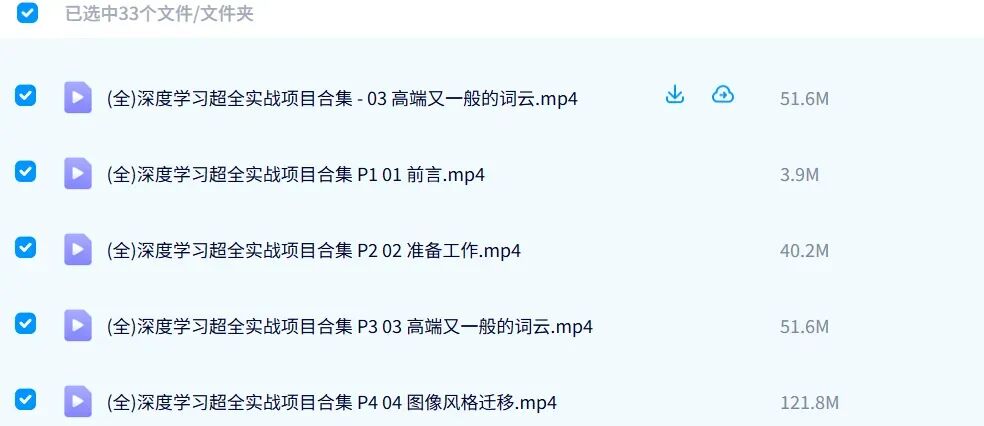
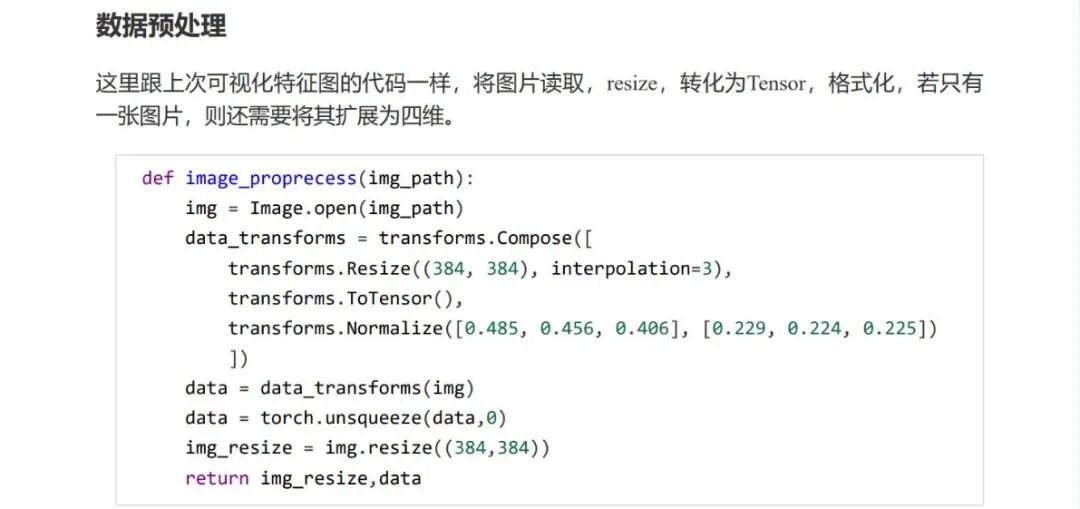
这一步我分享一套个人认为非常简单实用的PyTorch实战教程,还有我收集整理的28个深度学习实战项目。其中项目部分还包含31节讲解视频,代码逐行解读。你可以在里面挑自己感兴趣的跟着做,不需要一次全部学完,这有助于你快速上手。
2. 找代码,先跑再读
拿到GitHub项目,不要打开几千行代码就开始从第一行啃。先把环境配好、代码跑通,然后再去找:据在哪里?模型在哪里?Loss在哪里?训练循环在哪里?
先建立整体认识,再去看细节。看不懂很正常,尤其是第一次接触别人写的工程代码。
3. 看代码,用笨办法
看不懂太正常,要学会把代码拆小。不知道一个函数干嘛,就问GPT;不知道tensor怎么变化,就print输入输出的shape;不知道数据怎么流,就打断点跟一遍。你可以从AlexNet、VGG开始,对着代码敲一遍。要牢记咱们的目的是看懂、修改,最后能够自己写深度学习代码。
4. 边用边补基础
NumPy、Tensor、Dataset、DataLoader、Loss、Optimizer、反向传播、模型训练流程,这些是前期真正应该熟悉的。理论也不用一次学完。MLP、CNN、Transformer 先理解基本结构,用到反向传播、注意力机制等内容时,再回头补。
不要等全部学会才开始做项目,因为很容易一直学、一直不开始。
5. 改代码,从缝合开始
这一步很重要。我建议你先从最简单的改动做起:改参数→换模块→加模块→改网络结构→对比实验。后面做科研,就去paper with code搜任务和SOTA,看前50个开源算法,找baseline,搭积木,就是学会在已有Baseline上逐步修改。
这里我已备好366个深度学习即插即用模块合集,里面把常见的注意力、特征融合、卷积、特征提取、轻量化等模块按类型整理好了。
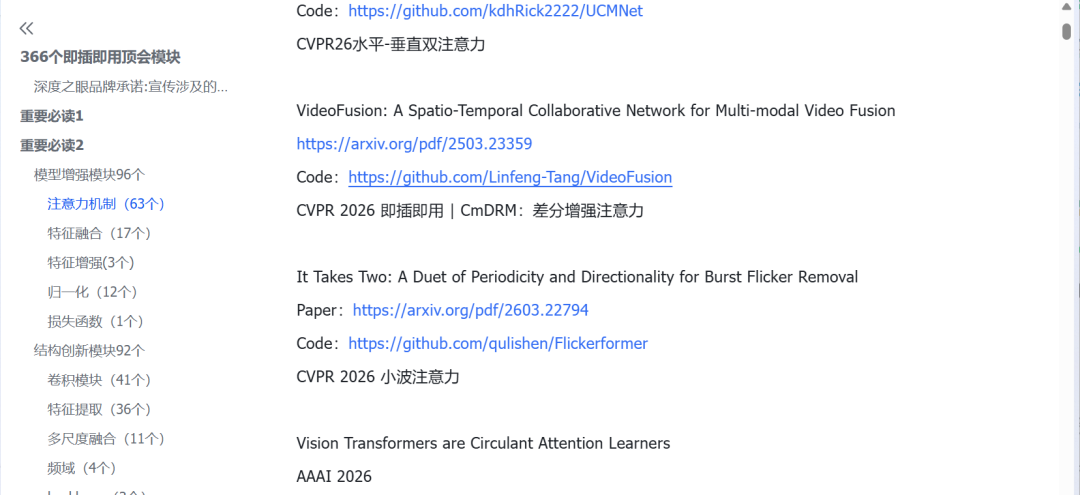
刚开始不需要研究几百个,先搞懂一个模块怎么接进现有网络,再自己动手改。
6. 论文复现,学会主动求助
等你已经能看懂Dataset、Model、Loss、Optimizer和训练流程,再去复现论文,会发现没有刚开始那么可怕。但如果报错实在看不懂,可以直接问GPT、CSDN、B站,或花红包找博士生。描述清楚问题,比自己钻牛角尖强。
总之,学习代码没有捷径,就是多跑、多调、多敲。先跑起来,再看懂;先会改,再谈自己写。



