最近,一个叫 Jev 的 AI 模型突然在开发者圈子里炸了。更可怕的是,根据最新消息,Jev 最近正在洽谈 10 亿美元融资,最新估值 100 亿美元——而这距离 Jev 推出,还不到 1 个月。
Jev 这个新模型,它不生成文本,不跟你聊天,甚至不写代码。你给它一段数据和一组结构化问题,它返回类型化的答案和校准过的概率值。TypeSafe AI 管它叫「System One 模型」,一种全新的模型类别。9 月 15 日发布早期访问版本的同时,公司宣布获得 DCVC 领投的 4000 万美元种子轮融资,估值 2 亿美元。
开发者社区很快炸开了锅。TypeSafe 公布的数据显示,在分类任务上 Jev 比 GPT 系列快约 193 倍、便宜约 445 倍。Vercel CEO Guillermo Rauch 测试后说,在 p95 延迟上 Jev 比 GPT Luna 快 18 倍,而且更准。LangChain 第一时间写了集成指南。
但真正让 Jev 值得关注的,不是这些数字,而是它背后的人和他的判断。
Jev 的创造者 Diogo Almeida 曾在 OpenAI 工作近四年,是 GPT-4、ChatGPT 以及 RLHF/InstructGPT 的合著者。 他所在的团队基本上发明了「后训练」这个概念。换句话说,今天几乎所有大语言模型背后的核心训练范式,都有他的手笔。
而在 Jev 发布前六周,Almeida 在 AI Engineer 大会上做了一场 18 分钟的演讲,标题叫「What's Next After RLHF?」。
他在台上说,自己是 OpenAI 内部少数公开「黑」ChatGPT 的人;他认为 ChatGPT 和 Claude Code 属于同一个时代;他相信整个行业终将把 RLHF 时代视为一段「奇怪的弯路」。
一个技术范式的缔造者,亲手给自己创造的时代写悼词,这种事不常发生。
以下是演讲中的一些核心观点:
「下一个时代不是 Claude Code 时代。ChatGPT 和 Claude Code 属于同一个时代。」
「为什么所有 LLM 都需要人类在回路中?因为我们就是把人类放进了回路里。」
「无论模型有多错,它都会看起来是对的。」
「我们只是在自动化『写软件』这件事,但软件本身的表达力并没有变。」
「原始的 Scaling Law 是错的。」
以下是这场演讲的精编转录文字:
01 「黑 ChatGPT 的人」
我叫 Diogo Almeida,今天讲的主题是「RLHF 之后是什么」。更准确地说,应该叫「我们所处的 ChatGPT 时代之后是什么」。
先给你们一个提示:下一个时代不是 Claude Code 时代。我后面会解释,但我认为 ChatGPT 和 Claude Code 属于同一个时代。
看看到底是谁在黑 ChatGPT|图片来源:Youtube
为什么你们该听我说?我是 OpenAI 基本所有重磅论文的合著者,包括 GPT-4、ChatGPT、RLHF/InstructGPT。我所在的团队基本上发明了「后训练」这个概念。所以这些东西我确实很熟。但真正让我有点特别的是,我大概是 OpenAI 内部少数公开黑 ChatGPT 的人。
别误会,我不是讨厌 ChatGPT 这个产品。ChatGPT 是一个改变世界的产品,大概会一直存在下去。但我也看到了它的局限性。我认为今天 AI 领域发生的很多事情,可以追溯到我们当初做 ChatGPT 背后算法时的一些小决策。
02 AI 领域现在到底怎么了
我觉得对所有做 AI 的人来说,现在最关键的问题是:到底发生了什么?
观点的光谱上有两个极端阵营。
阵营一认为,AI 不仅进展顺利,而且好得不可思议。每个 benchmark 都在碾压人类水平,而且还在加速。所有 NLP 基准测试都在被碾碎,LLM 自主运行的时间据说在指数增长。
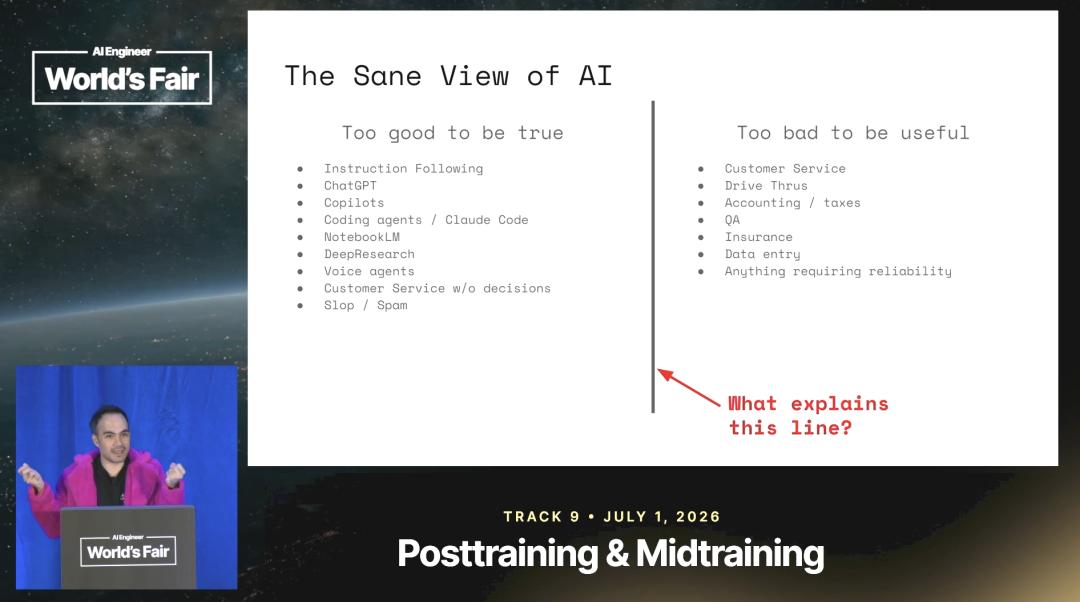
对当下 AI 持有对立观点的两个阵营|图片来源:YouTube
阵营二认为,AI 不仅进展不顺,而且烂得不可思议。AI 是泡沫,基本没创造价值,就是一堆循环融资。如果 AI 真的这么牛,为什么一切最后都只是个聊天应用?很多人已经放弃了「颠覆性 AI 革命」这种说法,开始降级成「像 B2B SaaS 那样有很大价值」。
两个阵营都有真实的证据,都有聪明人在里面。唯一的共识是:大家都觉得 AI 现在很疯狂,但原因完全不同。
我想回答的问题是:对 AI 的「正常」看法应该是什么?
把两边的证据都摊开,什么是最简单的解释,能说明为什么有些事好得不真实,有些事不仅差,而且差到我们还得雇人去做一些看起来很蠢的任务?
注意看,右边那些 AI 做不好的任务,看上去比左边那些要简单得多。我们能解未解的数学难题,但客服还需要人来做决策?我觉得这种状况相当疯狂,而任何做 AI 相关工作的人都应该对此有一个解释。
03 Assistance vs. Automation
我的答案是这样的。
左边那些 AI 做得好的任务,不是碰巧有人类在回路中。这些任务的目标就是取悦回路中的人类。 它们本质上就是 human-in-the-loop 任务。Claude Code 的目标不是让代码跑起来,否则它对话的方式会完全不同。它的目标是让人类满意。
而右边那些看起来更基础的任务,目标是去掉人类。理想状态是跑在后台服务器上,你永远不用看它,最终变成你完全不操心的遗留软件。
这就是 assistance 和 automation 的分界线。
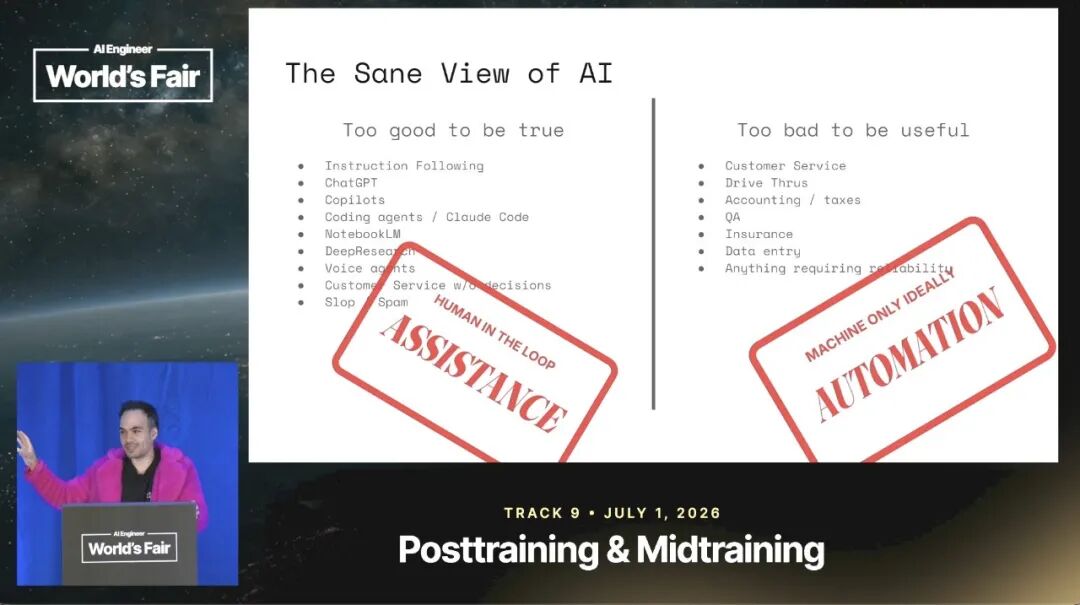
对于 AI 看法本质是对于 AI 功能的不同|图片来源:YouTube
第一课:今天的 AI,所有从 RLHF 继承下来的东西,在 human-in-the-loop 的事情上不可思议,但做不了 automation。
每个企业都学到的教训是,不要让 AI 做对你业务有风险的决策。 普遍的做法是把所有成本推给用户,比如在客服里让用户面对无穷无尽的文档页面,但绝不让 AI 做昂贵的决定。这种模式很糟糕,但这就是 AI 的现状。
04 RLHF 的问题
RLHF 是 ChatGPT 背后的算法,但其实是今天几乎所有 LLM 背后的算法。就使用量而言,大概 100% 的 LLM 都用 RLHF 训练。
它的本质就是两步:收集人类偏好,优化人类偏好。
这就很清楚地回答了行业里每个人都在问的一个问题:为什么所有 LLM 都需要人类在回路中?
简单的回答是,我们就是把人类放进了回路里。这个回路的目标是优化人类偏好,不是让软件自主运行。这其实超级明显。
正因为如此,过度承诺是一个 feature,不是 bug。这是 by design 的。
有一项早期的 meta 研究表明,RLHF 模型在人类偏好和实际结果之间永远存在很大差距,即使结果本身不错。因为你优化的主要目标就是人类偏好。
我特别喜欢一个例子:有人给 ChatGPT 发了一段放屁音效的音频文件,问「你觉得我做的音乐怎么样,给个真实反馈」。ChatGPT 一本正经地回答说这是「一首非常诡异的氛围感作品」。
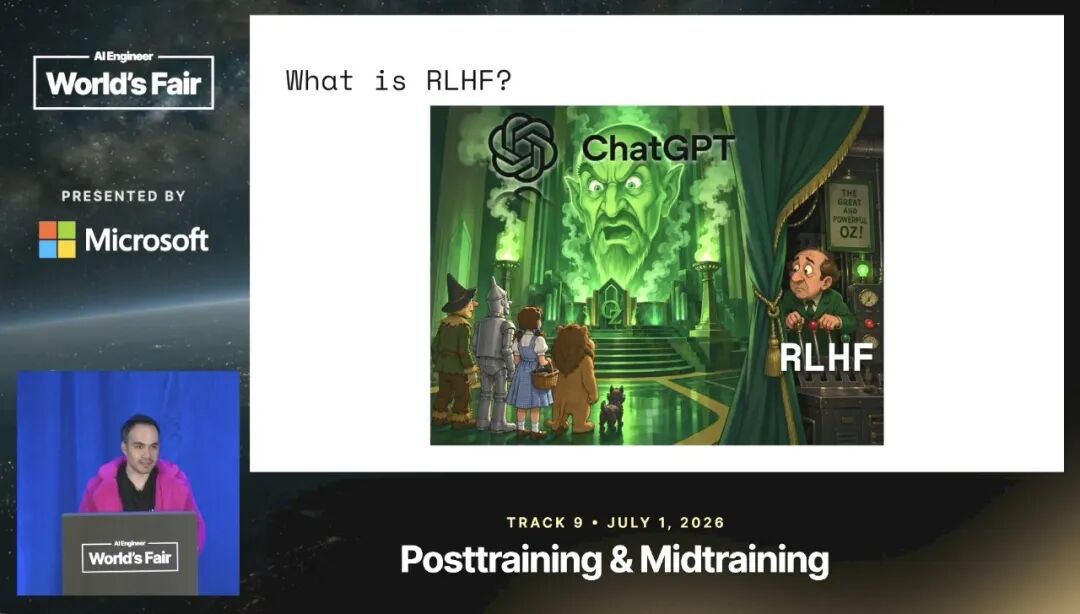
这就是 RLHF 的工作方式。当模型不确定时,它会选择讨好人类偏好。如果你是回路中的用户,这很合理,因为所有 RLHF 模型的终局都是优化 engagement。但如果你想要的是 automation,你真正需要的是让它完全不在乎人类,以校准的方式正确执行任务。
第二课:今天的 AI 被设计来做 assistance,通过优化人类偏好。这就写在名字里,不是什么有争议的观点。
有争议的是后果:无论模型有多错,它都会看起来是对的。 因为 RLHF 奖励模型中存在不对称性。这也是行业困局的根源,因为大家真的很想让 automation 发生。
05 Claude Code 为什么不是下一个时代
回到最开始的问题:RLHF 之后是什么?真正的问题应该是,AI 的 assistance 时代之后是什么。
回到开头的提示,为什么不是 Claude Code?因为 Claude Code 仍然是 assistance 时代的一部分,Claude Code 仍然是 RLHF 的。 如果它是纯 RLVR 的,看起来会非常不同。
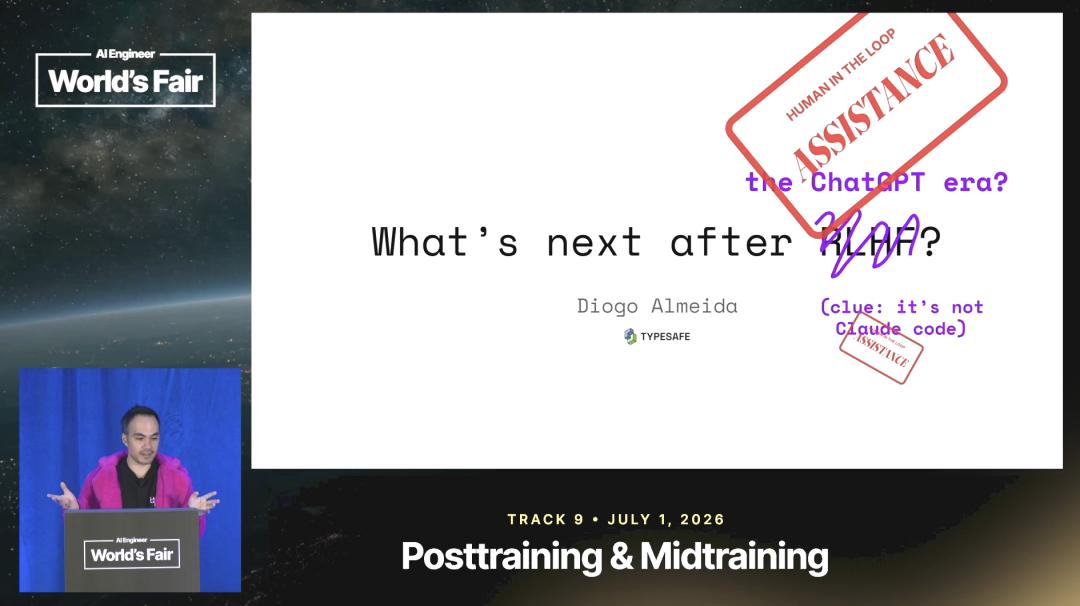
这就是为什么你会遇到这种困境:模型在 agentic 方面变得非常强,但它会偏离你真正想要的东西。RLHF 和 RLVR 这两个优化方向一直在来回拉扯,但两者都不触及 automation 的核心。
所以,assistance 之后的逻辑答案是什么?真正的 automation。
06 我们要「更聪明的软件」
我是一个热爱软件的人,我相信在座各位也是。软件超级有价值,看看所有的 SaaS 公司就知道了。但最疯狂的一点是,所有的 SaaS 自 2019 年以来基本没变过。
在 LLM 时代,SaaS 唯一的变化就是有时候会贴一个聊天机器人上去。
如果你想到 AI 取得了多大进步,这很荒谬。但如果你想到 AI 本质上是 assistance-native 的,这完全可以预测。AI 是为 assistance 设计的,那你能在 SaaS 里做什么?加一个助手呗。
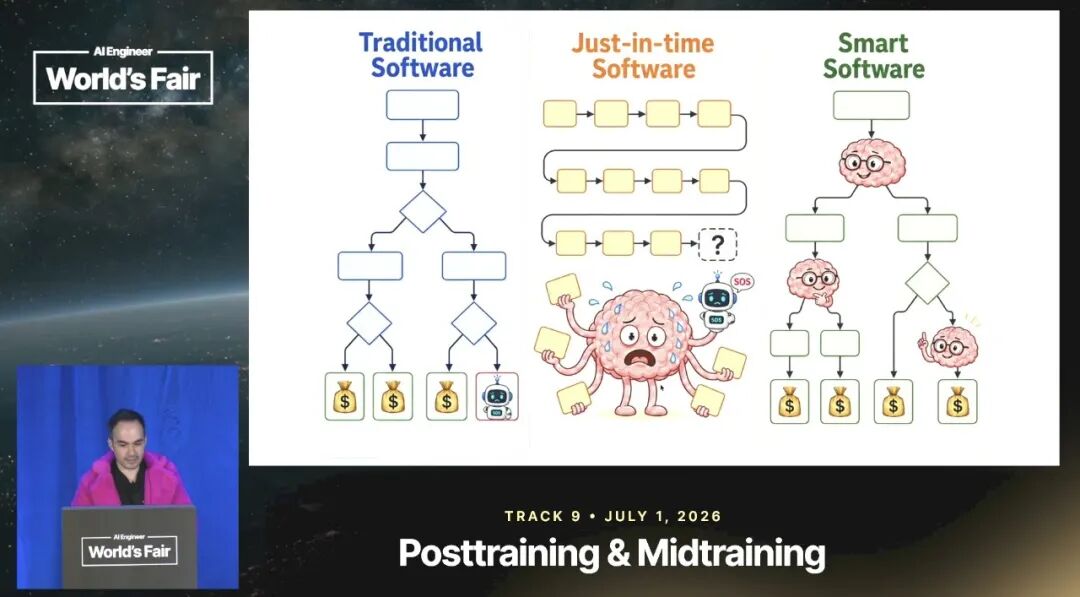
这不是早期 AI 先驱们预期会发生的事。看看 OpenAI 早期章程的措辞,说的是要做「大量的工作」,而不是赚钱什么的。我们曾经以为软件会变得更聪明,而不只是写起来更便宜。
Garry Tan 说过「我们正在进入 just-in-time software 的黄金时代」,我觉得他是当作赞美说的。但我认为这是一把双刃剑。我不只是想要 just-in-time software,虽然那确实很酷。我想要的是更聪明的软件。 为什么 B2B 软件的基本构建块还跟以前一样?
每次你想到 automation,不是说要自动化一个人的全部工作。而是说,有一些极其机械的工作,简单到你可以告诉别人该怎么做,理想情况下可以几乎免费地反复执行。这些本该由计算机来做。但现在并没有发生。我们只是在自动化「写软件」这件事,但软件本身的表达力并没有变。 在我看来这是这个世界的悲剧。
07 下一个时代和 TypeSafe 在做什么
第三课:我坚信,整个行业终将把 RLHF 时代视为一段奇怪的弯路,一段我们没有预料到的弯路。 未来的 AI 将服务于 automation。我们终将拥有更聪明的软件,真正的工作会被自动化掉。而现在,尽管 LLM 很聪明,真正被自动化的工作还只是一个四舍五入的零。
这就是我们在 TypeSafe 做的事情。我们的核心问题是:如果 AI 技术栈从头为可靠性和 automation 而设计,一切会怎么变?
我们很快就会发布。如果你有兴趣第一批构建真正智能的软件,请关注我们的邮件列表或招聘页面。我也在试着运营一个 Twitter 账号,会发一些很辣的观点。
给你们一个预告:原始的 Scaling Law 是错的。
08 现场 Q&A 精选
Q:如果在预训练阶段加入分类器头会怎样?类似 Yoshua Bengio 建议的那样。
A:我其实不认为预训练是问题所在。预训练是了不起的成就——把互联网的知识压缩成一个智能的核心,然后被利用起来。预训练模型确实极其聪明。我认为问题在于我们如何挖掘这些智能。
幻觉在我看来是优化人类偏好的固有产物。奖励模型中存在一种类似 GAN 的不对称性,它鼓励模型丢弃模式、表现得很自信,因为奖励模型很容易发现模型不自信并惩罚它。这个话题很复杂,但简单说就是这样。
Q:你们做的是 RLVR 吗?
A:绝对不是 RLVR。这是一种全新的东西。LLM 后训练的每一个分支都有自己优化的北极星。RLHF 优化的是人类偏好,RLVR 优化的是纯正确性的对数错误率,而我们在做第三件事:优化校准的决策能力,把预训练模型的智能直接灌注到真正有用的软件中。 甚至 API 的形态都不同,我们是从头设计的。就像在我们做指令遵循之前没人想过这件事一样,真正新的后训练范式刚出现时看起来完全陌生,事后看又极其显而易见。
Q:你对 Sutton 的 Bitter Lesson 怎么看?
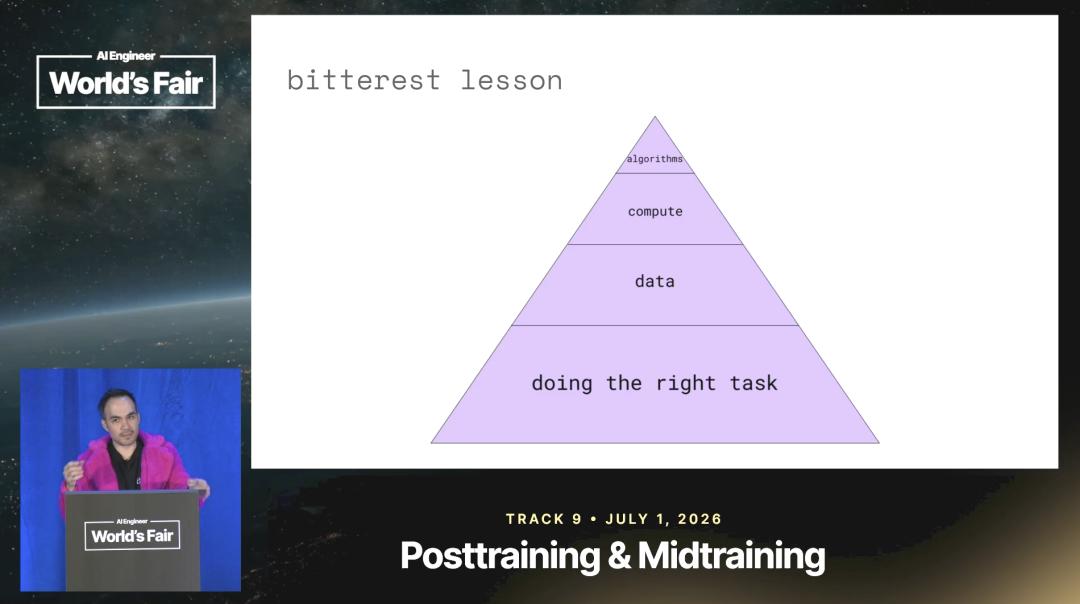
A:Bitter Lesson 说的是算法比计算更重要,这在游戏里成立,但在现实中不成立。我认为完整的层次是:数据比算力重要,做对的任务比数据重要得多。
本文来自微信公众号“极客公园”(ID:geekpark),作者:Techno 之王,编辑:靖宇,36氪经授权发布。



