Meta于9月8日发布Muse。每个Muse运行在一台专属虚拟机Muse Secure VM上,这台VM同时存放agent和用户数据;耗时较长的任务在用户关掉App后仍会继续执行,遇到变化或需要审批时再回来找用户。产品迅速走红,一度登顶美国移动端下载榜。
关于Muse产品端的情况,以及对Meta的逻辑影响,可以查看海豚君的点评《Muse 爆了,Meta 的真拐点还是假高潮?》,下面我们来谈谈这给上游产业链带来的变化。
Muse的火爆,不仅给$Meta.US 自身带来两位数上涨,还给CPU产业链条上的各家公司带来大涨的表现。那么,Meta的Muse会是CPU版的ChatGPT时刻吗?
Muse对CPU的带动
不同于传统的聊天机器人,Muse是一个“给你配一台24小时专属电脑+一个AI管家”的订阅服务。
举个例子来看,如果你想“监控Mac Mini的价格”:
①传统的聊天机器人方式:“帮我监控Mac mini价格”→ GPU推理 → 回答“好的”→结束→CPU 闲置→第二天你问同样的问题,一切重来;
②Muse:“帮我监控Mac mini价格”→GPU推理 →CPU设置监控脚本→VM持续运行→你关掉APP→VM还在云端跑→每天检查一次price API→每月检查30次,每次触发:GPU推理判断+CPU工具执行→30天后,价格降到$899——CPU的监控脚本检测到→唤醒GPU做下单决策→CPU操控浏览器填地址、填信用卡、点下单。
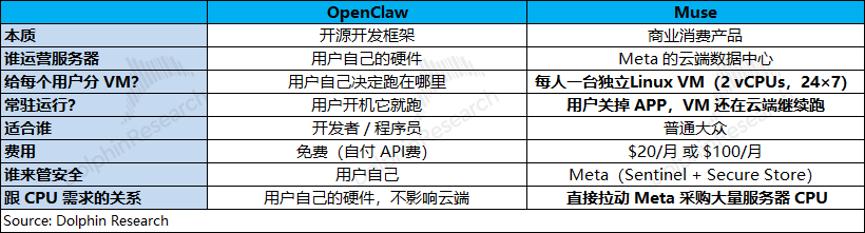
对比来看,传统的聊天机器人用完就走,之后就闲置了;而Muse的模式后续还会持续运行。这听起来是不是有点像之前的OpenClaw?确实Muse是受OpenClaw的启发,但两者还是不同的。
其中最大的区别就在于,Muse给每个用户配备了一台独立的虚拟机(Linux VM,2 vCPUs),而OpenClaw默认在本地运行。这样的好处在于即使用户关闭APP后,Muse仍会在云端继续跑,持续为你工作。
CPU在Agent中的重要性
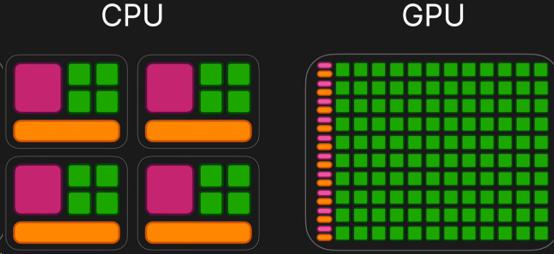
将CPU与GPU放在一起对比,可以发现,两类产品的结构有着明显的差别。
GPU把晶体管几乎全砸在算术单元上(下图绿色单元);而CPU把大部分晶体管花在不直接算术的东西上,重在管理控制(下图红色单元):分支预测器、乱序执行窗口、预取器、多级缓存等。
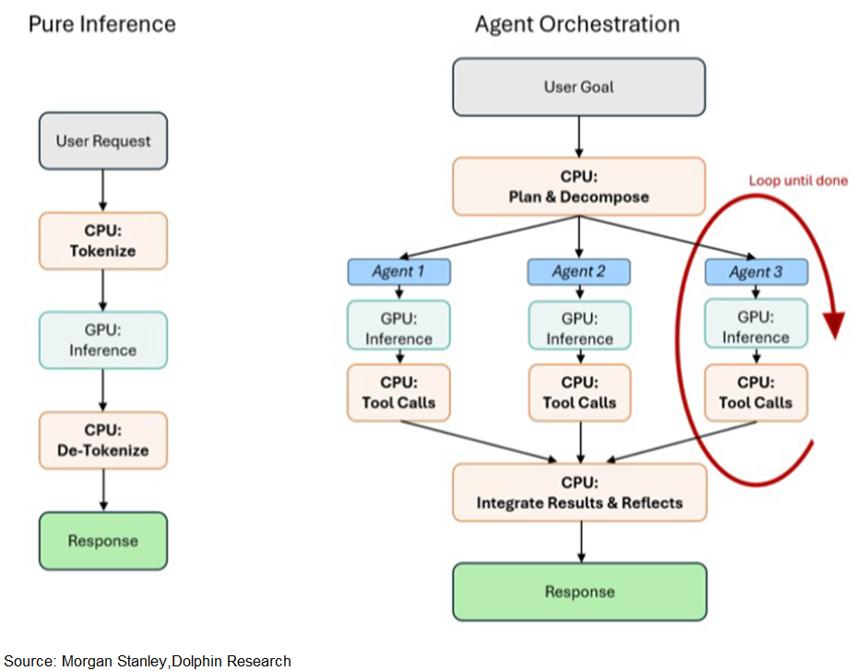
如果将Agent的工作流拆解出来,大致是:Agent=感知→规划→推理→工具执行→验证→再规划→再执行。其中GPU只能负责“推理”这一小段,其他的规划、执行、验证,都是必须由CPU(管理控制能力)来跑。
在纯推理场景中:CPU的作用仅限于对请求进行分词处理、将其传递给GPU,以及将结果重新组合。繁重的计算任务由GPU承担。
在Agent AI场景中:CPU则充当了指令层。它负责规划任务、将目标分解为子任务、调度并行运行的子智能体、管理工具调用和API请求、监控令牌流、整合结果,并运行反思循环,这里持续占用的主要是Agent CPU。
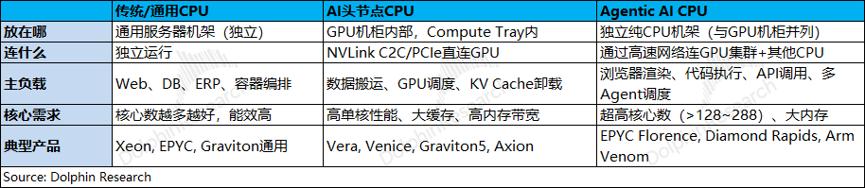
随着Agent AI的出现,数据中心CPU主要可以分为三大类:传统CPU、AI头节点CPU和Agentic AI CPU:
a)传统/通用CPU:是跑“传统非AI工作负载”的CPU——Web服务器、应用服务器、数据库、缓存、存储、消息队列。
主要工作就是处理网站服务、数据库管理、企业任务,特点是逻辑复杂但对并行计算要求不高,主要是串行。与AI GPU服务器是完全分立的,不依赖 GPU,独立部署在传统机架。
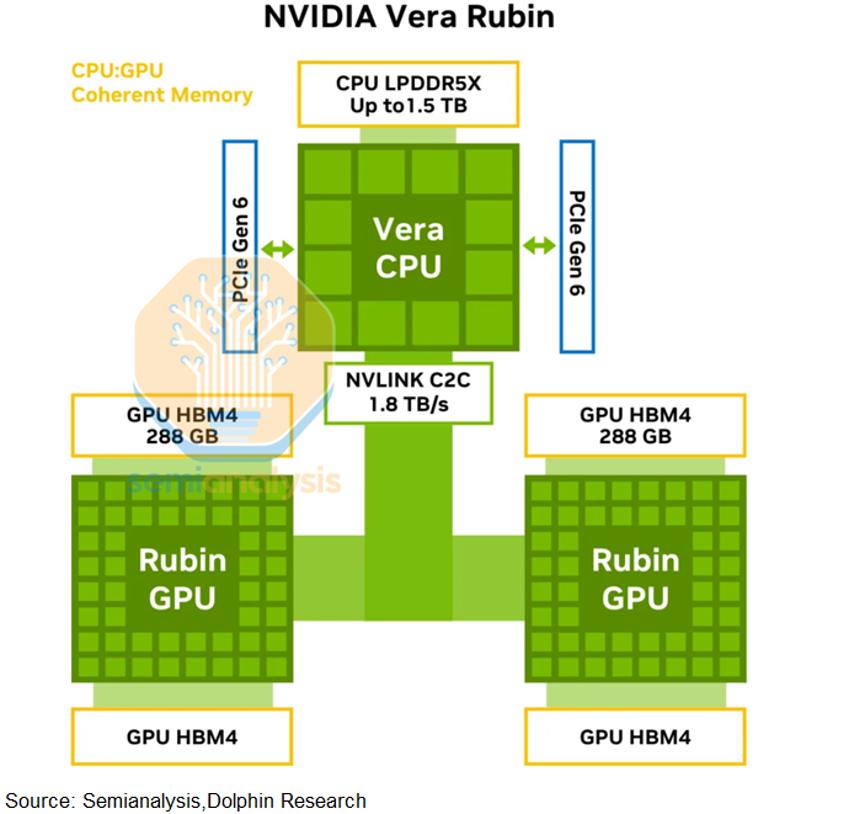
b)AI头节点CPU:“镶在GPU服务器里的管理GPU等设备的CPU”——负责给GPU喂数据、协调通信、管理内存、跑GPU做不了的非加速部分。
主要工作是管理连接的GPU,并持续为其提供数据。为了尽可能降低尾部延迟,需要具备大容量缓存、高带宽内存和IO的高性能单核。AI头节点CPU与GPU物理绑定在同一台服务器里。不存在独立的头节点CPU机架——它是GPU服务器的“管家”。
c)Agentic AI CPU:Agent的大脑和双手——专门跑AI Agent编排、工具执行、安全沙箱、RAG检索的独立CPU机架。
主要工作是AI智能体的自主决策规划任务。工具调用以及穿插在调用之间的逻辑推理,对GPU利用率不高,主要由CPU来完成。
与AI GPU服务器是分立的但紧密配合——Agent CPU机架与GPU机架通过高速网络(Spectrum-X/以太网)互连,形成完整的AI工厂。Agent CPU不绑定在 GPU 服务器内部,它是一个独立的机架品类。
Agent AI带来的增量需求
传统CPU的需求,主要来自于通用服务器的更新换代,而对数据中心CPU而言,进入Agent AI阶段的主要增量需求是来自于AI头节点CPU和Agentic AI CPU。
AI头节点CPU
即便在原来的LLM模型中,头节点CPU对于GPU本身就是必需品,CPU必须以极高速度为GPU提供数据(喂数据)的同时,处理通信、同步和应用程序的非加速部分,涉及权重加载、配置GPU的工作模式、管理KV Cache、数据校验等工作。
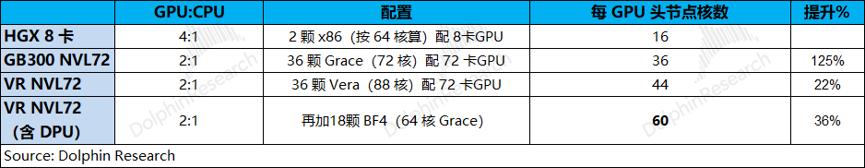
如果没有配置足够的AI头节点CPU,会一定程度上影响GPU的效率,具体来看:头节点CPU带宽不够→GPU卡在等待数据→利用率下降。正因如此,从传统HGX的4:1 到NVL72的2:1,因为加速器越来越复杂,就需要更多的CPU来管理和喂数据。
海豚君认为这部分的配比本身就在提升,主要是为了“投入CPU来榨干GPU的每一分钱”,是纯粹的经济性驱动,并不是Muse的Agentic AI直接带来的拉动。
Agentic AI CPU
Agent本质上是CPU工作负载,因为它们严重依赖顺序任务执行,而非纯并行处理,这是GPU做不了的事。在Agentic AI阶段,Agent CPU是“不得不用”的,这也是Muse模式带来的纯增量。
ARM曾给出一张AI agent的工作流线路图:
①用户→AI agent:提出一个目标,不是一个问题;
②AI agent→Cloud:agent的本体跑在云端的CPU上。这一层没有加速器,纯CPU。
③Cloud→Agents:一个agent把任务拆成多个子agent,图上是12个。这一步是整张图的需求乘数。
④Agents ⇅ AI data center(循环):注意这里画的是双向箭头,而且每个agent各有一对。这是“想-做-看”循环的图示——不是一次调用,是反复往返。
⑤AI数据中心内部:编排CPU(Agentic CPU,新增需求)接收请求、管理状态、调度;把需要推理的部分喂给加速器;加速器吐出token;再回到CPU判断下一步。
最后Agents→Cloud→Answer→用户:结果汇总回云端,生成一个"Answer",返回给用户。
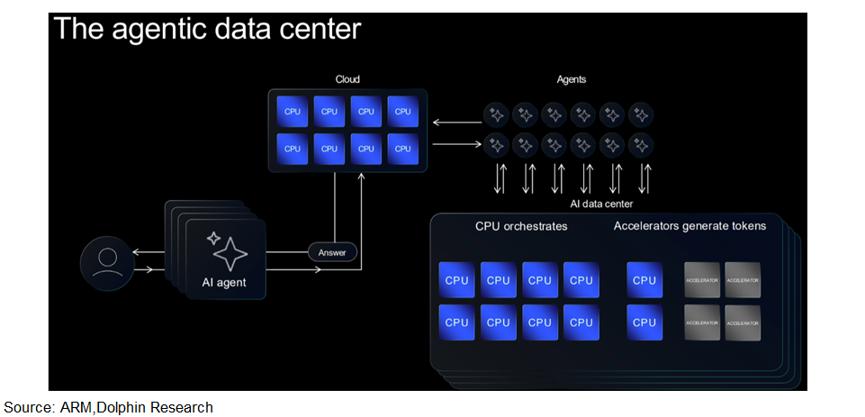
值得注意的是,这里提到的编排CPU(orchestrates)是指agent主循环的编排,包括拆任务、生成子 agent、持有状态、决定何时反思、何时分支、何时重试、分发工具调用,而不是推理服务中对GPU计算任务等的编排(这是靠近GPU的头节点CPU的工作职能)。
进入Agent AI,数据中心内会新增大量独立CPU机架来专门做 Agentic 编排、调度和管理。为应对这部分需求,英伟达之前发布了独立的Vera CPU机架,其中有256颗Vera CPU芯片,每颗88核心,这才是Agentic AI的真正增量。
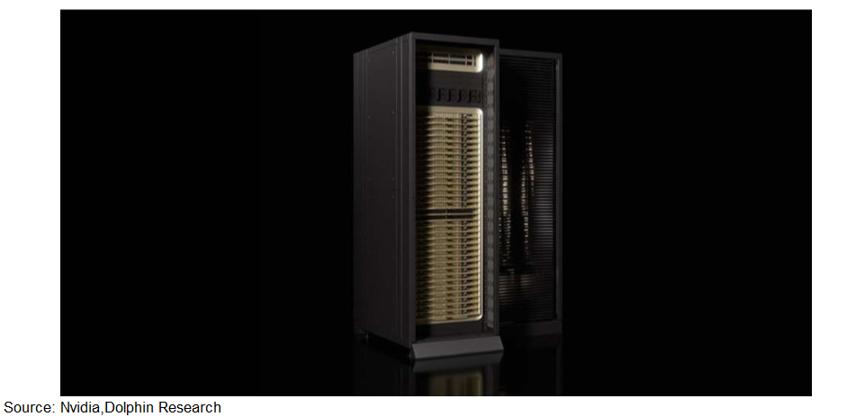
参考英伟达此前提出的AI工厂,Vera CPU在Vera Rubin NVL72(AI头节点)、Vera CPU Rack(独立 CPU 机架)之外,还会在Vera BlueField存储之中,负责存储管理、DPU、KV Cache持久化。
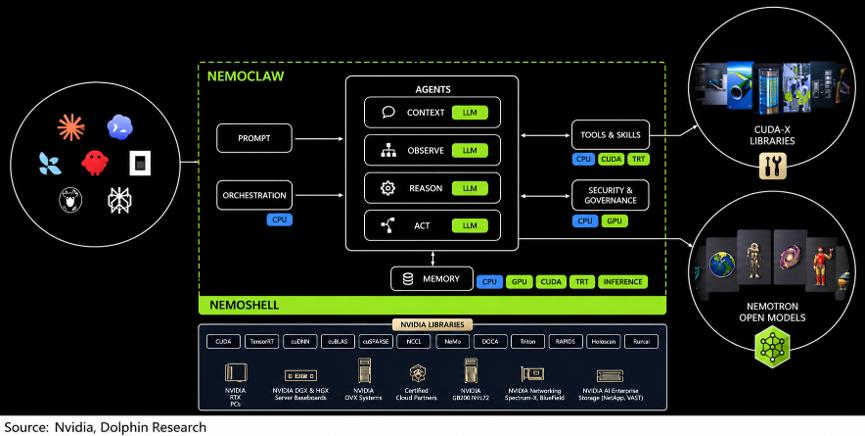
不同于NVL72内的BF-4 DPU(Grace CPU),英伟达STX存储机架的BF-4 DPU采用了Vera CPU。
在STX存储机架参考设计中,BF-4包含⼀颗Vera CPU、两个CX-9 NIC和两个SOCAMM模块。对于整个STX机架,它共有 16 个机箱(每个STX机箱包含两个BF-4单元),这意味着1个机架对应32颗 Vera CPU、64个CX-9NIC和64个SOCAMM。
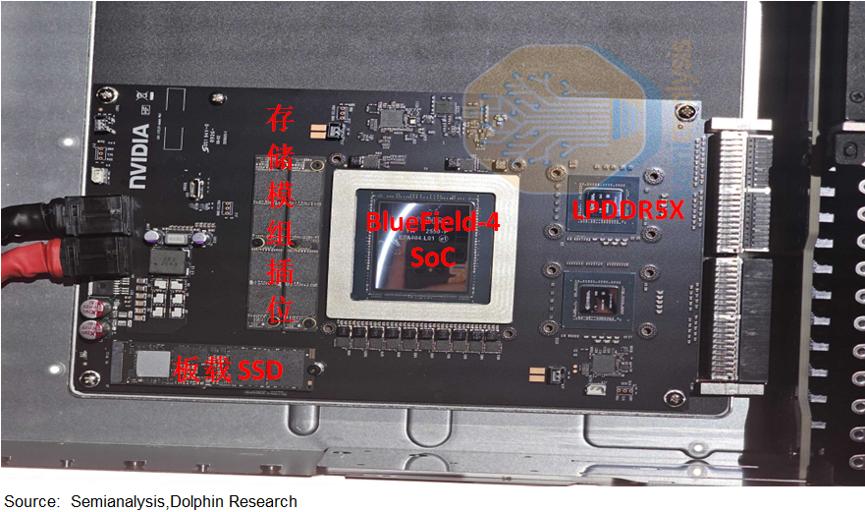
至于BF-4(DPU)实际上是有两类CPU芯片,一颗是在NVL72计算托盘内(Grace),还有一颗是在STX存储机架内(Vera)。
因而BF-4 (DPU)在AI头节点/Agentic CPU的归属,要看这个芯片主要为GPU集群服务,还是为Agent工作负载服务(持久化Agent状态、KV Cache、长上下文存储),更倾向于STX是Agentic的一类。
CPU的“ChatGPT时刻”?
经常会有人把CPU、核数和线程等概念搞混,我们先来理解这几个概念:
如果把CPU比作一个工厂,那么1个核心就是其中的1个工人,一个核心只能处理一项指令。1个处理器如果有更多的核心数,那就相当于在同样的时间内可以处理更多的指令(事情),比如英伟达Vera CPU(88核)。
至于线程,就好比是工厂中的传输带。如果A工厂有8核8线程,相当于每个工人有一条对应的传输带; B工厂有8核16线程,相当于每个工人有两条传输带;而C工厂是16核16线程。
在三家工厂中,C工厂的处理速度是最快的(核数最多)。至于A和B相比,B的处理速度会相对较快。在工人人数(核数)一样的情况下,线程的增多可以减少传输期间的时间空档,从而确保核心(工人)一直在工作状态。
这样来看,核数(工人)和线程(传输带)的增加,都是CPU性能提升的表现。
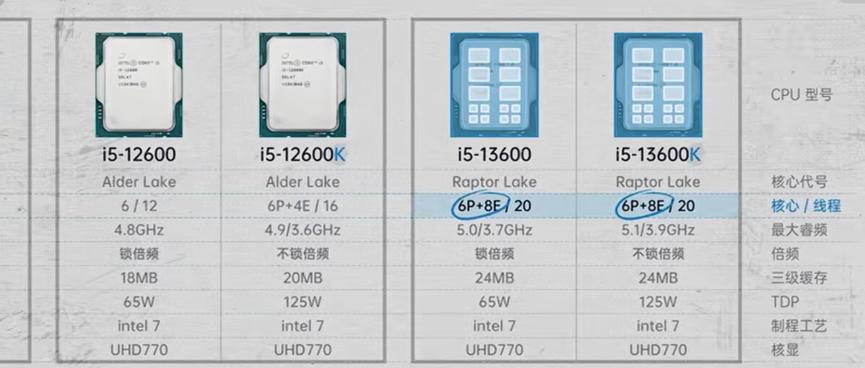
结合上文拆分的三类CPU来看,传统CPU、AI头节点和Agentic CPU的需求是完全不同的:
a)传统CPU:跟着企业IT和云的请求量走,新增的部分主要来自于agent访问的第三方网站和服务。整体CPU颗数相对平稳,但是核数会受产品迭代的带动,Agent影响不大;
b)AI头节点:主要受GPU数量和机柜配比的影响,与AI加速器(GPU/ASIC)数量成正比。在近年内每GPU的AI头节点核数涨了约3.75倍。但拆开看,这个增量主要来自于CPU:GPU配比提升(翻倍)、单CPU的核数增加(22%)以及NVL72内的DPU新增(36%)。
对于AI头节点,单GPU的核数涨幅因素已经考虑进去了,还未看到下一代再度大幅提升的迹象。Agentic AI对头节点 CPU的带动影响不大。
c)Agentic CPU:这是Agent带来最大的增量机会点。这一类的颗数不是由 GPU 决定,受并发agent数的影响。
对于Agent需求,英伟达推出了单个Vera CPU机架,其中有256颗Vera CPU(单颗88核,单核两线程),单机架总计22,528核, 符合官方称可支撑超过22,500个沙箱 (独立单间,防止污染 ) 。
注: Muse给每个用户发的虚拟机2 vCPU。其中2vCPU(虚拟CPU)=1个物理核的两个SMT线程。SMT线程共享执行单元,2 vCPU 的实际吞吐不是1vCPU的两倍,大约是1.2到1.3倍。
具体来看,Agentic CPU的需求可以分为固定层和弹性层两部分:①固定层主要是1个用户一个已经提前分好,就像是Muse发的2vCPU,对应着固定沙箱;②弹性层是负责执行拆分出来的子agent,持续复用的临时沙箱。不论是用户,还是子agent都是在独立隔离的环境中。
由此可见,Agent=模型(GPU侧)+固定沙箱(用户侧拆解Agent)+临时沙箱(处理子Agent)。大致过程就是,用户发出指令,用户侧固定层的CPU拆解Agent,接着交给临时沙箱处理子Agent,推理运算由GPU侧来完成。
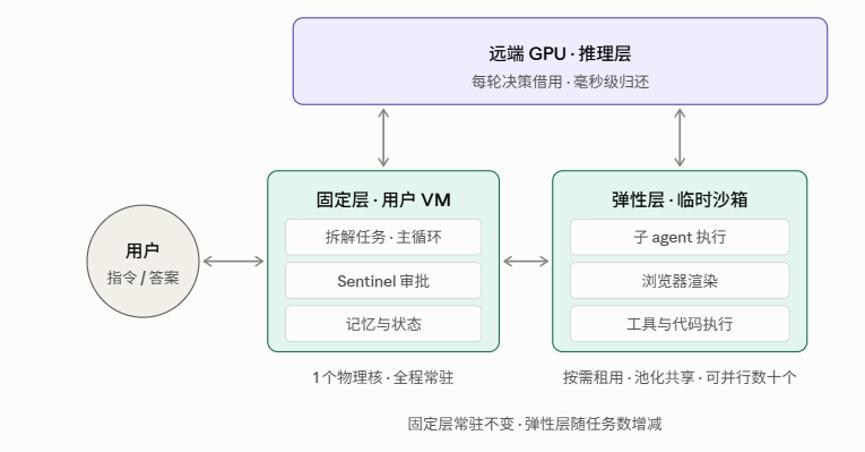
不论是固定层(用户侧)、还是弹性层(子Agent)都需要安全隔离(沙箱)。CPU的隔离能力来自于指令集和硬件结构本身。CPU从诞生起就在解决一个问题:让多个互不信任的程序共用一台机器。几十年积累下来,CPU硬件里有一整套专门的电路,来实现沙箱的功能。
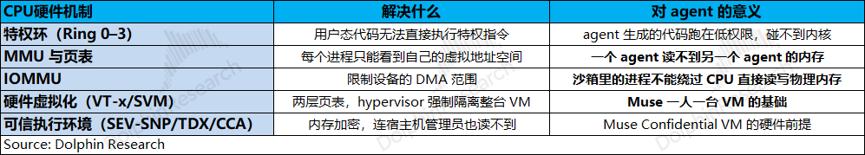
综合此前测算,单个VR NVL72(含DPU)的CPU核数有4320个(=72个GPUx单GPU的核数60), 而这里的单个CPU机架的CPU核数将达到22,528个(256个Vera CPU×88核),单个CPU机架的CPU核数是VR NVL72的5倍。
CPU核数的增长机会在哪?
ARM曾给出展望:传统AI数据中心每吉瓦(GW)算力大约需要3000万颗CPU核心,进入Agentic AI时代,这个数字将飙升至1.2亿颗。
对于CPU的需求,市场上有很多不同的说法。既有GPU:CPU,还有单个GPU对应CPU核数,还有单GW的核数需求。其实海豚君认为GPU:CPU主要是头节点的环节,对Agentic阶段意义不大。单GPU对应的CPU核数在CPU机架引入后必然是大幅提升的,因而单GW的CPU核数需求相对更有意义。
①传统AI数据中心:以GB300 NVL72为例,整机架功耗130kW左右。如果1GW全部用于GB300 NVL72,那么大约对应7692个NVL72机架。
单个GB300 NVL72约有2592个CPU核(72个GPUx单个GPU对应36个CPU核),那么1GW大约需要2000万颗CPU核心(低于ARM的3000万颗口径);
②Agentic AI数据中心:VR NVL72的整机架和CPU机架的功耗都提升至200kW左右,那么1GW大约对应5000个NVL72机架,接下来就是NVL72与CPU机架之间分配的情况。
目前的现状是纯GPU机架的方式,下述表格中的保守、中性、乐观等情形实际上都意味着CPU机架带来的纯增量。
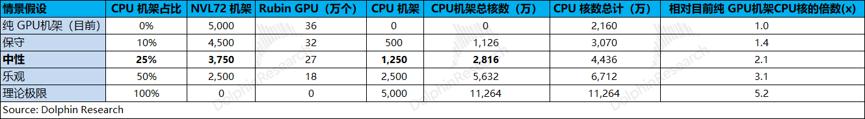
由此可见,在单一的1GW中,ARM展望中给出的1.2亿颗CPU核数高于上图中测算的理论上限1.13亿颗CPU核数。
海豚君合理估算,随着CPU机架的引入,更为合理的情况是对于数据中心所需要的核数的提升在2-3x左右。
英伟达CPU机架中是纯粹的CPU,并没有GPU。因而在Agentic AI阶段对CPU机架的引入,自然会大幅提升整个AI数据中心的单GPU对应的CPU核数(受CPU机架占比的影响)。在中性情况下(CPU机架占机架总数25%),可以测算单GPU对应的CPU核数有望从60个大幅提升至约160个,这才是CPU增量的直接体现。
Agentic AI能带来多少需求?
从上文可以看出来,其实AI数据中心本身就持续在建,其中对应的头节点需求是增加的(非增量信息)。而Muse的Agentic AI主要是在agent的需求下,要新增引入CPU机架,这也是Agentic CPU的主要需求来源。这和GPU无关,直接受agent用户情况的影响。
在这里引入一个公式:增量CPU需求= (A头节点) GPU 出货量×每GPU头节点CPU核数+ (B固定层) 总注册用户x日活率x(活跃时间/24)×每用户2vCPUx峰均比÷超售比÷ 2(单核两线程)+(C弹性层)活跃用户×任务并发率×每任务沙箱核数
在测算Agentic AI需求时候,主要关注于B固定层和C弹性层,需要理解的是:
①B固定层:还是针对于用户侧的,但需要注意的是Muse分配的2vCPU,并不会一直占用核心。a)当活跃时,用户被分配1个物理核心(2线程);b)而在空闲时,记入存储单元→VM暂停→物理核心释放给其他用户,等再次唤醒,会从存储中快速恢复。
Muse分配的2vCPU,实际上是保证你最多能用2个vCPU,但不用时不消耗物理核心。例如1台物理服务器(256核)可以分配几百甚至上千个vCPU,正是因为大部分VM同时处于空闲状态,这就是超售比的概念。
以1亿Muse为例,假定日活率30%,每天活跃3小时,峰均比2,超售比6,那么B固定层的CPU需求大约需要125万CPU核(=1亿x30%x3/24x2x2/6/2)。
②C弹性层:不需要承担所有用户,只需要处理活跃用户给出的任务。任务并发率指的是平均每个活跃用户同时在跑多少个沙箱(子agent),还要关注每个任务沙箱需要的核数。
依然在1亿Muse用户(日活30%)、每天活跃3小时、峰均比2的情况下,假定每个任务沙箱需要的CPU核数为4个,以并发率来做情景假设:其中峰值活跃达到750万(=1亿x30%x3/24x2)
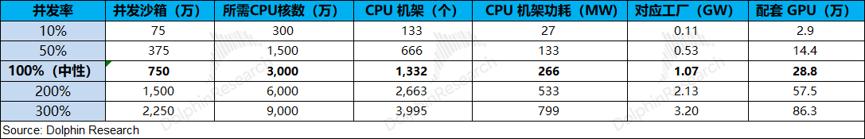
从中可以看出,在1亿Muse用户体量及以上假设的情况下,当并发率达到100%的情况下(即平均单个活跃用户同时在跑1个子Agent),大约需要1GW的配套工厂。在配置25%的CPU架构的模式下,大约需要1332个CPU机架, C弹性层对CPU核数的需求就将达到3000万个 。
在上述情况(中性)下,A部分GPU侧的CPU核数需求大致有1728万个(=28.8万个GPUx单个GPU对应60个CPU核数);B部分用户侧的CPU核数需求大致有125万个;C部分子Agent侧的CPU核数需求大致有3000万个。
将A+B+C三部分合起来的CPU核数需求将达到4853万个,是原来纯GPU机架方案的2.8倍左右(相比于1728万个)。考虑到英伟达存储机架(DPU)等部分的额外需求,海豚君预估Agentic CPU有望带动CPU核数需求有望提升至此前的3倍左右。
Agentic AI给CPU产业链带来的机会
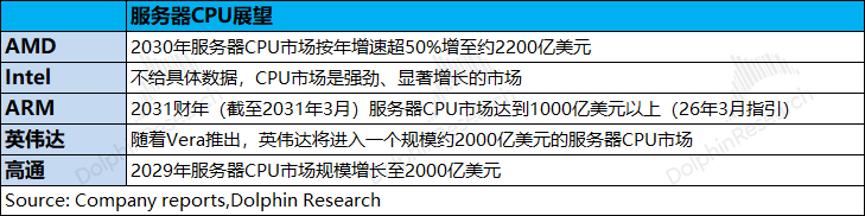
结合AMD此前给出的CPU展望,按年增超50%的增速至2030年服务器CPU市场规模有望增长至2200亿美元,可以倒推出2025年服务器CPU市场规模大约是290亿美元。
这里引入一个公式,“服务器CPU市场规模=CPU总核数x单个CPU核均价”。从上述测算中可以看出Agentic CPU有望将CPU核数需求提升至原来的3倍,另假设单个CPU核均价年增18%。
由于大部分CPU厂商的展望都给到了2030年,假定Agentic CPU模式将在2030年实现大规模落地(即2030年的CPU核数需求提升至3倍),以及在单个CPU核均价年增18%的情况下,至2030年CPU市场规模有望提升至2000亿美元(=290x3x1.18^5),复合增速接近50%。
上述对CPU市场规模的测算与各家厂商的展望基本相近,其中ARM管理层也承认此前给出的1000亿市场展望是偏于保守的,CPU市场规模至2030年将达到2000亿美元附近,已经基本上是CPU产业链的共识。
当前服务器CPU市场的主要厂商是英特尔和AMD, 结合两家公司2025年的相关收入情况来看,英特尔和AMD的市场份额分别为58%和35% ,其他的厂商合计不足1成。
由于CPU市场规模的增长主要来自于Agent CPU需求的推动,传统服务器CPU的增速相对较慢(主要来自于更新),海豚君预估英特尔的市场份额将继续回落,AMD、英伟达等厂商的份额有望实现回升,尤其是英伟达、ARM和高通三家都是直接的纯增量。
假定2030年服务器CPU市场中,英特尔和AMD的市场份额都在36%。英伟达、ARM和高通作为“新进入者”,有望获得15%、5%、2%的市场份额。
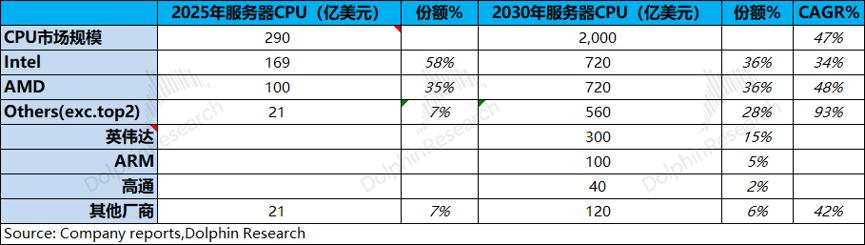
综合来看,Agentic AI有望为英特尔 和 AMD 的服务器CPU带来550亿和620亿美元年收入增量。 英伟达、ARM和高通能在Agent CPU中享受到300亿、100亿和40亿美元的年收入纯增量 。
基于上述情况,大致可以将英特尔和AMD服务器CPU在2030年的原有预期收入上调100-200亿美元,对应英特尔和AMD的2030年业绩预期大致提升10%左右。
虽然Agent CPU有望为英伟达带来的300亿美元收入,对于公司总收入占比不到3%,对英伟达的整体影响不大。
在纯增量之中,Agent CPU对ARM和高通的影响相对较大。如果两家公司在2030年分别获得5%和2%的市场份额,那么有望给两家公司分别带来100亿和40亿美元收入。假定Agent CPU业务的OPM为25%,大约能给ARM和高通分别带来25亿和10亿美元的2030年经营利润增厚。
整体来看,Agentic AI需要引入CPU机架,会直接带来CPU核心需求的增加,有利于推动整个CPU产业链的持续景气。从结构化的角度来看,增量需求主要来自于Agent CPU和头节点CPU,传统服务器CPU需求平稳。
Agent对于CPU产业链各公司的带动,ARM>英特尔/AMD>高通>英伟达。从上周的涨幅来看,同样体现了这样的排序情况。Muse带动Agent CPU的需求基本上都已经在股价中反映,后续关注于Agent需求能否继续做大蛋糕(服务器CPU市场)以及哪家公司能抢占更大的额外份额。
本文来自微信公众号 “海豚投研”(ID:haituntouyan),作者:海豚君,36氪经授权发布。



