当然能。今天就和大家分享一下我自己总结的一条学习路径。
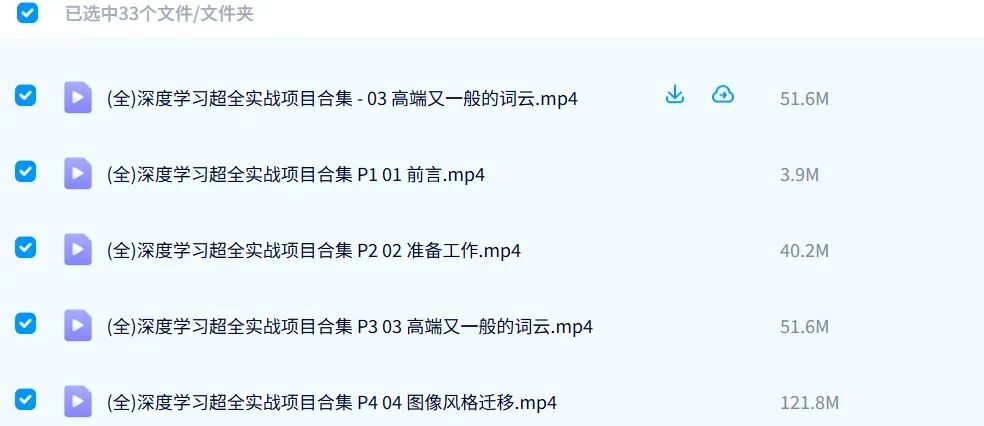
另外,我自己也整理了两份比较适合这类情况的资料:一套深度学习实战教程,项目部分有31节视频逐行讲代码;还有一套Google的深度学习调优资料,比较适合算力有限、想减少无效实验的人。需要可无偿获取,后面会结合具体场景讲。
1、刚开始学,GPU问题不用急
MLP、CNN、LeNet这类基础模型,对算力要求并不高,普通电脑CPU就能跑。这个阶段最重要的还是先把数据怎么进模型、Loss怎么算、怎么反向传播、参数怎么更新这些东西搞明白。
你甚至可以先用NumPy自己实现一个简单的网络,再逐渐过渡到PyTorch。而到了PyTorch,很多刚开始做深度学习的人,真正的问题就不是GPU,而是没有一套跑通代码的实践路径。
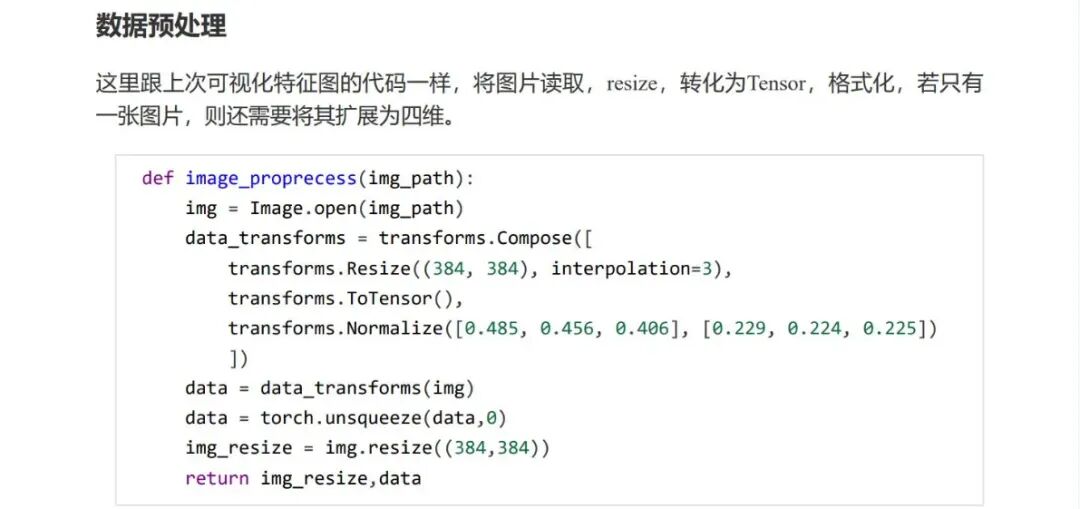
所以我自己整理了一套深度学习实战教程,里面有28个实践项目,项目部分还有31节视频逐行讲代码。可以挑自己感兴趣的跟着做,不需要一次全部学完。
2、真正做实验,不要什么都从零训练
现在很多任务都有成熟的预训练模型,可以直接拿来做迁移学习,或者使用LoRA、量化、梯度累积等方法降低训练成本。
核心思路很简单,能复用的就别重新训练,能小规模验证的就别直接跑完整实验。
尤其是刚开始做自己的Baseline时,先把数据和代码流程跑通,比直接追求完整训练更重要。
3、需要GPU的时候,再去用云端算力
如果确实需要GPU,我更建议租。本地负责写代码、处理数据、跑小规模实验;真正需要大量计算的时候,再把代码放到云端GPU上。
这样还有一个好处:不把GPU当成开发环境,而是当成计算资源。代码最好在本地就把Bug解决得差不多,确认流程没问题后再上GPU。
另外一定要学会保存Checkpoint和实验记录。云端机器不是自己的,随时可能需要换环境,能断点续训非常重要。
4、GPU越少,越要减少无效实验
这个才是没GPU之后最应该培养的能力。如果算力有限,更应该在实验前先想清楚:我要验证什么?为什么这样改?预期结果是什么?
先用小数据或者短训练做验证,确定方向以后,再把关键实验完整跑一遍。
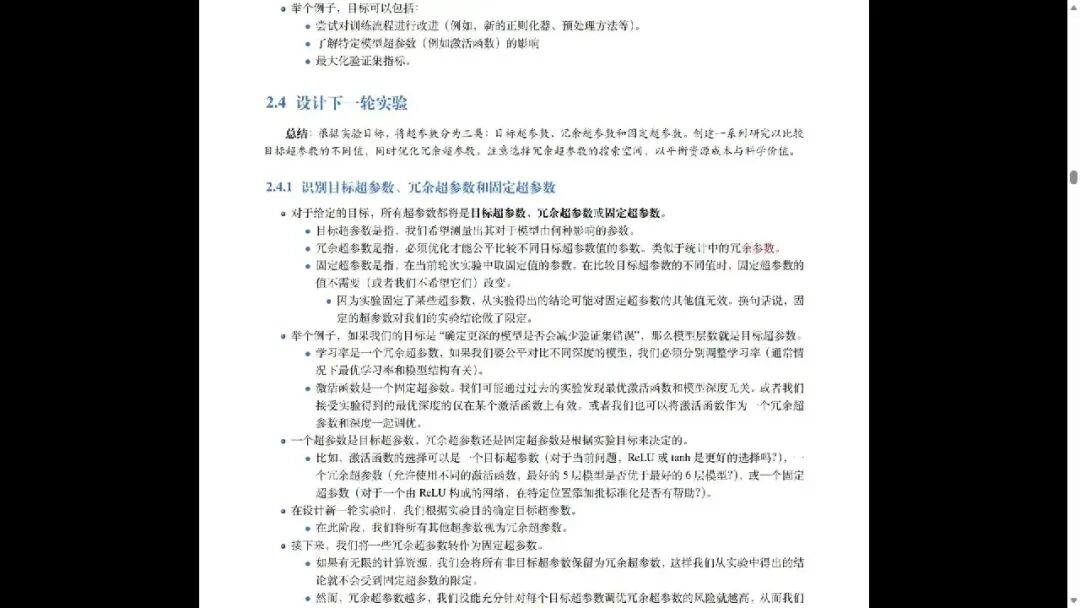
这里我比较推荐Google的深度学习调优教程。它从模型性能优化的角度,把模型架构、优化器、Batch Size、初始配置、训练步数、训练管道等值得关注的因素系统梳理了一遍。对GPU有限的人来说,先学会怎么减少无效实验更实际。
5、没GPU,也可以换个研究思路
最后,深度学习研究并不等于必须从零训练一个大模型。如果实验室长期没有GPU,可以优先考虑一些对算力要求相对可控的路线,比如迁移学习、参数高效微调、数据处理、模型评测、推理优化等。
具体怎么选,还要结合自己的任务、数据和研究目标。
所以没GPU不代表不能做深度学习,真正要做的是重新规划实验流程,把有限的资源用在最关键的验证上。



