文献、数据和初步想法都准备好了,小论文却迟迟没有成稿。
选题还没收紧,分析结果不知道放在哪一节,写到后面又发现前面的口径对不上。
用 GPT 推进论文,可以先根据已有材料确定问题,再沿着分析和写作持续往前做。
下面把这套过程安排成七天完成小论文初稿,每一轮都保存结果,下一轮接着使用。
| 00 研究主题与背景
假设我们要进行有关“信贷数据缺失如何影响信用风险预测”的研究,第一天先把已有文献和数据交给Codex,让它根据材料收紧选题。
本次使用含1000条记录的South German Credit公开数据。
下载包包含数据SouthGermanCredit.asc、编码表codetable.txt和读取示例read_SouthGermanCredit.R,将三份文件一起交给 GPT。
数据及编码说明的下载地址:
https://archive.ics.uci.edu/dataset/522/south+german+credit
内容摘要如下:
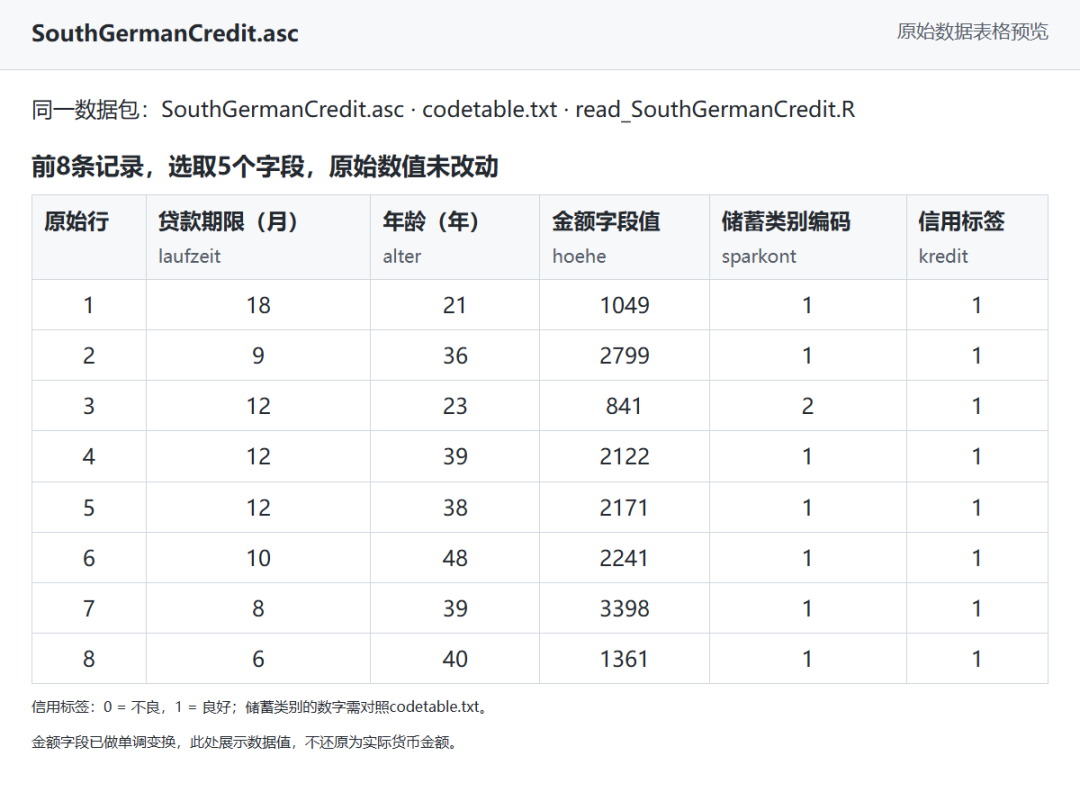
我们选取的参考文献是Maurino的《How Data Quality Affects Machine Learning Models for Credit Risk Assessment》和Yu的《Machine Learning Application in Online Leading Credit Risk Prediction》。
| 01 定主题
先让 GPT 整理研究约束,生成 研究约束.md,读者只需检查它是否准确概括手里的材料和目标。
提示词:
#请读取当前项目中的文献全文、原始数据及字段说明,整理本次研究的起点。#Maurino(2025)与Yu的论文全文、SouthGermanCredit.asc、codetable.txt、read_SouthGermanCredit.R。我们希望研究信贷数据缺失与信用风险预测,并在一周内完成小论文初稿。#生成00-研究约束.md;列出已有材料、能够研究的范围、缺少的资料及本周目标。#只依据当前材料整理,不提前选定最优方法或替我们编造研究发现。需要额外数据的方向明确标注。
输出结果如下:
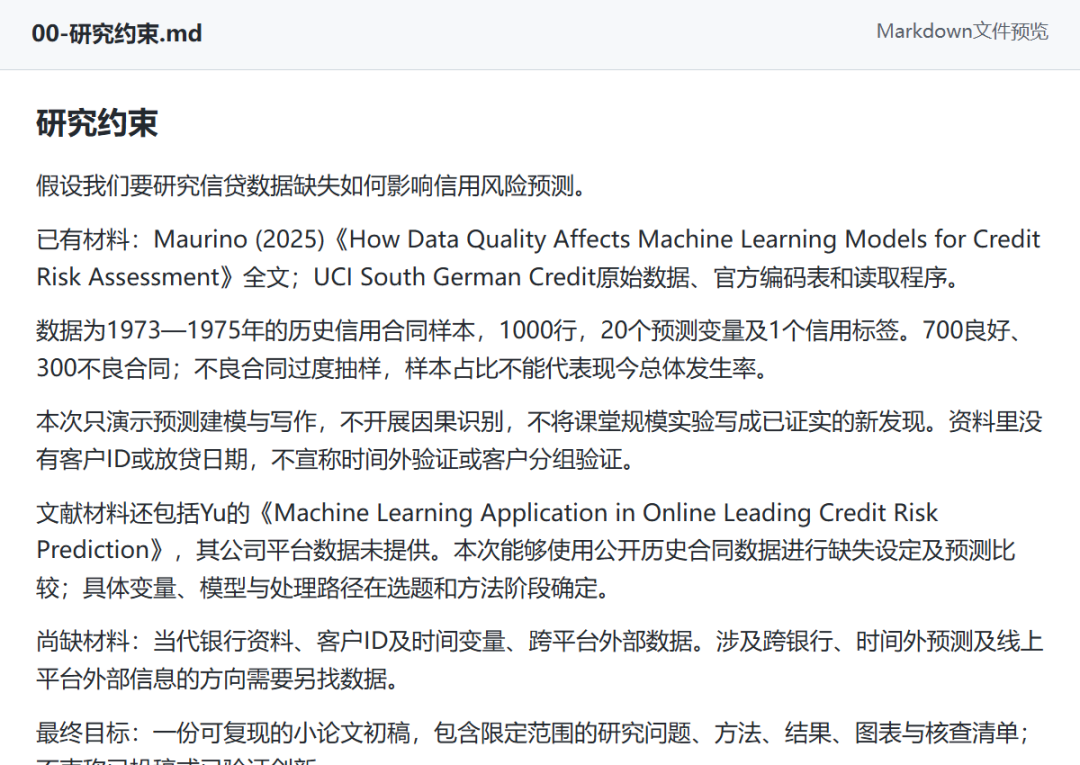
这份约束文件把公开数据能做的研究与尚缺材料的方向分开,后面的候选问题就有了筛选依据。
接着让 GPT 给出五个问题,并保存研究问题和文献证据表:
#假设我们要研究信贷数据缺失如何影响信用风险预测。请先给出5个可操作的研究问题,再推荐一个适合一周内完成初稿的问题。#00-研究约束.md、Maurino(2025)与Yu的论文全文、SouthGermanCredit.asc、codetable.txt、read_SouthGermanCredit.R。#生成01-研究问题.md; 01-文献证据表.md。每个候选说明数据要求、与已有研究的关系和可行性;推荐问题写清比较对象及目前能支持的结论范围。#文献空白只能依据已读材料判断;未检索全领域时不宣称首次发现。引用标注原文页码,不补造数据。
输出结果如下:
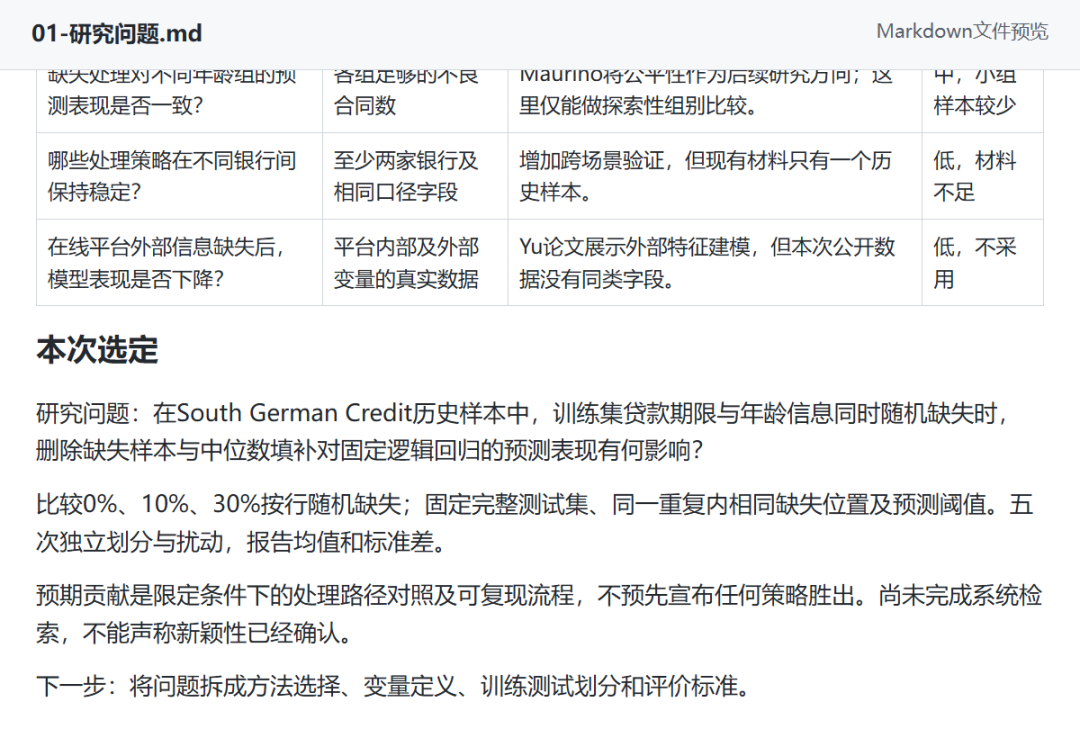
跨银行和线上平台的方向还缺数据,当前可以推进年龄与期限信息缺失后的处理方式比较,选题时就能判断后面是否跑得起来。
研究问题文件确定比较对象,另一份文献证据表记录已有研究与当前题目的关系:
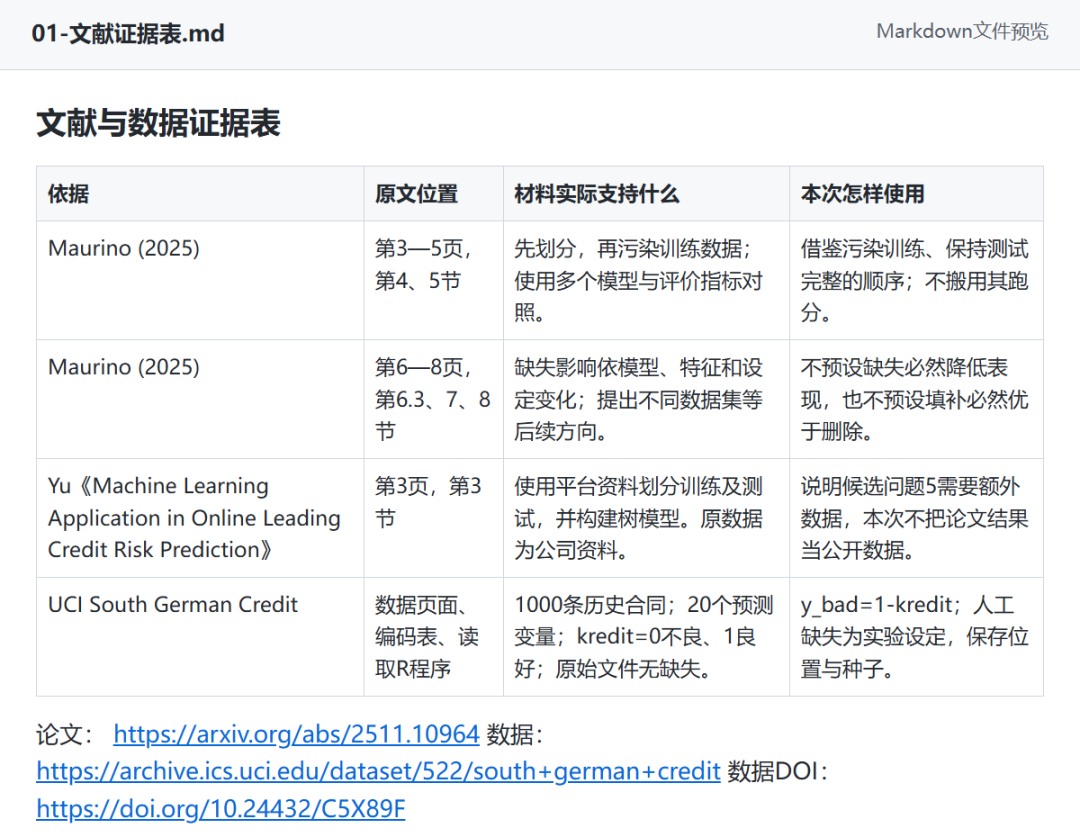
文献表把判断对应到原文位置,选择方法时可以回查依据,避免把模型提出的方向直接写成已经证实的文献空白。
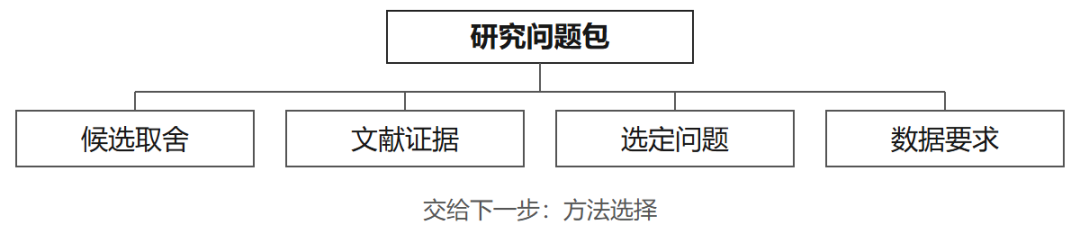
研究问题和文献证据表分别保存,第二天用它们确定方法。文献表负责记录已有研究做过什么,研究问题负责限定我们这次要比较什么。
如果相关文献还比较零散,可以在选题之后配合literature-review,围绕当前问题补充检索、按主题归纳研究并核对引用。
它属于Scientific Agent Skills 仓库,适合补足文献证据表,而不是替我们宣布题目已经具备创新性。
项目地址:
https://github.com/K-Dense-AI/scientific-agent-skills/tree/main/skills/literature-review
| 02 确定方法
第二天,研究问题已经收窄到“删除缺失样本还是填补缺失值”。
先让 GPT 比较三条方法路径,选定后再运行,避免一边分析一边改变问题。
提示词:
#请依据01-研究问题.md与01-文献证据表.md,比较3种方法路径,选出本次可执行的一条。#研究问题、文献证据表、数据及官方编码说明。#保存02-方法方案.md,说明比较条件、每轮输入输出、评价指标和需要先检查的前提。#不要用不同模型的差异冒充缺失处理差异。所有填补、标准化与编码参数只在对应训练集拟合,测试集保持完整;尚未运行的分析用计划时态。
输出结果如下:
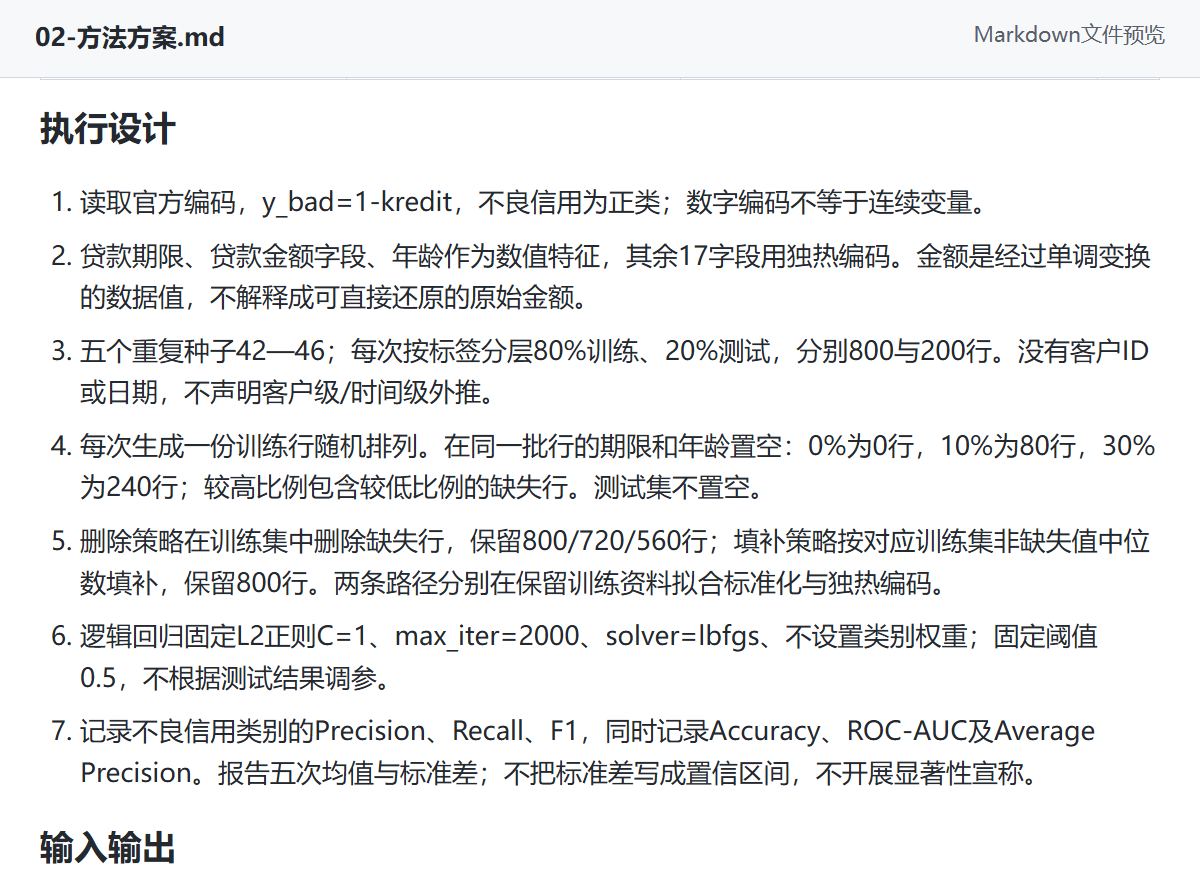
本次选择固定逻辑回归模型,只改变缺失处理方式。
这样结果出现差异时,比较对象清楚,不会同时混入更换模型的影响。
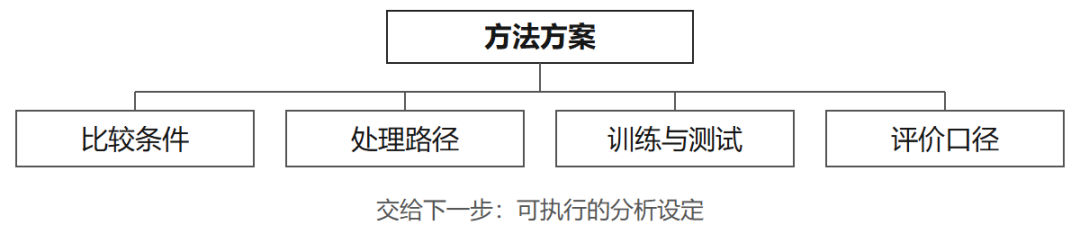
方法方案也把测试条件固定了下来:只在训练集制造缺失,测试集保持完整;填补和标准化参数从训练资料中计算。
把这份方案给导师或同门看时,可以集中核对这些前提,确认后交给下一步的数据处理。
| 03 数据处理
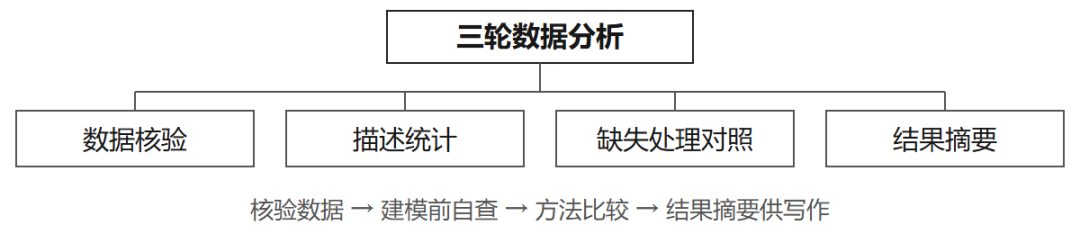
第三天的数据分析分三轮:先核验数据,再检查变量分布,最后按方法方案比较缺失处理。
#核对South German Credit原始数据的字段、标签方向、缺失和重复情况,生成可供后续分析使用的清洗数据。#SouthGermanCredit.asc、codetable.txt、read_SouthGermanCredit.R。#保存03-质量报告.md;03-清洗数据.csv,报告列出核验结果与原始记录抽查。#不改原始文件、不默删记录。标签映射须对照编码表;数据中没有的信息标为无法判断。
输出结果如下:
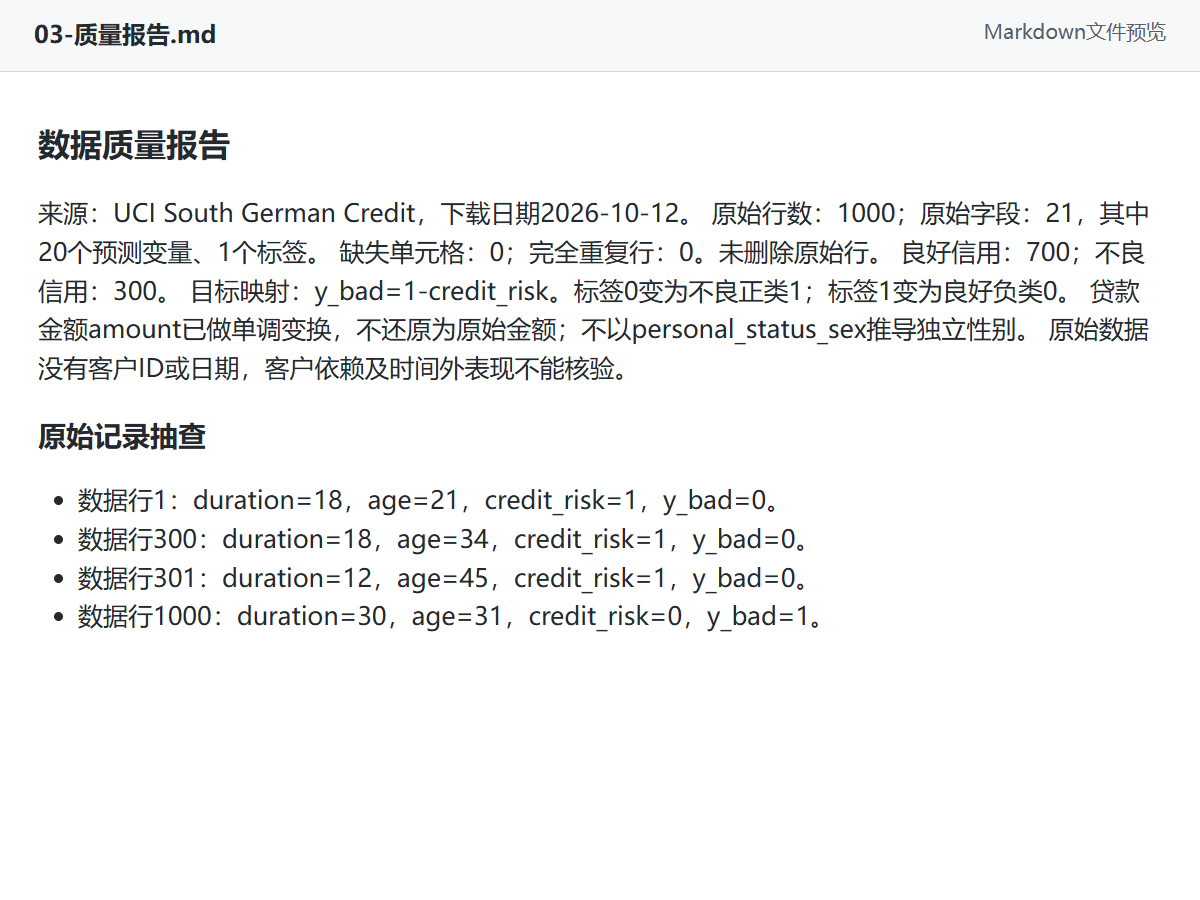
质量报告核对了标签、缺失和重复情况;原始数据无缺失,清洗数据留给下一轮使用。
提示词:
#基于核验后的数据计算描述统计。#03-清洗数据.csv。#保存03-描述统计.csv,列出贷款期限、金额字段和年龄的样本数、均值、标准差、四分位数与取值范围。#保留原始字段含义;金额字段经过变换,不解释为可还原的货币金额。
输出结果如下:
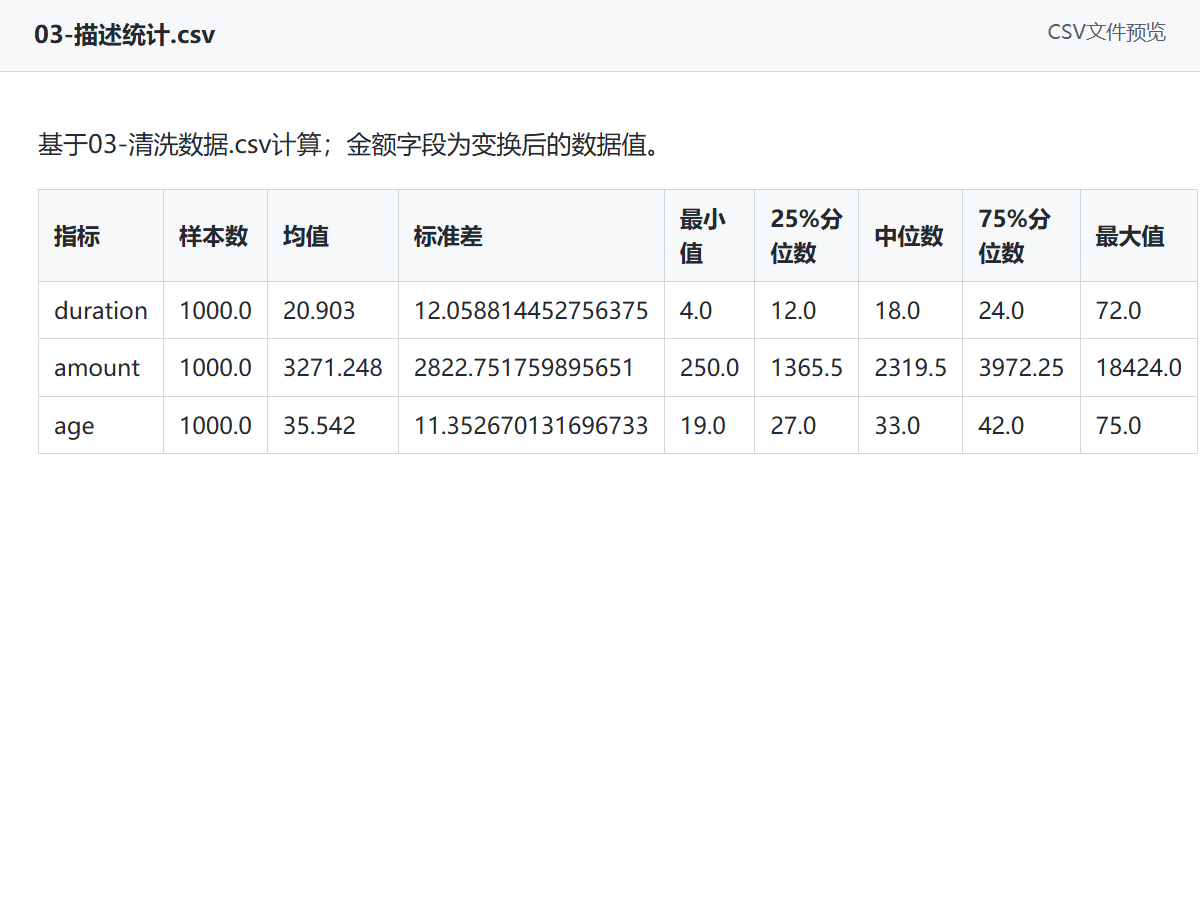
三项数值字段均有1000条记录,金额字段经过变换,统计表只用于建模前核对变量范围,不作为论文结果引用。
#按02-方法方案.md比较训练数据缺失处理方式。#02-方法方案.md、03-清洗数据.csv。#保存03-逐次结果.csv;03-结果汇总.csv;03-结果摘要.md;另保存03-分析脚本.py和复跑记录。#只在训练集期限和年龄中按方案加入随机缺失;同次比较共用缺失位置,测试集保持完整。只报告已计算结果,不补显著性或因果结论。
输出结果如下:
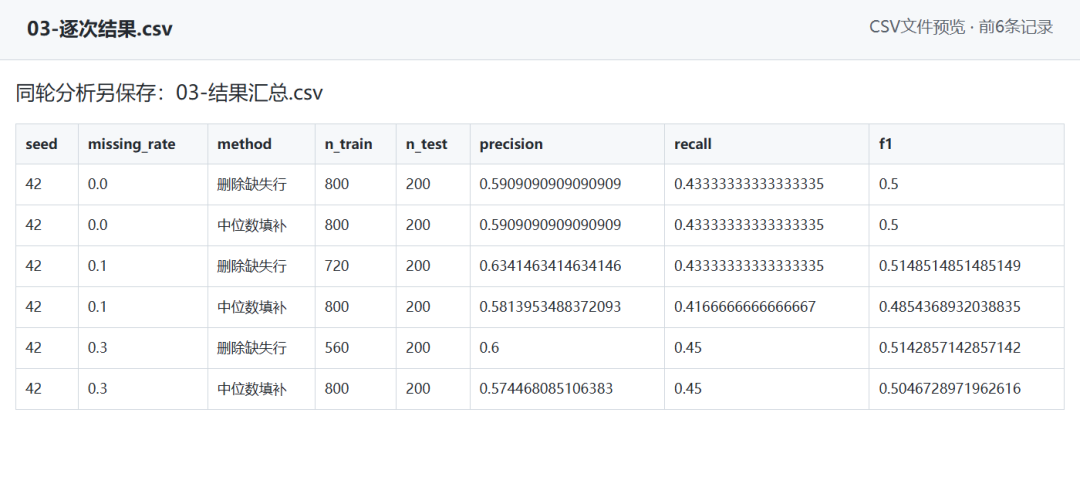
逐次结果保留每次运行,便于检查不同随机划分下的变化;汇总结果整理到摘要,供下一步搭建提纲。
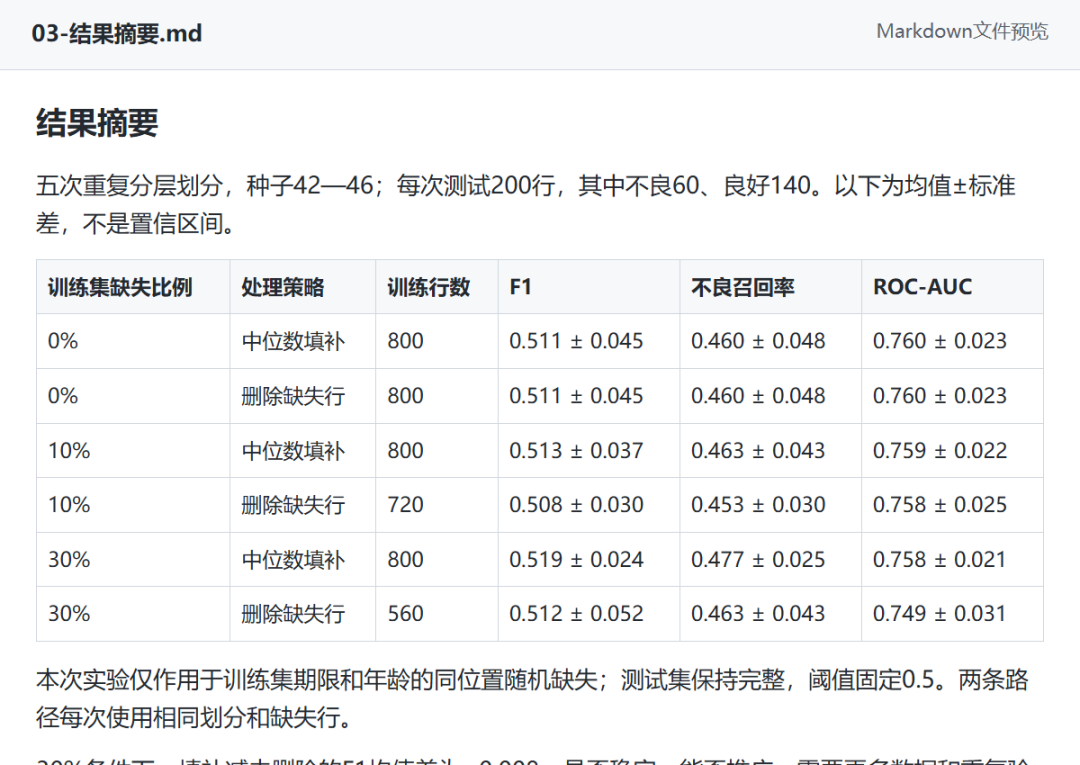
填补保留了更多训练样本,但预测表现的均值差很小。
结果摘要可用于写作,逐次结果和分析脚本留作回查与复跑。
| 04 搭文章框架
第四天,有了研究问题、方法方案和分析结果,再让AI安排正文。
先列到二级标题,并在每个标题下面标明要回答的问题和能用的证据。
提示词:
#把当前研究整理成精确到二级标题的小论文提纲。#01-研究问题.md、01-文献证据表.md、02-方法方案.md、03-质量报告.md、03-结果摘要.md。#保存04-论文提纲.md。每节写清需要回答的问题、可用证据和对应结果文件,注明哪里还需要补读文献。再依据这份提纲、文献证据表和结果摘要生成05-写作锚点.md每节列出写作要点及对应材料位置,不补造观点。#方法按实际运行的方案写,结果只引用已完成分析。讨论围绕处理策略及样本保留展开,不把小幅均值差写成显著优势;尚未生成的图注明“待生成”。
输出结果如下:
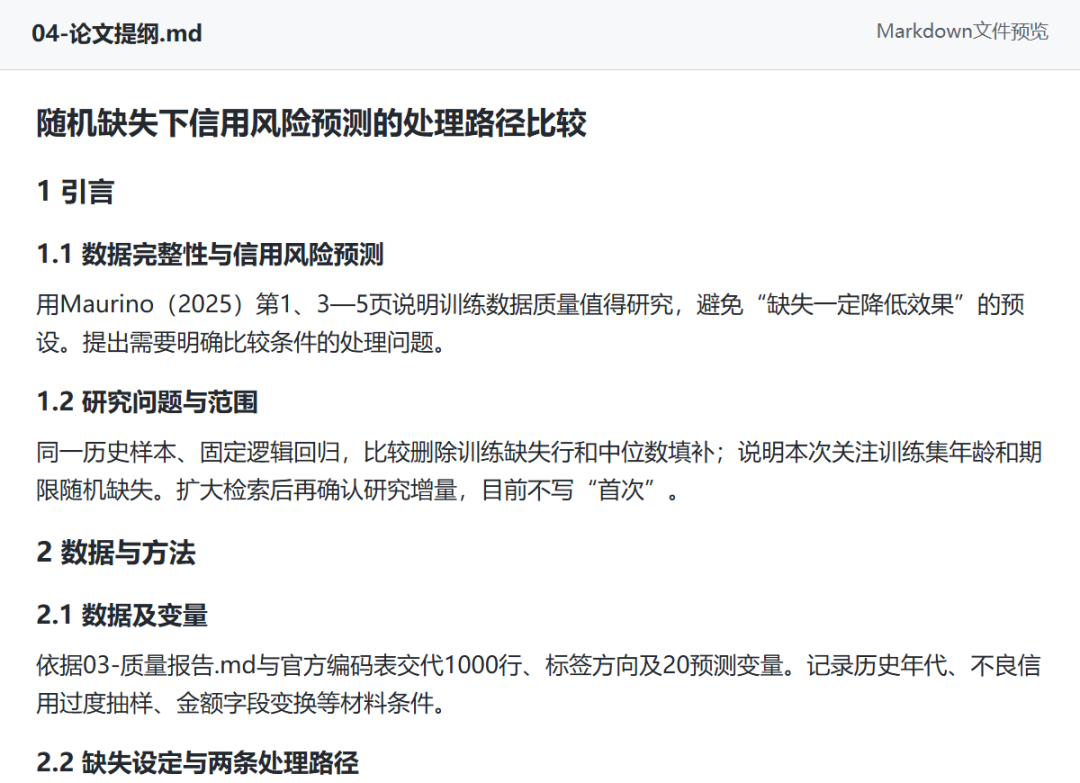
提纲把每节要回答的问题与证据对应起来,扩写时就能知道哪些内容已有支撑、哪些还缺材料。结果节呈现比较,讨论节解释取舍及适用条件,避免两节重复写同一组数字。
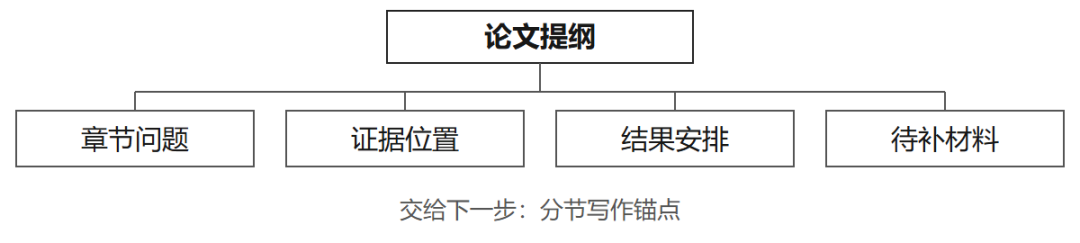
同一条提示词还生成了 05-写作锚点.md,列出各节要写的事实及来源。
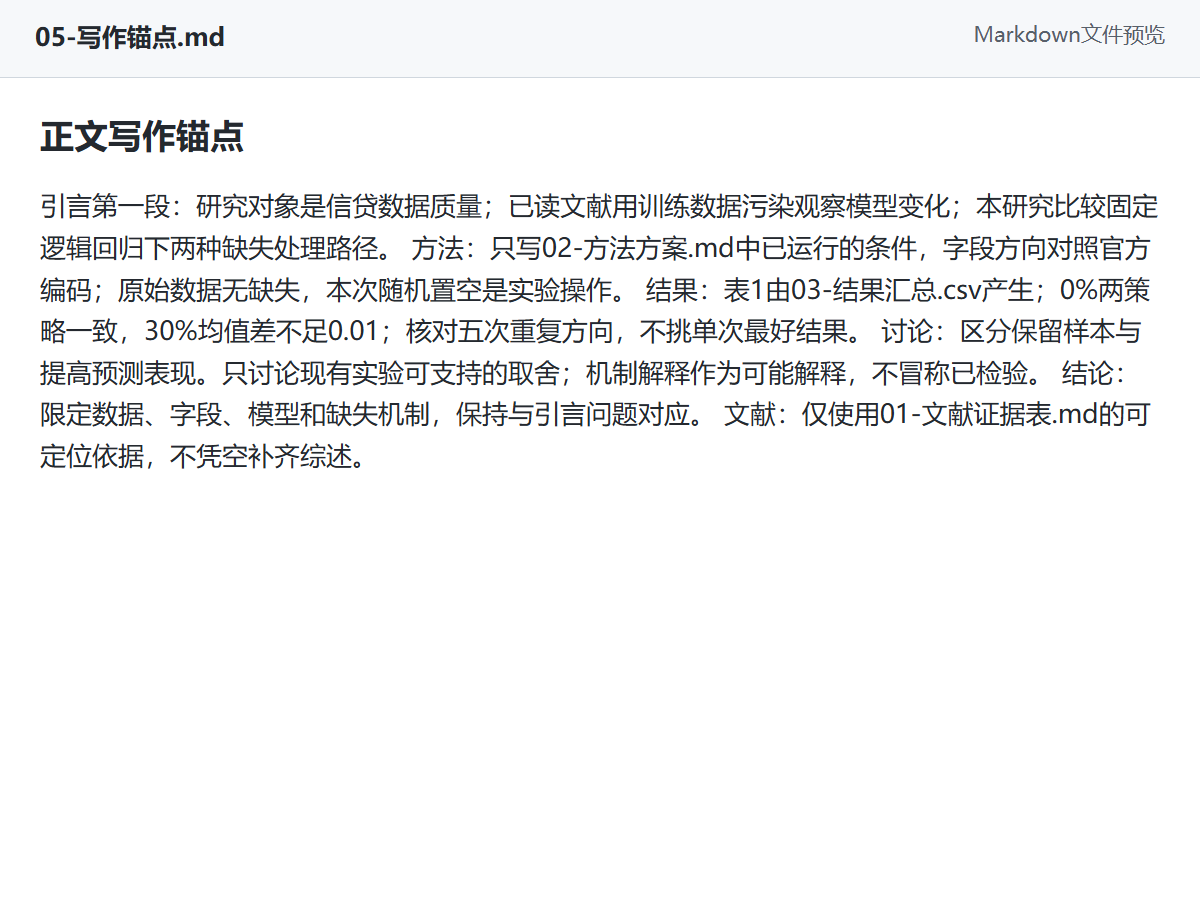
提纲确定章节,锚点提供每节的写作依据。
下一步把两份文件一起用于起草正文。
| 05 正文初稿
第五天,从引言第一段和方法写起。
引言的锚点是研究对象、已有文献的做法及本次比较;结果部分的锚点来自第三天的结果表,不让AI自己补出一个更好看的发现。
把这些锚点与提纲一起交给它,写完一节就核对一节,再补摘要和结论。
#按04-论文提纲.md分节写中文论文初稿。先写引言第一段,核对研究对象与问题后完成其余引言及方法;再依据结果表写结果与讨论,最后补摘要和结论。#04-论文提纲.md、05-写作锚点.md、01-文献证据表.md、02-方法方案.md、03-质量报告.md、03-结果汇总.csv、03-逐次结果.csv。#保存05-论文初稿.md,数字句前标记【数值核对】,每个主要判断说明对应材料位置;缺失的文献支撑另列待补项。#不补造引用、p值或未运行的实验。均值差不写成显著优势,图1保留待生成位置。本文的证据只来自当前资料。
输出结果如下:
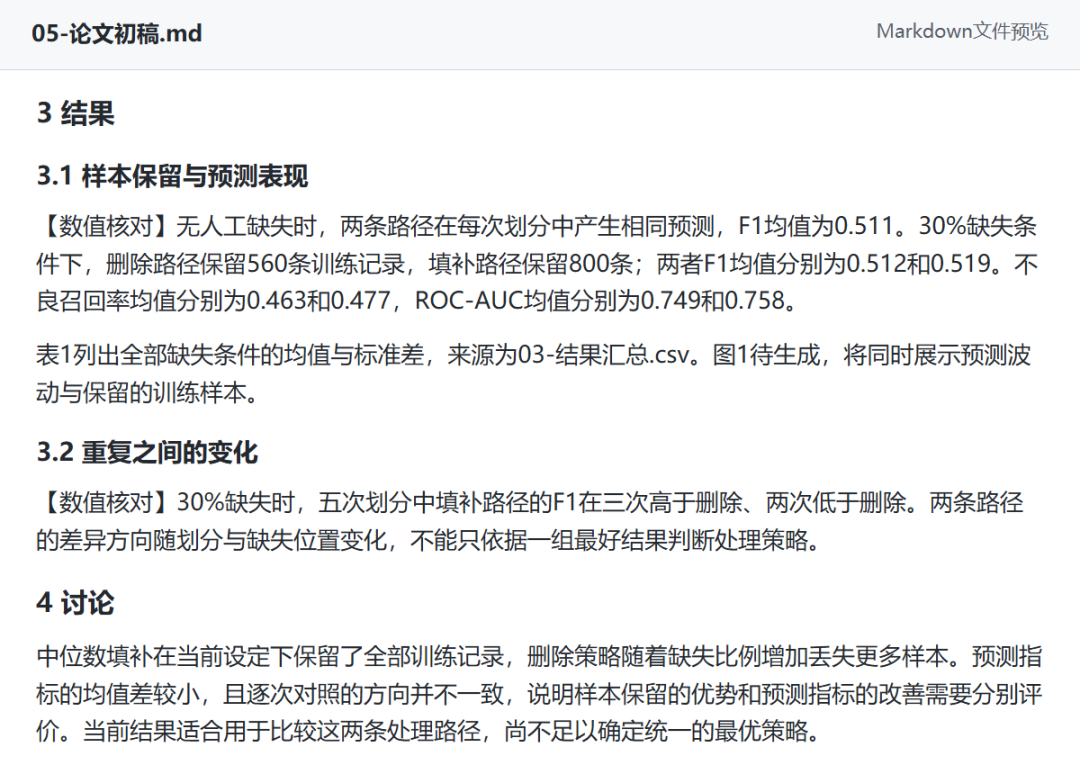
初稿把比较结果与研究问题对应起来,同时保留不同重复中的变化,接下来可以逐句回查数值,再补文献支撑。
先让结果说清楚,再处理表达,比反复要求“写得更学术”更容易找到具体修改位置。
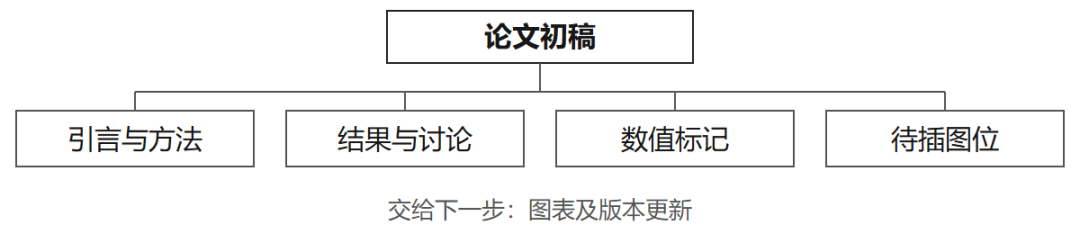
初稿中的数字句带有【数值核对】标记,按结果表逐句检查后再清除。
图表位置也先在稿中留下,等第六天生成正式图表,再更新到当前版本。
中文初稿里还有空话、重复和模板化表达时,可以用humanizer-zh做一轮语言审阅。
它处理已有文字,保留事实与结论的确定程度,适合放在内容核对之后,避免润色时把“小幅差异”改成“显著提升”。
项目地址:
https://github.com/op7418/Humanizer-zh
| 06 画图表
第六天,用第三天保存的03-结果汇总.csv;03-逐次结果.csv画图,
并把图表更新进第五天的05-论文初稿.md。
这个课题既关心预测表现,也关心删除记录后还剩多少训练样本,因此把两者并排放进同一张图。
#把现有结果制作成论文用图表,并同步到初稿。#03-结果汇总.csv、03-逐次结果.csv、05-论文初稿.md。#用matplotlib绘制双面板图:左侧F1均值及标准差,右侧保留的训练样本数。黑白打印可辨,导出图1-预测表现与样本保留.pdf300dpi的图1-预测表现与样本保留.png;制作表1-缺失处理比较.md,保存06-论文图表版.md;06-绘图脚本.py#每个指标使用真实结果;F1纵轴0—1,误差线标明标准差,不添加未计算的显著性星号。图表编号与正文对应。
输出结果如下
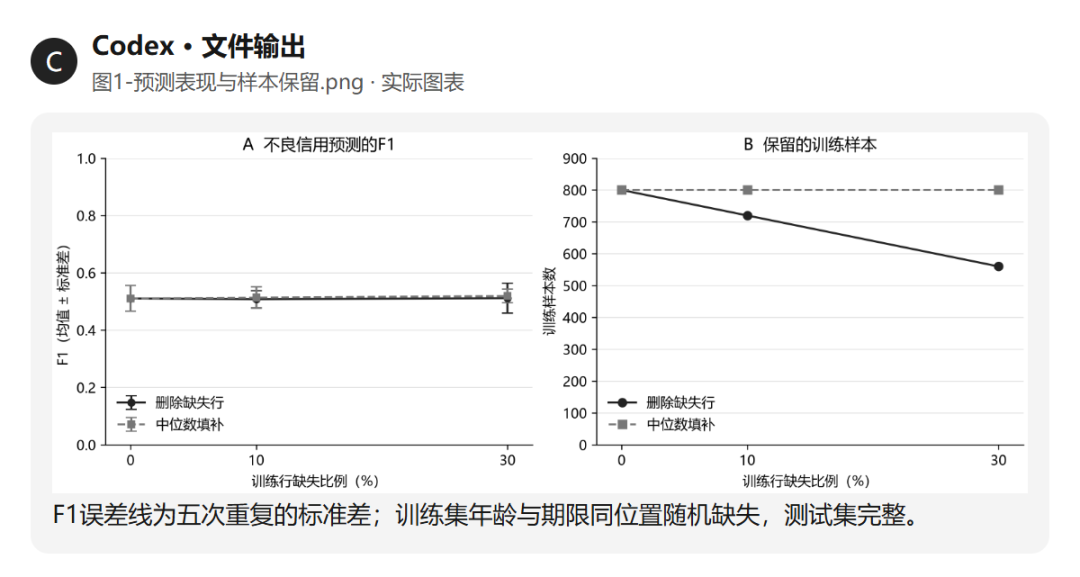
在图中,我们能够同时看见,样本损失和预测指标的波动。误差线写明是标准差,F1纵轴保留0—1,读者不会把很小的变化误看成明显提升;黑白线型和不同标记也方便打印。
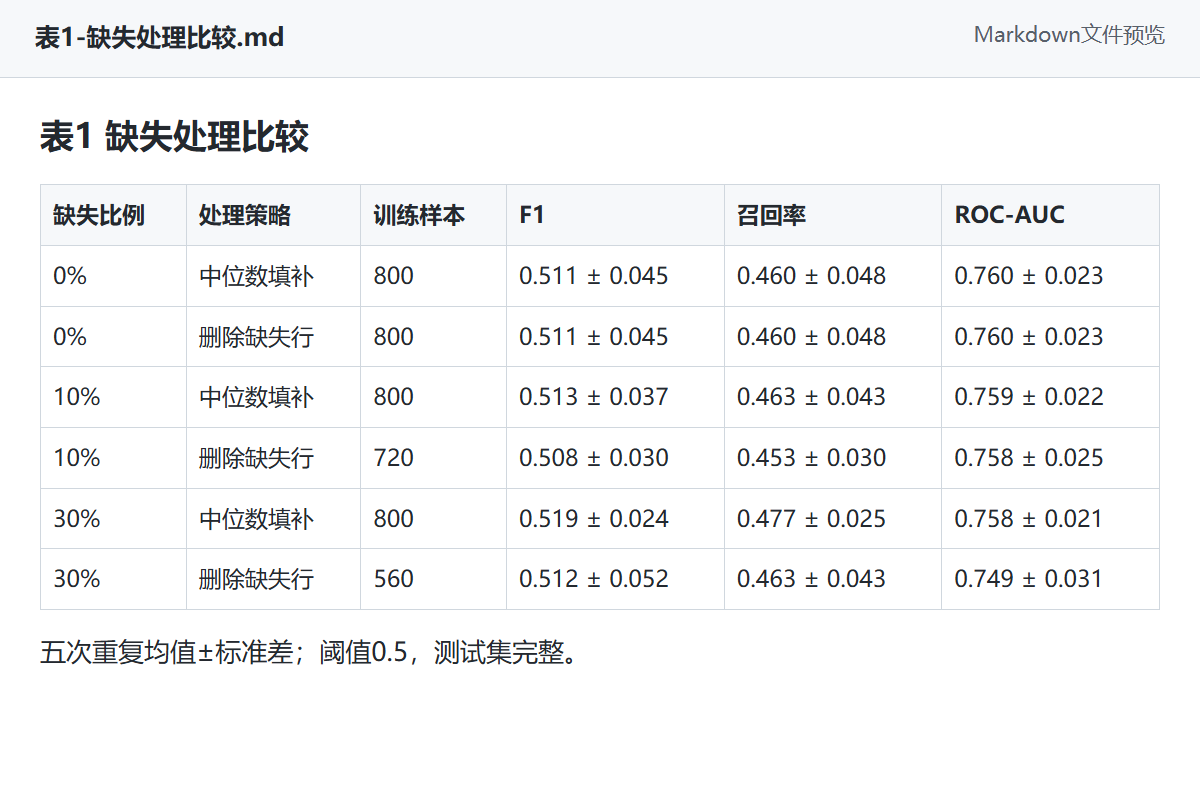
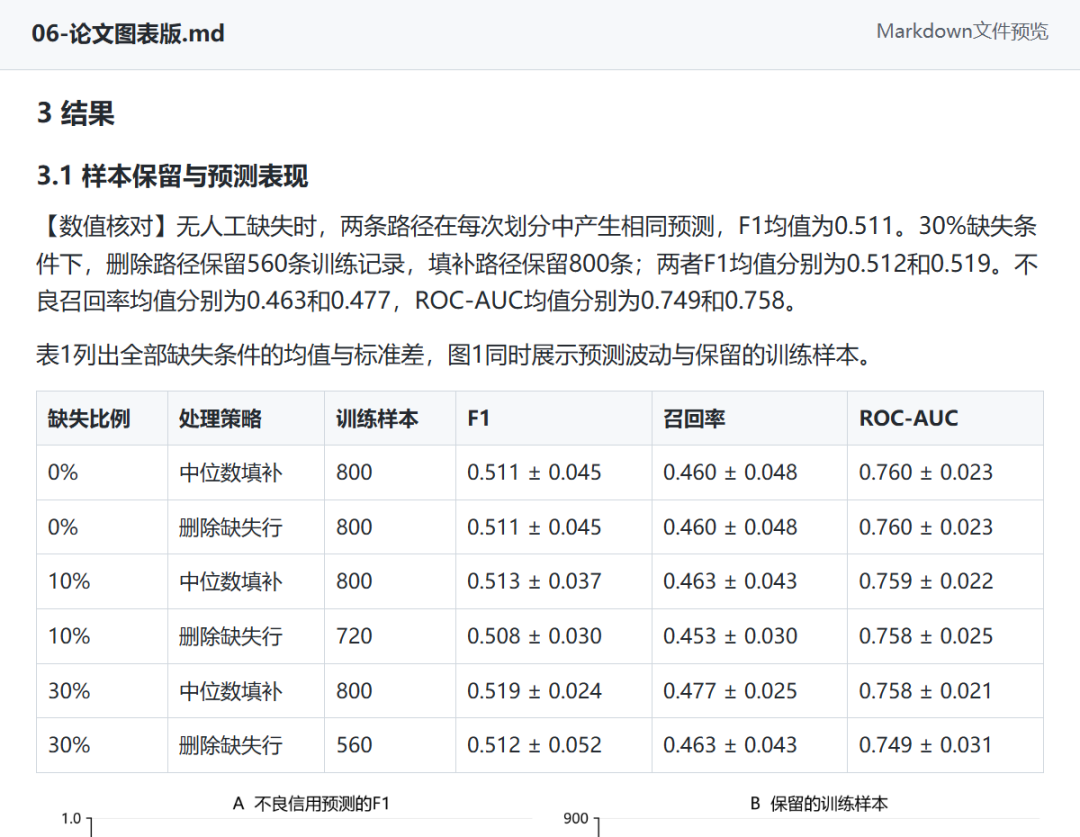
本轮同时生成图1-预测表现与样本保留.png、表1-缺失处理比较.md,并将图表编号和正文引用同步到06-论文图表版.md。
图1是上面的实际图表,表1和更新后的稿件也要检查,确认第七天使用的是这份新稿:
图表版稿件保留正文和表格,并链接本轮生成的图1。检查时读这份版本,可以核对图、表、正文是否使用同一轮数据:
需要统一多张科研图的字体、线型、误差线和导出尺寸时,可以配合scientific-visualization。
它同属第一节介绍的Scientific Agent Skills,适合已有结果表之后的图形整理;本例图1已经由上述绘图任务生成,后续再用它检查呈现与导出设置。
模块地址,所属项目页面见第一节:
https://github.com/K-Dense-AI/scientific-agent-skills/tree/main/skills/scientific-visualization
| 07 检查
第七天,把当前稿、方法方案、原始结果和文献证据一起交给GPT。
先核对研究问题与结论,再检查数字、参考文献、图表编号和单位;发现问题先列出来,按依据处理。
#检查06-论文图表版.md,先列问题和需要补充的材料,不直接改稿。#01-研究问题.md、01-文献证据表.md、Maurino与Yu两篇文献全文、02-方法方案.md、03-质量报告.md、03-结果汇总.csv、03-逐次结果.csv、06-论文图表版.md、图1和表1。#
保存07-检查报告.md,按位置列出问题、依据和处理建议;区分已经核对通过的内容与仍需补证的内容。#核对研究问题、方法、结果与结论是否对应,再查数字、文献、图表编号和单位。不要因格式通过就宣布论文可以投稿;没有公式时不虚构公式核对结果。
输出结果如下:
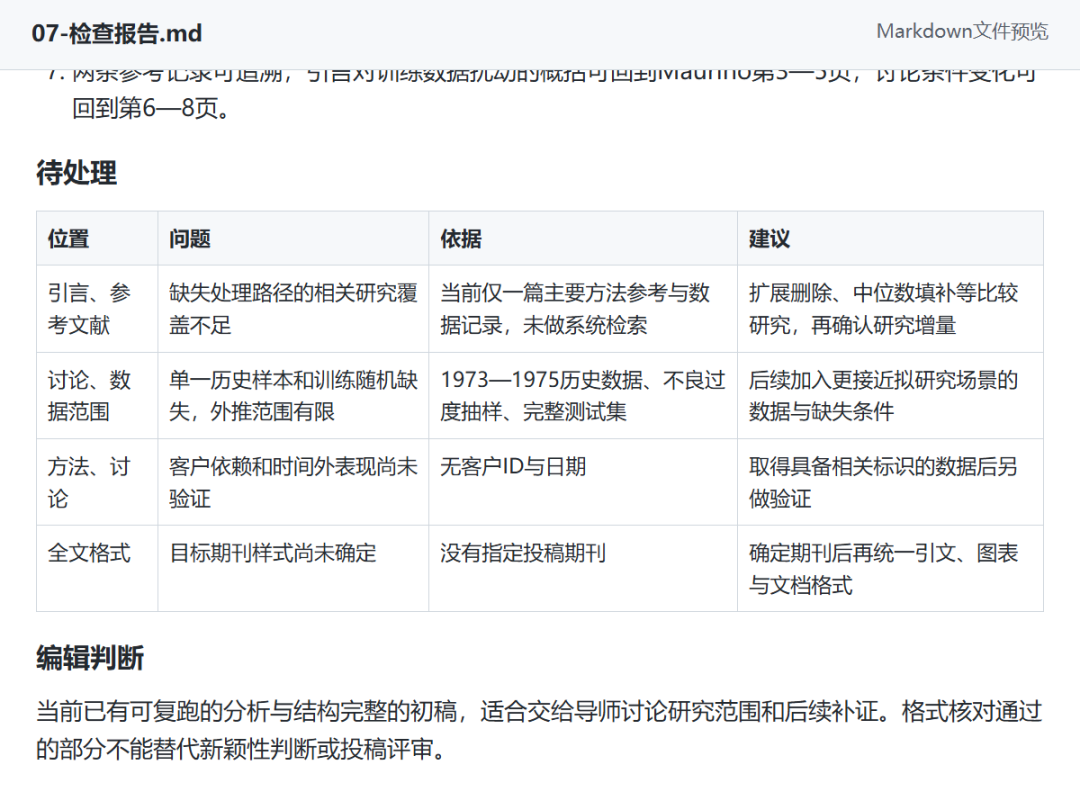
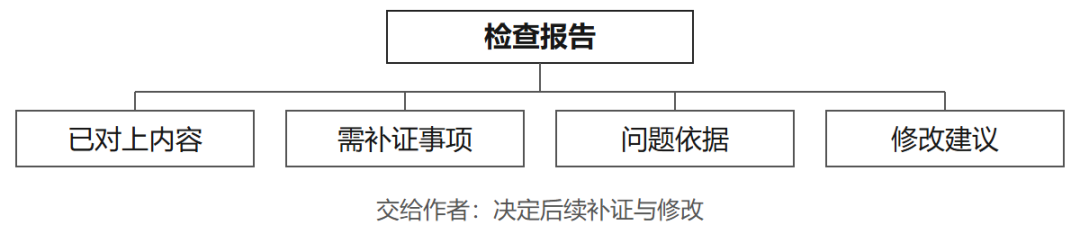
检查结果区分了已经对上的内容和仍需补证的事项。
文献覆盖不足就补文献,数据范围有限就限定结论,不能因为编号和格式整齐,便把初稿当成可以直接投稿的成稿。
一周结束时,我们已经有了能复跑的脚本、可回查的结果、图表和一份完整初稿。后面与导师讨论时,可以直接指向具体问题和证据,决定补哪一项研究,再修改对应章节。
换成自己的课题时,沿用这七个环节,同时替换文献、数据、研究问题和方法条件,评价指标与图表也随之调整。
每一步保存能交给下一步的产物,写作才能持续向前推进。



