关于这个问题,我的建议是先找到合适的Baseline,把已有代码跑通,再参考相近工作的实现,一步步把自己的想法加进去。今天就结合这条路线,分享一下具体操作,仅供参考,欢迎讨论。
另外,很多人卡在这一步,不只是代码原因,不知道该参考什么?具体改哪里?自己的想法有没有可借鉴的实现思路?都是问题。
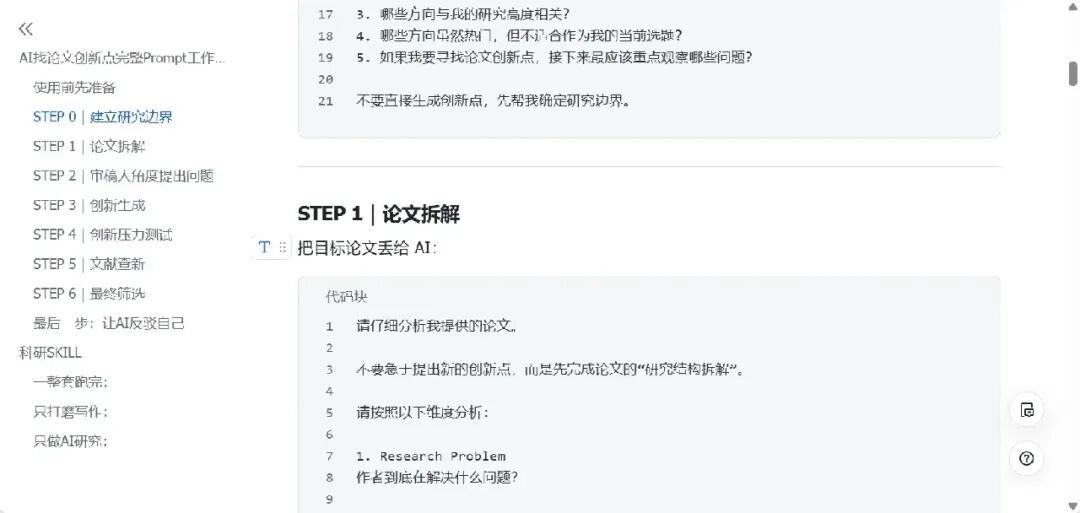
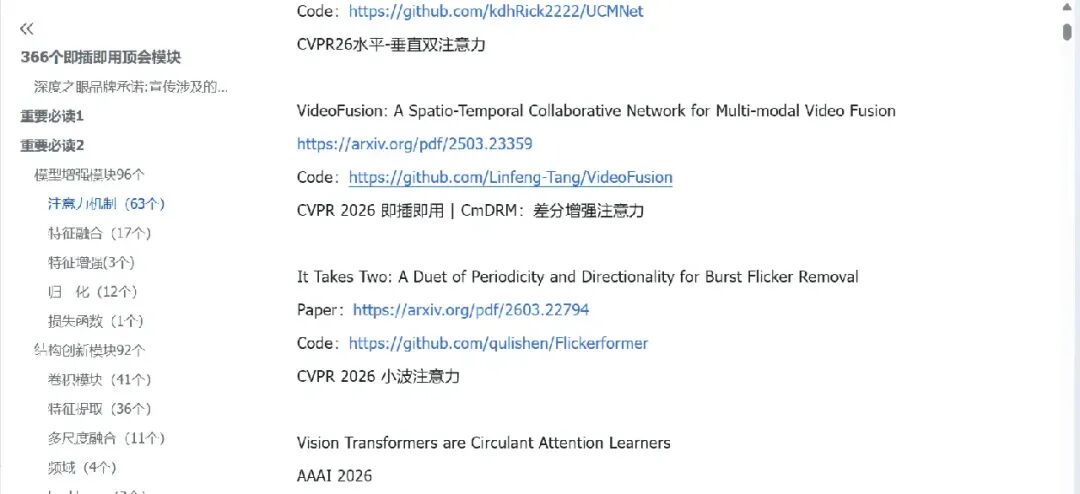
为此,我也整理了3份配套资料:AI找创新点Prompt工作流、各方向参考论文、366个即插即用模块。如果你已经有了研究方向,可以用它们辅助梳理现有方案、查找相关论文,再根据自己的模型寻找值得尝试的改进方向,省时省力!
Prompt模板
即插即用模块
第一步:找一个合适的Baseline
别急着从零造轮子,先从自己研究方向的论文里找1-2个开源项目。优先考虑近2-3年、README比较完整、代码容易运行的工作,最好能对照论文理解模型结构和实现逻辑。
第二步:先把原始代码跑通
按照项目说明配置环境、准备数据,先运行作者提供的原始实验。遇到报错,优先检查依赖版本和配置问题。
跑通之后,可以用Debug逐步查看数据如何输入、模型如何计算、结果如何输出。重点关注tensor的shape、中间变量和数据流转过程。看不懂就打印出来,先用一个样本或一个batch调试,不必一开始就跑完整数据集。
第三步:让Baseline适配自己的任务
先不要急着加入自己的idea。保留原有模型结构,优先修改数据读取、预处理等部分,让原始模型能够在自己的数据集上完成训练、验证和测试。
资料里的各方向参考论文就可以在这里发挥作用。你可以先筛选和自己任务最接近的工作,重点关注模型结构、改进位置和实验设计,再决定自己要从哪里入手。
这一步很重要:先确认数据和训练流程没有问题,后续才能判断实验效果的变化究竟来自哪里。
第四步:一次只加入一个创新点
无论是模型结构、损失函数还是训练机制,都可以先参考相似工作的开源实现,理解后再尝试修改。
如果你已经明确了要改进的部分,却缺少可供比较的模块思路,还可以查阅366个即插即用模块。结合自己的模型结构和研究问题,筛选几个有针对性的候选方案,弄清楚它们适合解决什么问题,再决定是否值得尝试。
实际实现时,新模块先用随机tensor测试前向传播和输出维度,确认基本逻辑没问题,再接入完整模型。每次只改一小部分,跑通后及时记录。这样即使出现报错,也更容易定位原因。
最后想说,有idea不代表必须从零实现整个模型。先把已有工作跑通,再逐步替换、增加和验证自己的模块,往往比一开始就大改代码更容易推进实验。



