大家好,我是小林。
最近 GitHub 上有个项目火得有点离谱,叫 REA,全称 Reverse Engineer Anything,翻译过来就是「逆向一切」。
其实这个仓库 4 月份就有了,一直没什么人关注,就在这个月突然冲上 GitHub Trending 第一,之后连着霸榜好几天,一周时间就狂揽 20 万 Star,现在第二周已经涨到了恐怖的 30 万+。
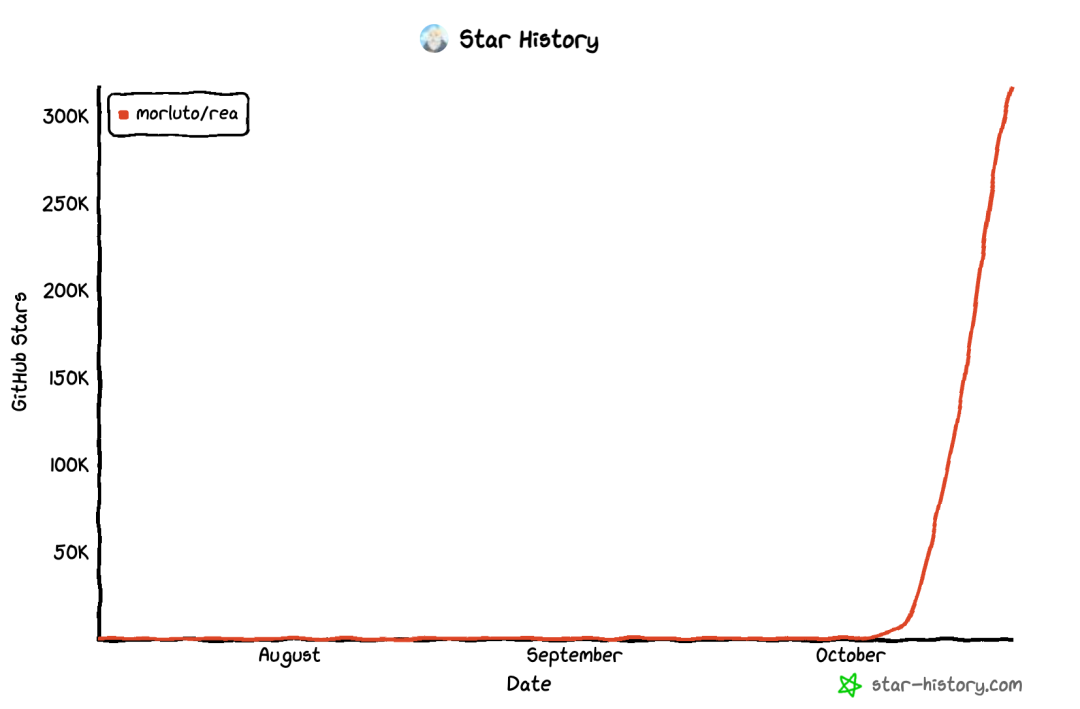 ▲ Github地址:https://github.com/morluto/rea
REA 爆火之后,不少人拿它逆向起了各种软件,玩出了不少花样。
比如,开发者 thinkszyg 用 REA 配合 Codex,把家里的智能马桶接进了 Mac 状态栏,鼠标点一下就能控制翻盖,他说前后只花了大概半小时。
还有开发者 Ben 嫌飞书来回切账号麻烦,用 Codex 加 REA 分析客户端,做出了一个「飞书 2」。现在 Mac 上能同时开两个飞书,各登一个账号,改造只花了 6 分钟。
还有开发者 Himansh Raj 为了在 Mac 上玩安卓游戏,用 REA 研究了 MuMu 模拟器的部分实现,再基于 Google 的安卓模拟器做出游戏播放器 Kestrel。他说,现在已经能用键盘鼠标玩 BGMI 这款吃鸡手游了。
还有开发者梁,用 REA 逆向经典游戏《大富翁 4》,再让 Claude 用 Flutter 重写,跑到了 iPhone 上。他说,研究逆向和重写各花了一天。
看到这里,你是不是也手痒痒,想装个 REA 逆向点什么玩玩?
但是我劝你别在codex里用,因为看到有人在 codex 用了 REA 后,直接被OpenAI 封号了 。。。
如果你头铁,就是想试试,用起来其实也很简单。先让 Agent 帮你装好 REA,再把想逆向的软件告诉 Agent 就行。
不过这篇不讲怎么用,我想跟你们聊聊 REA 背后的原理。我们先从逆向到底是怎么回事说起。
────逆向到底在逆什么?────
编译时丢掉了什么?
要搞懂逆向,得先搞懂「正向」是怎么回事。
我们平时写代码,写的是给人看的东西。变量叫 userName,函数叫 calcDiscount,旁边还有注释,告诉你这段逻辑为什么这么写。可 CPU 看不懂这些,它只认机器码,也就是一串串的二进制指令。
所以代码写完,要经过编译器翻译一遍,变成机器码,再打包成 exe、app 这种能直接运行的文件。我们从网上下载的软件,拿到手的就是这个编译后的产物,源码一直留在开发商自己手里。
这里有个关键点,编译是一个会丢信息的过程。
打个比方,源码就像一份菜谱,写着放多少盐、火候多大、为什么要先焯水。编译就像把菜做出来,端到你面前的是一盘成品菜,菜谱可没跟着一起端上来。
逆向要干的事,就是对着这盘菜,把菜谱推回来。
尝一口,咸淡大概有数了。看看颜色,能猜出放没放酱油。夹起来看看刀工,能推出切菜的手法。推出来的菜谱不可能跟原版一字不差,但照着做出来的味道,可以八九不离十。
什么是反汇编?
拿到一个编译后的文件,打开一看,全是这种东西。
●  ●  ●

55 48 89 E5 48 83 EC 10 C3
人肯定是看不懂的。所以逆向的第一步,叫反汇编,就是把机器码翻译成汇编。
汇编说白了,就是给每条机器指令起了个人能念的名字。比如 55 叫 push rbp,意思是把一个值存到栈上。C3 叫 ret,意思是函数返回。
机器指令和汇编指令是一一对应的,反汇编工具就像一本「机器码词典」,把这串数字逐条翻成汇编。
对了,指令有长有短。55 一个字节就是一条,48 89 E5 却要三个字节才算一条,所以工具得先把这串数字正确切开,再逐条翻译。
这一步的好处是准。只要认准了哪些字节是代码,逐条查表翻出来的汇编一般就是准的。
坏处是难读,汇编里只有搬数据、做加减、跳转这些最原始的操作,一个简单的 if 判断,翻出来可能就是十几行。
怎么找到要分析的代码?
一个软件反汇编出来动不动几百万行,从哪里看起?逆向老手不会从头读,他们会先找线索。
最好用的线索是字符串。比如想知道马桶翻盖是怎么实现的,就在文件里搜「翻盖」这两个字。字符串基本都原样留在文件里,反汇编工具也记着哪些代码用到了它,点一下就能跳过去。
另一种线索是系统接口。软件要连蓝牙、发网络请求,都得调用系统接口,顺着「谁调用了蓝牙发送接口」往上找,就能摸到发指令的那段代码。
这种「看谁用了它、它又用了谁」的找法,叫交叉引用,是逆向里最常用的操作。
什么是反编译?
找到了目标代码,接下来就得读懂它。可汇编实在太难读,能不能把它变回我们熟悉的代码?
能,这一步叫
反编译。
反编译工具会分析汇编里的跳转关系,认出哪些跳转其实是 if 判断,哪些是 for 循环,再把它们拼回类似 C 语言的代码,这种代码叫伪代码。
拿 REA 官方的一个案例来说。他们逆向了一个 1996 年的老游戏 DX-Ball,想搞清楚游戏里声音的左右声道是怎么算的。
反编译工具第一眼给出来的结果,长这样。
●  ●  ●

void FUN_00406400(void)
函数名是工具按内存地址自动起的,参数那里显示的是空。可实际上这个函数是有输入的,只是反编译工具没认出来。
为什么会认错?因为机器码里压根没有「参数」这个概念,参数只是提前放在某个寄存器或者栈上的值,工具只能靠猜,猜漏了就显示成空。
就算参数认对了,读起来也是这种感觉(示意)。
●  ●  ●

int FUN_00401a20(intparam_1)
{
intlocal_8;
local_8=param_1*0x1e+0x14;
if (local_8<0x100) {
    local_8=FUN_00401b40(local_8);
  }
returnlocal_8;
}
变量叫 param_1、local_8,数字全是十六进制,你只能看出它在做一些计算和判断,至于到底在算什么,全得靠猜。
这就是反编译的真实状态。你以为能直接拿回源码?其实拿回来的更像是打了马赛克的源码,结构大概还在,名字全没了,有些地方还会认错。
要把马赛克一点点擦掉,就得靠人去补。看看这个函数被谁调用、传进来的是什么值,结合游戏画面猜它的用途,再给它起个有意义的名字。
DX-Ball 这个函数最后被还原成了一个公式。
● ● ●
pan = ((double)x * 1.5625 - 500.0)
* dxball_pan_scale;
意思就是根据发声的砖块在屏幕上的横向位置,算出声音该偏左还是偏右。砖块在左边被打碎,声音就从左声道出来。
做反汇编、反编译的工具,业内最有名的是这三个,IDA、Ghidra 和 Hopper。IDA 是商业软件,贵但强。Ghidra 是美国国家安全局开源出来的,免费。Hopper 主要用在 macOS 上。
后面会看到,REA 干活靠的就是它们。
不同软件的逆向难度一样吗?
不一样。上面说的是最难的一种,也就是 C、C++、Rust 这类语言写的原生程序,编译完直接就是机器码,信息丢得最多。
别的软件,难度要低不少,我按从易到难排一下。
• 网页和网络请求,最好拆。打开浏览器开发者工具,页面发了什么请求、带了什么参数,一目了然,很多时候不用看代码就知道功能是怎么实现的。• Electron 和 JS 应用,像 Notion、Slack 这类桌面软件,本质上是套了壳的网页,安装包里装的就是 JS 代码。解包后拿到的是压缩过的 JS,变量名可能变成了 a、b、c,但字符串、接口名和整体结构都还在,格式化一下就能读。• Java、.NET、安卓 APK,编译后是一种叫字节码的中间格式,类名、方法名这些信息很多都还保留着,反编译出来跟源码挺接近。不过安卓 App 上线前大多会用 ProGuard 这类工具混淆,名字会被改成 a、b、c,但代码结构还在,还是比机器码好读得多。• C、C++、Rust 原生程序,最难拆,就是上面说的那一套,只能从机器码一点点往回推。回头看开头的案例,就更好理解了。马桶的微信小程序是 JS 写的,蓝牙指令就藏在代码里,属于比较好拆的那档。而前面提到的 DX-Ball 老游戏,拿到手的是编译后的程序,就得靠反汇编、反编译,一点点还原里面的逻辑。
对了,除了盯着文件看,逆向还有另一条路,就是让软件跑起来,在旁边观察。看它发了哪些网络请求,往哪个文件里写了什么,蓝牙发出去的是哪几个字节。
前一种叫静态分析,后一种叫动态分析,实际干活时两条路经常配合着用。
传统逆向难在哪里?
逆向的套路其实不复杂,难的是量。
一个中等规模的软件,反编译出来是成千上万个 FUN_xxxx 这样的函数,每追一层都得读懂、猜名字,猜错一次就可能绕进死胡同。
所以以前逆向一个功能,花上几天甚至几周都很正常。说白了,过去保护软件的,主要是逆向的成本。
可读大量代码、猜意图、反复试错,不正好是现在的 AI 最擅长的事吗?
────REA 是怎么让 AI 学会逆向的?────
REA 和反编译工具是什么关系?
看到这估计有同学就问了,那直接把安装包丢给 AI 不就行了?
还真不行。几十 MB 的机器码,AI 既塞不进上下文,也读不出名堂。把机器码翻成能读的东西,还得靠专门的工具。
所以 REA 自己其实不做反编译,这些重活还是交给 IDA、Ghidra、Hopper 这些老牌工具。REA 干的是牵线搭桥的活。
这些工具原本是给人用的,得人去点、去看。REA 把它们的能力包装成了 AI 能直接调用的接口,比如「列出文件里的字符串」「查看函数的伪代码」「找出谁调用了这个函数」。包装用的是 MCP 协议,可以理解成 AI 调用外部工具的统一插口,Claude Code、Codex 这些工具装上就能用。
另外,REA 还给 AI 配了一份操作手册,也就是一个 skill,告诉 AI 逆向该按什么步骤来。
简单来说,以前是人坐在 Ghidra 前面一点点点,现在是 AI 拿着 REA 这个工具箱和说明书,自己去点。
一次逆向的完整流程是怎样的?
拿 REA 官方的 Notion 案例来走一遍。
在 Notion 里复制一个带格式的内容块,粘贴到另一个页面,各种格式都能完整保留。Notion 是怎么在复制粘贴之间记住这些格式的?
把这个问题丢给装了 REA 的 AI,它大概会这么干。
第一步,认清对象。AI 先让 REA 检查安装包,发现 Notion 是个 Electron 应用,属于好拆的那档,直接解包看 JS 代码就行。
第二步,找线索。AI 在代码里搜和剪贴板相关的调用,找到了点击复制时触发的那段代码。
第三步,顺藤摸瓜。AI 顺着这段代码一路往下追,从界面追到真正写剪贴板的主进程,用的就是前面说的交叉引用。
第四步,得出结论。原来 Notion 复制时,会在内容里偷偷藏一个复制 ID,同时在本地按这个 ID 存一份完整数据。粘贴回 Notion 时,凭这个 ID 就能把格式原样找回来。
你看,整个过程跟前面讲的人工逆向一模一样,认清对象、找线索、交叉引用、推出结论。区别在于,读代码、追调用、试错这些最耗时间的活,现在全交给了 AI。
而且 AI 不是一口气走完的。每一步拿到结果,它都会判断够不够,不够就换个工具再查,查完再判断,一直循环到能把问题讲清楚为止。
REA 是如何避免 AI 瞎编的?
用过 AI 的同学都知道,AI 最大的毛病是一本正经地胡说八道。逆向更容易翻车,伪代码本来就是半猜的,AI 再猜一层,很容易编出一个听着合理、实际不对的结论。
REA 的办法有两个。
第一个是结论必须有出处。REA 工具返回的每条信息,都会标明来自哪个文件、哪个函数地址,没搞清楚的地方也会单独列出来。AI 的结论能追到出处才算数,追不到的就是猜的。
第二个是跑一遍对比。还是前面 DX-Ball 那个声道函数,AI 把伪代码补全、改写成 C 代码后,拿 3205 个测试用例对比原版和还原版,结果全部一致。再用当年的老编译器重新编译,连 63 个字节的机器码都一模一样。
这跟我们平时写代码跑测试一个道理,AI 说它看懂了不算数,结果对得上才算数。
REA 有哪些局限?
局限肯定有,REA 自己也说得挺坦诚。
首先,它拿不回原始源码。它给出的是伪代码、调用关系和证据,最终的实现是 AI 根据这些重新写出来的,代码跟原版长得不一样,只是行为一致。
其次,碰上专门防逆向的软件就很吃力。有些软件会加壳、做代码混淆,故意把代码搅成一团乱麻,人看着头疼,AI 看着一样头疼。
再者,服务器上的逻辑它碰不到。逆向只能拆你手里有的东西,很多软件的核心逻辑跑在厂商的服务器上,客户端只是个显示结果的壳,这部分怎么逆都看不到。
还有一点,网上那些「一句话复刻整个 App」的演示,得打个问号。
REA 擅长的是一个功能一个功能地拆,整个应用复刻出来,界面可能看着很像,背后的行为未必一样。
也有人做过对比,在一些简单的软件上,不装 REA 的 AI 直接对着界面和文件分析,效果也差不太多。
这其实也说得通,简单的 JS 应用,AI 自己就能读个大概,REA 真正价值的,是 C、C++ 原生程序这种 AI 自己啃不动的硬骨头。
────写在最后────
看完你会发现,逆向的基本套路其实一直没变过,反汇编、反编译、找线索、追调用、验证结果。
REA 并没有发明什么新的逆向技术,它做的是把这些老手艺打包好,交给 AI 去干。
可就是这一步,把门槛拉下来了。以前专业搞逆向的蹲上几天甚至几周的活,现在一个没碰过逆向的普通人,借助 AI 可能半小时、一小时就搞定了。
对我们写代码的人来说,这件事有个很直接的启发,装在用户电脑上的代码,基本没什么秘密可言了。真正核心的逻辑和校验规则,该放服务端的,还是老老实实放服务端。



