大家好,我是你们的朋友架构君,一个会写代码吟诗的架构师。
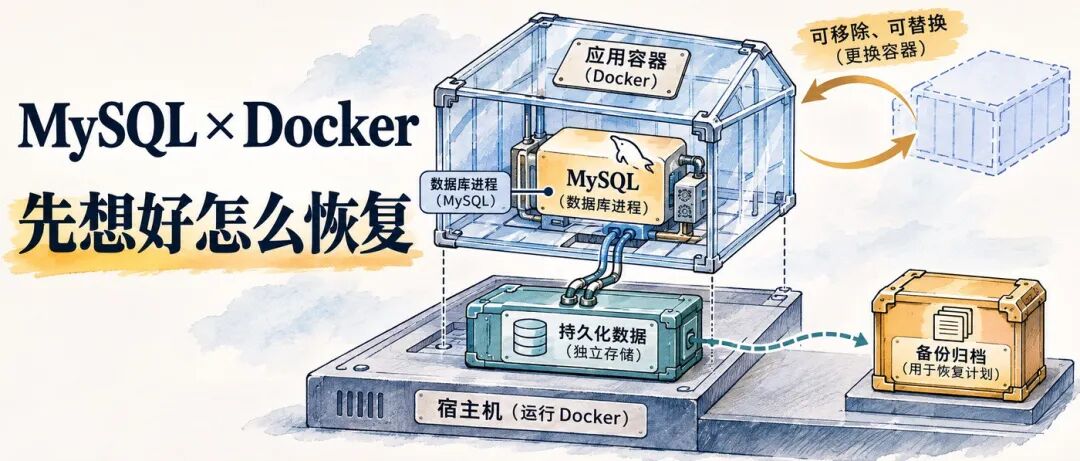
MySQL容器、持久化存储与独立备份相互区分的恢复规划概念图
Java 服务搬进了容器,MySQL 要不要跟着搬?架构君的答案是:可以,但得把存储和恢复安排好。容器能让部署省事,数据放在哪儿、磁盘能扛多少写入、机器坏后怎么恢复,仍得自己回答。
先分清容器重启和删除
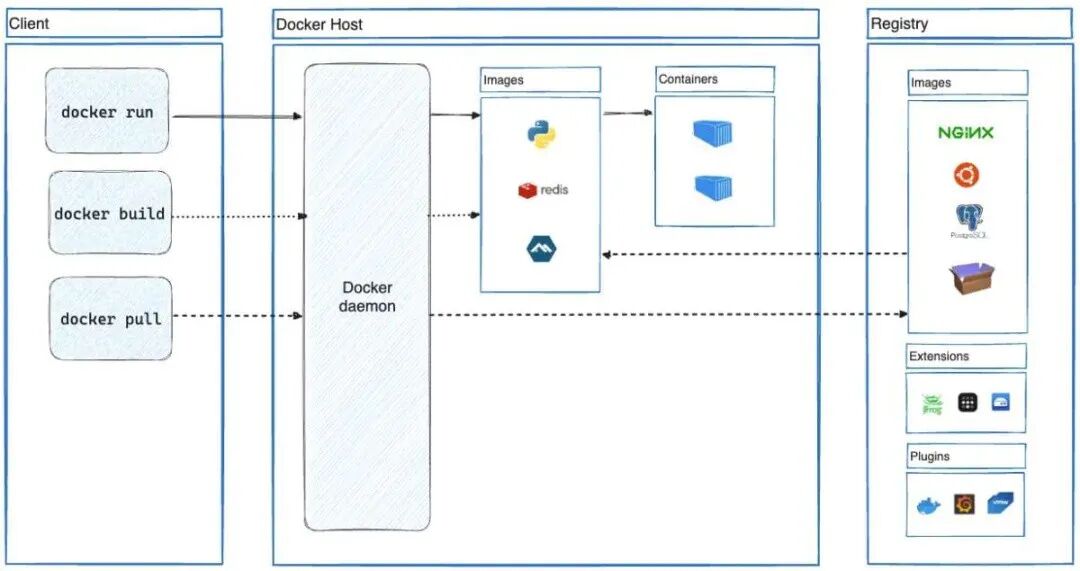
Docker客户端、宿主服务和镜像仓库之间的架构关系
重启同一个容器,可写层还在;删除容器再重建,就不能指望旧可写层继续留着数据。数据库文件要放到独立管理的挂载存储中。
官方 MySQL 镜像为
/var/lib/mysql 声明了 VOLUME,没显式写命名卷,也可能创建匿名卷。麻烦在于重建时能否挂回同一个卷。生产环境把卷名、路径和重挂流程写清楚,别让数据库接到新建的空卷。
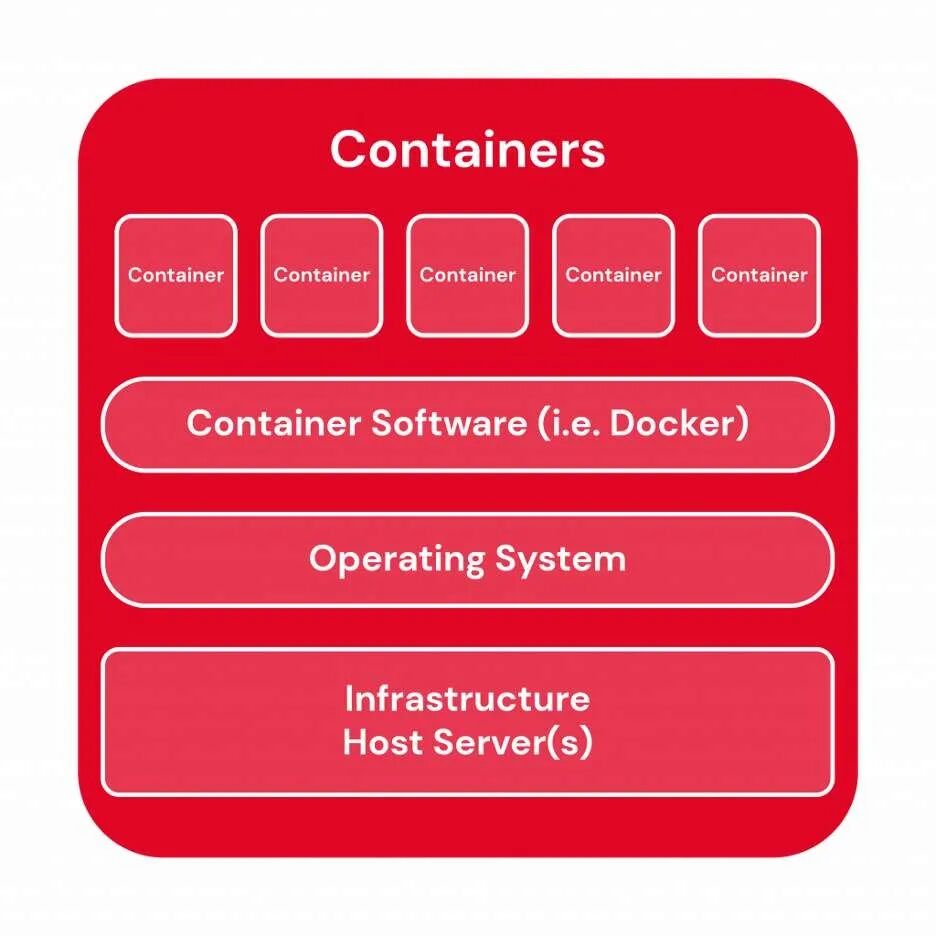
Linux容器共享宿主内核的简化分层示意
这张图画的是 Linux 容器的简化分层。Docker Desktop 通常还隔着虚拟机,别把笔记本上的测试直接当成生产宿主机的结果。
磁盘性能,测实际挂载后的 MySQL
命名卷和 bind mount 都能让数据写入绕开容器可写层,并非只有 bind 才行。存储驱动取决于 Docker 版本和配置,也不能一概认定都是 overlay2。
“通常慢一两成”“挂目录就只差百分之一”,先别背这些数字。磁盘、文件系统、刷盘配置和业务负载没对齐,就没法这样比较。该测的是实际挂载方案下的事务延迟、吞吐和 I/O 等待,两次简单文件写入代替不了数据库压测。
有数据卷,也得有恢复办法
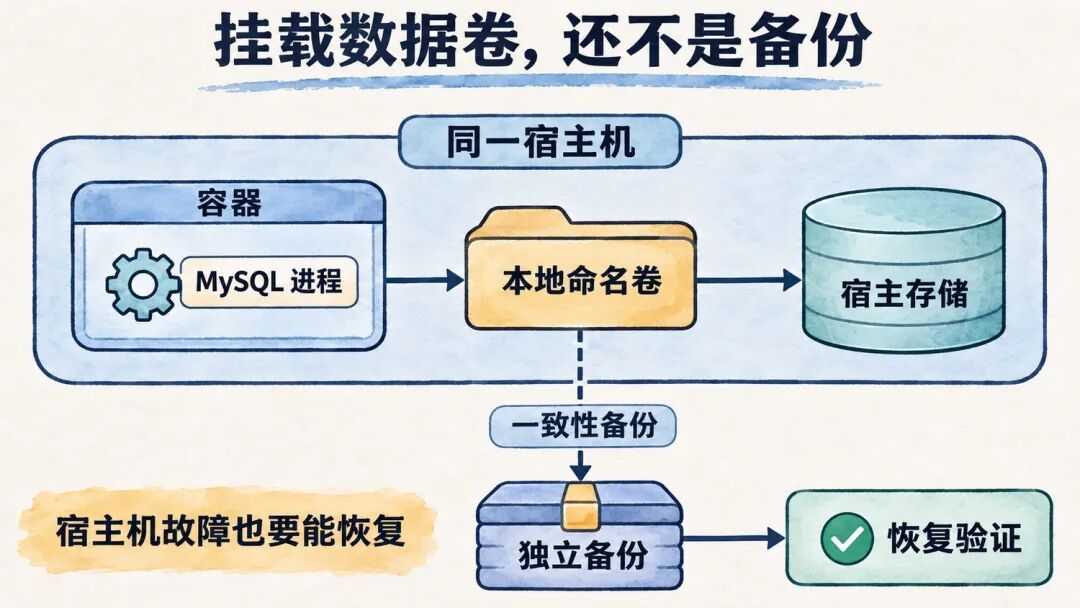
本地命名卷与宿主存储属于同一故障范围,独立备份还需要恢复验证
本地卷还是靠宿主机的磁盘,盘坏了,卷不会自动搬到另一台机器。已提交事务能否保住,还要看 redo、binlog 刷盘策略和底层存储。挂了卷,不等于有了备份。
备份有没有用,拿一个新实例试。至少走完:确认挂载 → 按同条件压测 → 从独立备份恢复到新实例 → 检查数据并记录耗时。再对照业务能接受丢多少数据、停多久,看看恢复结果是否达标。
数据库高可用,得单独做
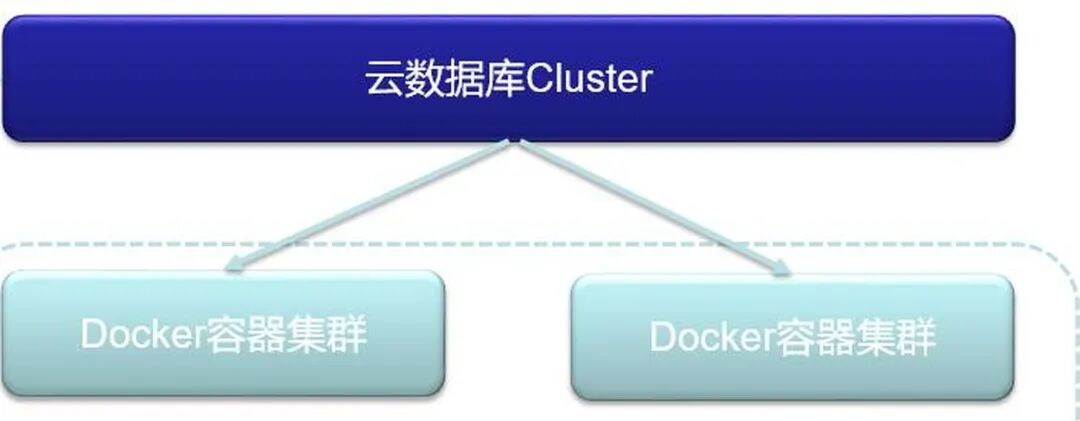
历史关系局部示意:云数据库连接两个容器集群,用户入口和服务器硬件层未展示
这里只示意云数据库与容器集群的关系,未展示的服务器硬件和存储仍是运行基础。复制、选主、备份都没在这里展开,不能把它当成完整的高可用架构。
多开几个 MySQL 容器,不能靠共用一个数据目录分担读写。每个实例要有自己的数据,再配复制和故障切换。StatefulSet、稳定服务名、持久卷不会自动补齐这些工作,切换时还得隔离旧主,防止它继续写入。
资源预算也别只填一个限额。CPU、内存上限不保证资源够用;算内存时,buffer pool 之外还有连接和其他开销。容器与裸机都可能因资源不足出问题。
生产怎么选,先看谁来运维
开发测试可以用容器快速搭环境;生产要不要用,先看存储、容量、监控、升级和恢复有没有人负责。数据超过某个固定大小就一律不能容器化,也不是通用界线。
团队缺数据库运维能力,可以先比较托管数据库方案;选了托管服务,也要确认备份保留与恢复流程。先把恢复演练做出来:机器坏了以后,数据能恢复到哪一刻、多久能恢复?这两个问题答得上来,再决定部署形式。



