很多人以为「机器学习」必须靠 GPU、Python 和几 GB 的依赖。其实一个巴掌大的单片机,也能完整跑完「读图 → 预处理 → 推理 → 出结果」的机器学习闭环。本文介绍的项目,就是用 SWM341(Cortex-M33,150MHz)这块国产 MCU,配合一张普通 SD 卡,纯 Rust 实现的手写数字识别。整条链路没有操作系统、没有 Python,全部 no_std 裸机运行。
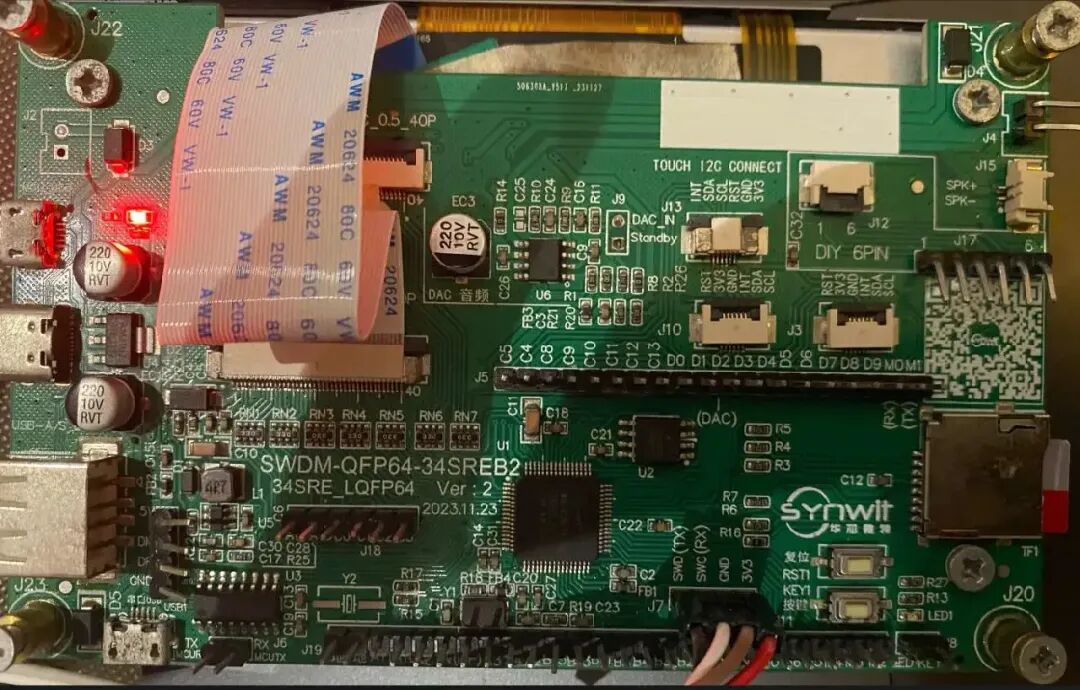 SWM341开发版
一、整体架构:一张图看明白
系统架构:上层软件组件(纯 Rust · no_std)运行于下层 SWM341 硬件之上;数据流向 SD 卡 → SDIO → hadris-fat → decode_png → core_ml → embedded-nn → RTT软件栈(全部纯 Rust、no_std):
| | |
|---|
| hadris-fat | |
| 自研 decode_png + miniz_oxide | |
| core_ml | |
| embedded-nn | CMSIS 风格 fully_connected_per_channel_s8 |
| host/ | |
| RTT | |
二、机器学习的数学原理
1. 问题怎么建模
手写数字识别是个 10 类分类问题:输入一张图,输出它属于 0~9 中哪一类。我们把 28×28 的灰度图摊平成一个 784 维向量x(每个像素一个特征,取值 0~255)。
2. 模型:最简单的线性分类器(Softmax 回归)
本项目用的是单层全连接 + Softmax,也就是「多类逻辑回归」。它没有任何隐藏层,是教科书里最朴素的模型。对第 k 类(k = 0..9),先算一个「对数几率」:
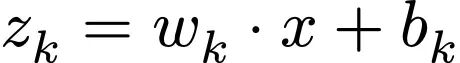 对数几率(logits)
其中 w_k 是 784 维权重向量,b_k 是偏置。把所有 10 个 z_k 丢进 Softmax,变成一组和为 1 的概率:
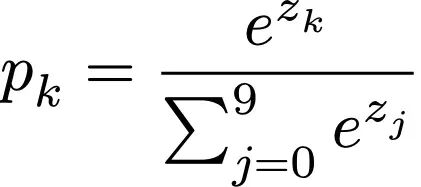 Softmax 概率
概率最大的那一类,就是模型的预测。
为什么用线性模型? 因为它参数极少(7850 个)、推理只需一次矩阵乘,在 150MHz 的 MCU 上也能毫秒级出结果,而且量化后和浮点结果完全一致——非常适合做 TinyML 入门和教学示范。
3. 怎么训练:交叉熵 + 梯度下降
训练目标是让「正确类的预测概率」尽量大。用交叉熵损失:
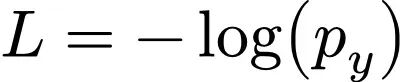 交叉熵损失
对损失求偏导,得到每个权重的梯度(这就是反向传播的起点):
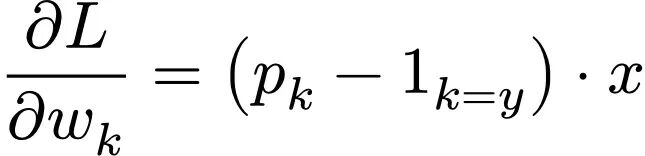 损失对权重的梯度
项目里用 mini-batch SGD(小批量随机梯度下降)更新:每轮随机抽一个 batch(默认 64 张),累加梯度后统一更新,学习率 0.05,跑 8 个 epoch。这套公式直接照搬经典教材,几十行就能写完。
4. 怎么部署:int8 量化数学
MCU 没有浮点单元(或浮点很慢),所以要把浮点权重压成 int8。本项目用的是对称 per-channel 量化,关键公式:
权重量化:
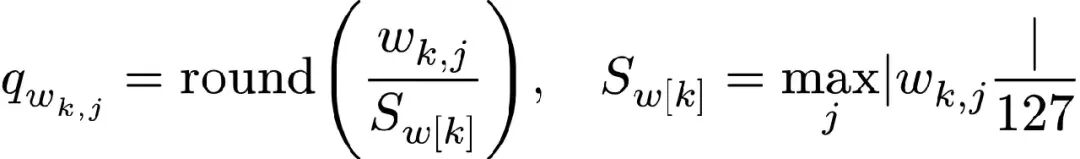 权重量化公式
输入量化:
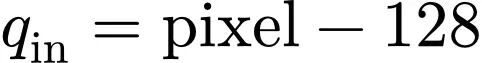 输入量化公式
再靠算子里的 input_offset = +128 加回来,等价于直接拿原始像素算。
输出重量化:用训练集校准出的全局缩放因子,把有效乘子编码成 CMSIS 风格的 (mult, shift) 定点数:
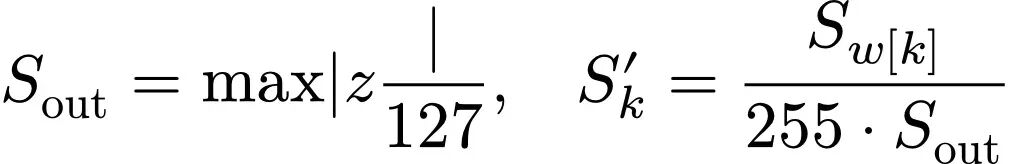 输出重量化公式
于是算子输出的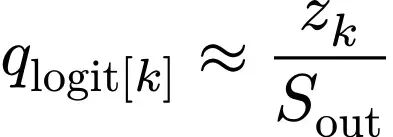 ,取 argmax 和浮点模型完全一样——也就是说,Softmax 只是用来「看概率」,判类结果量化前后零误差。
三、算法怎么实现的
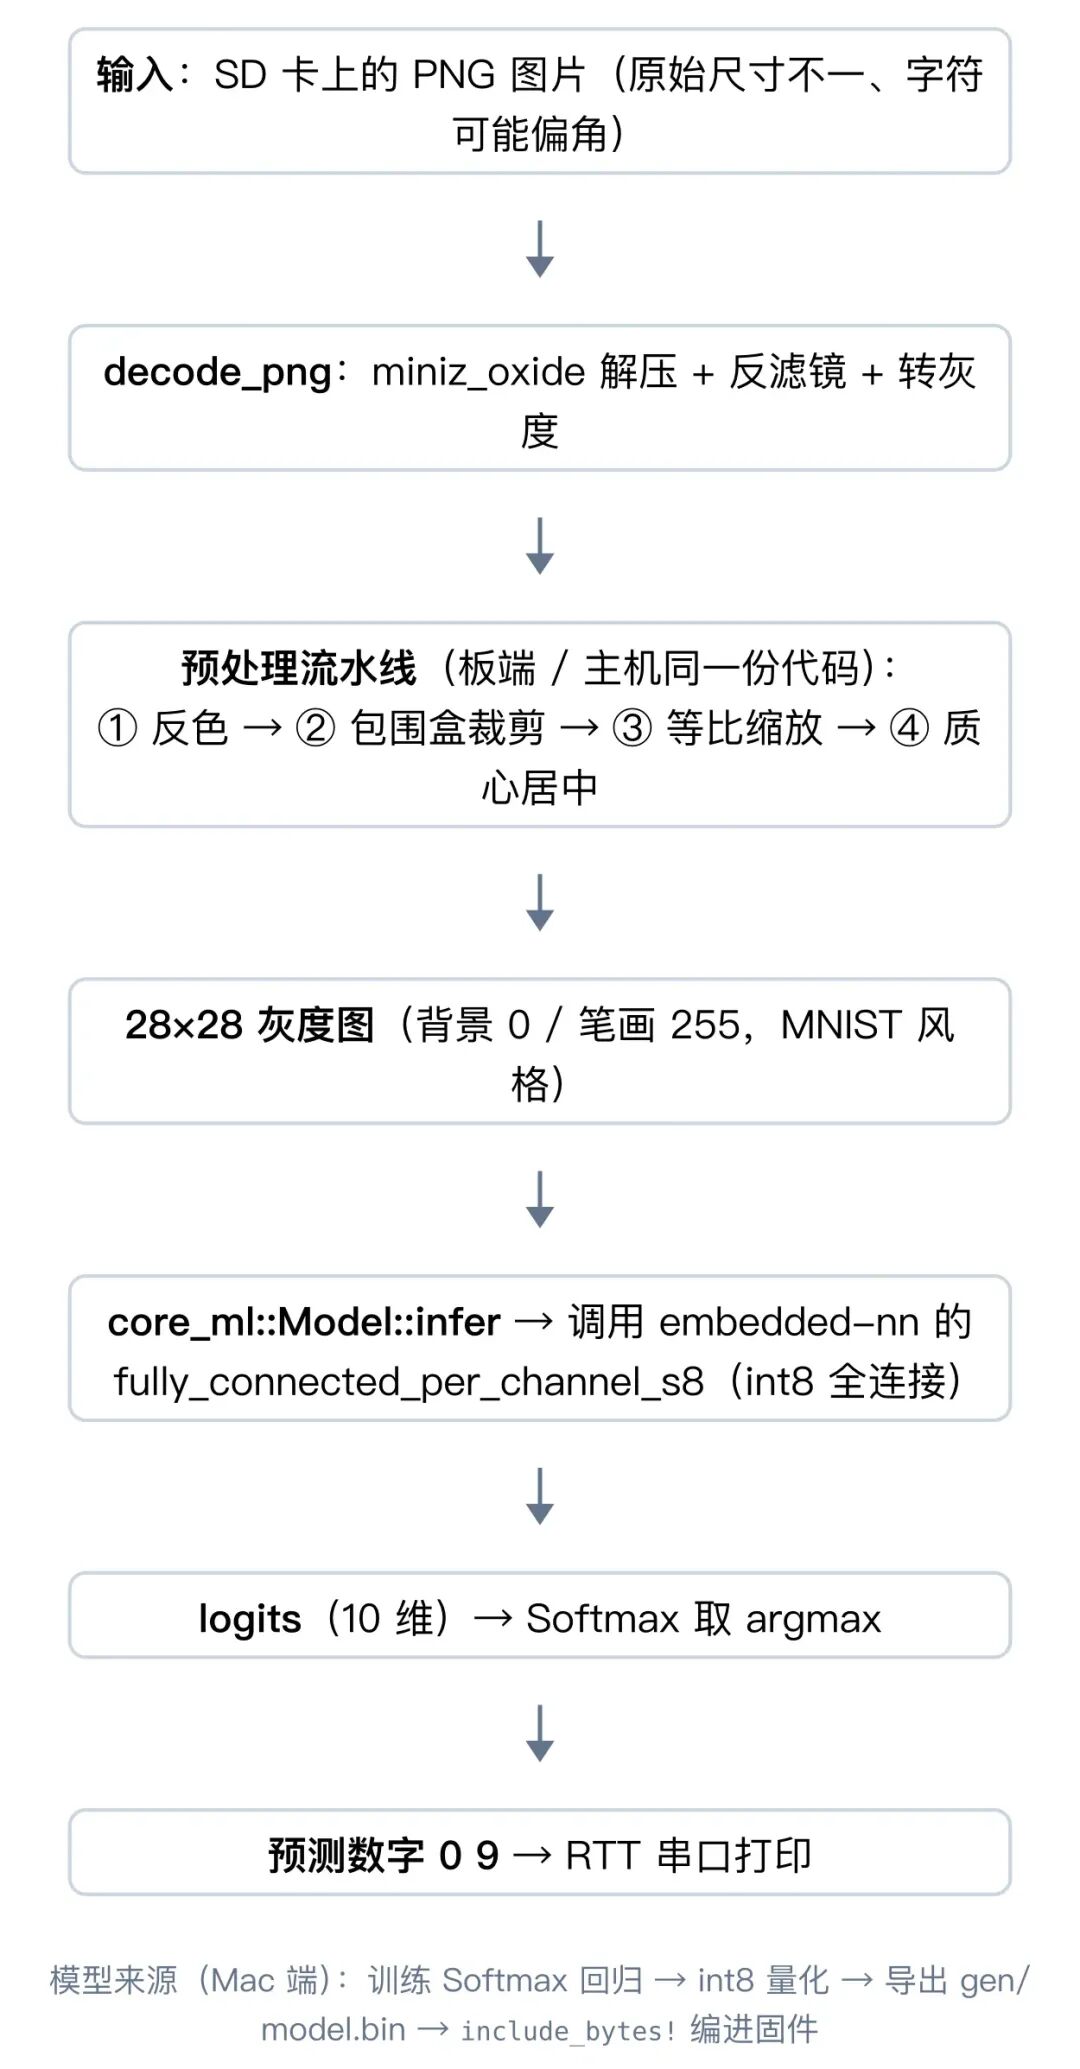 算法实现总览:从 SD 卡图片到预测结果的实现流水线(板端 / 主机共用预处理与算子)
1. 预处理流水线(板端 & 主机共用同一份代码)
原始图片尺寸不一、字符还可能偏在一角。预处理把它统一成 MNIST 风格(背景 0、笔画 255)的 28×28:
- 反色:白底黑字,反成黑底白字,和 MNIST 一致;
-
等比缩放:最长边缩到 20px(留 4px 边距),保持长宽比,双线性插值;
- 质心居中:把墨水重心放到 28×28 正中央,抵消手写位置抖动。
整段用纯定点/整数运算,跑在 no_std 下也不依赖堆。
2. 训练与量化(Mac 端)
host/ 工具做四件事:
- 从
data/by_field.zip(NIST SD19 手写数字,按书写者分组)抽样本,用和板端完全相同的preprocess 预处理; - 训练 Softmax 回归(默认每类 1500 训练 / 1000 测试,hsf_7 作书写者不相交的测试集,泛化性更严格);
- 把权重 int8 量化,写成
gen/model.bin(CML1 自定义格式); - 用板端同一个
embedded-nn 算子跑 int8 推理,对比浮点精度,证明量化误差可控。
3. 板端推理
固件把 model.bin 用 include_bytes! 编进 Flash,上电后用 Model::from_bytes 直接加载,无需任何解析开销:
let logits = model.infer(&img28);   // 调 embedded-nn 的 fully_connected_per_channel_s8
let pred   = model.predict(&img28); // logits 取 argmax → 0~9
关键设计:主机端和板端调用的是同一个算子。只要主机端验证过 from_bytes 加载的权重精度没问题,板端结果必然一致——我们可以在没有硬件的情况下,把整条量化链路验证干净。
四、测试的过程
1. 数据集与切分
- 数据:NIST SD19 手写数字(
by_field 按书写者分组); - 默认:每类 1500 张训练 / 1000 张测试;
-
测试集用
hsf_7(和训练集没有重叠书写者),比随机切分更能反映真实泛化能力。
2. 主机端验证
host 工具会打印下面这几组数字,肉眼确认链路正确:
- int8 测试准确率(与浮点差距通常只有零点几个百分点)
- 端到端回读准确率(字节 →
from_bytes → predict,即板端走的路径)
实际跑一次 host(8 个 epoch)的输出如下:
![host 端训练与量化验证的完整输出:8 个 epoch 训练曲线、浮点 / int8 测试准确率、权重导出]
3. 板端评测(SWM341)
把测试图片按 test/digit/N 放到 SD 卡(N 即数字类别,真值 = N − 30,例如 test/digit/32 里全是数字 2),固件会:
- 用 hadris-fat 挂载 FAT32(自动识别 MBR 分区偏移);
- 遍历每个数字子目录,逐张解码 → 预处理 → 推理;
- 每张打印
文件名 预测 X 真值 Y OK/X (N cyc); - 最后汇总总体准确率 + 每类准确率,以及平均推理周期数。
4. 测试图片展示
可以看到:1(97.4%)、
6(95.7%)、0(94.5%)这类笔画特征分明的数字最好认;而 8(83.7%)最容易和 0、3 混淆——这和人的直觉完全一致。要知道,这是一个没有隐藏层的线性模型,还是书写者不相交的严格测试集。
部分原始测试样本(取自 SD 卡 test/digit/ 目录,文件名 N_00000.png 中 N = 数字 + 30,即 30→0 … 39→9;左→右、上→下依次为数字 0~9):
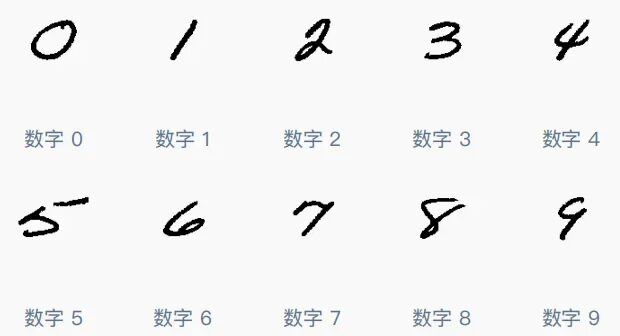 部分样本
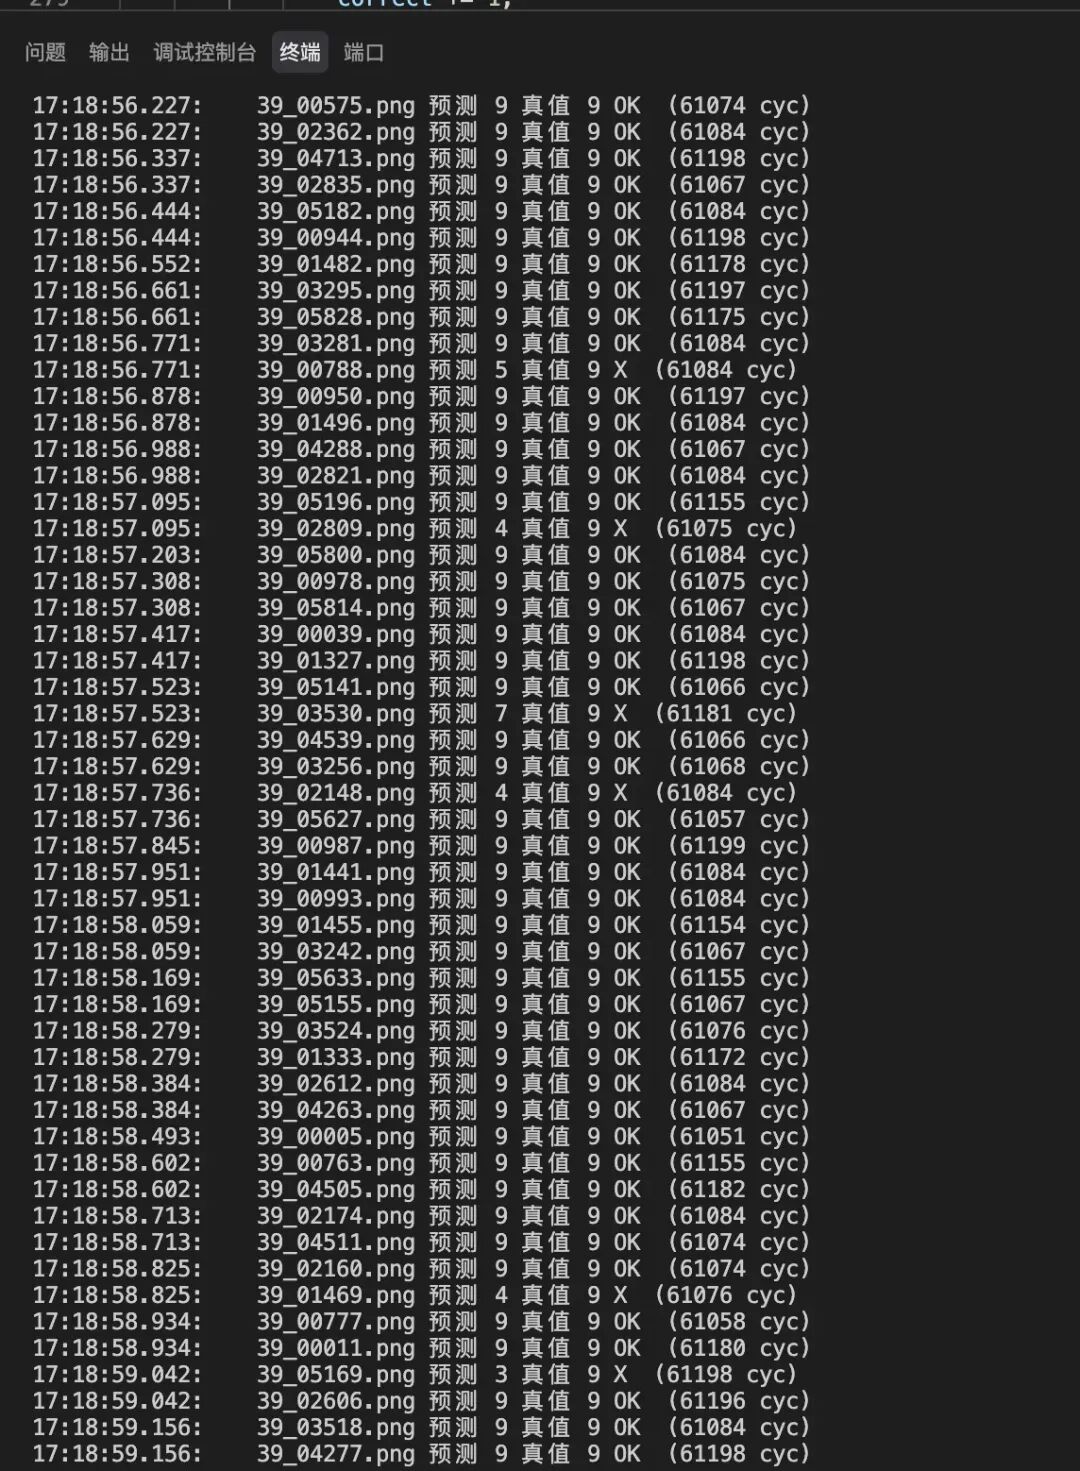
板端逐张评测日志(数字 9 的测试子目录,每行一条「预测 / 真值 / OK-X」,个别误判一目了然):
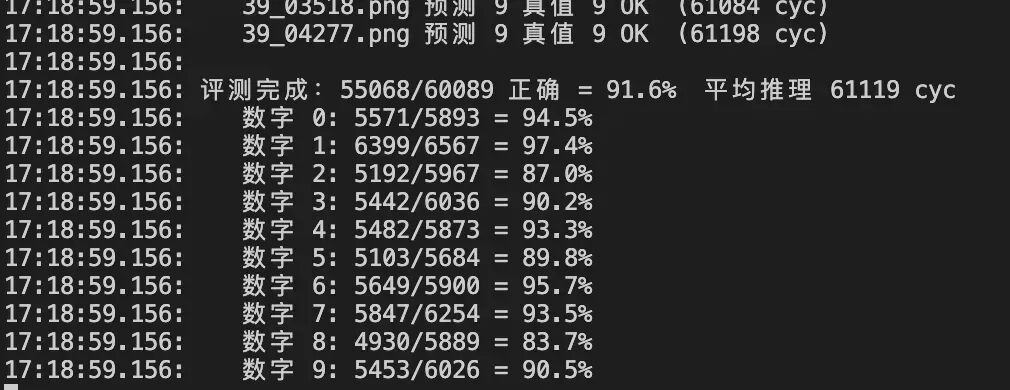 板端逐张评测日志(数字 9 的测试子目录,每行一条「预测 / 真值 / OK-X」,个别误判一目了然)
评测结果汇总:总体 55068/60089 = 91.6%,每类准确率,平均推理 61119 周期:
 评测结果汇总:总体 55068/60089 = 91.6%,每类准确率,平均推理 61119 周期
五、资源占用情况
在「算力 + 存储都极其有限」的 MCU 上,这个模型的 footprint 非常小:
| | |
|---|
| Flash(固件总大小) | | 含 SDIO、FAT、PNG 解码、NN、RTT 全部代码 |
| 模型权重文件 | | CML1 头 20 字节 + 784×10 int8 权重 + 偏置/乘子/移位 7960 字节 |
| 片内 SDRAM | | SWM341 内置封装,只用于文件系统堆消耗、PNG 解码和预处理的中间缓冲 |
| 推理算力 | | |
| 单张推理耗时 | | |
| 等效算力 | | |
几个直观结论:
- 模型权重文件只有 7980 字节(约 7.8KB),Flash 完全装得下,连外挂 Flash 都不需要;
- 一张图从读卡到出结果 不到半毫秒,实时性绰绰有余;
- 整条链路(含文件系统、图像解码)固件也只有
76KB,对 MCU 来说非常轻量。
六、总结与展望
这个项目展示了:机器学习不必是「高性能芯片 + 高主频」的专利。一个 150MHz 的国产单片机,用纯 Rust 裸机代码,就能完成「读 SD 卡图片 → 预处理 → int8 推理 → 出结果」的完整闭环,而且主机端和板端共用同一套算子,量化误差能在上板前就验证干净。
如果想进一步提升准确率,下一步自然是换成小型 CNN(比如 LeNet-5)——权重会大一些、推理慢一些,但对手写数字的识别率能明显上一个台阶,而这整套「训练→量化→板端验证」的工程框架完全可以直接复用。
后期计划增加 LVGL 图形界面,直接绘制手写数字,板端就能实时识别。也可以把训练数据换成其他分类任务测试(比如手势、符号、字母),只要是 10 类以内 的问题,这套流水线都能直接用。
代码整理后将开源,欢迎追更交流。如果你也想在自己的板子上跑 TinyML,不妨从这篇的「最小线性模型」起步。



