房价高是北漂们一直关心的话题,本文就对北京的二手房数据进行了分析。
本文主要分为两部分:Python爬取赶集网北京二手房数据,R对爬取的二手房房价做线性回归分析,适合刚刚接触Python&R的同学们学习参考。
Python爬取赶集网北京二手房数据
入门爬虫一个月,所以对每一个网站都使用了Xpath、Beautiful Soup、正则三种方法分别爬取,用于练习巩固。数据来源如下:
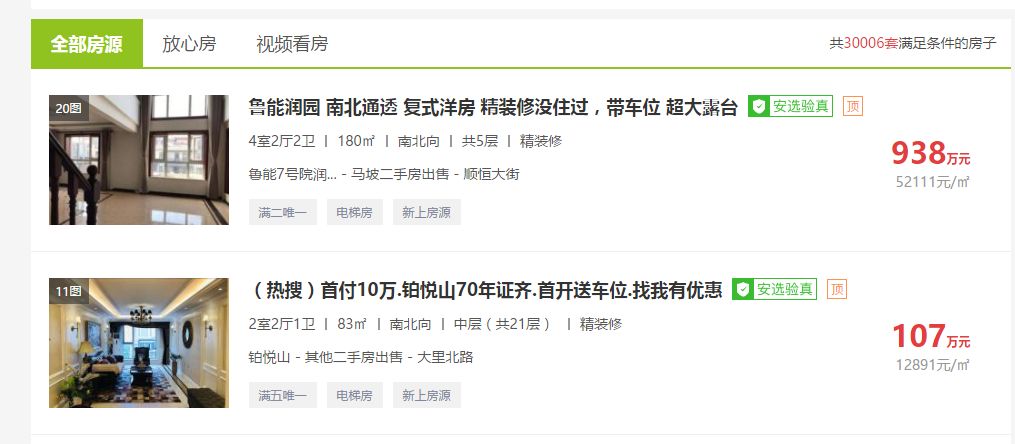
Xpath爬取:
这里主要解决运用Xpath如何判断某些元素是否存在的问题,比如如果房屋没有装修信息,不加上判断,某些元素不存在就会导致爬取中断。
import requests
from lxml import etree
from requests.exceptions import RequestException
import multiprocessing
import time
headers = {
'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/55.0.2883.87 Safari/537.36'}
def get_one_page(url):
try:
response = requests.get(url, headers=headers)
if response.status_code == 200:
return response.text
return None
except RequestException:
return None
def parse_one_page
(content):
try:
selector = etree.HTML(content)
ALL = selector.xpath('//*[@id="f_mew_list"]/div[6]/div[1]/div[3]/div[1]/div')
for div in ALL:
yield {
'Name': div.xpath('dl/dd[1]/a/text()')[0],
'Type': div.xpath('dl/dd[2]/span[1]/text()')[0],
'Area': div.xpath('dl/dd[2]/span[3]/text()')[0],
'Towards': div.xpath('dl/dd[2]/span[5]/text()')[0],
'Floor': div.xpath('dl/dd[2]/span[7]/text()')[0].strip().replace('\n', ""),
'Decorate': div.xpath('dl/dd[2]/span[9]/text()')[0],
'Address': div.xpath('dl/dd[3]//text()')[1]+div.xpath('dl/dd[3]//text()')[3].replace('\n','')+div.xpath('dl/dd[3]//text()')[4].strip(),
'TotalPrice': div.xpath('dl/dd[5]/div[1]/span[1]/text()')[0] + div.xpath('dl/dd[5]/div[1]/span[2]/text()')[0],
'Price': div.xpath('dl/dd[5]/div[2]/text()')[0]
}
if div['Name','Type','Area','Towards','Floor','Decorate','Address'
,'TotalPrice','Price'] == None:
return None
except Exception:
return None
def main():
for i in range(1, 500):
url = 'http://bj.ganji.com/fang5/o{}/'.format(i)
content = get_one_page(url)
print('第{}页抓取完毕'.format(i))
for div in parse_one_page(content):
print(div)
if __name__ == '__main__':
main()
Beautiful Soup爬取:
import requests
import re
from requests.exceptions import RequestException
from bs4 import BeautifulSoup
import csv
import time
headers = {'User-Agent':'Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/55.0.2883.87 Safari/537.36'}
def get_one_page(url):
try:
response = requests.get(url,headers = headers)
if response.status_code == 200:
return response.text
return None
except RequestException:
return None
def
parse_one_page(content):
try:
soup = BeautifulSoup(content,'html.parser')
items = soup.find('div',class_=re.compile('js-tips-list'))
for div in items.find_all('div',class_=re.compile('ershoufang-list')):
yield {
'Name':div.find('a',class_=re.compile('js-title')).text,
'Type': div.find('dd', class_=re.compile('size')).contents[1].text,
'Area':div.find('dd',class_=re.compile('size')).contents[5].text,
'Towards':div.find('dd',class_=re.compile('size')).contents[9].text,
'Floor':div.find('dd',class_=re.compile('size')).contents[13].text.replace('\n',''),
'Decorate':div.find('dd',class_=re.compile('size')).contents[17].text,
'Address':div.find('span',class_=re.compile('area')).text.strip().replace(' ','').replace('\n',''),
'TotalPrice':div.find('span',class_=re.compile('js-price')).text+div.find('span',class_=re.compile('yue')).text,
'Price':div.find('div',class_=re.compile('time')).text
}
if div['Name', 'Type', 'Area', 'Towards', 'Floor', 'Decorate', 'Address', 'TotalPrice', 'Price'] == None:
return None
except Exception:
return None
def main():
for i in range(1,50):
url = 'http://bj.ganji.com/fang5/o{}/'.format(i)
content = get_one_page(url)
print('第{}页抓取完毕'.format(i))
for div in parse_one_page(content):
print(div)
with open('Data.csv', 'a', newline='') as f:
fieldnames = ['Name', 'Type', 'Area', 'Towards', 'Floor', 'Decorate', 'Address', 'TotalPrice', 'Price']
writer = csv.DictWriter(f, fieldnames=fieldnames)
writer.writeheader()
for item in parse_one_page(content):
writer.writerow(item)
time.sleep(3)
if __name__=='__main__':
main()
正则爬取:我研究了好久,还是没有解决。
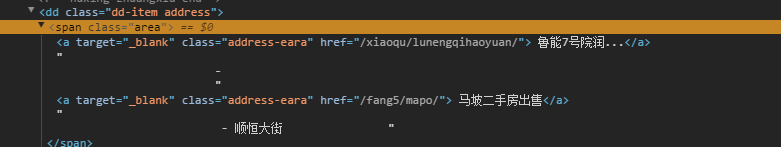
这一过程中容易遇见的问题有:
import os
print(os.getcwd())
os.chdir('e:\\workpython')
print(os.getcwd())
e:\workpython
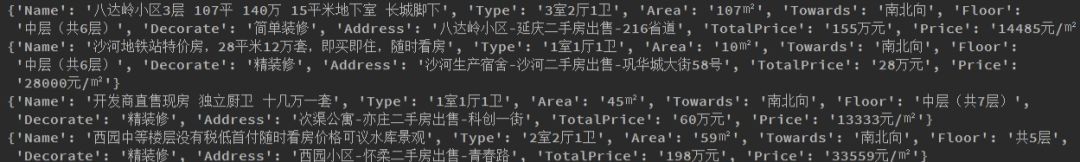
Pycharm中打印如下:
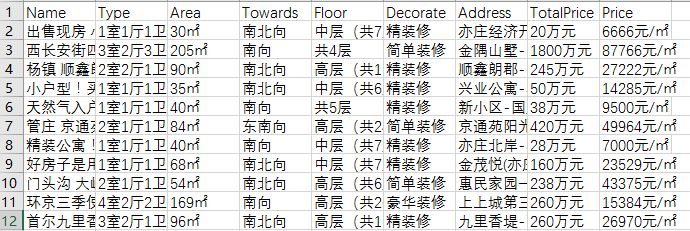
将字典循环直接写入CSV效果如下:
R对爬取的二手房房价做一般线性回归分析
下面我们用R对抓取的赶集网北京二手房数据做一些简单的分析。
数据的说明
Name:主要是商家的醒目标题,不具备分析参考意义
Type:卧室数、客厅数、卫生间数
Area:面积(平方米)
Towards:朝向
Floor:楼层
Decorate:装修情况,如精装修、简单装修、毛坯房
Address:二手房的地址
TotalPrice:总价
Price:均价(元/平方米)
数据清洗
data
DATA#将Name和Address两列去掉
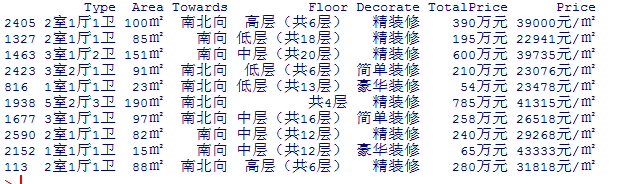
DATA[sample(1:nrow(DATA),size=10),]

library(tidyr)
library(stringr)
DATA=separate(data=DATA,col=Type,into = c("Bedrooms","Halls"),sep="室")
DATA=separate(data=DATA,col=Halls,into = c("Halls","Toilet"),sep="厅")
DATA$Toilet$Toilet,"卫","")
DATA$Halls$Halls,"卫","")
newdatawhich(DATA$Toilet %in% NA),2]
newdata
DATA[which(DATA$Toilet %in% NA),2]DATA[which(DATA$Toilet %in% NA),3]colSums(DATA=="")
Bedrooms Halls Toilet Area Towards Floor Decorate
0 0 2 0 0 0 0
TotalPrice Price
0 0
DATA$Toilet[DATA$Toilet == ""]

##这里将Area后的㎡去掉
DATA$Area$Area,"㎡","")
##查看Towards的类型
table(DATA$Towards)
Towards 北向 东北向 东南向 东西向 东向 南北向 南向 西北向
51 25 23 50 65 32 1901 678 38
西南向 西向
28 26
##将Floor信息带括号的全部去除
DATA$Floor$Floor,"[(].*[)]","")
#查看Floor的类别信息
低层 地下 高层 共1层 共2层 共3层 共4层 共5层 中层
632 32 790 36 61 101 68 130 1016
#分别将TotalPrice和Price后面的万元、元/㎡去掉
DATA$TotalPrice$TotalPrice,"万元","")
DATA$Price$Price,"元/㎡","")
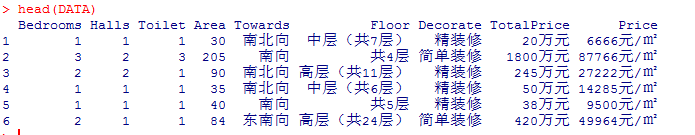
head(DATA)
DATA$Bedroomsas.factor(DATA$Bedrooms)
DATA$Hallsas.factor(DATA$Halls)
DATA$Toiletas.factor(DATA$Toilet)
DATA$Areaas.numeric(DATA$Area)
DATA$TotalPriceas.numeric(DATA$TotalPrice)
DATA$Priceas.numeric(DATA$Price)
DATA$Towardsas.factor(DATA$Towards)
DATA$Decorateas.factor(DATA$Decorate)
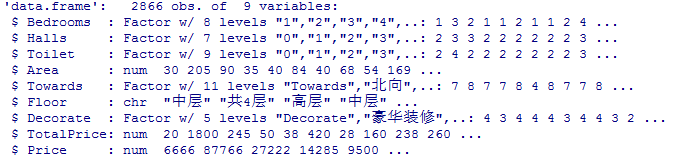
str(DATA)
以上数据清洗完毕。

描述性分析
这部分的主要思路是探究单个自变量对因变量的影响,对房价的影响因素进行模拟探究之前,首先对各变量进行描述性分析,以初步判断房价的影响因素。这里探究各个因素对总价影响。
探究Bedrooms与TotalPrice的关系
table(DATA$Bedrooms)
1 2 3 4 5 6 7 9
541 1225 779 193 102 20 5 1
DATAwhich(DATA$Bedrooms %in% "6")),]
DATAwhich(DATA$Bedrooms %in% "7")),]
DATAwhich(DATA$Bedrooms %in% "9")),]
table(DATA$Bedrooms)
1 2 3 4 5
541 1225 779 193 102
library(ggplot2)
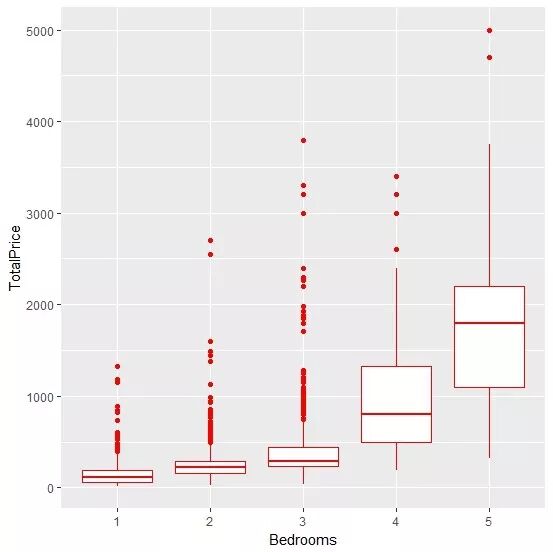
ggplot(DATA,aes(x=Bedrooms,y=TotalPrice))+geom_boxplot(col="red")
DATA$Bedroomsas.numeric(DATA$Bedrooms)
DATA$Bedrooms[DATA$Bedrooms=='1']"A"
DATA$Bedrooms[DATA$Bedrooms=='2']"A"
DATA$Bedrooms[DATA$Bedrooms=='3']"A"
DATA$Bedrooms[DATA$Bedrooms=='4']"B"
DATA$Bedrooms[DATA$Bedrooms=='5']"C"
不同卧室数,TotalPrice不同。且随着卧室数的增多,总价越高,符合大众的认知。
探究Halls与TotalPrice的关系
table(DATA$Halls)
0 1 2 3 4 5 9
20 1674 1050 77 18 1 0
DATAwhich(DATA$Halls %in% "5")),]
table(DATA$Halls)
0 1 2 3 4 5 9
20 1674 1050 77 18 0 0
ggplot(DATA,aes(x=Halls,y=TotalPrice))+geom_boxplot(col="red")
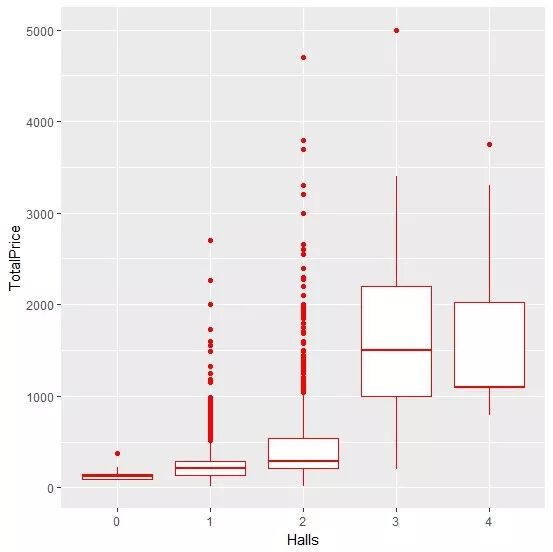
客厅数为3时候总价最高,客厅数为0、1和2的时候总价低于客厅数3和客厅数4。
探究Toilet与TotalPrice的关系
table(DATA$Toilet)
0 1 2 3 4 5 6 7 9
2 2142 470 116 74 26 7 2 0
DATAwhich(DATA$Toilet %in% "0")),]
DATAwhich(DATA$Toilet %in% "6")),]
DATAwhich(DATA$Toilet %in% "7")),]
table(DATA$Toilet)
0 1 2 3 4 5 6 7 9
0 2142 470 116 74 26 0 0 0
ggplot(DATA,aes(x=Toilet,y=TotalPrice))+geom_boxplot(col="red")
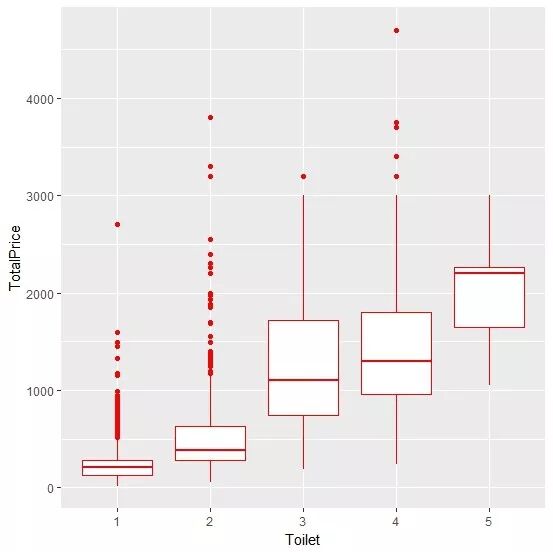
一般卧室数越多,卫生间数也越多,即卫生间数越多,总价越高。
探究Area与TotalPrice的关系
ggplot(DATA, aes(x=Area, y=TotalPrice)) + geom_point(col='red')

这个完全符合住房面积越大,总价越高。
探究Towards与TotalPrice的关系
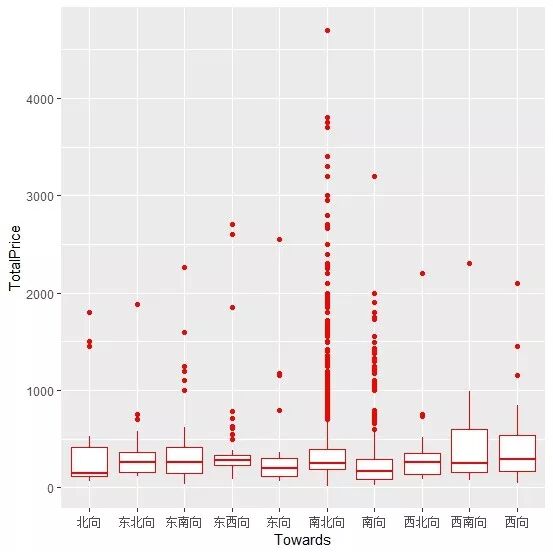
ggplot(DATA,aes(x=Towards,y=TotalPrice))+geom_boxplot(col="red")
探究Floor与TotalPrice的关系
ggplot(DATA,aes(x=Floor,y=TotalPrice))+geom_boxplot(col="red")

图中信息显示楼层一共只有1、2、3、地下的总价较高。
探究Decorate与TotalPrice的关系
ggplot
(DATA,aes(x=Decorate,y=TotalPrice))+geom_boxplot(col="red")
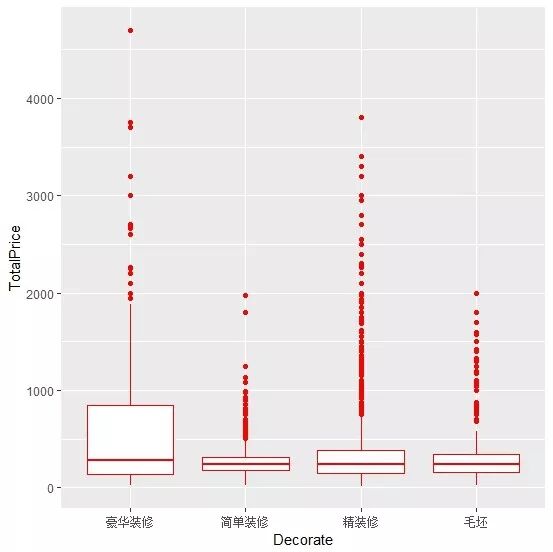
不同装修信息对总价影响较小。

模型建立
fit summary(fit)
Call:
lm(formula = TotalPrice ~ Bedrooms + Halls + Toilet + Area +
Towards + Floor + Decorate, data = DATA)
Residuals:
Min 1Q Median 3Q Max
-1330.80 -103.49 -21.41 63.88 2961.59
Coefficients:
Estimate Std. Error t value Pr(>|t|)
(Intercept) -112.7633 88.3010 -1.277 0.201697
Bedrooms2 -43.5934 16.2533 -2.682 0.007359 **
Bedrooms3 -82.6565 20.7641 -3.981 7.04e-05 ***
Bedrooms4 -63.3096 34.9521 -1.811 0.070198 .
Bedrooms5 79.0618 54.0763 1.462 0.143842
Halls1 -5.0663 64.2764 -0.079 0.937182
Halls2 -53.8905 65.4427 -0.823 0.410307
Halls3 -303.9750 79.2280
-3.837 0.000127 ***
Halls4 -528.5427 104.0849 -5.078 4.07e-07 ***
Toilet2 112.9566 19.1171 5.909 3.87e-09 ***
Toilet3 543.7304 38.8056 14.012 2e-16 ***
Toilet4 735.1894 55.0977 13.343 2e-16 ***
Toilet5 338.7906 84.2851 4.020 5.98e-05 ***
Area 5.1091 0.1619 31.557 2e-16 ***
Towards东北向 138.9088 79.3817 1.750 0.080248 .
Towards东南向 187.1895 68.5388 2.731 0.006351 **
Towards东西向 176.3055 65.8384 2.678 0.007453 **
Towards东向 210.9435 73.2744 2.879 0.004022 **
Towards南北向 75.7831 57.1199 1.327 0.184704
Towards南向 60.1949 56.9678 1.057 0.290763
Towards西北向 75.4326 71.1415 1.060 0.289091
Towards西南向 169.8106 75.9626 2.235
0.025467 *
Towards西向 234.0816 76.5585 3.058 0.002253 **
Floor地下 -812.3578 63.3277 -12.828 2e-16 ***
Floor高层 12.3525 14.2466 0.867 0.385991
Floor共1层 -313.7278 52.1342 -6.018 2.00e-09 ***
Floor共2层 -453.3692 41.6829 -10.877 2e-16 ***
Floor共3层 -601.7032 44.3336 -13.572 2e-16 ***
Floor共4层 -183.7866 36.3396 -5.057 4.52e-07 ***
Floor共5层 -41.4184 25.7922 -1.606 0.108419
Floor中层 -1.7223 13.5961 -0.127 0.899204
Decorate简单装修 -63.1591 22.0584 -2.863 0.004224 **
Decorate精装修 -49.3276 19.8544 -2.484 0.013033 *
Decorate毛坯 -157.0299 24.3012 -6.462 1.22e-10 ***
---
Signif. codes: 0 ‘***’ 0.001 ‘**’ 0.01 ‘*’
0.05 ‘.’ 0.1 ‘ ’ 1
Residual standard error: 265.5 on 2794 degrees of freedom
Multiple R-squared: 0.6852, Adjusted R-squared: 0.6815
F-statistic: 184.3 on 33 and 2794 DF, p-value: 2.2e-16
模型的F检验拒绝原假设,说明建立的模型是显著的;Ajusted R-squared为0.6815,模型的拟合程度尚可接受。
作者:徐涛,19年应届毕业生,专注于珊瑚礁研究,喜欢用R各种清洗数据,知乎用户@parkson。
声明:本文为公众号数据森麟投稿,版权归对方所有。
CSDN 公众号秉持着「与千万技术人共成长」理念,不仅以「极客头条」、「畅言」栏目在第一时间以技术人的独特视角描述技术人关心的行业焦点事件,更有「技术头条」专栏,深度解读行业内的热门技术与场景应用,让所有的开发者紧跟技术潮流,保持警醒的技术嗅觉,对行业趋势、技术有更为全面的认知。
如果你有优质的文章,或是行业热点事件、技术趋势的真知灼见,或是深度的应用实践、场景方案等的新见解,欢迎联系 CSDN 投稿,联系方式:微信(guorui_1118,请备注投稿+姓名+公司职位),邮箱(guorui@csdn.net)。
————— 推荐阅读 —————