(点击上方公众号,可快速关注)
转自:量子位
一直以来,PyTorch就以简单又好用的特点,广受AI研究者的喜爱。但是,一旦任务复杂化,就可能会发生一系列错误,花费的时间更长。于是,就诞生了这样一个“友好”的PyTorch Lightning。
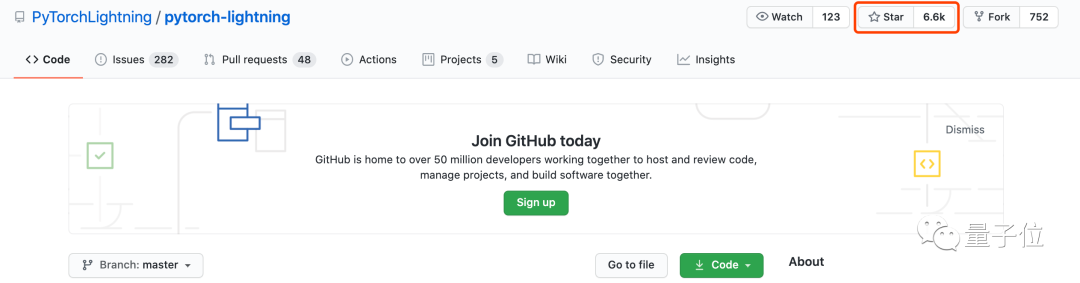
直接在GitHub上斩获6.6k星。
首先,它把研究代码与工程代码相分离,还将PyTorch代码结构化,更加直观的展现数据操作过程。
这样,更加易于理解,不易出错,本来很冗长的代码一下子就变得轻便了,对AI研究者十分的友好。
话不多说,我们就来看看这个轻量版的“PyTorch”。
关于Lightning
Lightning将DL/ML代码分为三种类型:研究代码、工程代码、非必要代码。
针对不同的代码,Lightning有不同的处理方式。
这里的研究代码指的是特定系统及其训练方式,比如GAN、VAE,这类的代码将由LightningModule直接抽象出来。
我们以MNIST生成为例。
l1 = nn.Linear(...)
l2 = nn.Linear(...)
decoder = Decoder()
x1 = l1(x)
x2 = l2(x2)
out = decoder(features, x)
loss = perceptual_loss(x1, x2, x) + CE(out, x)
而工程代码是与培训此系统相关的所有代码,比如提前停止、通过GPU分配、16位精度等。
我们知道,这些代码在大多数项目中都相同,所以在这里,直接由Trainer抽象出来。
model.cuda(0)
x = x.cuda(0)

distributed = DistributedParallel(model)

with gpu_zero:
download_data()

dist.barrier()
剩下的就是非必要代码,有助于研究项目,但是与研究项目无关,可能是检查梯度、记录到张量板。此代码由Callbacks抽象出来。
# log samples
z = Q.rsample()
generated = decoder(z)
self.experiment.log( images , generated)
此外,它还有一些的附加功能,比如你可以在CPU,GPU,多个GPU或TPU上训练模型,而无需更改PyTorch代码的一行;你可以进行16位精度训练,可以使用Tensorboard的五种方式进行记录。
这样说,可能不太明显,我们就来直观的比较一下PyTorch与PyTorch Lightning之间的差别吧。
PyTorch与PyTorch Lightning比较
直接上图。
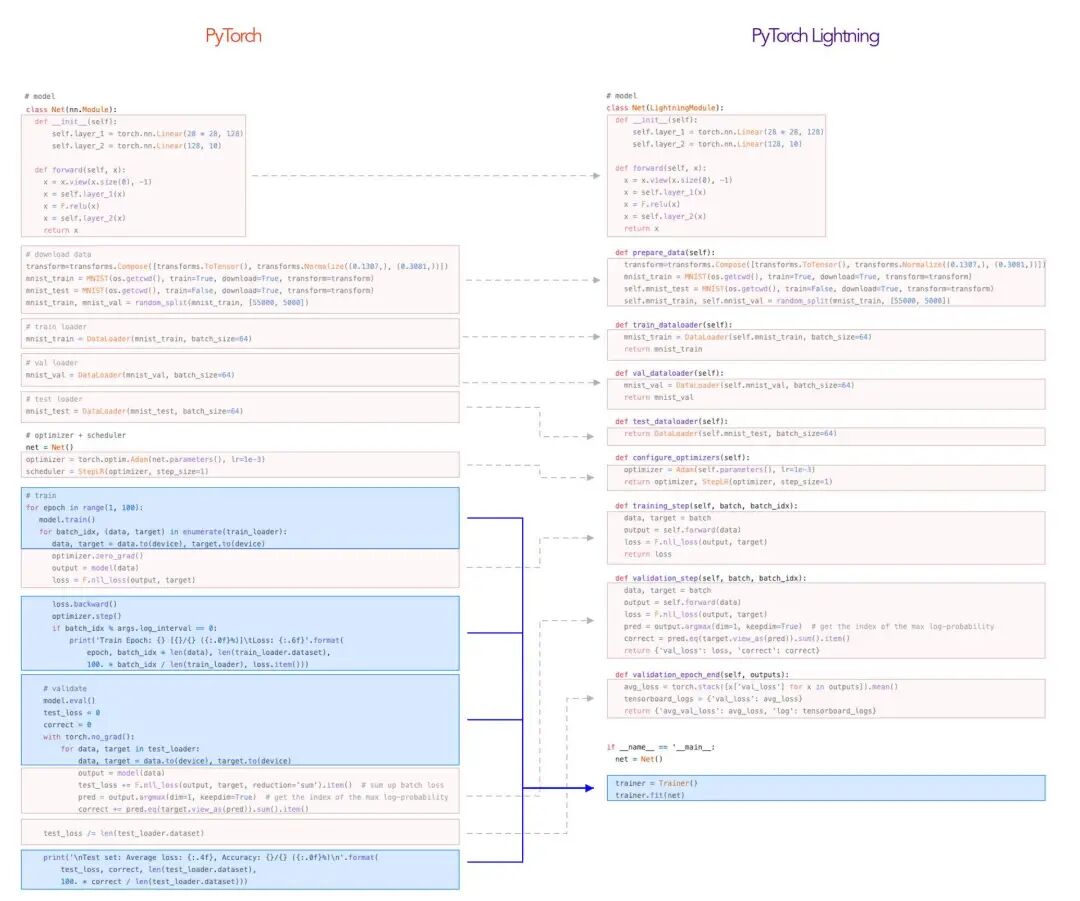
我们就以构建一个简单的MNIST分类器为例,从模型、数据、损失函数、优化这四个关键部分入手。
模型
首先是构建模型,本次设计一个3层全连接神经网络,以28×28的图像作为输入,将其转换为数字0-9的10类的概率分布。
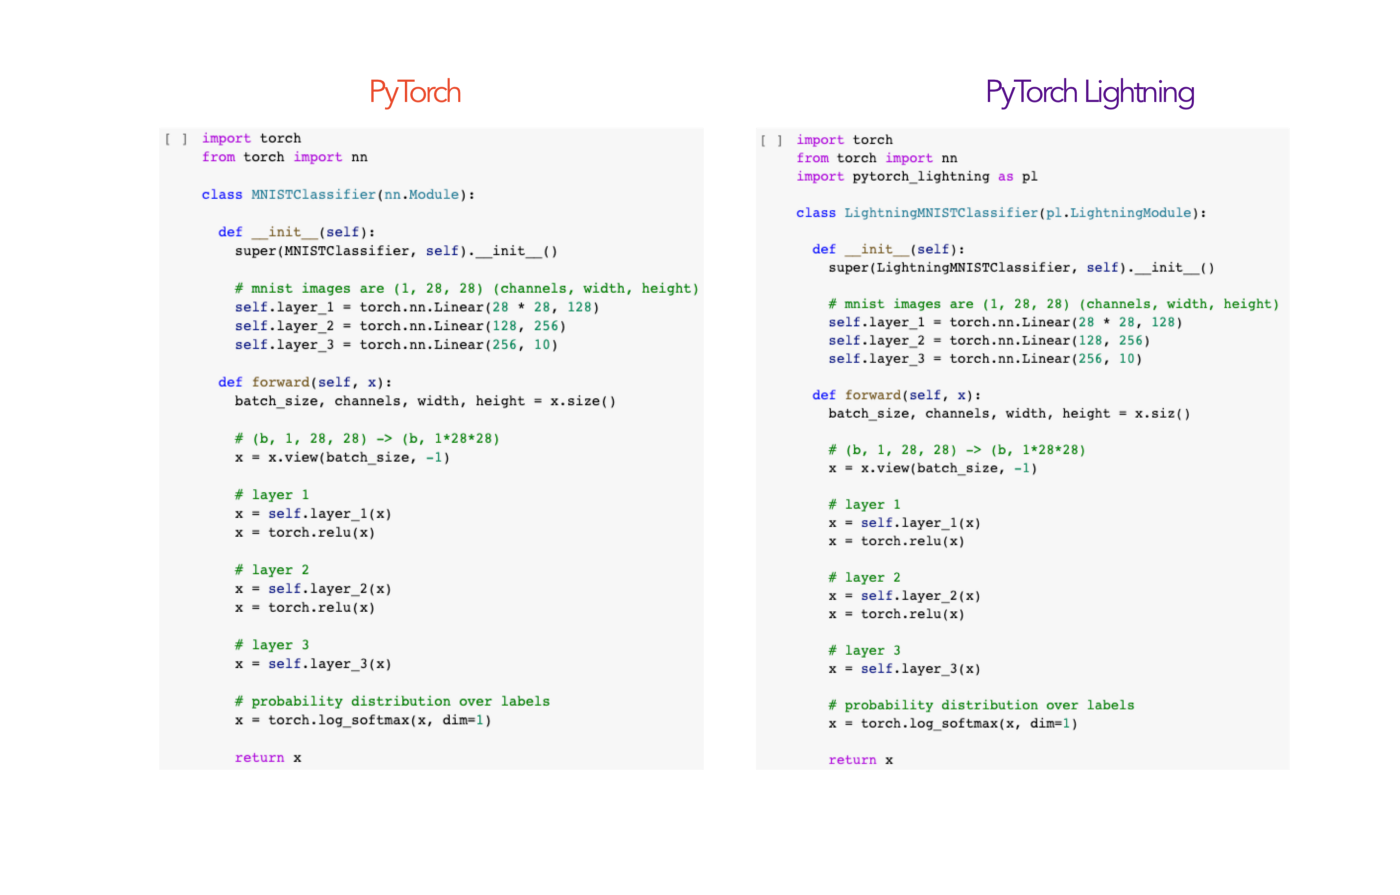
两者的代码完全相同。意味着,若是要将PyTorch模型转换为PyTorch Lightning,我们只需将nn.Module替换为pl.LightningModule
也许这时候,你还看不出这个Lightning的神奇之处。不着急,我们接着看。
数据
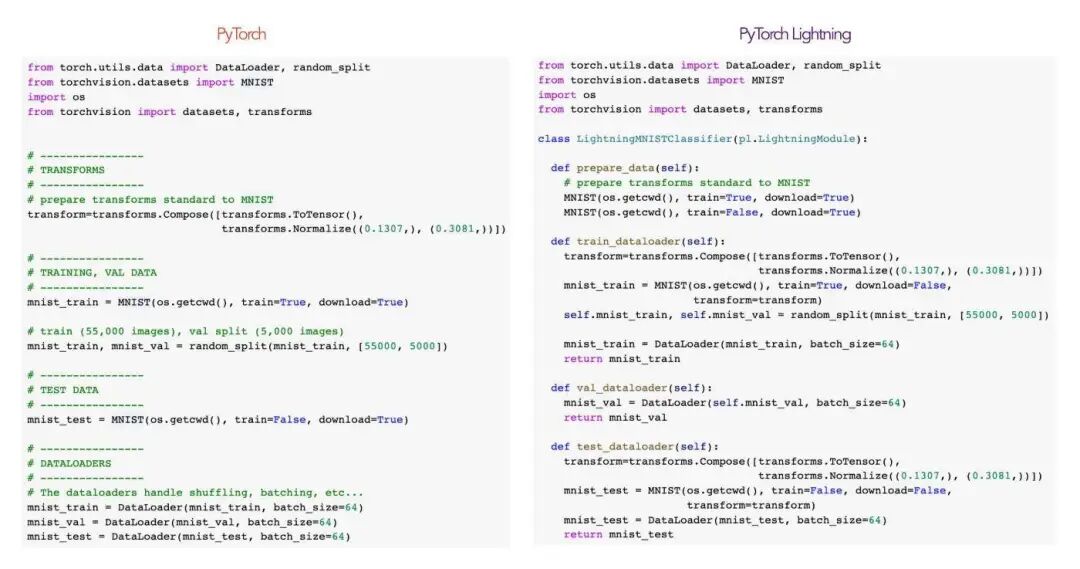
接下来是数据的准备部分,代码也是完全相同的,只不过Lightning做了这样的处理。
它将PyTorch代码组织成了4个函数,prepare_data、train_dataloader、val_dataloader、test_dataloader
prepare_data
这个功能可以确保在你使用多个GPU的时候,不会下载多个数据集或者对数据进行多重操作。这样所有代码都确保关键部分只从一个GPU调用。
这样就解决了PyTorch老是重复处理数据的问题,这样速度也就提上来了。
train_dataloader, val_dataloader, test_dataloader
每一个都负责返回相应的数据分割,这样就能很清楚的知道数据是如何被操作的,在以往的教程里,都几乎看不到它们的是如何操作数据的。
此外,Lightning还允许使用多个dataloaders来测试或验证。
优化
接着就是优化。
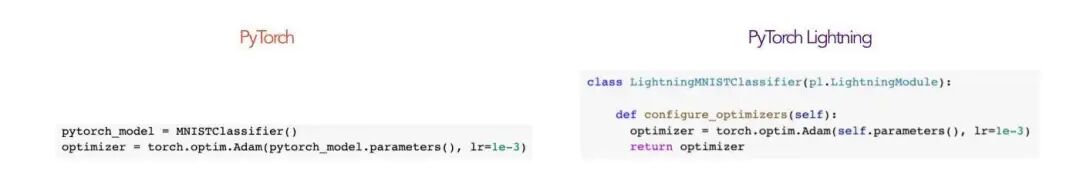
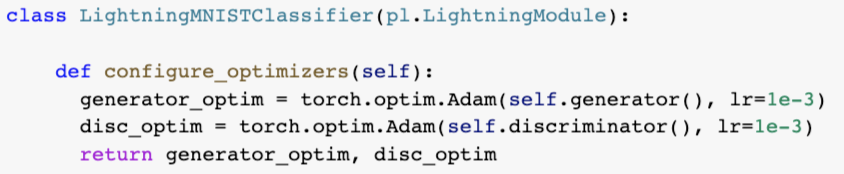
不同的是,Lightning被组织到配置优化器的功能中。如果你想要使用多个优化器,则可同时返回两者。
损失函数
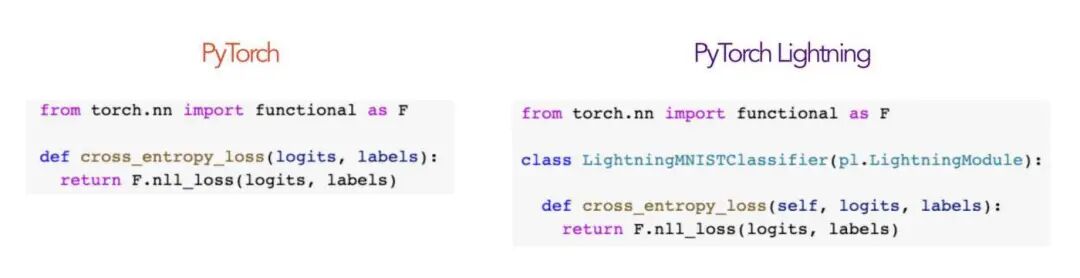
对于n向分类,我们要计算交叉熵损失。两者的代码是完全一样的。
此外,还有更为直观的——验证和训练循环。
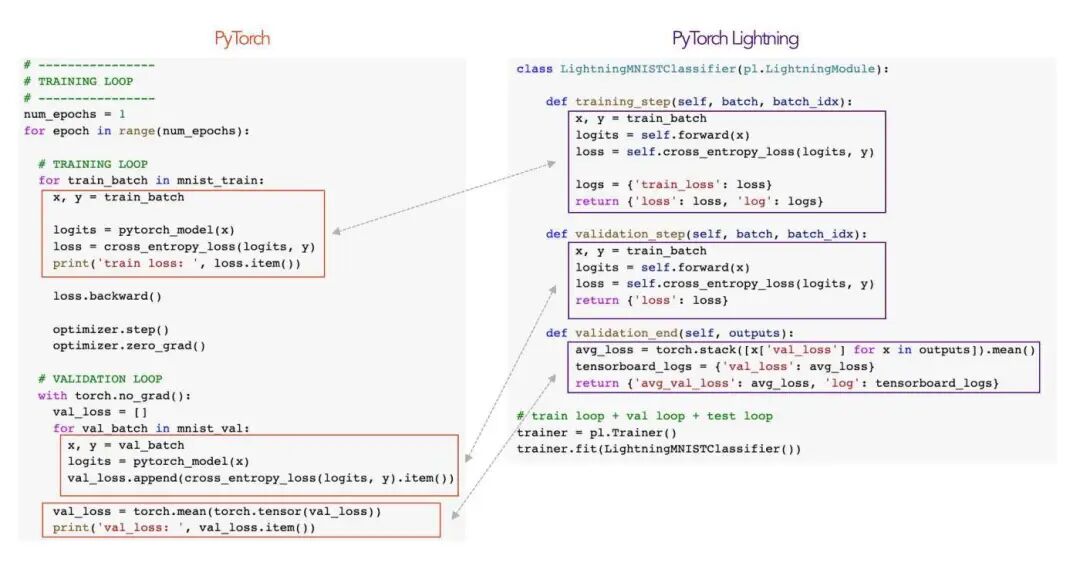
在PyTorch中,我们知道,需要你自己去构建for循环,可能简单的项目还好,但是一遇到更加复杂高级的项目就很容易翻车了。
而Lightning里这些抽象化的代码,其背后就是由Lightning里强大的trainer团队负责了。
PyTorch Lightning安装教程
看到这里,是不是也想安装下来试一试。
PyTorch Lightning安装十分简单。
代码如下:
conda activate my_env
pip install pytorch-lightning
或在没有conda环境的情况下,可以在任何地方使用pip。
代码如下:
pip install pytorch-lightning
创建者也有大来头
William Falcon,PyTorch Lightning 的创建者,现在在纽约大学的人工智能专业攻读博士学位,在《福布斯》担任AI特约作者。
2018年,从哥伦比亚大学计算机科学与统计学专业毕业,本科期间,他还曾辅修数学。
现在已获得Google Deepmind资助攻读博士学位的奖学金,去年还收到Facebook AI Research实习邀请。
前不久,华尔街日报就曾还曾提到这个团队,他们正在研究呼吸系统疾病与呼吸模式之间的联系。可能会应用到的场景,是通过电话在诊断新冠症状。目前,该团队还处在数据收集阶段。
果然,优秀的人,干什么都是优秀的。叹气……
怎么样,是不是想试一试?赶紧戳下方链接下载来看看吧!
上手传送门
https://github.com/PyTorchLightning/pytorch-lightning
https://pytorch-lightning.readthedocs.io/en/latest/index.html
创建者个人网站:
https://www.williamfalcon.com/
- EOF -
看完本文有收获?请转发分享给更多人
关注「大数据与机器学习文摘」,成为Top 1%