视频目标检测是为了解决每一个视频帧中出现的目标如何进行定位和识别的问题。相比于图像目标检测,视频具有高冗余度的特性,其中包含了大量的时空局部信息。随着深度卷积神经网络在静态图像目标检测领域的迅速普及,在性能上相较于传统方法显示出了非常大的优越性,并逐步在基于视频的目标检测任务上也发挥了应有的作用。但现有的视频目标检测算法仍然面临改进与优化主流目标检测算法的性能、保持视频序列的时空一致性、检测模型轻量化等关键技术的挑战。针对上述问题和挑战,本文在调研大量文献的基础上系统地对基于深度学习的视频目标检测算法进行了总结。从基于光流、检测等基础方法对这些算法进行了分类,从骨干网络、算法结构、数据集等角度细致探究了这些方法,结合在ImageNet VID等数据集上的实验结果,分析了该领域具有代表性算法的性能优势和劣势,以及算法之间存在的联系,对视频目标检测中待解决的问题与未来研究方向进行了阐述和展望。视频目标检测已成为众多的计算机视觉领域学者追逐的热点,将来会有更加高效,精度更高的算法被相继提出,其发展方向也会越来越好。
Hinton[1]在2015年提出了通过神经网络
对多媒体数据中的高级特征进行自动学习,
自此,深度学习在包括分类、分割、检测等
计算机视觉(Computer Vision,CV)任务中得
到了广泛的应用。基于深度学习的目标检测
也成为了非常热门的研究领域[2-5]。作为计算
机视觉中的基础任务,使得场景分析和理解
能够顺利进行,而视频中的目标检测则更加
贴近真实场景的任务需求,如视频监控,自
动驾驶,无人机导航[6-7]等。与静态图像的目
标检测不同,由于视频中的目标是不断变化
的,而这些变化对检测的效果会产生非常重
要的影响,这是解决视频目标检测问题的重
点也是难点。
传统的特征判别方法有以下四种:方向
梯度直方图( Histogram of Oriented Gradient,
HOG)[8]、尺度不变特征变换( Scale-Invariant
Feature Transform,SIFT)[9]、滑动窗口[8]和
局部形变模型(Deformable Part Model, DPM)
[10]及其扩展。在目标检测中,因传统的滑动
窗口方法会消耗很大的计算资源,后来逐步
被候选窗口所代替,而目前较为通用的方法
为选择搜索(Selective Search)[11]和边缘窗口
(Edge-Box)[12],但其速度依然很慢。
在网络方面,随着深度学习的不断发展,
神经网络迅速涵盖了计算机视觉的各个领
域,通过增加网络的层数,使得神经网络的
解析能力更强。在数据方面,ImageNet[13]、
MS COCO(Microsoft Common Objects in
Context)
[14]等大型数据集的建立促使网络越
深性能越好成为了可能。由于当时算力的限
制,只有七层的卷积神经网络 AlexNet[15]在
2012 年的 ILSVRC(ImageNet Large Scale
Visual Recognition Challenge)图像分类大赛
中以高出第二名十多个百分点的绝对优势
摘得桂冠,其性能也在检测,识别等领域得
到了广泛验证。随着算力资源的不断发展,
相继出现了更深层次的网络,如 VGG[16]、GoogleNet[17-20]以及 ResNet[21],使得网络的
性能和各类任务的准确性大幅提升。与此同时,目标检测领域也开始有了长
足的进步,Girshick 等人[11]首次将基于区域
的卷积神经网络(Region-based Convolutional
Neural Network,R-CNN)用于目标检测,目
标检测的精确度有了质的提升,R-CNN 主
要由产生候选窗口、特征提取、SVM(Support
Vector Machines)分类以及窗口回归这三部
分组成。
R-CNN 通过选择搜索生成候选框,再
将其全部输入神经网络进行特征提取,最后
在支持向量机(support vector machine,SVM)
分类器上进行候选框的分类和回归。虽然
R-CNN 极大地提升了检测性能,但由于
R-CNN 的各个部分都是相互独立的,所以
检测速度很慢。基于上述情况,为了加快网
络的检测速度,学者们对 R-CNN 进行了很
多优化和改进,从而使得尺度金字塔池化网
络 (Spatial Pyramid Pooling Network ,
SPPNet)[22] 和 快 速 基 于 区 域 的 神 经 网 络
(Fast Region Based Convolutional Neural
Network,Fast- RCNN)[23]被相继提出。
学者们在 Fast-RCNN 的基础上又进一
步提出了 Faster-RCNN(Faster Region Based
Convolutional Neural Network)
[24],其候选框
由区域建议网络(Region Proposal Network,
RPN)产生,再利用与 Fast-RCNN 相同的结
构进行分类及窗口回归,与此同时,RPN 和
Fast-RCNN 共享网络使二者成为统一的网
络结构。通过对 Faster-RCNN 更进一步的优
化就得到了基于区域的全卷积网络(Region
Based Fully Convolutional Network ,
R-FCN)[25],试验发现,经过感兴趣区域
(Region of Interest,ROI)池化后的网络层不
再具有平移不变性的特性,而且经 ROI 池化
后的网络其深度增加后效率反而会降低。因
此,R-FCN 直接对 ROI 池化后的结果进行检测,实验结果有了大幅提升。YOLO(You
Only Look Once)[26-29]与 SSD(Single Shot
Multibox Detector)[30]的提出旨在损失可接
受范围内的精度来最大限度地提升检测速
度,使其接近实时检测的程度,值得一提的
是 SSD 在提高检测速度的同时也兼顾了检
测精度。视频目标检测作为在无人驾驶[31-32]、视
频监控和物联网[3]等领域中一项重要的任务,
与静态图像的目标检测相比更具挑战性和
实用性。与静态图像目标检测不同的是,目
标在视频中是动态变化的,即其自身属性诸
如外观、形状、尺寸会动态地改变,检测过
程中视频序列需要在时间和空间维度保持
一致以防检测目标丢失成为了视频目标检
测任务的研究难点。由于视频比二维图像多
了时间维度,因此有很多算法通过利用时间
维度的信息来提升检测性能。
本文对近几年
基于深度学习的视频目标检测工作进行了
梳理和总结,将其分为以下几个核心问题和面临的挑战:
(1) 目标在视频序列中的位置变化会产
生相应的运动信息,而通过这些运动信息便
可以进行目标检测。例如光流信息,目标检
测算法通过光流信息可以将位置发生改变
的目标高效地检测出来,从而保证了检测的
高效性和鲁棒性。(2) 检测算法首先对视频序
列中每一个视频帧进行检测,然后应用相关
的跟踪算法对目标检测框进行跟踪,最后将
跟踪得到的结果与检测结果进行对比修正
以此达到视频目标检测的目的。(3) 视频目标
检测模型的轻量化。视频目标检测算法在移
动端、无人驾驶以及嵌入式等领域应用的前
提条件是实现轻量化处理,而深度神经网络
的使用通常伴随着模型体积大、运行消耗资
源多等问题,如何将基于深度学习的视频目
标检测算法进行轻量化处理则是一个关键。(4) 检测模型的跨界问题。通过借鉴深度学习
其他领域的相关知识如 NLP 等,将其应用
于视频目标检测中也收到了不错的效果。(5)
保持目标在视频序列中的时空一致性。具体
的挑战可分为以下五类:
(a).运动模糊:在实际场景中,目标的
运动是一个连续的过程,视频中快速移动的
物体会造成明显的模糊拖动痕迹,此时,目
标通过外观就很难分辨,如图 1a 所示。(b).虚焦:由于录像设备一直没有对目
标进行对焦,使得目标在视频帧中出现模糊
甚至整个视频帧都很模糊的现象,如图 1b
所示。(c).遮挡:目标在运动过程中,可能会
与其它一些物体发生重叠,从而出现检测目
标被遮挡的问题,如图 1c 所示。(d).外观变化:在视频序列中,同一目
标不同的姿态会导致外观上有明显的差异,
如图 1d 中变色龙出现的罕见姿态。(e).尺度变化:目标在运动过程中,随
着与镜头距离的变化,不同帧中会展现出外
观尺寸不一的情况
结合上述问题与出现的挑战,本文从运动信息、检测和跟踪、检测模型的轻量化以
及跨界模型的应用四个方面对基于深度学
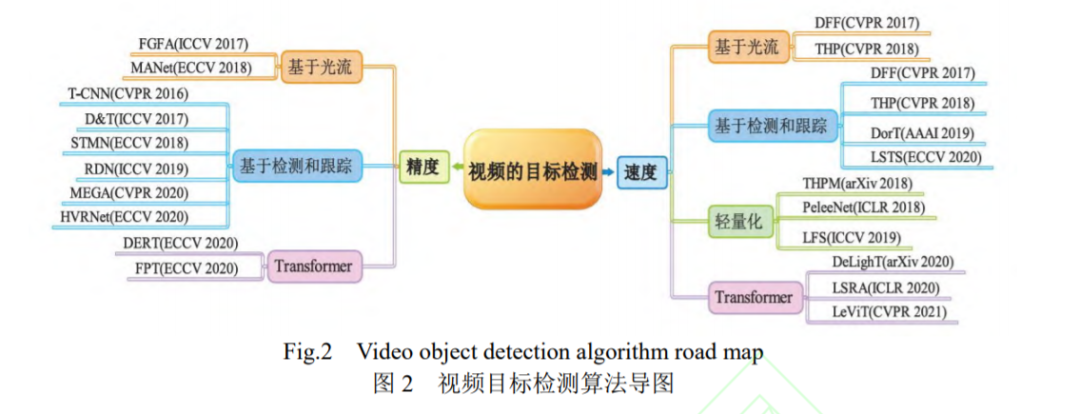
习的视频目标检测算法的发展与研究现状进行了全面而透彻的分析,如图 2 所示,对
一些具有代表性的检测算法在主流数据集
上进行了对比分析,并对视频目标检测领域
将要解决的问题和发展方向进行了展望。
专知便捷查看
便捷下载,请关注专知公众号(点击上方蓝色专知关注)
专知,专业可信的人工智能知识分发,让认知协作更快更好!欢迎注册登录专知www.zhuanzhi.ai,获取5000+AI主题干货知识资料!欢迎微信扫一扫加入专知人工智能知识星球群,获取最新AI专业干货知识教程资料和与专家交流咨询!点击“阅读原文”,了解使用专知,查看获取5000+AI主题知识资源



