点击上方“菜J学Python”,选择“星标”公众号
超级无敌干货,第一时间送达!!!
专栏作者:曜,好奇心重的科研学生党,单纯的爬虫爱好者,以输出倒逼自己输入,希望与大家一起进步。公众号后台回复入群,拉你进技术群与大佬们近距离交流。说到Python其实应该有很多人都看过一个广告:某某同学能够批量下载文献。作为一个生物相关专业学生党,我对此表示很好奇,于是在学了爬虫之后对文献网站进行了尝试,然后就有了这次的分享。在文章讲解之前,咱们先来看看代码运行效果:
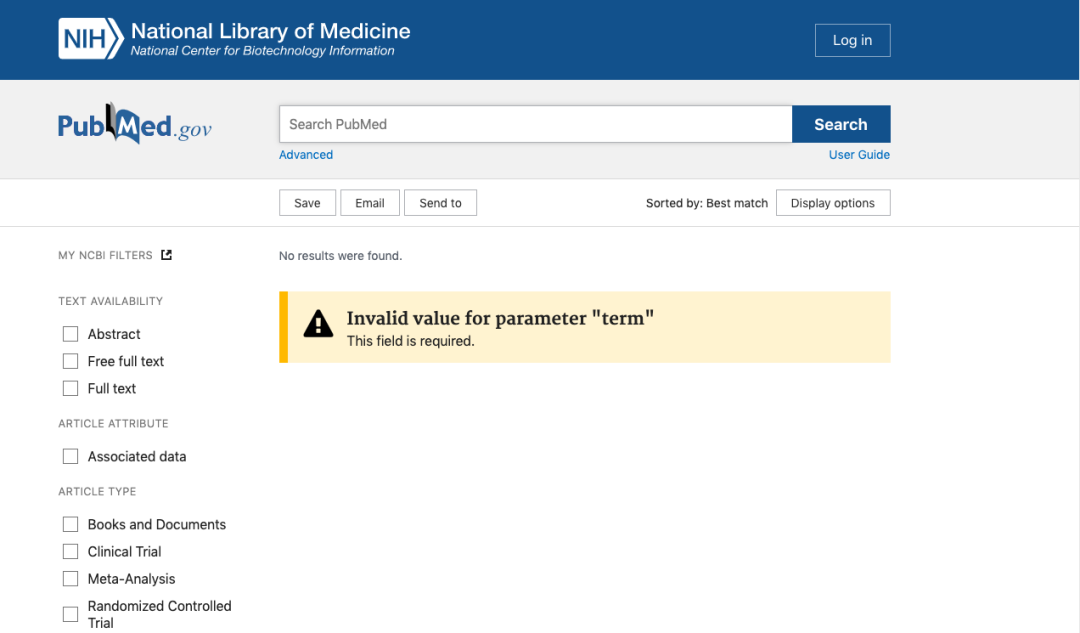
对ncbi(美国国家生物信息中心)(emmm,没错,我就是生化环材“四大天坑”之首的学生)的PubMed文献库进行爬取:
爬虫思路如下:
1.对某个查询词进行爬取,获取搜索得到的结果数
2.爬取到文章的标题以及它的doi号(“科技论文的身份证”)
3.根据doi号链接到sci-hub,下载文献到本地,保存为doi号.pdf
接下来,让我们开启愉快的爬虫之旅吧,go!
首先是需要的库:
import requests
from lxml import etree
import time
import re
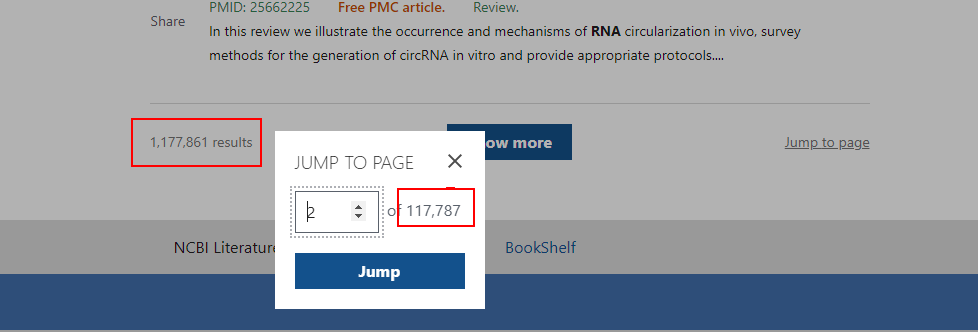
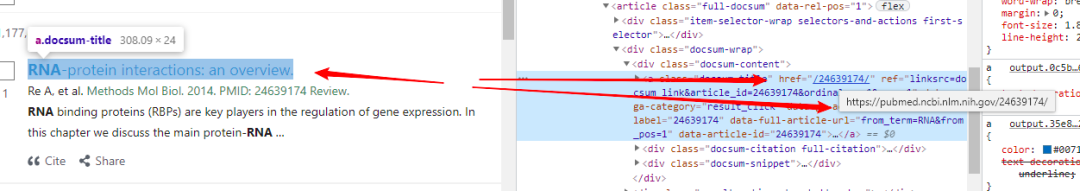
ok,第一部分的代码:获取查询到的结果,可以看到term参数的值就是我们要查询的词(图一),像以RNA为搜索词一共查到1177861个结果,我们把这个部分爬下来(图二),方便得知一共有多少的结果。而页码数(图三),我们可知一页有10个结果,页码数就是结果数除以10,多出来的结果不够10个则自成一页。
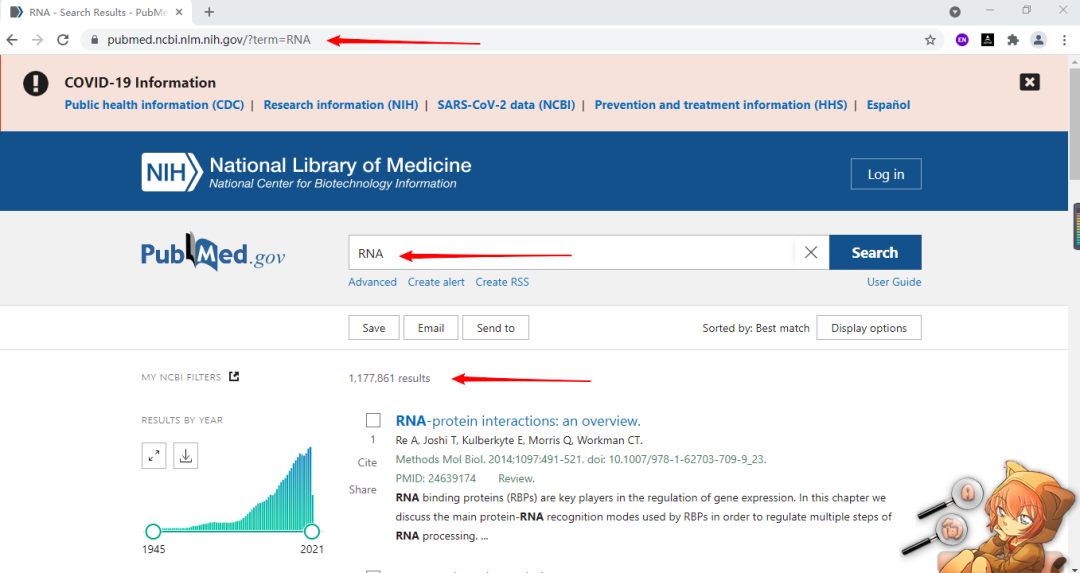
图一
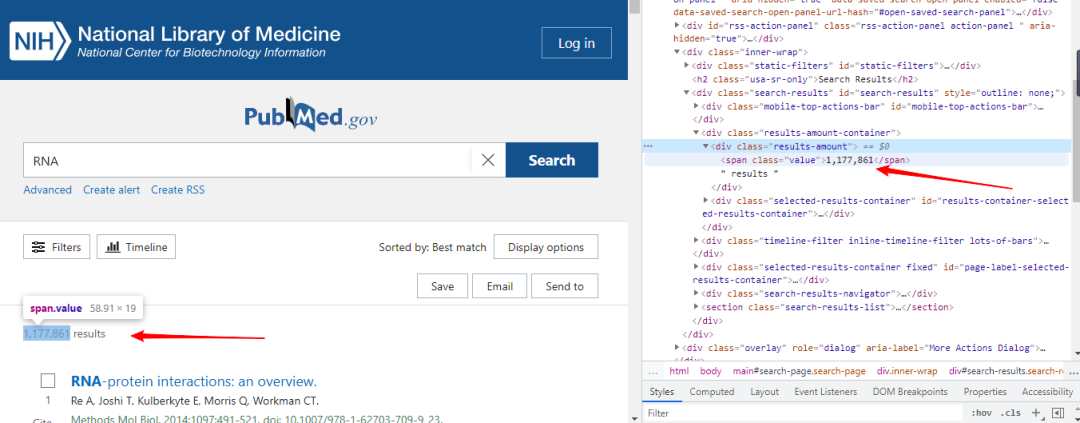
图二
图三
我们传入一个参数term(需要查询的词),然后构造url,这里的f "....{...}"是格式化输出,类似于format方法:def get_results(term):
url = f'https://pubmed.ncbi.nlm.nih.gov/?term={term}'
headers = {
"User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/80.0.3987.163 Safari/537.36",
}
r = requests.get(url, headers=headers)
r.encoding = 'utf-8'
tree = etree.HTML(r.text)
results = tree.xpath('//div[@class="results-amount"]/span/text()')
if len(results) !=0:
new_results = str(results[0]).replace("\n","")
print(f"一共找到{new_results}个结果")
end_results = int(new_results.replace(",",""))#字符串中含有,号无法转换成数字,我们用空来替代它
if end_results % 10 == 0:
pages = end_results / 10
else:
pages = int(end_results/10)+1
print(f"一共有{str(pages)}页结果")
else:
print("没有结果")
pages = 0
return pages
第二部分我们将每一篇文章的链接爬下来,保存到列表里,传入参数需要查询的词term以及需要爬取的页码数。
(ps:遇到的坑之一,由于数据很多,尽量不要几百页全部爬取,只是学习的话可以爬一两页试试,如果要爬几百页消耗时间太长)
def get_links(term,pages):
total_list = []
for i in range(pages):
url = f'https://pubmed.ncbi.nlm.nih.gov/?term={term}&page={str(i+1)}'
headers = {
"User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/80.0.3987.163 Safari/537.36",
}
r = requests.get(url,headers=headers)
r.encoding='utf-8'
tree =etree.HTML(r.text)
links = tree.xpath('//div[@class="docsum-content"]/a/@href')
for link in links:
#构造单个文献的链接
new_link = 'https://pubmed.ncbi.nlm.nih.gov' + link
total_list.append(new_link)
time.sleep(3)
return total_list
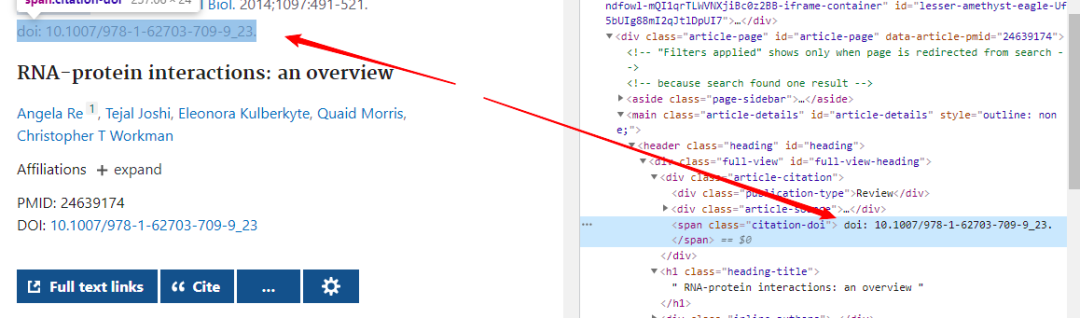
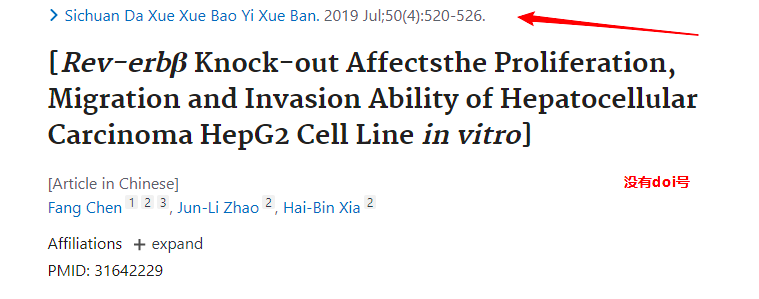
第三部分:遍历列表里每一个链接到文献详情页将文献题目以及doi号取出,并将doi号进行保存用以之后下载文献使用,若一篇文献没有doi号则打印出无doi号:
这部分代码如下:
def get_message(total_list):
doi_list = []
headers = {
"User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/80.0.3987.163 Safari/537.36"
}
for url in total_list:
r = requests.get(url, headers=headers)
r.encoding = 'utf-8'
tree = etree.HTML(r.text)
title = tree.xpath('//h1[@class="heading-title"]/text()')[0]
new_title = str(title).replace("\n", "")
print(new_title[26:])
doi = tree.xpath('//span[@class="citation-doi"]/text()')
if len(doi) == 0:
print("这篇文章没有doi号")
else:
new_dois = str(doi[0]).replace(" ", "")
new_doi = new_dois[5:-2]
doi_list.append(new_doi)
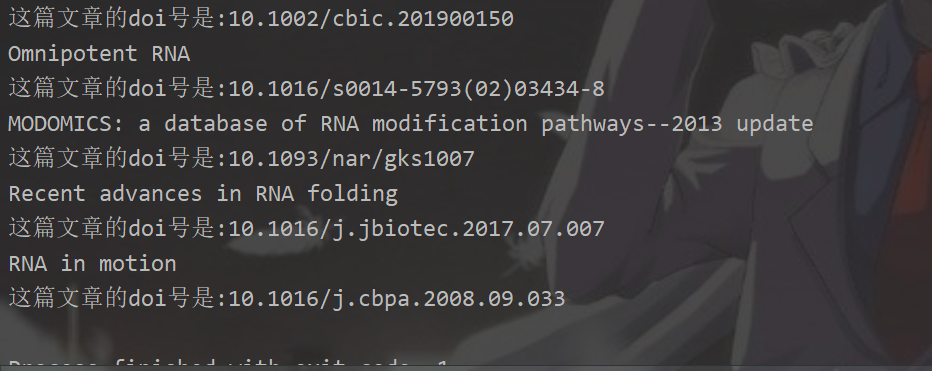
print(f"这篇文章的doi号是:{new_doi}")
return doi_list
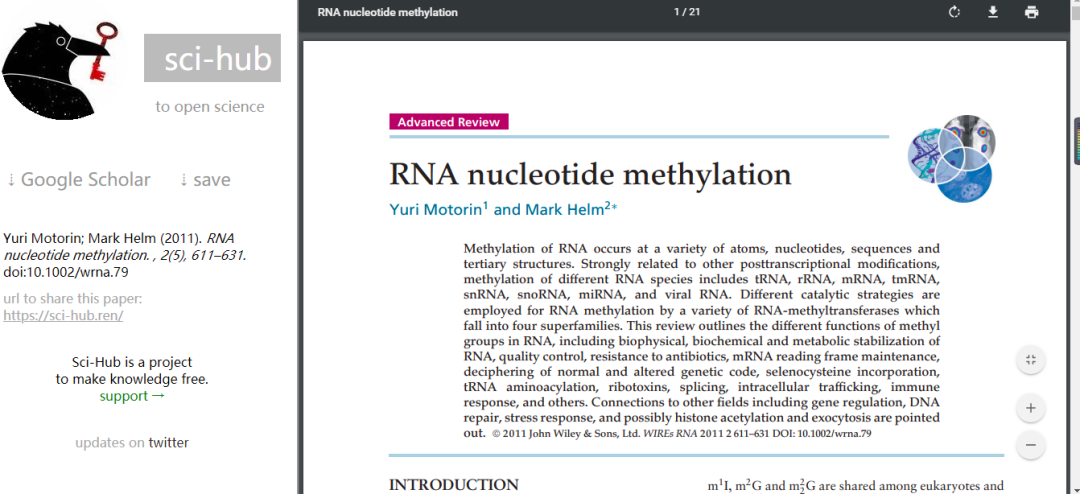
最后一部分就是下载了,相关专业的应该知道下载文献的一个网站叫sci-hub,这次我们就链接到这个网站进行下载,将doi号输入该网站,就会跳转得到一个PDF,如图:
分析网页可以得到下载地址在这里:
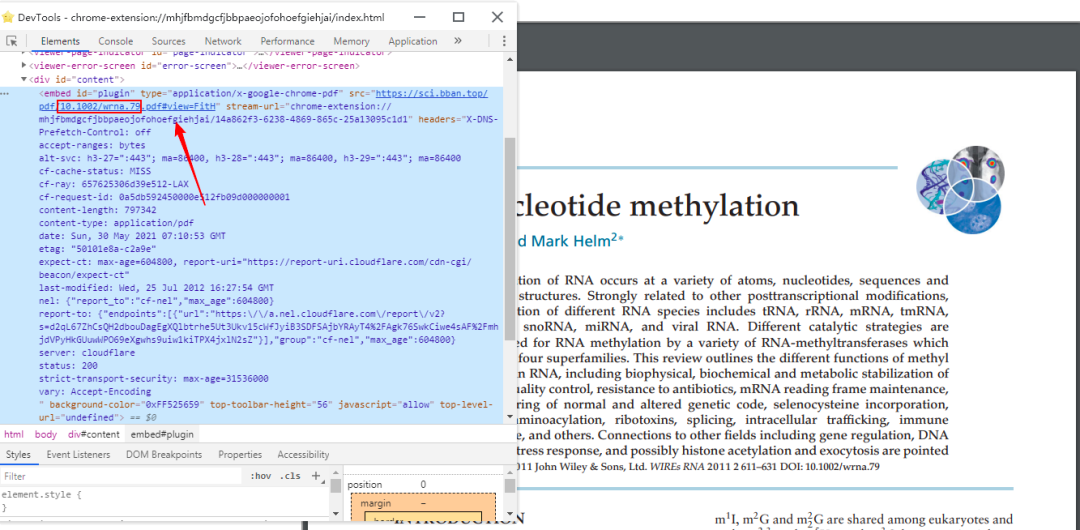
接下来就简单了,我们直接上代码,把它保存下来:
def get_content(dois):
for doi in dois:
urls = f'https://sci.bban.top/pdf/{doi}.pdf#view=FitH'
headers = {
"User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/80.0.3987.163 Safari/537.36"
}
r = requests.get(urls, headers=headers)
title = re.findall("(.*?)/",doi)
with open(f"{title[0]}.pdf",'wb')as f:
f.write(r.content)
time.sleep(2)
最后就是运行了,为了好看一点,可以多打印点文字。
if __name__ == '__main__':
    term = input("请输入文献的关键词(英文):")
    print("正在寻找文献中....")
    if get_results(term) != 0:
        page = int(input("请输入下载的页数:"))
        print("正在下载文献,注意只能下载含doi号的文献")
        get_content(get_message(get_links(term=term,pages=page)))
        print("下载已完成")
    else:
        print("对不起,没有文献可以下载")
运行结果(因为时间原因只运行一页来尝试):
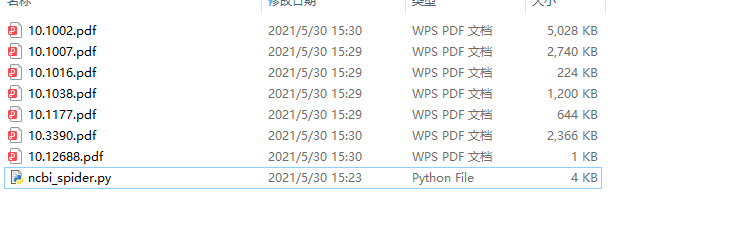
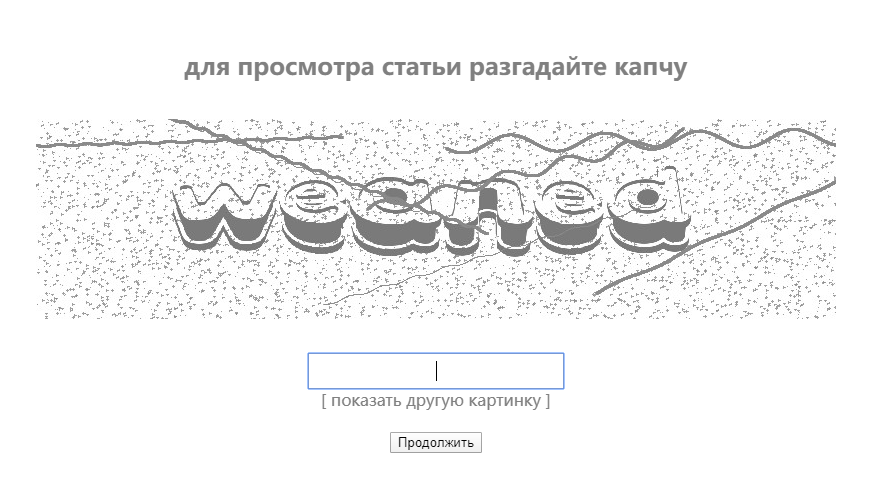
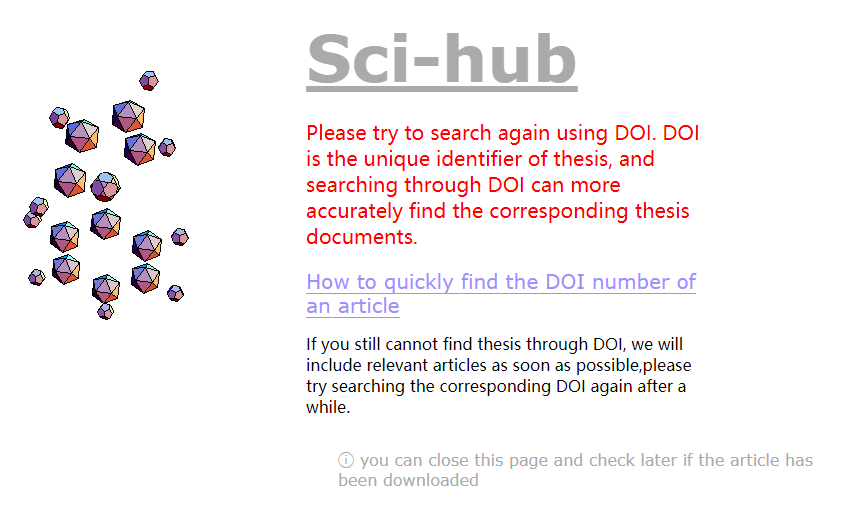
写在最后,运行结果后发现也有一些PDF只有1k,发现出现此结果的原因可能如下:
使用Python下载文献也并不是非常快,代码也需要持续优化,写这个案例的目的主要是巩固一下自己的基础知识,希望能和小伙伴们一起改进代码,继续进步!
关注「数据有道」公众号,回复「有道15」领取本文源码

既往专辑