社区所有版块导航
Python
python开源   Django   Python   DjangoApp   pycharm  
DATA
docker   Elasticsearch  
aigc
aigc   chatgpt  
WEB开发
linux   MongoDB   Redis   DATABASE   NGINX   其他Web框架   web工具   zookeeper   tornado   NoSql   Bootstrap   js   peewee   Git   bottle   IE   MQ   Jquery  
机器学习
机器学习算法  
Python88.com
反馈   公告   社区推广  
产品
短视频  
印度
印度  
Py学习  »  机器学习算法

【数据看球】2018 年世界杯夺冠预测,CDA带你用机器学习来分析

CDA数据分析师 • 8 年前 • 566 次点击  

作者  Gerald Muriuki

编译  Mika
本文为 CDA 数据分析师原创作品,转载需授权

观看更多国外公开课,点击"阅读原文"

随着2018年FIFA世界杯开赛在即,世界各地的球迷都渴望知道:谁将夺取梦寐以求的冠军奖杯?


如果你不仅是一名资深球迷,而且还是技术宅,那么你还可以利用机器学习和人工智能这两个利器。下面让我们一起预测哪个国家会赢得本次世界杯。


足球比赛涉及到很多因素,因此许多因素无法在机器学习模型中进行探讨。这只是我作为技术宅,从数据角度的尝试。


目标


1. 目标是使用机器学习预测谁将赢得2018年世界杯。


2. 预测世界杯中每场比赛的结果。


3. 对下场比赛进行模拟预测,比如四分之一决赛,半决赛和决赛。


这些目标体现了现实世界中的机器学习预测问题,当中涉及的机器学习任务包括:数据整合,特征建模和结果预测。


数据


我使用了Kaggle的两个数据集,包括自1930年起所有参赛队在国际比赛中的结果。


Kaggle数据集链接:

(https://www.kaggle.com/martj42/international-football-results-from-1872-to-2017/data)


局限性:

由于国际足联排名创建于90年代,因此缺乏大部分数据集。在此我们按照历史比赛记录分析。


环境和工具: 

jupyter notebook,numpy,pandas,seaborn,matplotlib和scikit-learn。


我们首先要对两个数据集进行探索性分析,通过特征工程选择最相关的特征进行预测。之后进行数据处理,选择机器学习模型,最后将其部署到数据集上。


开始


首先,导入必要的库并将数据集加载到数据框。


导入库


加载数据集


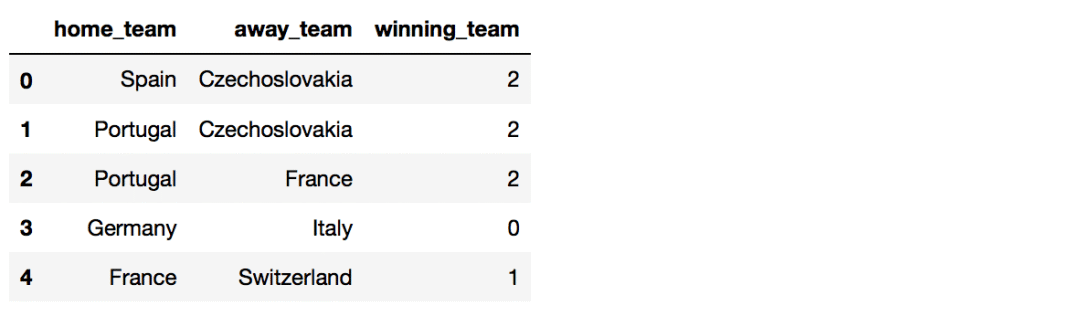
通过调用两个数据集world_cup.head()和results.head(),确保数据集加载到数据框中,如下所示:


探索性分析:


对两个数据集进行分析后,所得数据集包含过去比赛的数据。新产生的数据集对分析和预测之后的比赛很有用。


在数据科学项目中,确定哪些特征与机器学习模型相关是最耗时的部分。


现在,让我们在结果数据集中添加净胜球数和结果列。


查看新的结果数据框。


然后我们将使用数据的子集。其中包括只有尼日利亚参加的比赛。这将有助于我们了解某支球队的特色,并拓展运用到其他参赛球队。


第一届世界杯于1930年举办。创建年份列,选择1930年以后的所有比赛。


现在可以将这些年尼日利亚的比赛结果进行可视化。


每个世界杯参赛球队的获胜率是很有用的指标,我们可以用它来预测每场比赛的结果。其中比赛场地并不重要。


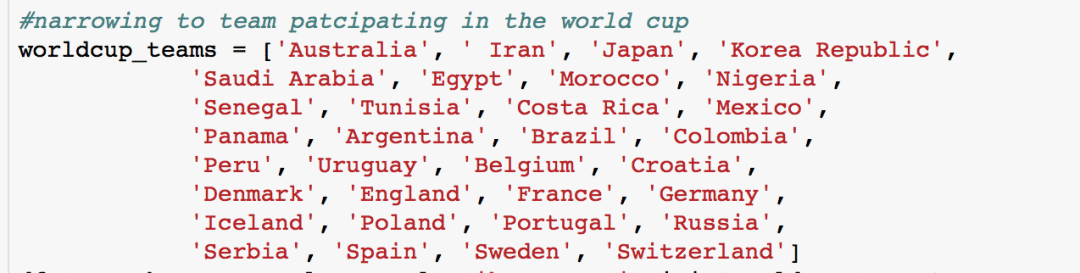
参赛球队


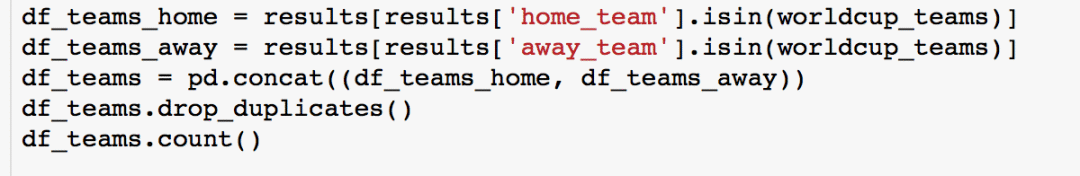
对所有参赛球队创建数据框。


然后进一步过滤数据框,只显示从1930年起到今年世界杯的球队,减少重复的球队。


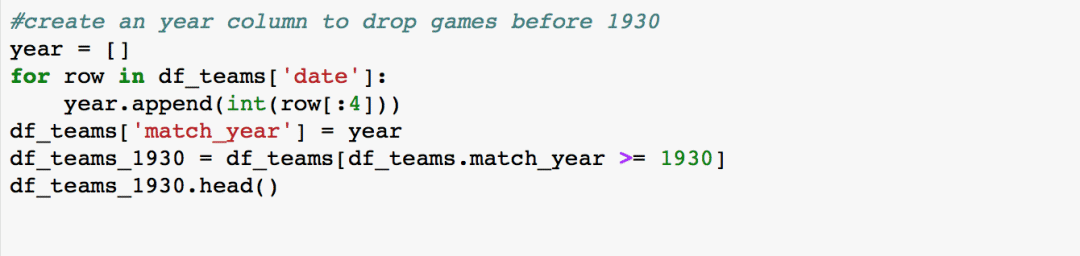
创建年份列,并删除1930年之前的比赛,以及不影响比赛结果的列,例如日期、主队进球数、客队进球数、锦标赛、城市、国家、净胜球数和比赛年份。


修改“Y”(预测标签)以简化模型处理。


如果主队获胜,获胜队(winner_team)列将显示“2”,如果是平局则显示“1”,如果客队获胜则显示“0”。
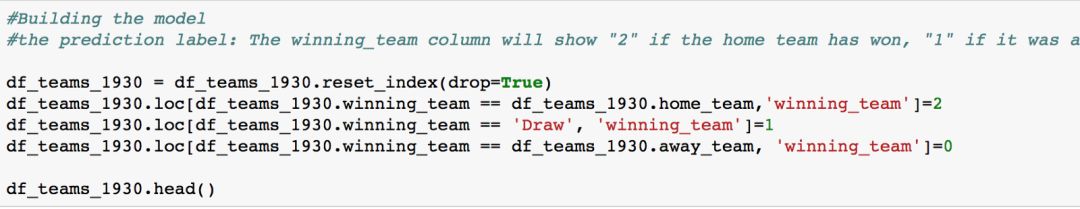


通过设置虚拟变量,将主队(home_team)和客队(away _team)从分类变量转换为连续输入。


使用 pandas,get_dummies()函数。从而用one-hot(数字“1”和“0”)代替分类列,确保加载到Scikit-learn模式。


然后,我们将X和Y集分开,并将数据的70%用于训练,30%用于测试。
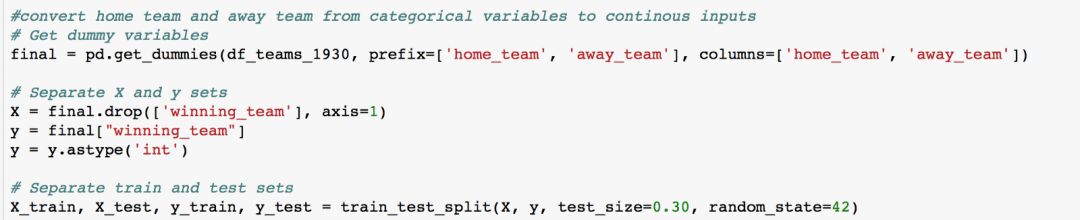


我们将使用逻辑回归。通过逻辑函数估计概率,我可以测量分类因变量和一个或多个自变量之间的关系。


换句话说,逻辑回归通过影响结果的数据点(统计数据)对结果进行预测(赢或输)。


在实际运用中,每次对一场比赛输入算法,同时提供上述“数据集”和比赛的实际结果。然后,模型将学习输入数据将如何对比赛结果产生积极或消极影响。


让我们看到最终数据框:
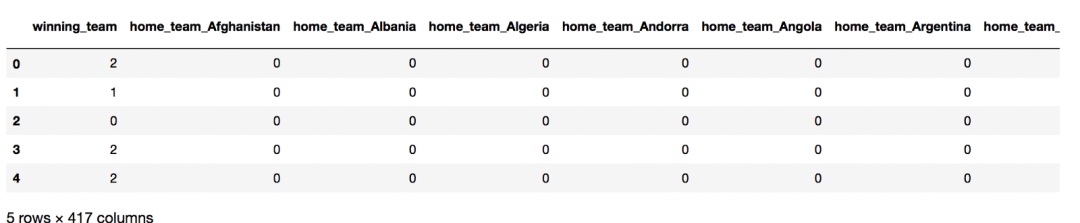


看起来很棒。现在加入算法:
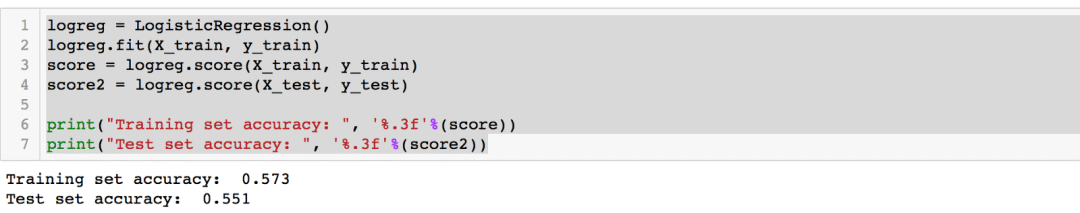


我们的模型在训练集上的准确率为57%,测试集的准确率为55%。这并不理想,但让我们继续。


现在我们将创建数据框部署模型。


首先,我们将加载截至到2018年4月的国际足联排名数据集和小组赛阶段的数据集。


国际足联排名:

(https://us.soccerway.com/teams/rankings/fifa/?ICID=TN_03_05_01)


小组赛阶段数据:

(https://fixturedownload.com/results/fifa-world-cup-2018)


国际足联排名较高的球队将被视为“受欢迎”球队。由于世界杯中不分“主队”或“客队”球队,他们都将归属到“home_teams”列。然后,根据每个团队的排名将球队添加到新的预测数据集中。下一步将创建虚拟变量并部署机器学习模型。


预测比赛


你肯定在想什么时候才能到预测部分。前面代码和解释占据了太多的篇幅,现在我们开始预测。


将模型部署到数据集


首先将模型部署到小组赛。


下面是小组赛的结果。


该模型预测了三场平局,并预测西班牙有很高的胜率。我用这个网站预测了小组赛。

(https://ultra.zone/2018-FIFA-World-Cup-Group-Stage)


16强


以下是对16强的预测。


四分之一决赛


四分之一决赛的情况为:

葡萄牙vs法国,巴西vs英格兰,西班牙vs阿根廷,德国vs比利时。


预测结果:


半决赛


葡萄牙vs巴西;德国vs阿根廷


预测结果:


决赛


巴西vs德国


预测结果:巴西获胜。


根据模型预测,巴西很可能赢得本次世界杯。


结语


研究和改进空间:


1.数据集。为了改进数据集,你可以使用国际足联数据来评估球队中每个球员的水平。


2.混淆矩阵能够用于分析模型分析错误的情况。


3.我们可以整合更多模型,从而提高预测准确率。


完整的代码如下:

https://github.com/itsmuriuki/FIFA-2018-World-cup-predictions


原文链接:

https://blog.goodaudience.com/predicting-fifa-world-cup-2018-using-machine-learning-dc07ad8dd576


投票


根据各大数据机构给出的本届世界杯夺冠赔率榜,本次的八大夺冠热门球队为:巴西、德国、西班牙、法国、阿根廷、比利时、英格兰、葡萄牙。你觉得哪支球队能赢得的冠军奖杯呢?


更多精彩文章

十分钟带你看Google I/O 2018的亮点

在Booking当数据科学家是怎样一种体验

轻松看懂什么是以太坊

Kaggle大神经验分享丨如何用15个月冲到排行榜的首位

收藏丨学习数据科学不可错过的优质资源

我是如何从物理学转行到数据科学领域

数据科学领域的20位杰出女性

TED演讲-数据科学家最重要的技能是什么

区块链将影响的19个行业


今天看啥 - 高品质阅读平台
本文地址:http://www.jintiankansha.me/t/jSnt33U2o8
Python社区是高质量的Python/Django开发社区
本文地址:http://www.python88.com/topic/13541